pandas提供的 to_numeric 方法使用中遇到的坑
业务逻辑是需要将一个csv读入,然后进行一些处理,比如对多个元素求和、求方差等等。要求忽略非数值型数据,而pandas的忽略数值型是整行整列的忽略,所以自然不能满足我的业务要求。于是,我这里的方案是先取出要计算的元素,然后进行数据清洗,再进行计算。
这里就会存在一个问题,浮点数的问题。众所周知,浮点数在计算机中是没有办法完全精确表示的。所以会有保留精度。
这在调用 pandas的内置方法 to_numeric 的时候更是凸显了出来:

字符串 2.067 在用该方法转为数值的时候,被认为是浮点型,依照规范,python中的浮点数是保留17位精度,所以可以得到这样的结果。
解决方案:
我是放弃了这个方法,为了保证小数的精度,所以采用了decimal模块的Decimal类。
decimal是可以高精度计算的,为什么不用上面的方面了呢,一个是本身存在的问题,还有就是它的浮点数类型都是float,精度不够高,所以综合权衡了下,采用的是decimal。
from decimal import Decimal

import pandas as pd
import numpy as np


def convert_num(x, fill=None):
    x = str(x)
    try:
        res = Decimal(x)
    except Exception:
        res = fill if fill else np.NaN
    return res


df = pd.DataFrame([['3.517', '1', '2.06789464564654654654646', 2.067, 'sdf']])
df = df.applymap(lambda x: convert_num(x))
print(df)
[print(data) for data in df.loc[0]]
print(df.iloc[0, 2])
代码非常简单,调用的是applymap函数,它与apply函数的区别就是,applymap是针对于每个元素的,而apply是针对于行列级别的。
利用Decimal类转化的时候,参数需要用字符串才能保证其正确性,所以我是在方法里的第一行就将参数转为了字符串,能转化为数值的它都会转化过去,不能转化的它会抛异常,所以捕获异常后,当前的字符串一定是一个非数值型数据,那么我也模仿pandas的一些内置方法,将其置为nan。
结果如下:
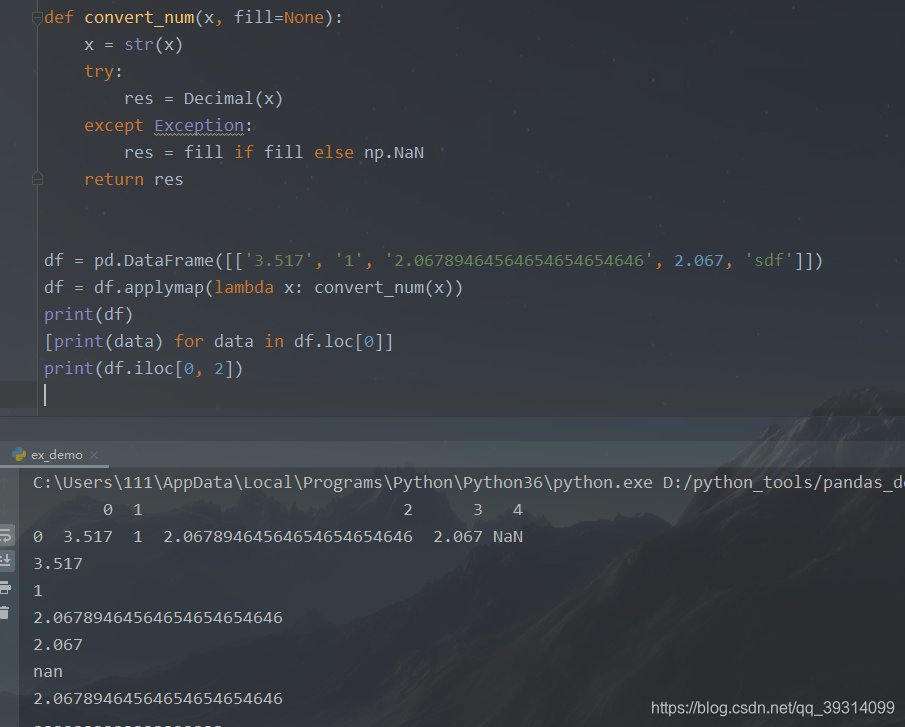
另外,还有一点需要注意的是,applymap是只接收一个func,不像apply,后面可以传入该func的参数,所以想给applymap里的func传参,我采用的是lambda表达式的写法。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 2
 0
- 0


 已为社区贡献4条内容

所有评论(0)