pandas空值填充
·
背景
数据缺失是数据不完整的表现,常表现为空值,也是数据分析人员经常碰到的问题,数据的缺失可能是数据采集不到,或在数据录入的不小心遗漏,或者根本不存在这个数据,还可能是数据导出的过程发生错误,数据的缺失会使得信息不完整,处理缺失数据一般会有下面两种办法
- 直接删除掉
当缺失值占比非常小,直接省略掉缺失的这部分数据,但是在原数据量小的情况下,原本数据能够提供的信息就不多,再删除这些缺失值会导致信息更一步减少,非常不可取,这时候就需要通过填充手段来进行缺失值填充。 - 空值填充
空值填充是指利用某些技术手段把空缺的值给填充上,来弥补信息的完全丢失,常见的填充方法有固定值填充法,均值填充法,中位数填充法,众数填充法,向前向后填充法,高端一点的有K近邻填充法,预测模型填充法,每种方法有其适用场景,这次主要讲一讲最常用的向前向后填充法。 - 不予理会
有些算法对空值友好,有较好的容错能力,及时空值参与模型也不会对模型影响很,这个时候可以考虑不理睬缺失值。
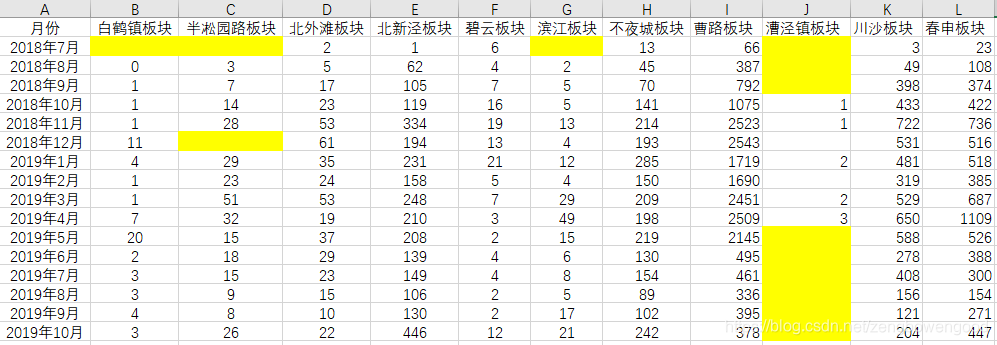
现在手边有一份数据表如下,其中黄色部分是缺失的,根据业务知道其中0也是不合理的,现在需要把其中的0值去掉,并且将空值填充,看到漕泾镇板块这一列数据缺失比较大,对于这种缺失严重的,建立一套标准直接删除掉,大致步骤如下
- 用空值替换掉表中0值
- 统计每一列的空值
- 设定一个门槛,将缺失严重的列直接删除掉
- 利用向前向后填充法填充表中空值
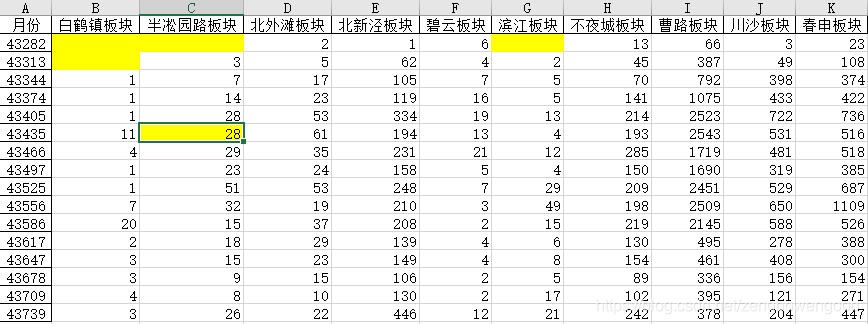
我们发现向前填充之后,首行还是没发填充,原因很简单,因为,向前填充是利用前面一个数来填充后面的空位,如果前面没有数的话,也就无法填充,同样的道理,向后填充也无法填充最后一行的空值。针对这种情况需要先后采用向后填充和向后填充,两者配合使用,下面是接着再使用向后填充的效果。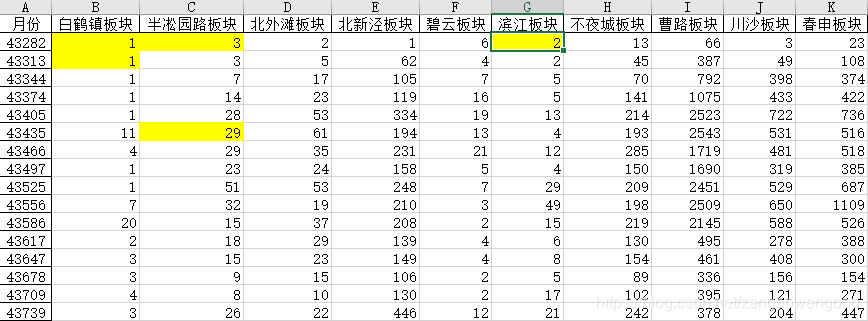
完整代码
# -*- coding: utf-8 -*-
"""
project_name:数据填充
@author: 帅帅de三叔
Created on Tue Nov 12 13:33:44 2019
"""
import numpy as np #导入数据分析模块
import pandas as pd #导入数据分析模块
data=pd.read_excel("待填充数据.xlsx",sheet_name="房间数",index_col="月份") #读取数据
print(data.describe())
data[data==0]=np.nan #先将0值转化为空值\
df=data.dropna(axis=1,thresh=11, subset=None, inplace=False) #过滤空值过多的列
print(df.describe())
df1=df.fillna(value=None,method='ffill',axis=0,limit=None) #列向前填充
df2=df.fillna(value=None,method='bfill',axis=0,limit=None) #列向后填充,避免首行空值
df2.to_excel("清洗填充结果.xlsx")
代码解读
读取数据后可以 data.describe() 函数来查看数据框的一些统计情况,特别注意count值,可以对比count值和len的大小,两者之差就是缺失值的个数,紧接着将0值转化为空值,然后在利用 thresh 的值来设定非空缺值个数为多少时候不过滤,再通过 describe() 函数来看前后两次的数据维度,可以发现数据维度在收缩,然后接连使用向前填充和向后填充,最后将填充的结果保存到excel。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 1
 0
- 0


 已为社区贡献2条内容

所有评论(0)