pandas练习
·
US_Baby_Names_right.csv文件中存储了美国小孩的姓名, 出生年份, 性别, 所在州及名称出现次数, 试实现以下统计分析:
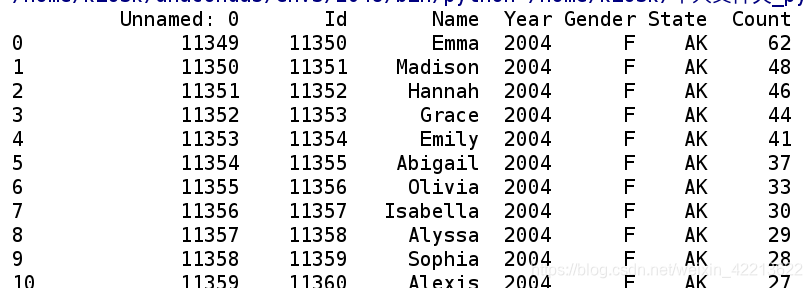
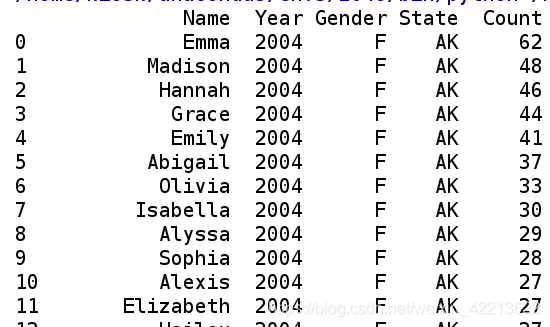
1). 删除 [Unname: 0] 列 和 [id]列;
child_info = pd.read_csv('US_Baby_Names_right.csv')
del_li = child_info.drop(['Unnamed: 0','Id'],axis=1)
print(del_li)
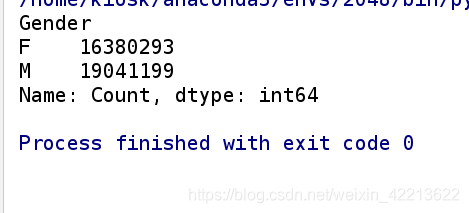
2). 判断出数据集中 男孩名字、女孩名字谁多;
judge_gender=del_li.groupby('Gender').Count.sum()
print(judge_gender)
3). 根据题目2,绘制扇形图统计男孩名字和女孩名字分别占总名称的百分比;
from pyecharts import  Pie

attr = ['Femal','Male']
gender_info=[judge_gender[0],judge_gender[1]]
pie = Pie("男女比例图:")
pie.add("", attr, gender_info, is_label_show=True)
pie.render()
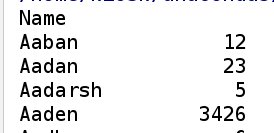
4). 按照 【Name】列将数据集进行分组并求和, 效果如下:
Year Count
Name
Aaban 4027 12
Aaadan 8039 23
…后面省略
judge_byname = del_li['Count'].groupby(del_li['Name']).sum()
print(judge_byname)
5). 根据题目4, 以列【Count】的值对DataFrame降序排序,查看前5条数据, 并绘制柱状图显示;
from pyecharts import Bar
dict_judge_byname = {'Name':judge_byname.index,'Count':judge_byname.values}
df_judge_byname = pd.DataFrame(dict_judge_byname)
top5 = df_judge_byname.sort_values(by='Count',ascending=False).head()
print(top5)

bar = Bar('名字数量排名前5')
bar.add('',top5['Name'],top5['Count'])

bar.render()
6). 统计出现次数最少的名字共有几个 ? (运行结果应该为2578)
print(df_judge_byname[df_judge_byname['Count']==df_judge_byname['Count'].min()].count())

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)