揭秘Redis性能优化:从批量操作到集群读写分离的全面指南
问题1:懂Redis的批量操作么?
我们在生产上采用的是Redis Cluster集群架构,不同的key会划分到不同的slot中,因此直接使用mset或者mget等操作是行不通的。
问题2:懂Redis事务和Pipeline吗?
- Redis中,如果一个事务被提交,那么事务中的所有操作将会被顺序执行,且在事务执行期间,其他client的操作将会被阻塞;Redis采取了这种简单而“粗鲁”的方式来确保事务的执行更加的快速和更少的外部干扰因素。
- Redis Cluster集群架构,不同的key是有可能分配在不同的Redis节点上的,在这种情况下Redis的事务机制是不生效的。 Redis的事务功能较弱(不支持回滚),而且集群版本(自研和官方)要求一次事务操作的key必须在一个slot上(可以使用 hashtag 功能解决)
- 管道(pipeline)可以一次性发送多条命令并在执行完后一次性将结果返回,pipeline通过减少客户端与redis的通信次数来实现降低往返延时时间,而且Pipeline 实现的原理是队列,而队列的原理是时先进先出,这样就保证数据的顺序性Pipeline 的默认的同步的个数为53个,也就是说arges中累加到53条数据时会把数据提交
# 假设 r 是一个 Redis 客户端实例
pipeline = r.pipeline()
pipeline.set('key1', 'value1')
pipeline.get('key2')
pipeline.zadd('key3', {'member1': 1})
responses = pipeline.execute()  # 执行所有命令并收集它们的执行结果


# 获取多个key的值
values = r.mget('key1', 'key2', 'key3')
问题3:Redis的多数据库机制,了解多少?
Redis支持多个数据库,并且每个数据库的数据是隔离的不能共享,单机下的redis可以支持16个数据库(db0 ~ db15)
在Redis Cluster集群架构下只有一个数据库空间,即db0。因此,我们没有使用Redis的多数据库功能!
问题4:Redis集群机制中,你觉得有什么不足的地方吗?
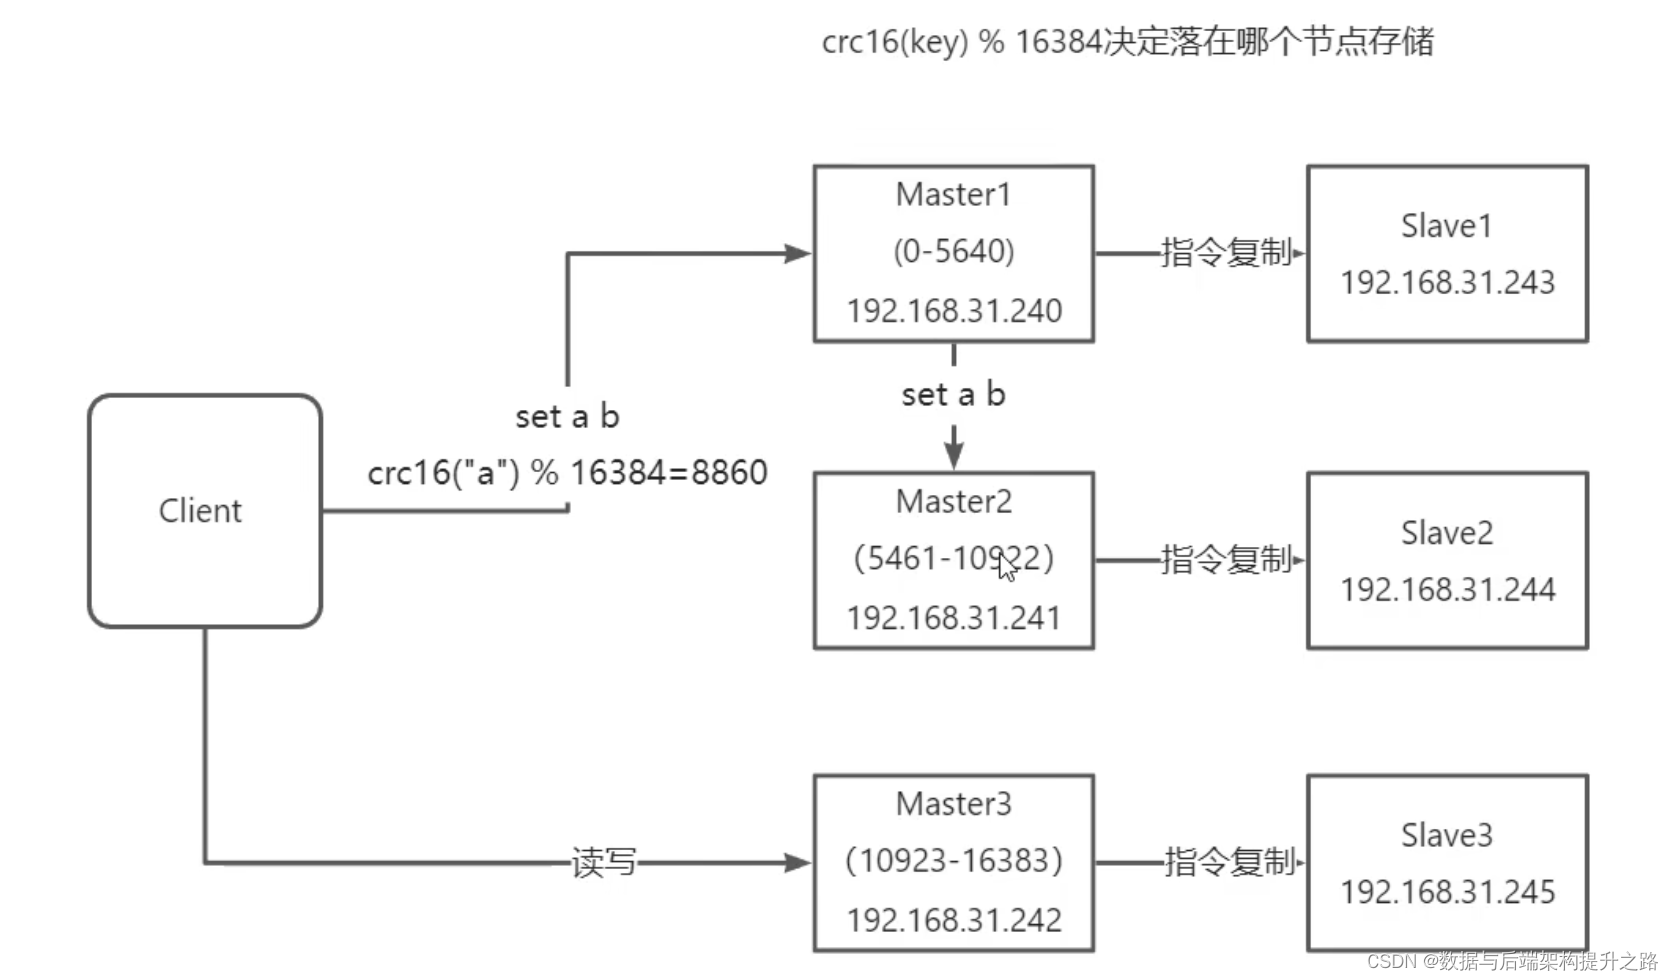
Redis因为是要提升性能,所以直接采用的异步复制,当在Master上写入数据后直接返回,然后把数据快照广播给Slave,让所有的Slaves去执行操作,数据通过异步复制,不保证数据的强一致性。
- 假设有一个key,对应的value是Hash类型的。如果Hash对象非常大,当使用哈希类型时,单个key对应的哈希可以看成是一个字段与值的映射表。即便哈希对象很大,它也被视为一个单独的条目(key),该条目必须完整地存储在集群中的一个节点上面,而不能跨多个节点分布存储。这是因为Redis的数据分片策略是基于键级别的,而不是在键值内部数据结构级别。
- 还有就是做批量操作比较麻烦!
问题5:Redis Cluster 默认采用的是“串行命令”模式能用MGET吗?
Redis Cluster 默认采用的是“串行命令”模式,也就是说,它不支持跨节点的多键操作,因此MGET,MSET是可以使用的。
在Redis Cluster模式下,如果需要使用MGET这样的命令,需要确保所有的键都在同一节点上。否则,如果键分布在不同的节点上,会抛出一个错误。在实际开发中,如果需要在Redis Cluster模式下使用MGET这样的命令,一般有两种方案:
通过客户端库实现对命令的适配,例如,对于MGET命令,客户端库可以将其分解成多个GET命令,然后分别发往不同的节点执行。
通过哈希标签来控制键的分布,使得相关的键都分布在同一节点上。例如,对于键"{user1}:name"和"{user1}:age",由于它们的哈希标签"user1"相同,所以它们会被分布到同一节点上,因此可以使用MGET命令。
问题6:那在Redis集群模式下,如何进行批量操作的优化?
- 串行命令(默认):由于n个key是比较均匀地分布在Redis Cluster的各个节点上,因此无法使用mget命令一次性获取,所以通常来讲要获取n个key的值,最简单的方法就是逐次执行n个get命令,这种操作时间复杂度较高,它的操作时间=n次网络时间+n次命令时间,网络次数是n。很显然这种方案不是最优的,但是实现起来比较简单。
- 串行IO:串行IO方式下,客户端先将多个命令打包到一个请求中(通常使用pipeline命令或则MGET),然后将打包好的请求一次性发送到Redis服务器。该请求被发送到包含要处理的键所在的节点。然后,服务器可以在一次网络请求内处理多个命令。节省了很多网络请求时间,性能优化明显。
- 并行IO:此方案是将方案2中的最后一步改为多线程执行,网络次数虽然还是节点个数,但由于使用多线程网络时间变为O(1),这种方案会增加编程的复杂度。
- hash_tag实现:Redis Cluster的hash_tag功能,它可以将多个key强制分配到一个节点上,它的操作时间=1次网络时间+n次命令时间。hashtag的解决方案:可以使用twitter的 twemproxy
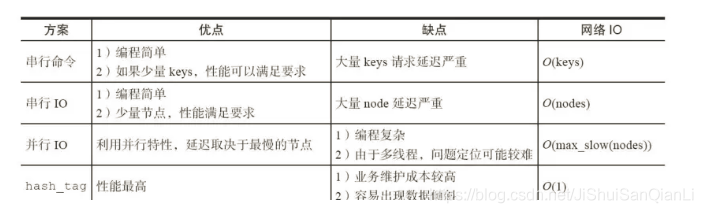
四种批量操作解决方案对比 使用Redis Cluster时,pipelining、事务和LUA Script功能涉及的key必须在同一个数据分片上,否则将会返回错误。如要在Redis Cluster中使用上述功能,就必须通过hash tags来确保一个pipeline或一个事务中操作的所有key都位于同一个Slot中。
有一些客户端(如Redisson)实现了集群化的pipelining操作,可以自动将一个pipeline里的命令按key所在的分片进行分组,分别发到不同的分片上执行。但是Redis不支持跨分片的事务,事务和LUA Script还是必须遵循所有key在一个分片上的规则要求。
问题7:你们有对Redis做读写分离么?
不做读写分离。我们用的是Redis Cluster的架构,是属于分片集群的架构。而Redis本身在内存上操作,不会涉及IO吞吐,即使读写分离也不会提升太多性能,Redis在生产上的主要问题是考虑容量,单机最多10-20G,key太多降低Redis性能.因此采用分片集群结构,已经能保证了我们的性能。其次,用上了读写分离后,还要考虑主从一致性,主从延迟等问题,徒增业务复杂度。
读写分离通常适用于以下情况:
高读负载: 当应用程序的读操作远远超过写操作时,读写分离可以显著提高性能。例如,线上服务通常面对的是大量的读请求和相对较少的写请求。
磁盘I/O瓶颈: 对于非内存型数据库,如果遇到磁盘I/O瓶颈,读写分离可以通过分散读请求到多个从服务器,减少对单个磁盘的I/O请求,从而提高性能。
数据备份和报表分析: 如果需要进行数据备份或报表分析,而这些操作对性能要求不高,可以在从服务器上执行,以避免影响到主服务器的性能。
跨地域访问: 当用户分布在不同地理位置时,可以通过在不同区域部署从服务器来减少延迟,优化用户的读取体验。
容错和高可用性: 在某些高可用性要求的场景中,读写分离可以在主服务器不可用时,仍然保持读取操作的可用性。
写入性能不是瓶颈: 在Redis等内存数据库中,由于内存操作的速度非常快,主节点的写入通常不会成为瓶颈,这时读写分离带来的性能提升可能并不明显。
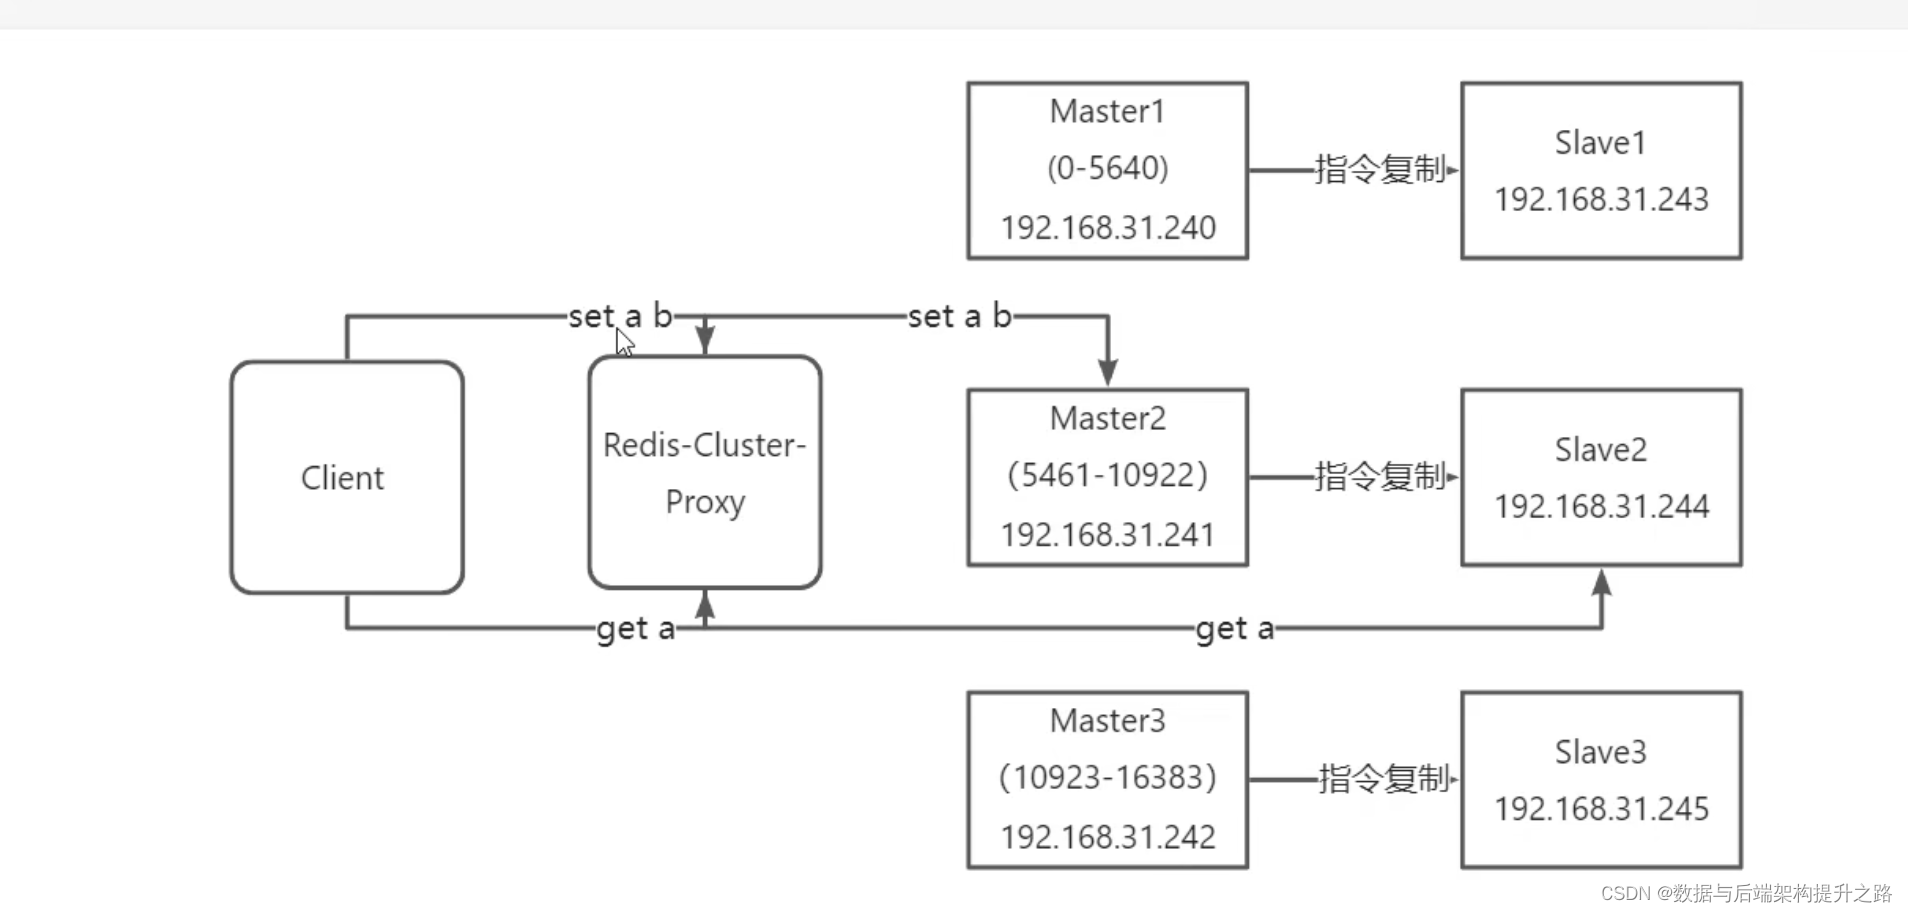
这张图展示的是一个带有读写分离的 Redis 集群架构。原理如下:
客户端请求:
- 客户端(Client)执行读写操作,但不直接与 Redis 节点通信。
代理层:
- 所有的客户端请求都通过 Redis 集群代理(Redis-Cluster-Proxy)进行。这个代理负责将请求路由到正确的节点。
写操作(set a b):
- 写请求(例如
set a b)被代理发送到负责键a的主节点(Master)。- Redis 集群根据一致性哈希或其他算法决定键
a应该由哪个主节点处理。- 在这个示例中,集群分为三个主节点,每个节点处理一定范围的哈希槽。比如,Master1 处理 0-5640 范围的哈希槽。
读操作(get a):
- 读请求(例如
get a)同样经过代理层,但它可以被路由到主节点或其相应的从节点(Slave)。- 读写分离的目的是为了减轻主节点的负担。读请求可以由任何拥有相关数据副本的从节点来处理。
数据同步:
- 当主节点有数据写入时,它会将数据更改同步到从节点,以保持数据一致性。
高可用性:
- 如果主节点发生故障,其中一个从节点可以被提升为新的主节点,以维护服务的可用性和数据的一致性。
这种架构使得 Redis 能够处理高并发场景,通过分散读操作到从节点,来提高整体性能。同时,通过复制确保数据的高可用性和冗余。这种模式在需要快速读取操作和数据持久化的应用场景中非常常见。
问题8:Redis 序列化方式有哪些?
当我们的数据存储到Redis的时候,我们的键(key)和值(value)都是通过Spring提供的Serializer序列化到数据库的。RedisTemplate默认使用的是JdkSerializationRedisSerializer,StringRedisTemplate默认使用的是StringRedisSerializer。
Spring Data JPA为我们提供了下面的Serializer:GenericToStringSerializer、Jackson2JsonRedisSerializer、JacksonJsonRedisSerializer、JdkSerializationRedisSerializer、OxmSerializer、StringRedisSerializer。
序列化方式对比:
JdkSerializationRedisSerializer: 使用JDK提供的序列化功能。 优点是反序列化时不需要提供类型信息(class),但缺点是需要实现Serializable接口,还有序列化后的结果非常庞大,是JSON格式的5倍左右,这样就会消耗redis服务器的大量内存。
Jackson2JsonRedisSerializer: 使用Jackson库将对象序列化为JSON字符串。优点是速度快,序列化后的字符串短小精悍,不需要实现Serializable接口。但缺点也非常致命,那就是此类的构造函数中有一个类型参数,必须提供要序列化对象的类型信息(.class对象)。 通过查看源代码,发现其只在反序列化过程中用到了类型信息。
问题9:Redis 如何做异步队列?
一般使用list结构作为队列,rpush生产消息,lpop消费消息。当lpop没有消息的时候,要适当sleep一会再重试。
如果不用sleep呢?list还有个指令叫blpop,在没有消息的时候,它会阻塞住直到消息到来。
能不能生产一次消费多次呢?
使用pub/sub主题订阅者模式,可以实现1:N的消息队列。pub/sub有什么缺点?在消费者下线的情况下,生产的消息会丢失,得使用专业的消息队列如rabbitmq等。
redis如何实现延时队列?使用sortedset,拿时间戳作为score,消息内容作为key调用zadd来生产消息,消费者用zrangebyscore指令获取N秒之前的数据轮询进行处理

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献14条内容

所有评论(0)