elasticsearch 快速入门
ES作为一个索引及搜索服务,对外提供丰富的REST接口,测试的话就用head 插件进行测试,从而快速的熟悉ES的使用方法及流程
1.创建索引库
ES的索引库是一个逻辑概念,它包括了分词列表及文档列表,同一个索引库中存储了相同类型的文档。它就相当于MySQL中的表,或相当于Mongodb中的集合。
索引
索引(名词):ES是基于Lucene构建的一个搜索服务,它要从索引库搜索符合条件索引数据。
索引(动词):索引库刚创建起来是空的,将数据添加到索引库的过程称为索引。
es 创建索引库
1.使用head 插件.没有安装的可以参考 概念及安装
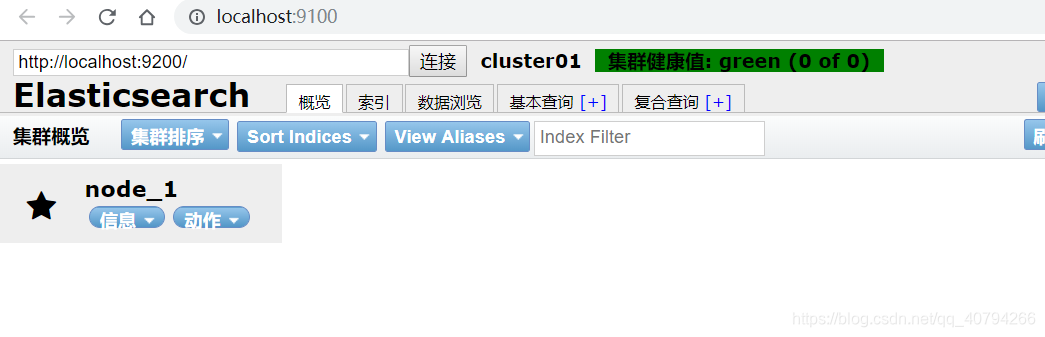
使用浏览器访问 head
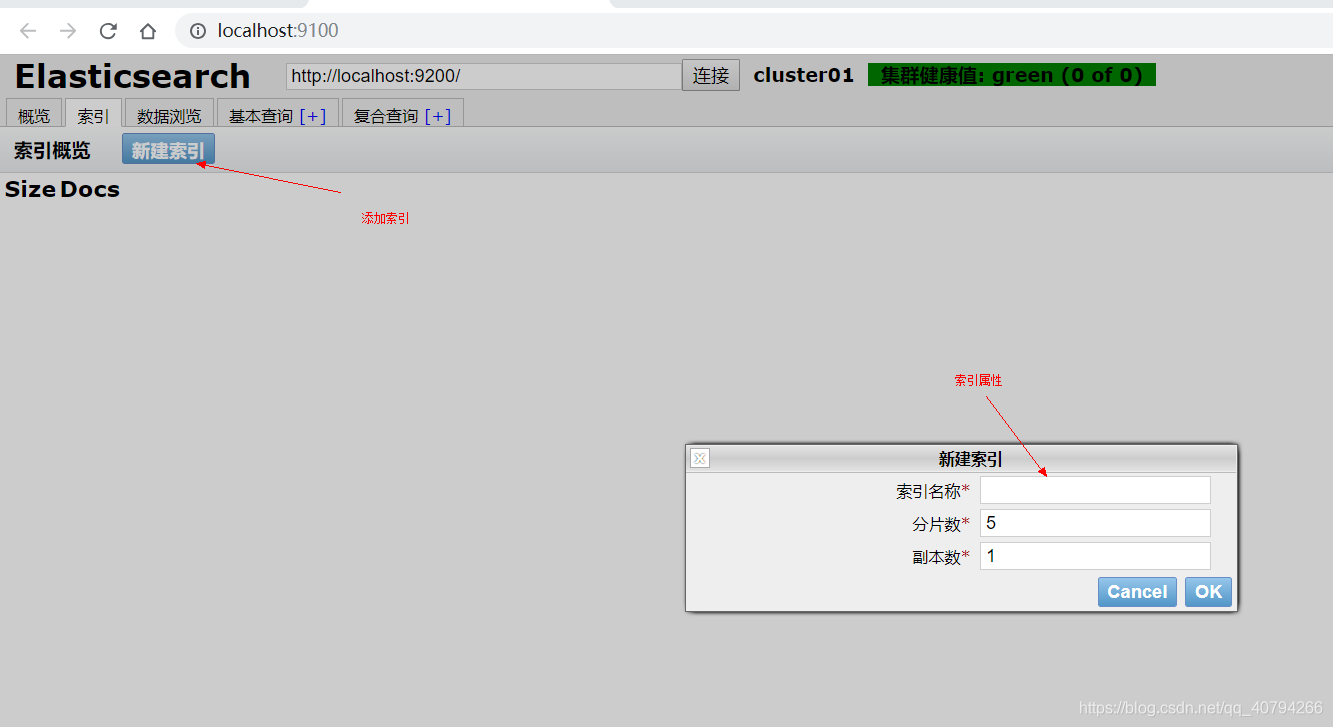
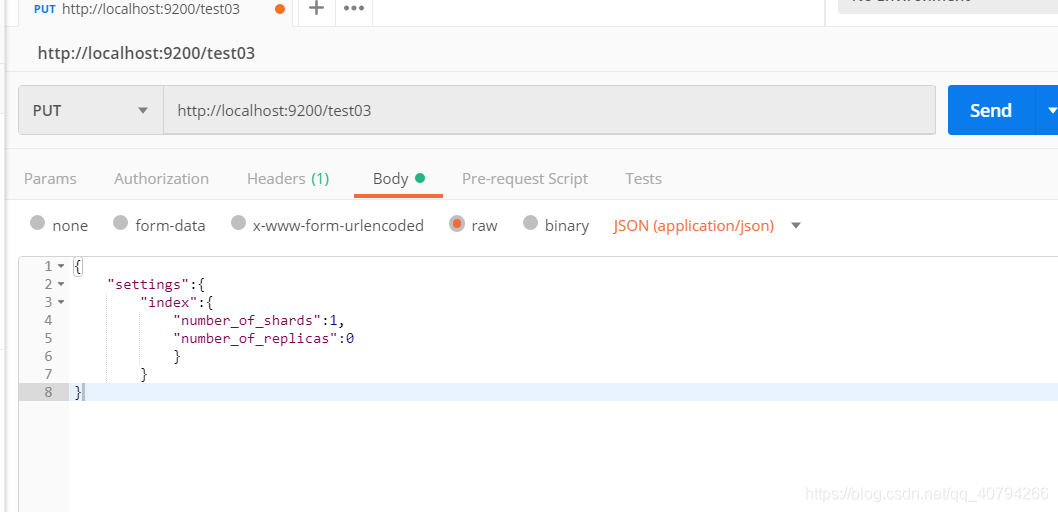
number_of_shards:设置分片的数量,在集群中通常设置多个分片,表示一个索引库将拆分成多片分别存储不同的结点,提高了ES的处理能力和高可用性,入门程序使用单机环境,这里设置为1。
number_of_replicas:设置副本的数量,设置副本是为了提高ES的高可靠性,单机环境设置为0.
添加索引
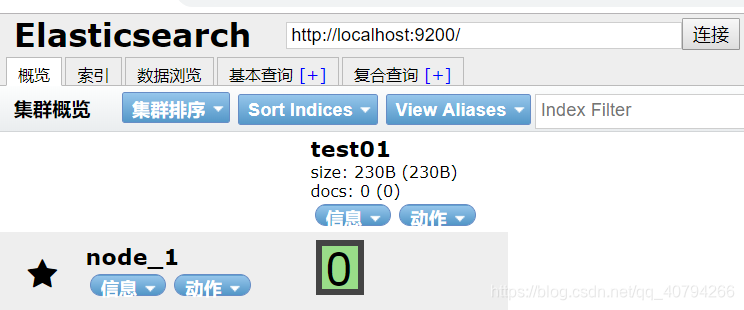
查看索引库
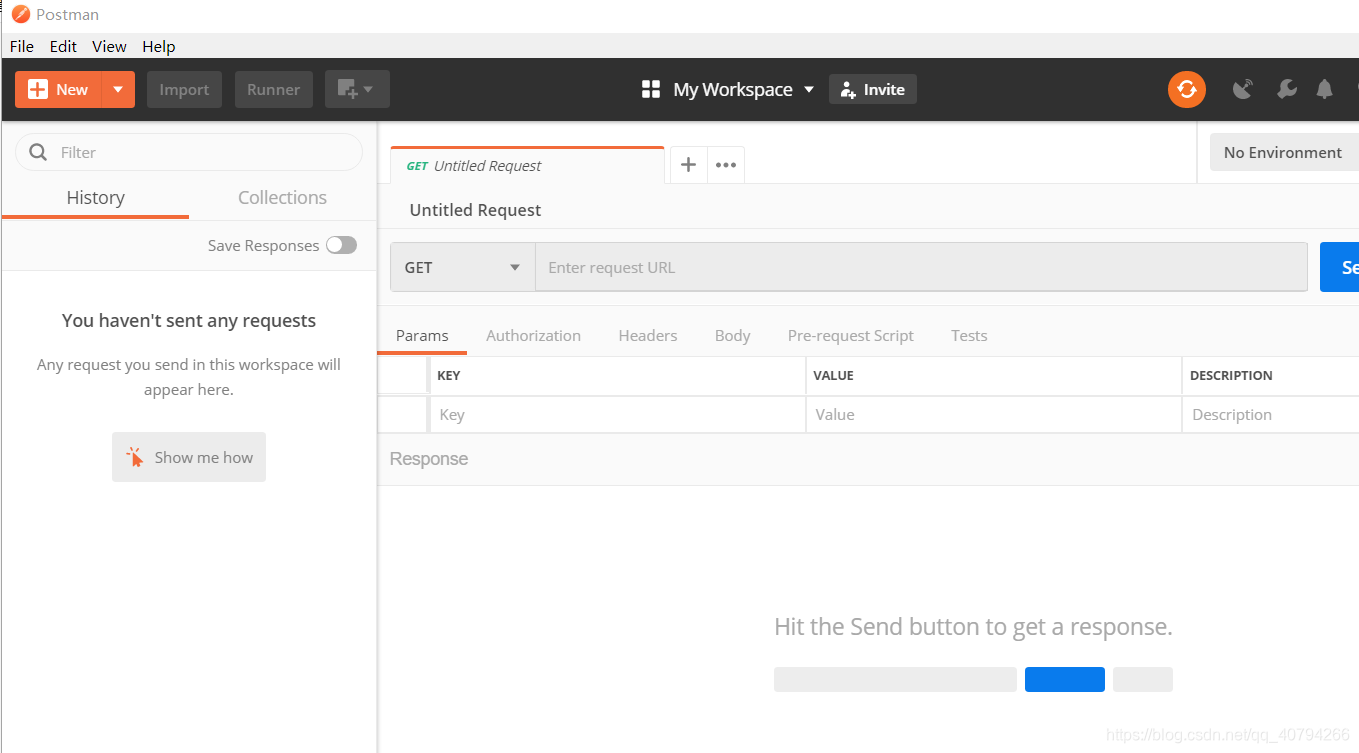
2.使用httpclient 工具
我选择的是使用postman,挺好用的一款软件(主要是ui设计的比较体面),
es 提供的restful 接口为
put http://localhost:9200/索引库名称
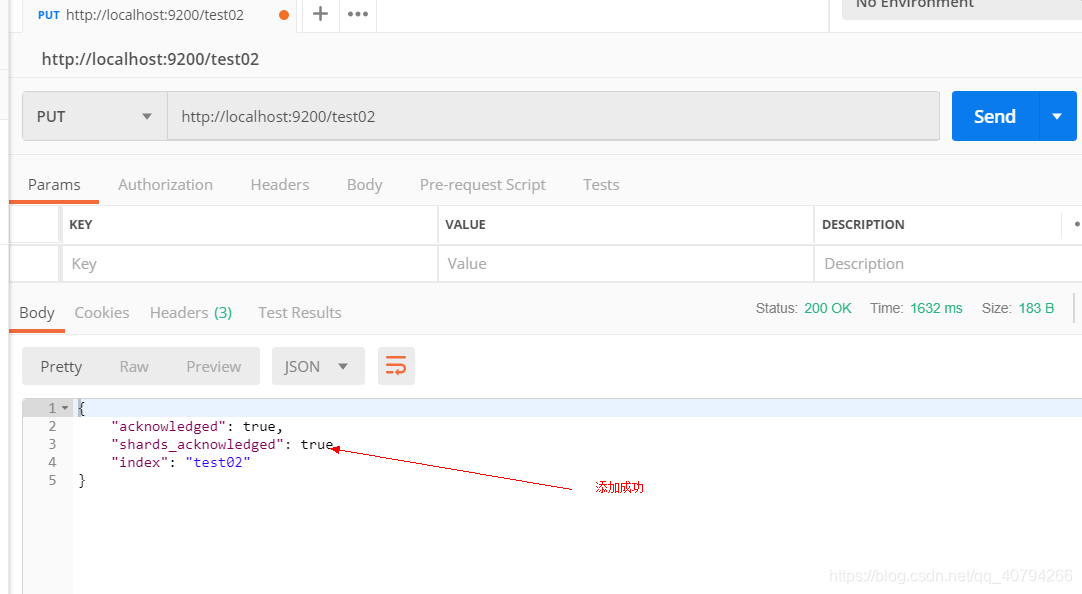
如果要设置分片数,和副本数的需要 可以设置请求体
3.创建映射
什么是映射?
在索引中每个文档都包括了一个或多个field,创建映射就是向索引库中创建field的过程
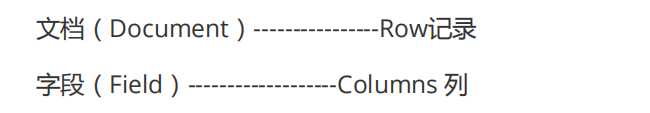
注意:6.0之前的版本有type(类型)概念,type相当于关系数据库的表,ES官方将在ES9.0版本中彻底删除type。
emmm,索引库 到底算是数据库还是表??
如果索引库相当于数据库的话 一个索引库可以存不同类型的文档
如果相当于表就表示一个索引库只能存储相同类型的文档,ES官方建议 在一个索引库中只存储相同类型的文档
添加映射
es 提供的 restful 接口为
post http://localhost:9200/索引库名称/类型名称/_mapping
我们创建三个映射字段 分别为 name ,desc,price
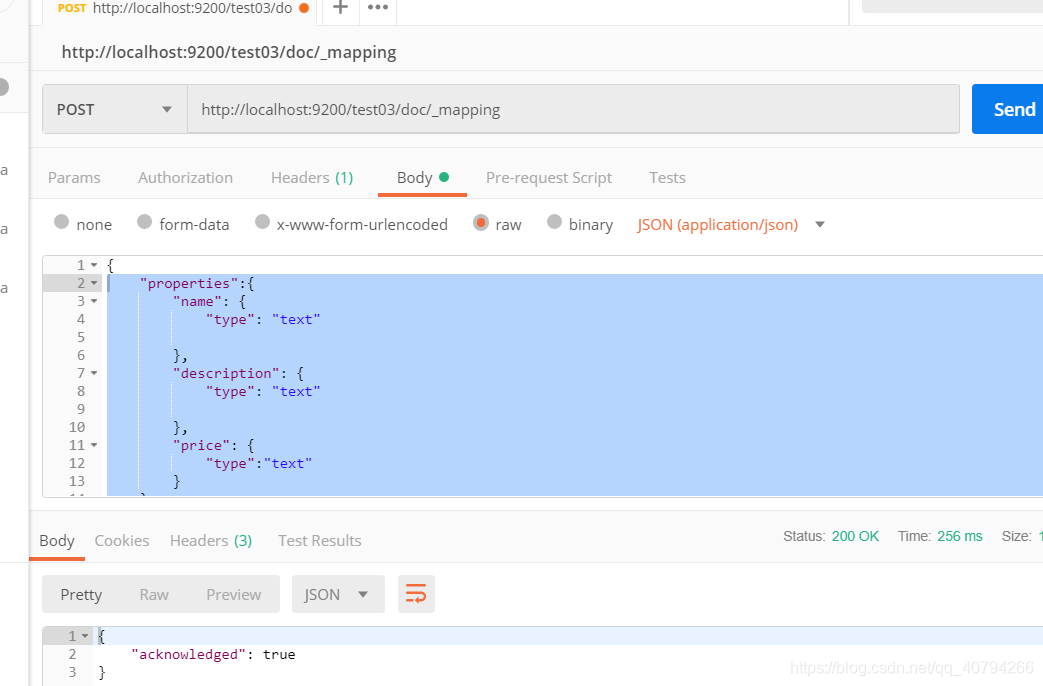
由于ES6.0版本还没有将type彻底删除,所以暂时把type起一个没有特殊意义的名字。
doc是类型名,可以自定义,在ES6.0中要弱化类型的概念,给它起一个没有具体业务意义的名称。
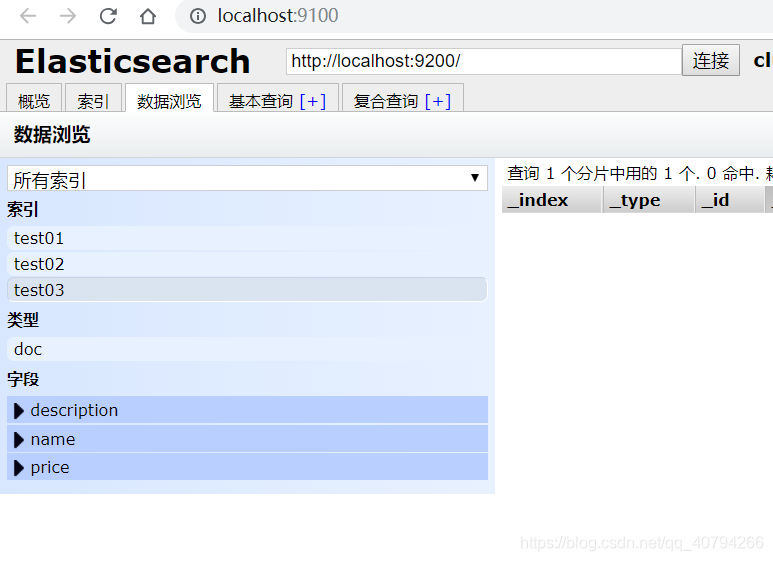
我们使用head 插件来看创建的映射 ,
4.创建文档
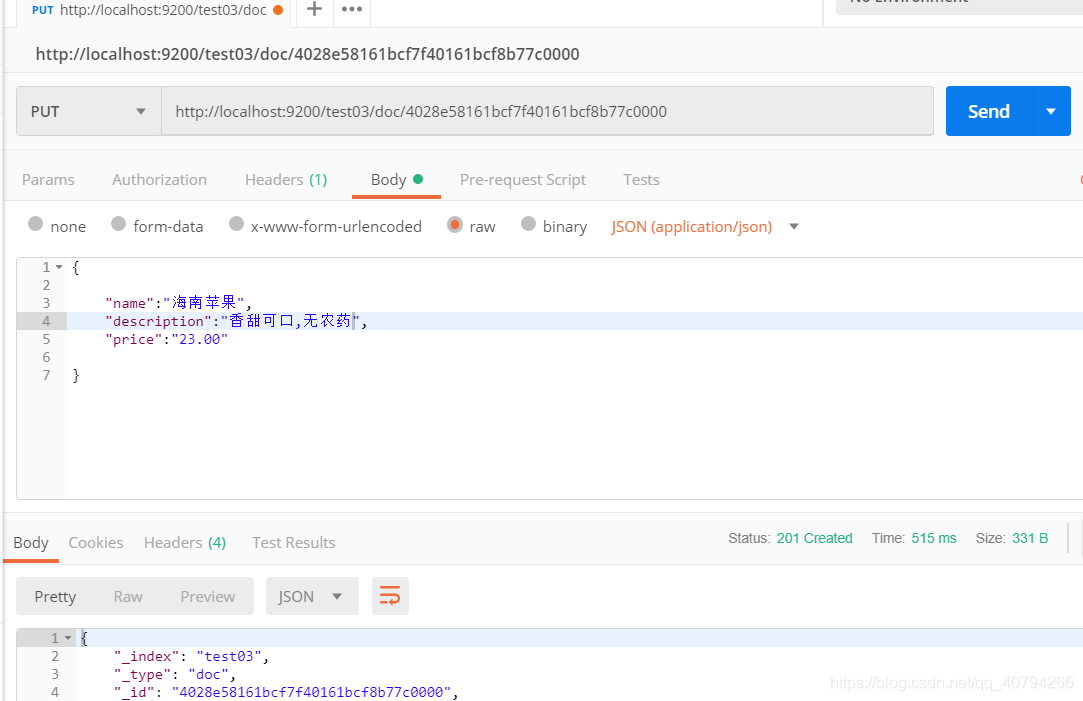
es添加文档对外提供的restful 接口为
put 或Post http://localhost:9200/xc_course/doc/id值 (如果不指定id值ES会自动生成ID)
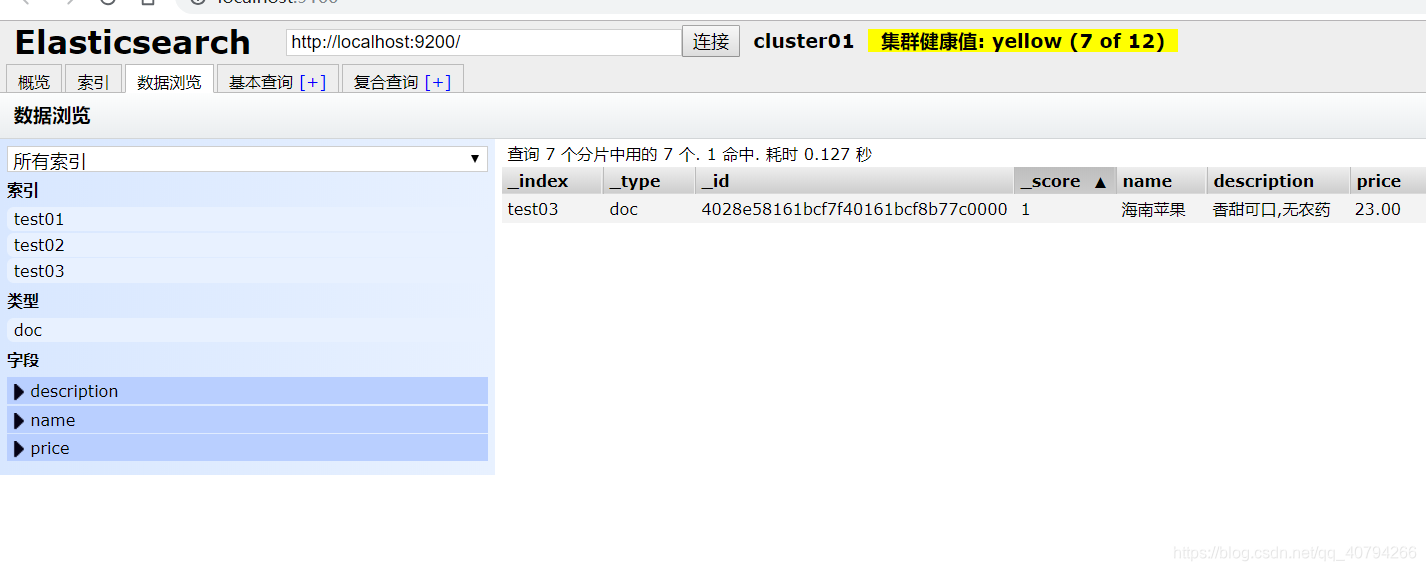
使用head 查看
5. 搜索文档
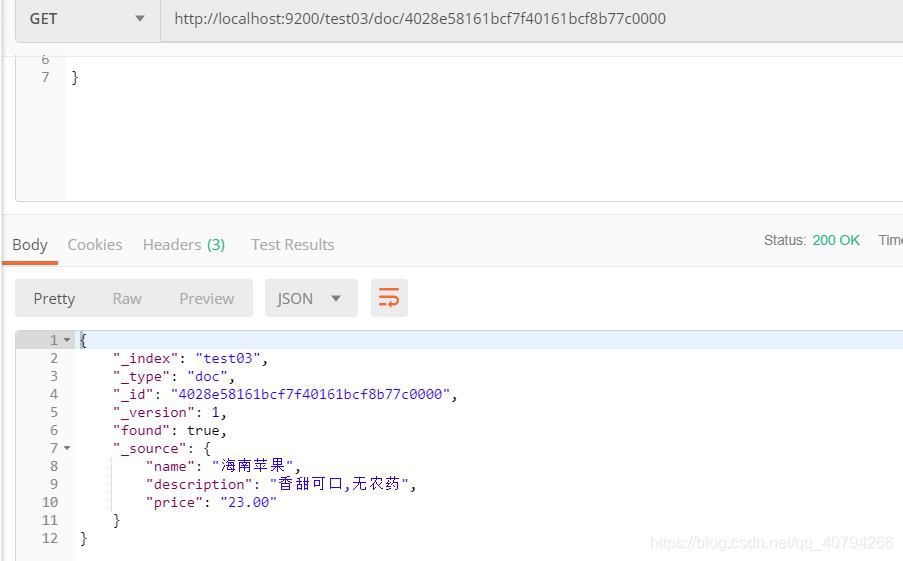
id 查询
restful 接口
get http://localhost:9200/索引名/type/id
2.查询所有记录
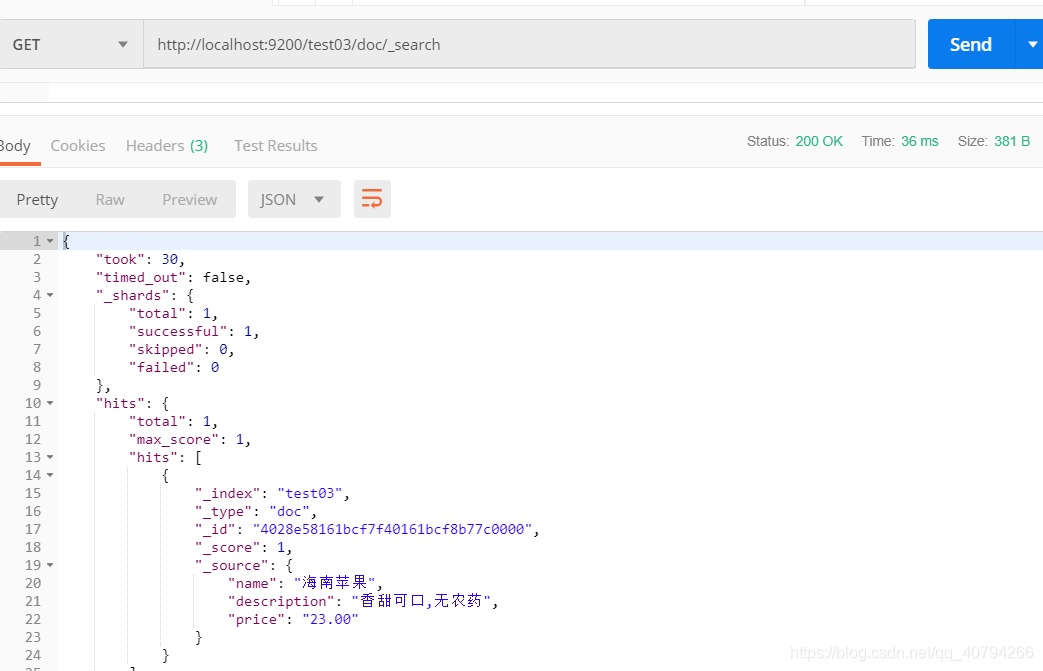
根据字段查询数据
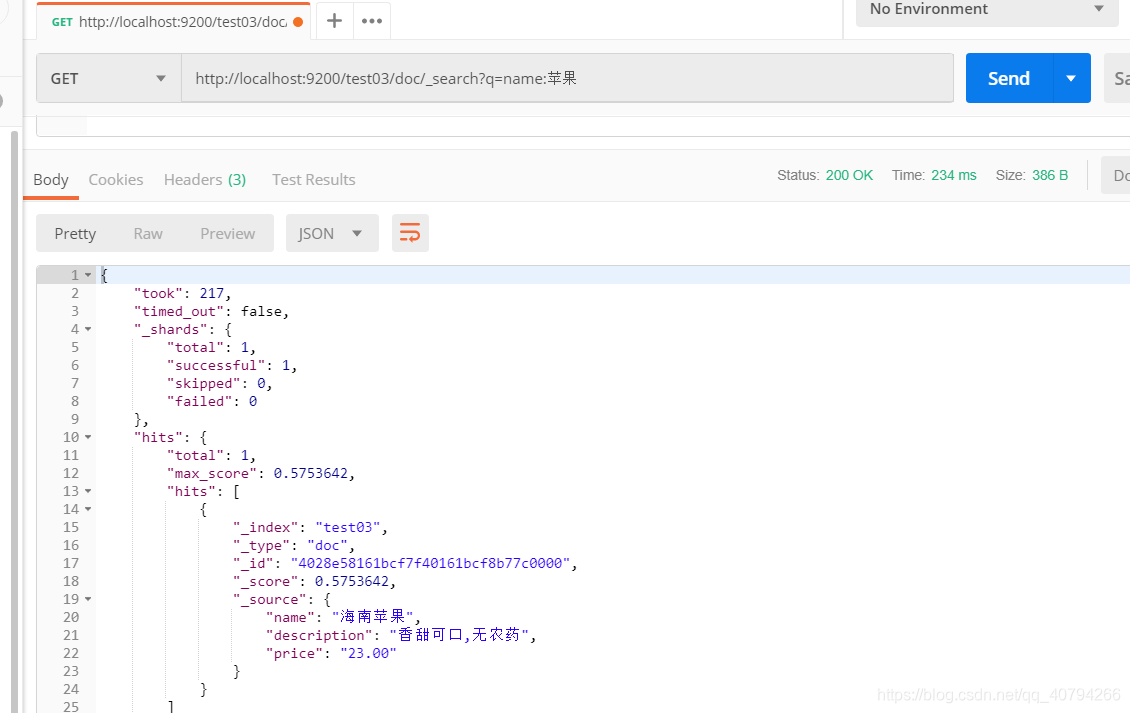
took:本次操作花费的时间,单位为毫秒。
timed_out:请求是否超时_
shards:说明本次操作共搜索了哪些分片
hits:搜索命中的记录
hits.total : 符合条件的文档总数
hits.hits :匹配度较高的前N个文档
hits.max_score:文档匹配得分,这里为最高分
_score:每个文档都有一个匹配度得分,按照降序排列。
_source:显示了文档的原始内容。
IK分词器
在添加文档时会进行分词,索引中存放的就是一个一个的词(term),当你去搜索时就是拿关键字去匹配词,最终找到词关联的文档。
测试当前索引库使用的分词器:
post 发送:localhost:9200/_analy
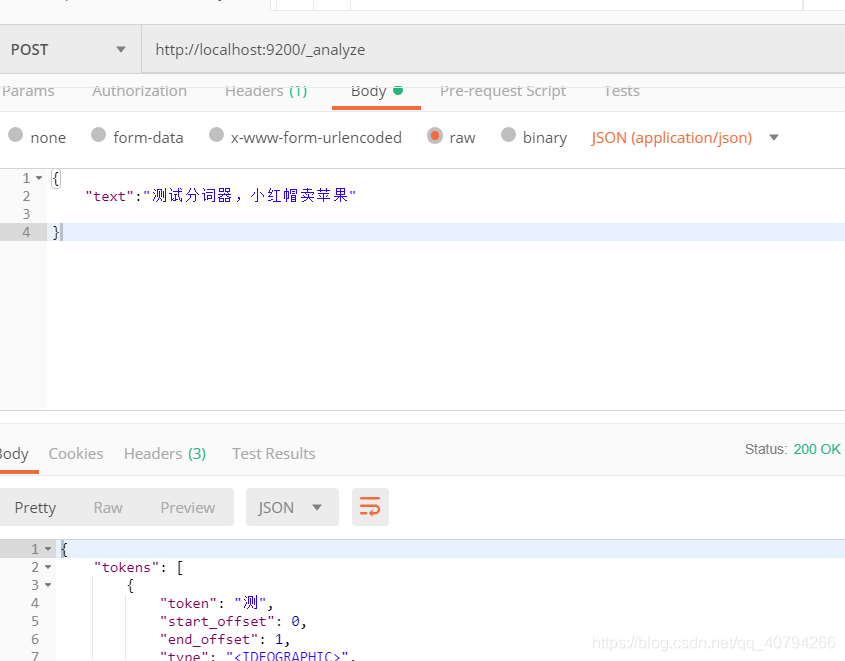
会发现分词的效果将 “测试” 这个词拆分成两个单字“测”和“试”,这是因为当前索引库使用的分词器对中文就是单字分词
安装ik 分词器
使用IK分词器可以实现对中文分词的效果。是一款很火的分词器
(Github地址:https://github.com/medcl/elasticsearch-analysis-ik)
解压,并将解压的文件拷贝到ES安装目录的plugins下的ik目录下
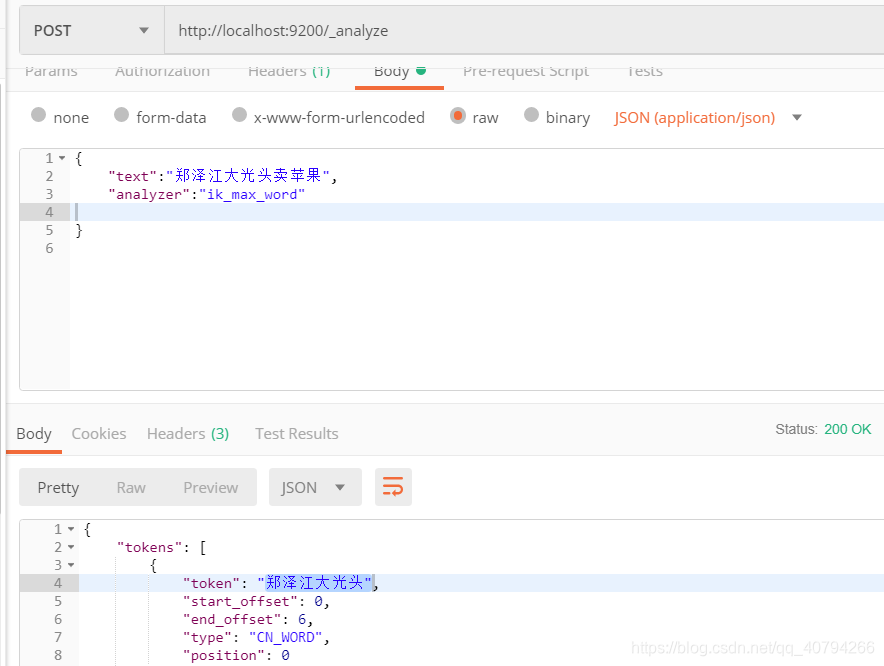
重启es ,测试分词器
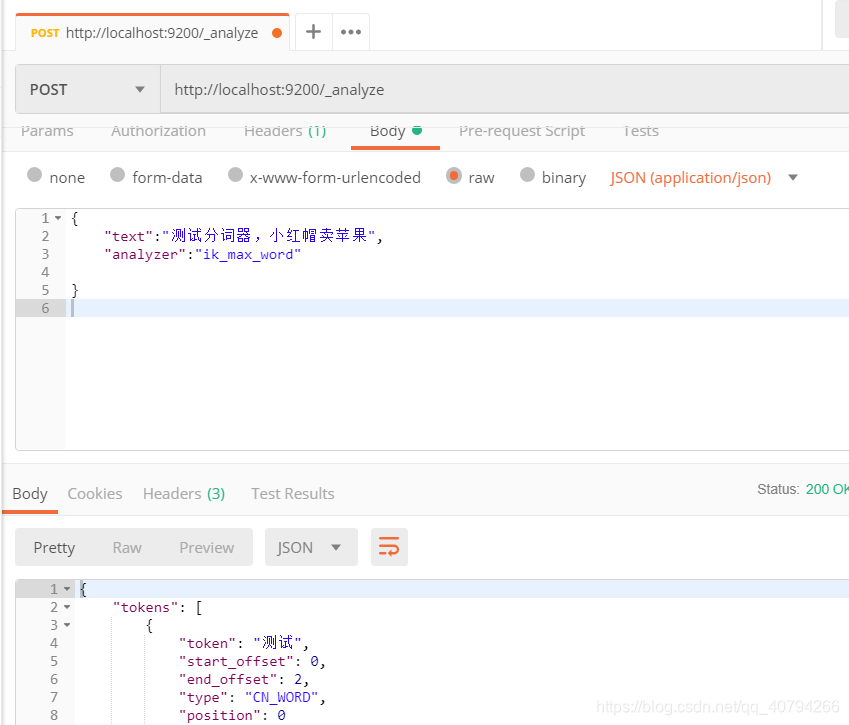
分词器模式 :
ik_max_word: 大颗粒度分词,会将文本做最细粒度的拆分,比如会将“中华人民共和国人民大会堂”拆分为“中华人民共和国、中华人民、中华、华人、人民共和国、人民、共和国、大会堂、大会、会堂等词语。
ik_smart:会做最粗粒度的拆分,比如会将“中华人民共和国人民大会堂”拆分为中华人民共和国、人民大会堂。
使用粗颗粒度 会使搜索到的数据更有准确性,但是细颗粒度能让搜索数据更多
自定义词库
如果要让分词器支持一些专有词语,可以自定义词库。iK分词器自带一个main.dic的文件,此文件为词库文件。
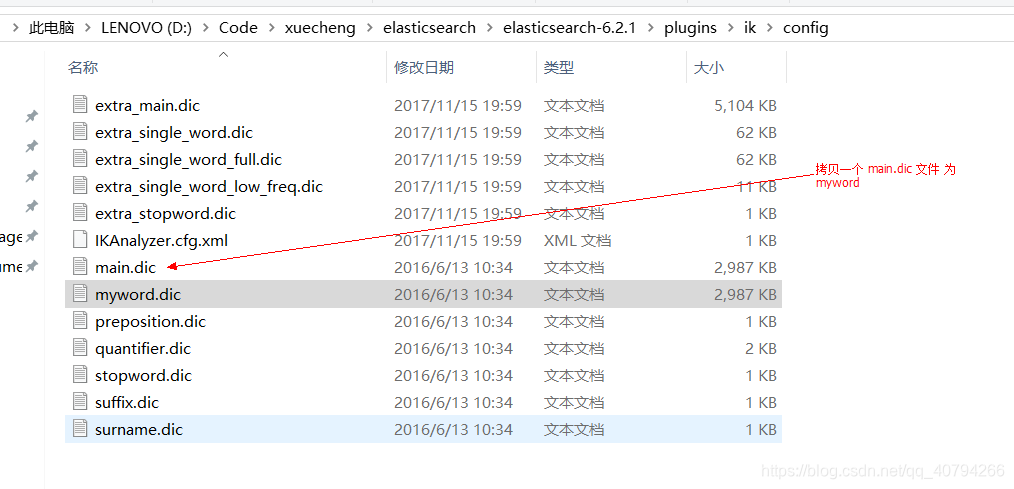
在myword.dic 中添加分词,每个分词占一行
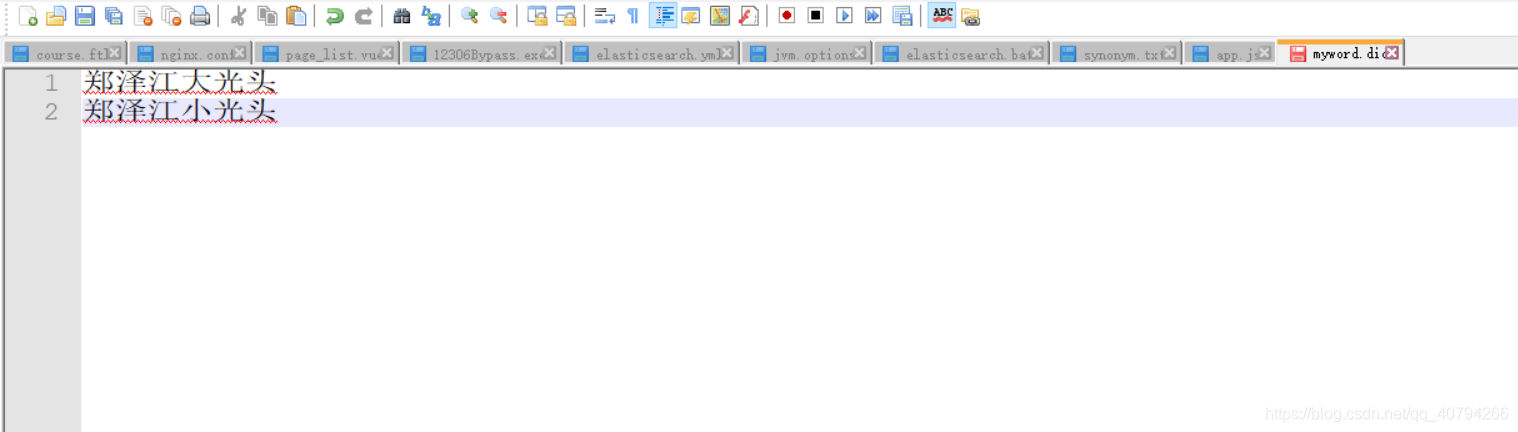
保存的时候设置 编码格式为 UTF-8无bom格式编码
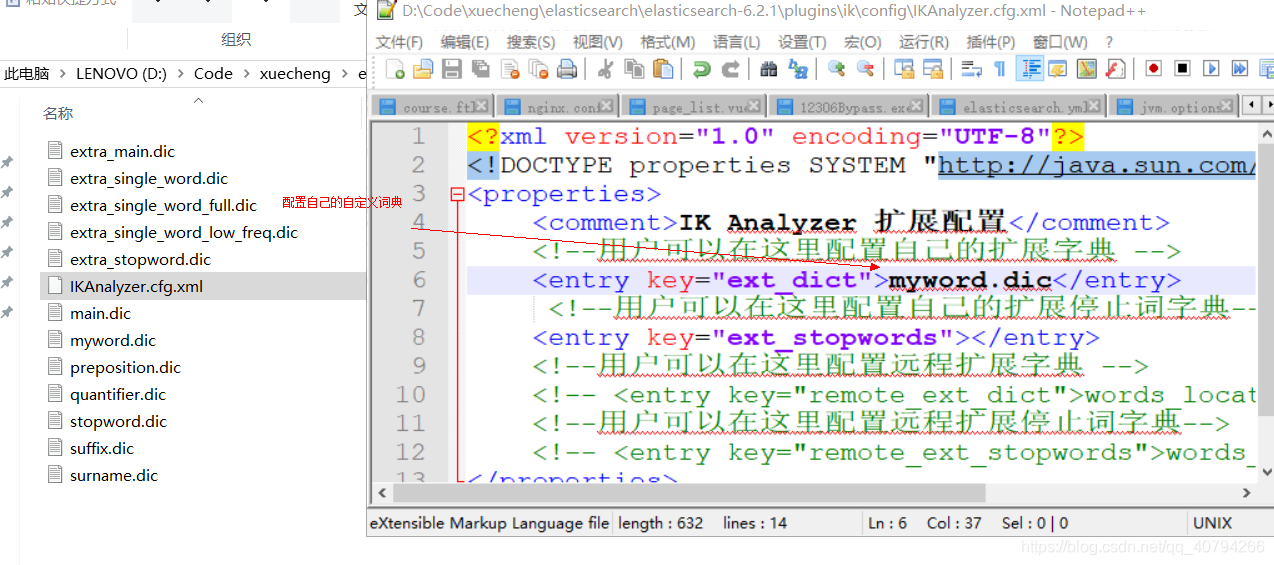
重启es,测试分词器
映射
下面是es 的数据类型
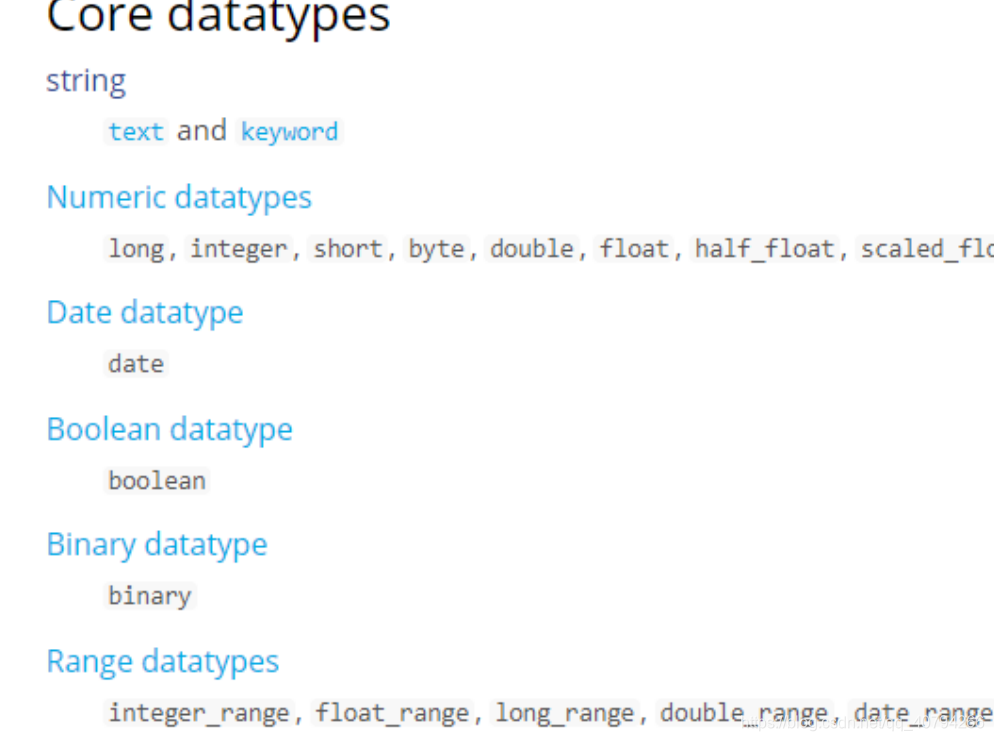
字符串包括text和keyword两种类型:
1.text
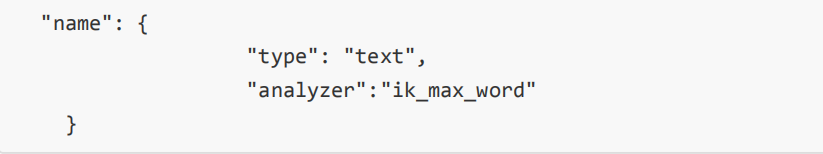
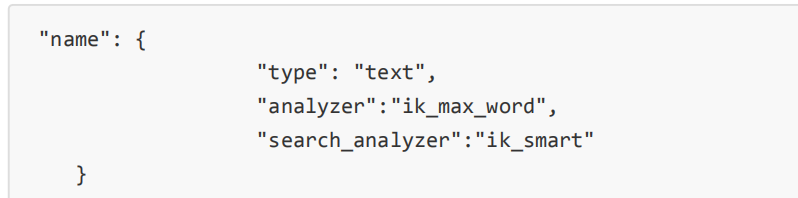
上边索引和收索时都是使用粗颗粒度分解,如果需要单独设置收索时的使用的分词器 ,可以单独设置 search_analyzer属性
下边使用的是细颗粒度索引入库,粗颗粒度收索,增加搜索精确性
2.keyword
上边介绍的text文本字段在映射时要设置分词器,keyword字段为关键字字段,通常搜索keyword是按照整体搜索,所以创建keyword字段的索引时是不进行分词的,比如:邮政编码、手机号码、身份证等。keyword字段通常用于过虑、排序、聚合等。
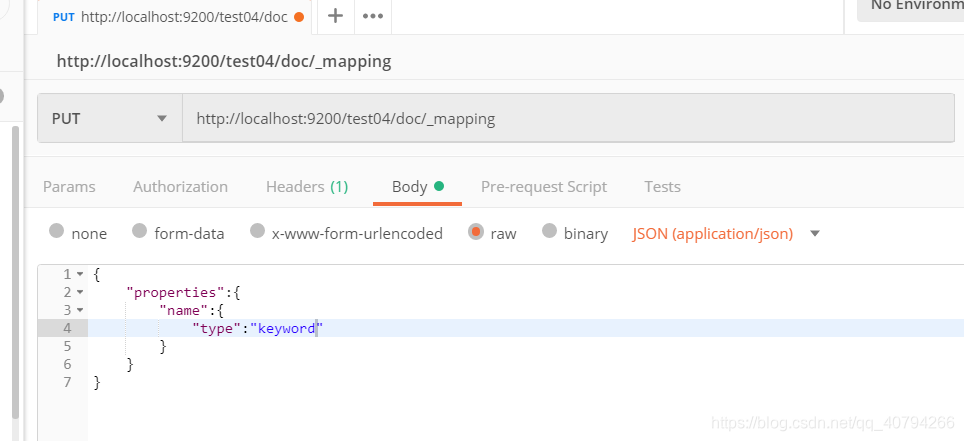
因为name 是keyword 类型,所以查询的时候需要精确查询
3.日期类型 data
日期类型不用设置分词器。通常日期类型的字段用于排序。
1. format
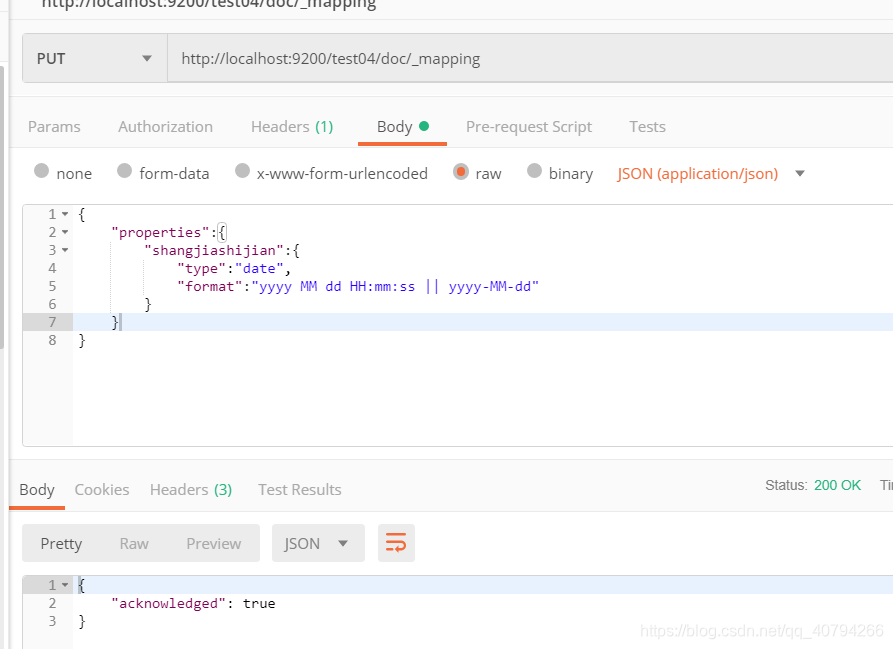
通过format设置日期格式
下边的设置允许date字段存储年月日时分秒、年月日 俩种格式。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)