java--哈希表(hash)
hash
哈希的引入
顺序结构以及二叉搜索树中,元素与其存储位置之间没有对应关系,因此在查找一个元素时,必须要经过多次比较。顺序查找时间复杂度为O(N),二叉搜索树中为树的高度,即O(log2n).
哈希的思想是不经过任何比较,一次直接从表中得到要搜索的元素。( 如果构造一种存储结构,通过某种函数(hashFunc)使元素的存储位置与其之间能够建立一一映射的关系,那么在查找时通过该函数可以很快找到该元素的)
当向该结构中:
-
插入元素
根据待插入元素的值,以此函数计算出该元素的存储位置并按此位置进行存放 -
搜索元素
对元素的值进行同样的计算,把求得的函数值当做元素的存储位置,在结构中按此位置取元素比较,若值相等,则搜索成功
该方式即为哈希(散列)方法,哈希方法中使用的转换函数称为哈希(散列)函数,构造出来的结构称为哈希表(Hash Table)(或者称散列表)
都是干巴巴的概念,举个例子吧
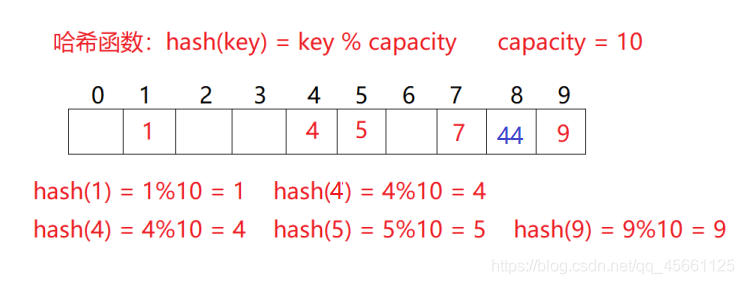
例如:数据集合{1,7,6,4,5,9};
哈希函数设置为:hash(key) = key % capacity; capacity为存储元素底层空间总的大小。
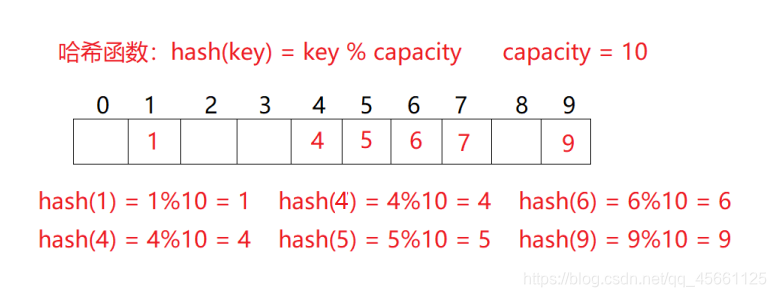
用该方法进行搜索不必进行多次的比较,因此搜索的速度比较快
但按照上述哈希方式,向集合中插入元素44,会出现44的位置已被占用,那么该怎么办呢?便是接下来的哈希冲突了。
哈希冲突
不同值通过相同哈希哈数计算出相同的哈希地址,该种现象称为哈希冲突或哈希碰撞。(都是关键啊)
避免冲突
首先,我们需要明确一点,由于我们哈希表底层数组的容量往往是小于实际要存储的数据的数量的,这就导致一 个问题,冲突的发生是必然的,我们能做的应该是尽量的降低冲突率。
设计合适的哈希函数
引起哈希冲突的一个原因可能是:哈希函数设计不够合理(找源头呗)。
哈希函数设计原则:
- 哈希函数的定义域必须包括需要存储的数据(你要存的元素,没有他们你要干啥啊?),而如果散列表允许有m个地址时,其值域必须在0到m-1 之间(你都出界了,怎么存啊)
- 哈希函数计算出来的地址能均匀分布在整个空间中(每个数据的概率相等,不然都算的是一个地址还是冲突啊)
- 哈希函数应该比较简单
常见哈希函数
- 1.直接定制法–(常用)
取数据的某个线性函数为散列地址:Hash(Key)= A*Key + B
优点:简单、均匀
缺点:需要事先知道关键字的分布情况
使用场景:适合查找比较小且连续的情况
- 2.除留余数法–(常用)就上面举例用的方法
设散列表中允许的地址数为m,取一个不大于m,但最接近或者等于m的质数p作为除数,按照哈希函数:Hash(key) = key% p(p<=m),将关键码转换成哈希地址。
其他的话还有平方取中法,折叠法,数学分析法等等,这里就不具体讲了。
负载因子的调节(重点)
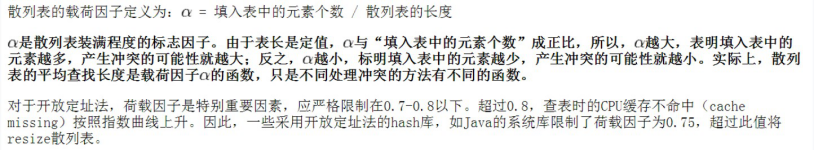
负载因子和冲突率的关系粗略演示
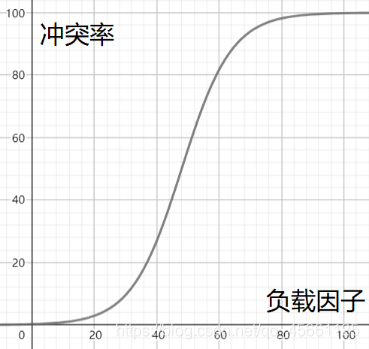
负载因子和冲突率成正比关系,我们需要通过降低负载因子来降低冲突率。 但哈希表要添加数据的个数是不可变的,那我们能调整的就只有哈希表中的数组的大小。
解决冲突
闭散列(开放地址法)
闭散列:也叫开放定址法,当发生哈希冲突时,如果哈希表未被装满,说明在哈希表中必然还有空位置,那么可以 把key存放到冲突位置中的“下一个” 空位置中去。那如何寻找下一个空位置呢?
- 线性探测
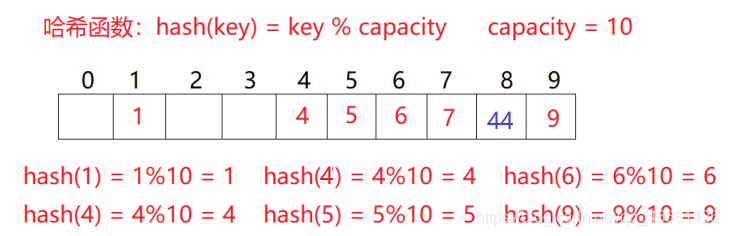
比如上面的场景,现在需要插入元素44,先通过哈希函数计算哈希地址,下标为4,因此44理论上应该插在该位置,但是该位置已经放了值为4的元素,即发生哈希冲突。
线性探测:从发生冲突的位置开始,依次向后探测,直到寻找到下一个空位置为止。
- 插入
通过哈希函数获取待插入元素在哈希表中的位置
如果该位置中没有元素则直接插入新元素,如果该位置中有元素发生哈希冲突,使用线性探测找到 下一个空位置,插入新元素
- 删除
采用闭散列处理哈希冲突时,不能随便物理删除哈希表中已有的元素,若直接删除元素会影响其他 元素的搜索。比如删除元素4,如果直接删除掉,44查找起来可能会受影响。因此线性探测采用标记的伪删除法来删除一个元素。
- 二次探测
线性探测的缺陷是产生冲突的数据堆积在一块(这与其找下一个空位置有关系,因为找空位置的方式就是挨着往后逐个去找)因此二次探测为了避免该问题,找下一个空位置的方法为:新位置 = (原位置 +i的平方 )% 数组长度, 其中:i = 1,2,3…,
对于上边如果要插入44,产生冲突,如果用线性探测的话,会插入到6的位置,但二次探测的话,就插入到了8的位置(新位置=(4+2的平方)%10)
开散列(链地址法)重点
开散列法又叫链地址法(开链法),首先对数据集合用散列函数计算散列地址,具有相同地址的关键码归于同一子集合,每一个子集合称为一个桶,各个桶中的元素通过一个单链表链接起来,各链表的头结点存储在哈希表中。
但在java8之后,当链表的长度大于8或者数组的长度大于64时会使查询的性能降低(O(n)),所以链表将会升级为红黑树的存储方式(Ologn),但链表的长度变为6之后红黑树会降为链表
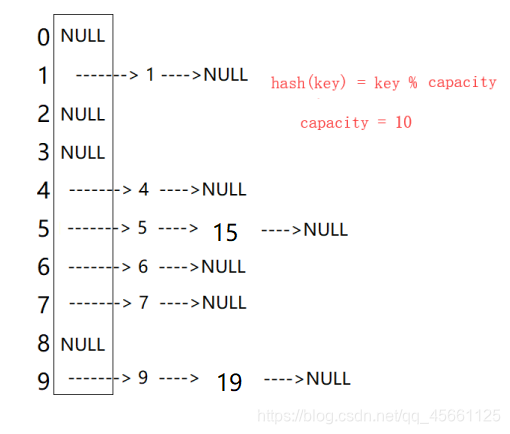
从上图可以看出,开散列中每个桶中放的都是发生哈希冲突的元素。
开散列,可以认为是把一个在大集合中的搜索问题转化为在小集合中做搜索了。
性能分析
虽然哈希表一直在和冲突做斗争,但在实际使用过程中,我们认为哈希表的冲突率是不高的,冲突个数是可控的, 也就是每个桶中的链表的长度是一个常数,所以,通常意义下,我们认为哈希表的插入/删除/查找时间复杂度是 O(1) 。
hash和java类集的关系
- 1.Map 和 Set都是用哈希表实现的
- 2.java 中使用的是哈希桶方式解决冲突的
- 3.java 会在冲突链表长度大于一定阈值后,将链表转变为搜索树(红黑树)
- 4.java 中计算哈希值实际上是调用的类的 hashCode 方法,进行 key 的相等性比较是调用 key 的 equals 方法。所以如果要用自定义类作为 HashMap 的 key 或者 HashSet 的值,必须覆写 hashCode 和 equals方法,而且要做到 equals 相等的对象,hashCode 一定是一致的。(hashcode和equals成对出现)
海量数据处理的问题
面试题:有40亿个不重复的无符号整数(>=0)设计一种算法或者数据结构如何快速的判断某个数n是否在集合中
- 分析:1.数据量非常大,大到常规算法由于内存的大小限制放不下这么多数据2.无符号整数(>=0)3.只判断是否存在
主要思路有两个位图和布隆过滤器
位图(缩小存储空间)
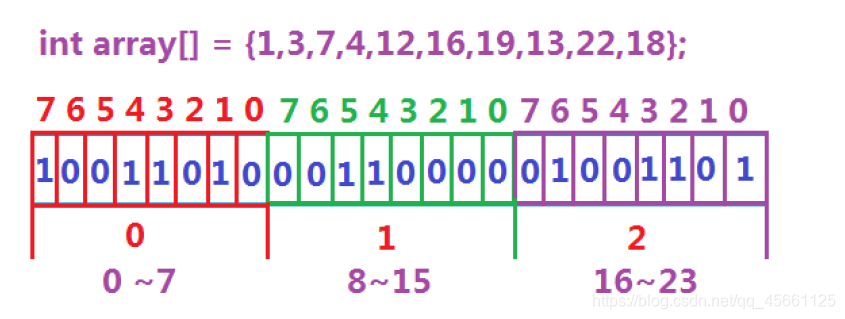
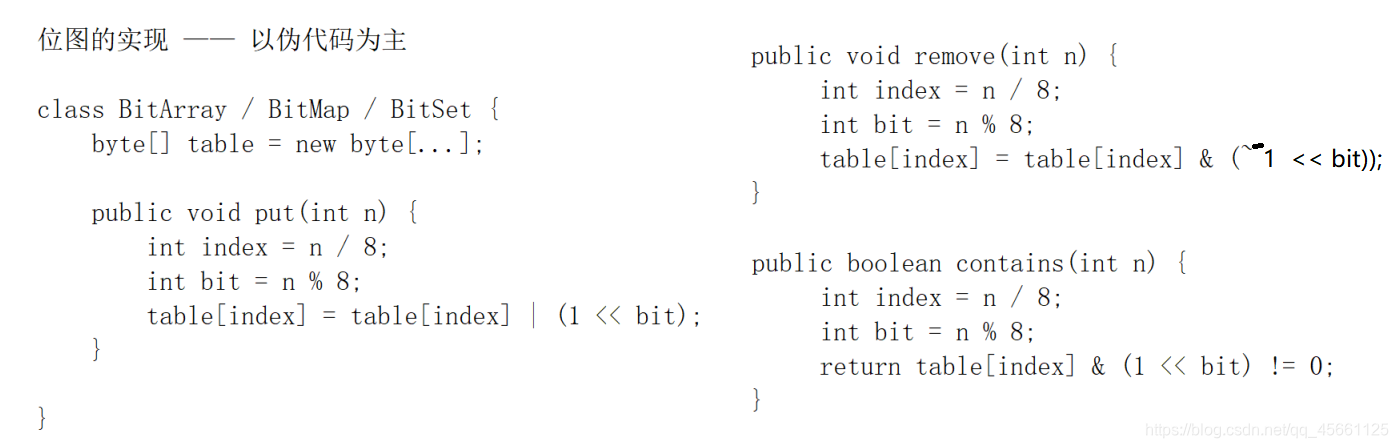
数据是否在给定的整形数据中,结果是在或者不在,刚好是两种状态,那么可以使用一个二进制比特位来代表数据是否存在的信息,如果二进制比特位为1,代表存在,为0代表不存在。比如:
伪代码实现
位图的应用
- 快速查找某个数据是否在一个集合中
- 排序 + 去重
- 求两个集合的交集、并集等
- 操作系统中磁盘块标记
布隆过滤器
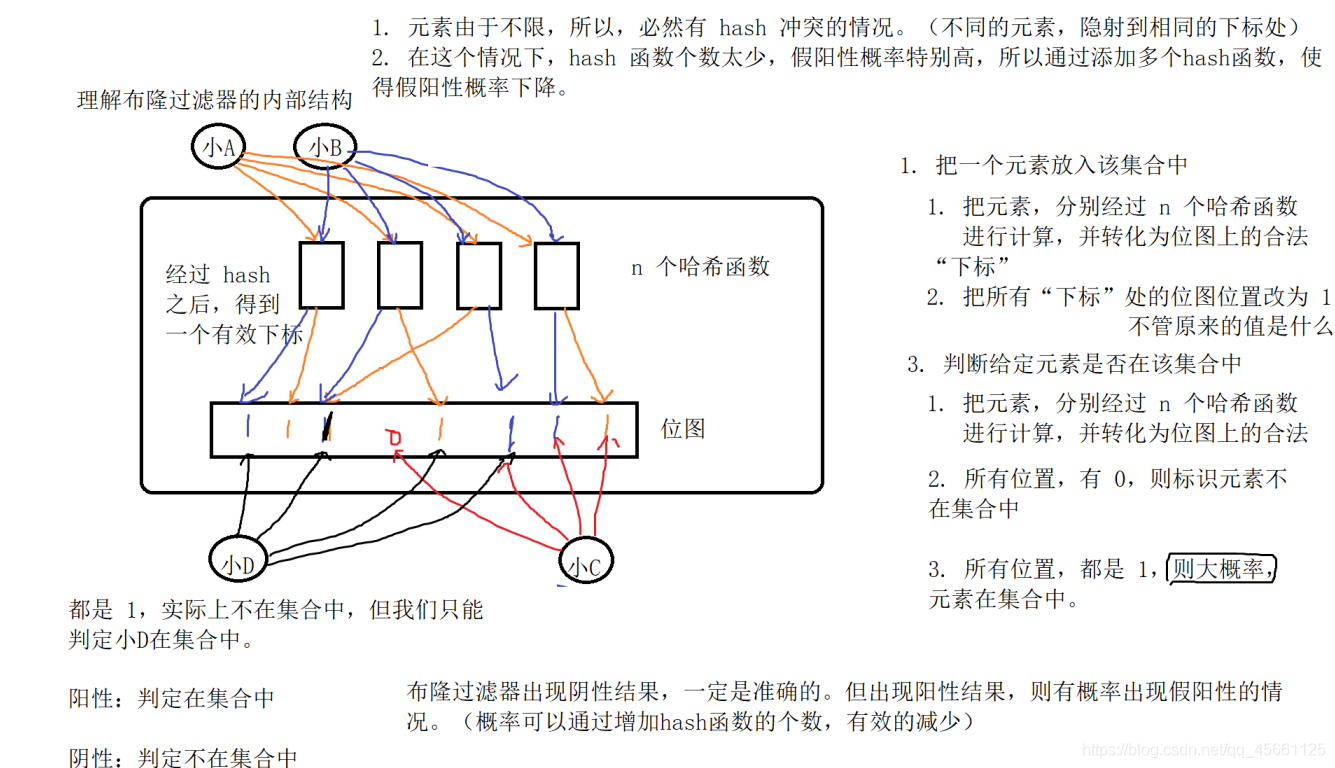
布隆过滤器缺陷
- 有误判率,即存在假阳性(False Position),即不能准确判断元素是否在集合中(补救方法:再建立一个白名单,存储可能会误判的数据)
- 不能获取元素本身
一般情况下不能从布隆过滤器中删除元素- 如果采用计数方式删除,可能会存在计数回绕问题

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 1
 0
- 0


 已为社区贡献8条内容

所有评论(0)