c++和c#中的STL底层(List,ArrayList,hashmap,vector等底层知识)
数组和List和ArrayList的异同
在实际开发过程中我们可能对于数组和ArrayList还有List不以为然
但是他们之间还是有很大的区别的
数组
数组在内存中时连续存储的,所以其索引速度非常快,而且赋值和修改元素也比较简单
但是数组也有一些不足的地方,比如在一个数组中的两个数据中插入一个元素,是比较麻烦的
我们在声明一个数组的时候,必须同时指明数组的长度,数组长度过长会导致内存浪费
数组长度过短,回导致数据溢出的错误
所以在声明数组的时候,我们是必须权衡一个比较完美的数值
c#中提供的ArrayList就完美克服了这些缺点
ArrayList
ArrayList是Syetem.Colllections下的一个部分,它的大小是按照其中存储的数据进行动态扩充和收缩的
所以我们在声明ArrayList对象的时候,完全不用考虑内存的浪费和指定长度的权衡
ArrayList是很方便进行数值的插入,修改,移除等操作的
从上边看ArrayList好像完美的客服了数组中的缺点,那么为什么还要出现List呢?
在ArrayList中可以同时插入不同类型的数据,比如string,char,int等等
因为ArrayList把这些数据当做object来处理的,所以这样是允许的
但是有一个问题,如果我们用ArrayList来处理问题的时候,很可能发生类型不匹配的错误
所以说ArrayList是不安全的
即使我们保证插入数据的时候很小心,但是在使用的时候,我们需要他们都转化成为原来类型来处理
这里就有了拆装箱的操作
可想而知,这样会有巨大的内存消耗
拆装箱:
装箱:把值类型的数据打包到引用类型的实例中去,
拆箱:从引用类型中把原类型的数据提取出来
正因为ArrayList不安全的原因,所以c#也出现了泛型的概念,List正是ArrayList的泛型类
它的大部分用法和ArrayList相似,但是在声明List的时候,必须严格声明器类型
List
List<int> list = new List<int>();
//新增数据
 list.Add(123);
//修改数据
list[0] = 345;
//移除数据
list.RemoveAt(0);
如果此时插入其他类型的数据,就会报错
这样避免了前面所说安全问题和拆装箱消耗邢恩能够的问题了
List泛型的优点:
通过允许指定泛型类或者是方法操作的特定类型,泛型功能将安全的任务从程序员转换到了编译器上
减少了类型强制转换的内存消耗和发生错误的可能性,泛型提供了类型安全,而且没有增加开销
对于底层的知识
ArrayList
ArrayList底层是用数组实现的
对于ArrayList而言,实现List接口,底层使用数组保存所有元素,其操作基本上是对数组的操作
hashmap
map的底层也是使用数组来实现,数组中每一项都是单向链表(链表和数组的结合体)
当链表长度大于一定的阈值,链表转换为红黑树,减少链表的查询时间
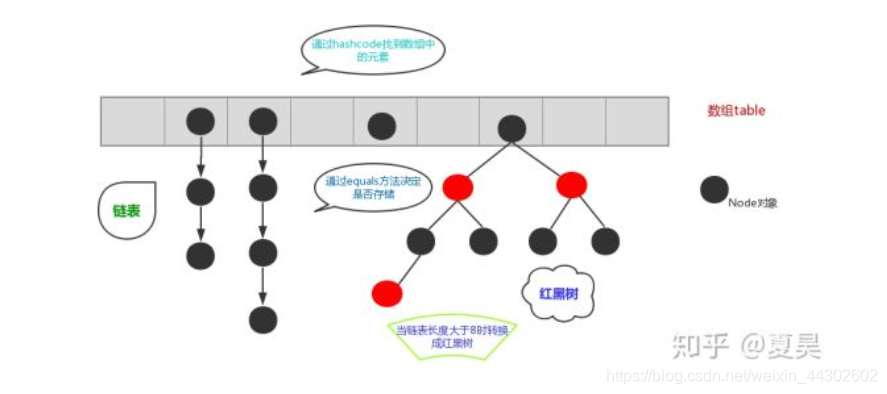
数组特点: 查询效率高,插入删除效率低
**链表特点:**查询效率低,插入删除效率高
在hashmap中使用数组加(链表或者红黑树)可以完美解决数组和链表的问题 使得查询 插入删除效率都比较高
**哈希码:**哈希码和调用其的对象的地址和内容有关
对于同一个对象如果没有被修改,那么无论何时其哈希码都是相同的
对于两个对象 如果其内容不同 其哈希码也可能是相同的
当哈希表插入一个数据的时候
分为两种情况:
1.数组中索引处为空,这种情况直接将元素放入即可
2.数组中索引处不是空,那么我们判断该位置的元素和当前元素是否相等
如果相等我们直接覆盖,如果不相等 我们使用链表或者红黑树的形式存储该元素
如果链表中的元素太多也会影响查找效率,所以当链表元素达到8的时候,链表存储就转换为红黑树存储
因为红黑树是平衡二叉树 在查找性能方面高于链表
List
List容器底层是用双向循环链表实现的,相比双链表的结构的好处是构建List的容器的时候,
只需借助一个指针就可以轻松的表示List的首位元素
set
关于set的底层实现有两种说法,
第一种是c++的STL的set用的是红黑树
第二种是hash_set的hashtable
红黑树和哈希表最大的不同就是红黑树是有序结构,hashtable不是有序结构
如果只是判断set中的元素是否存在,hash显然更加适合,因为set的访问操作复杂度是log(N),而使用hash底层实现hash_set近似O(1)
map和List的区别
List是存储单列数据的集合,存储的数据是可以重复并且有序的
Map存储的是双列数据的集合,通过键值对存储数据,存储的数据是无序的,key不能重复,value可以重复
vector
vector的底层实现很简单,就是一段连续的线性存储空间(可以理解为指针)
//_Alloc 表示内存分配器,此参数几乎不需要我们关心
template <class _Ty, class _Alloc = allocator<_Ty>>
class vector{
    ...
protected:
    pointer _Myfirst;
    pointer _Mylast;
    pointer _Myend;
};
Myfirst指向的是vector容器对象的起始字节位置
MyList指向的是最后一个元素的末尾字节
myend指向整个vector所占内存的末尾字节
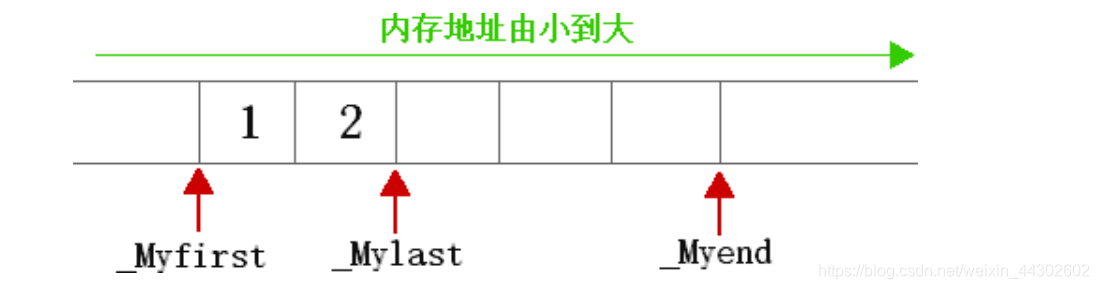
vector扩大容量的本质
vector的大小和容量相等的时候,也就是满载的时候
如果再向其中添加元素,那么vector就需要扩容,
1.完全弃用现在的内存空间,重新申请新的 内存空间
2.将旧的内存空间中的数据,按照原有顺序移动到新的内存空间中
3.最后将旧的内存空间释放
这也就是为什么vector扩容之后,与其相关的指针,引用,迭代器等都会失效的原因
由此可见vector的扩容是很好时的,为了降低再次分配内存的成本,每次扩容的时候,都会申请比用户需求更多的内存空间
这也就是vector容量的由来,以便之后使用
vector扩容的时候,不容的编译器申请到的内存空间是不容的 VS会扩容现有容量的50%
希望我所写的对大家有帮助

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 2
 0
- 0


 已为社区贡献8条内容

所有评论(0)