结合代码读3DGS&世界模型论文(2)——CVPR 2026 3DGS & 世界模型新工作GaussianDWM论文及代码解读
CVPR 2026 3DGS & 世界模型新工作GaussianDWM论文及代码解读
写在前面:此博客为3DGS & 世界模型方向论文工作介绍(暂未开通新的GitHub仓库)。如果想了解此前关于3DGS的加速压缩新工作,可以关注笔者的Github仓库:Awesome-3DGS-Compress-Accelerate。
一、论文简介 🌟
1.1 基本信息
- 📖 题目:GaussianDWM: 3D Gaussian Driving World Model for Unified Scene Understanding and Multi-Modal Generation
- 🏫 单位: Shanghai Jiao Tong University; Tsinghua University; MEGVII Technology; Mach Drive
- 🌍 主页:https://github.com/dtc111111/GaussianDWM
- 🀄️ 论文摘要:驾驶世界模型(DWM)随着生成模型的发展而快速演进。然而,现有的DWM缺乏三维场景理解能力,只能根据输入数据生成内容,无法对驾驶环境进行解释或推理。此外,当前方法通常使用点云或鸟瞰视角(BEV)特征来表示三维空间信息,无法实现文本信息与底层三维场景之间的准确对齐。为了解决这些问题,论文提出了一种基于三维高斯场景表示的新型统一DWM框架,使模型能够同时实现三维场景理解和多模态场景生成,并为理解任务与生成任务提供上下文信息增强。论文将丰富的语言特征嵌入每个高斯基元中,从而实现语言模态与场景的早期对齐。论文还设计了一种任务感知的语言引导采样策略,用于移除冗余的三维高斯,并将准确且紧凑的三维标记注入大语言模型。除此之外,论文设计了一种双条件多模态生成模型,将视觉语言模型提取的信息作为高级语言条件,并结合低级图像条件,共同引导多模态生成过程。论文在nuScenes和NuInteract数据集上开展了全面实验,以验证框架的有效性。论文方法取得了当前最优的性能。论文将公开发布代码。
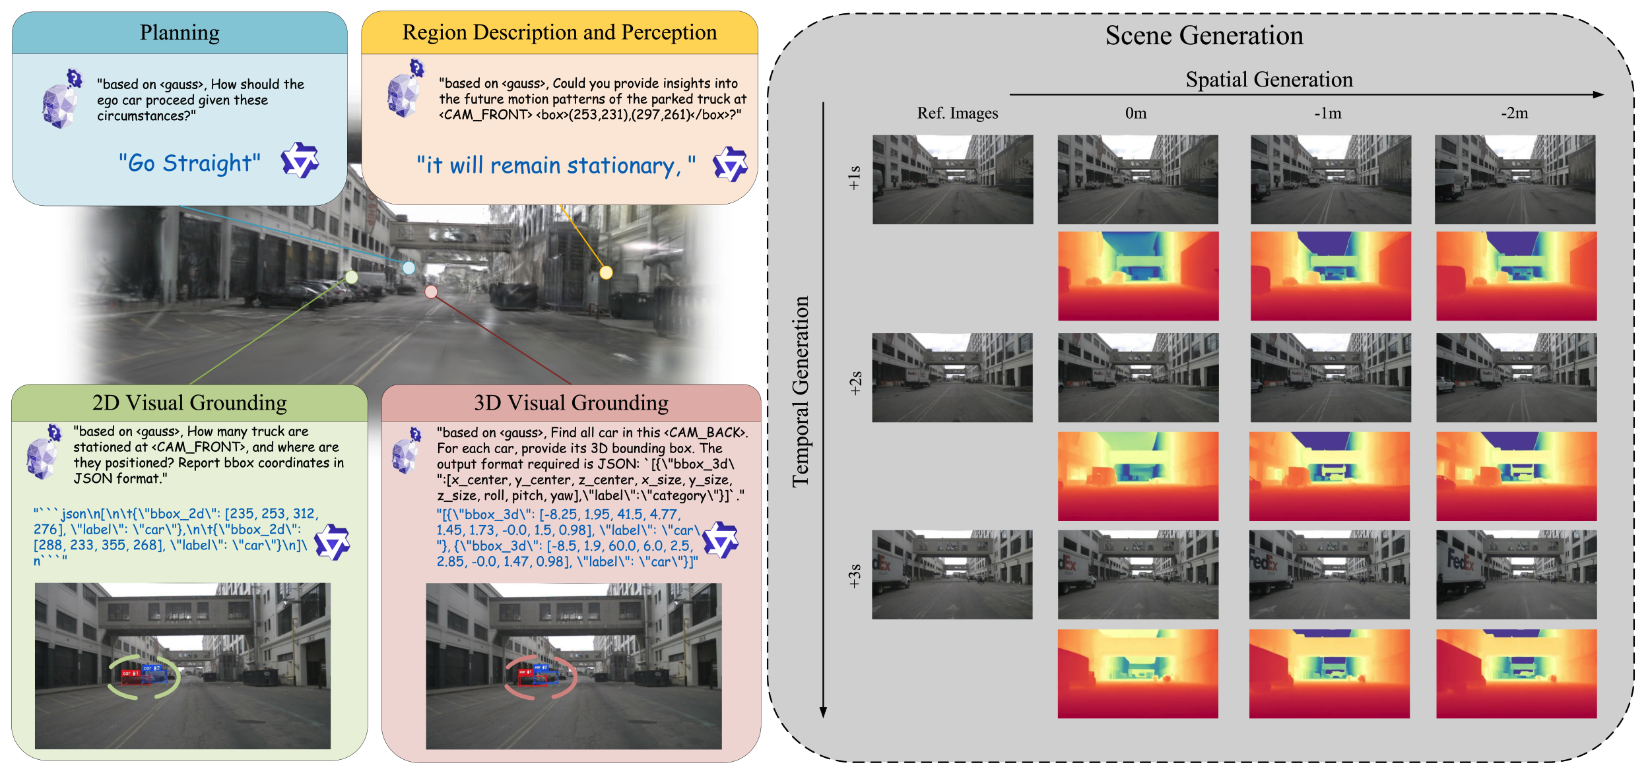
图1。论文提出了首个基于三维高斯的统一世界模型框架,实现了全面的场景理解和多模态生成。论文能够高效地编码复杂场景,采样与任务相关的信息,并处理多种问答任务。此外,论文利用提取的世界知识引导生成模型,实现准确的空间场景生成和时间场景生成。
1.2 论文引言 & 主要贡献
驾驶世界模型(DWM)凭借预测未来场景生成的能力,已成为自动驾驶领域的重要组成部分。这些模型能够预测环境变化并合成仿真数据,从而用于风险预测、路径优化和极端场景训练。现有的大多数方法通过预测图像和点云等模态来实现这一目标,这些模态分别表示环境的视觉属性和几何属性。尽管这些驾驶世界模型在预测环境演化方面表现出色,但它们难以对环境进行解释、描述或查询,也无法便捷地提供上下文信息,例如视觉问答或场景描述。
随着大语言模型和视觉语言模型(VLM)的快速发展,借助世界知识和因果推理能力,通用视觉任务取得了显著进展。这表明,将视觉语言模型的场景理解能力与驾驶世界模型的生成能力相结合,是一个很有前景的发展方向。值得注意的是,HERMES和UniFuture等先行工作首次实现了自动驾驶世界模型中场景生成与场景理解的统一。论文采用鸟瞰视角(BEV)特征或深度特征来表示空间信息,将其与文本空间对齐,并将其注入生成模型。然而,这种基于BEV的场景表示只能实现文本信息与空间输入之间的特征级对齐,其准确性仍然不足。为克服这一局限,论文提出了一种基于三维高斯场景表示、统一场景理解与场景生成的框架。
首先,论文将语言特征直接嵌入三维高斯中,从而实现文本与三维场景之间的显式空间对齐。这提高了跨模态对齐的准确性。其次,鉴于高斯表示具有冗余性,即每个场景包含数以万计的三维标记,视觉语言模型难以有效处理如此大量的标记,论文提出了一种新型任务感知的语言引导采样策略。论文通过计算输入文本与三维高斯之间的相似度,为查询选择最相关的高斯,并通过投影器将其映射到上下文空间,将准确且紧凑的三维标记注入文本理解过程。最后,论文设计了一种双条件多模态生成模型。在该框架中,视觉语言模型的理解结果提供高级语言条件,而图像特征则提供低级图像条件,二者共同引导多种模态的生成过程,包括RGB、深度和语言。此外,论文的框架同时支持空间生成和时间生成。
论文的主要贡献如下:
-
论文提出了首个基于三维高斯的统一世界模型框架,同时支持场景理解和场景生成。
-
论文针对三维高斯场景表示提出了一种新型标记提取与投影模块。由于三维高斯具有冗余性,论文进一步设计了一种任务感知的语言引导采样策略,在保留关键空间信息的同时克服标记长度限制。
-
论文设计了一种新型双条件多模态场景生成框架,其中高级条件来自世界知识,低级条件来自图像特征。
-
在NuScenes和NuInteract数据集上开展的大量实验表明,论文方法能够有效弥合场景理解与场景生成之间的差距,从而实现准确的场景理解和更加连贯的未来场景预测。
二、方法论 🍀
本文提出了GaussianDWM,一种面向驾驶场景理解与生成的统一框架,其采用三维高斯场景表示。该方法的整体流程如图2所示。本文的输入包括图像 { I i } \{I_i\} {Ii}、高斯椭球体 { G i } \{G_i\} {Gi} 和查询文本 { t i } \{t_i\} {ti}。该框架由三个主要模块组成:(i)世界标记器;(ii)场景理解;(iii)多模态生成。下面将对本文系统的完整流程进行详细介绍。
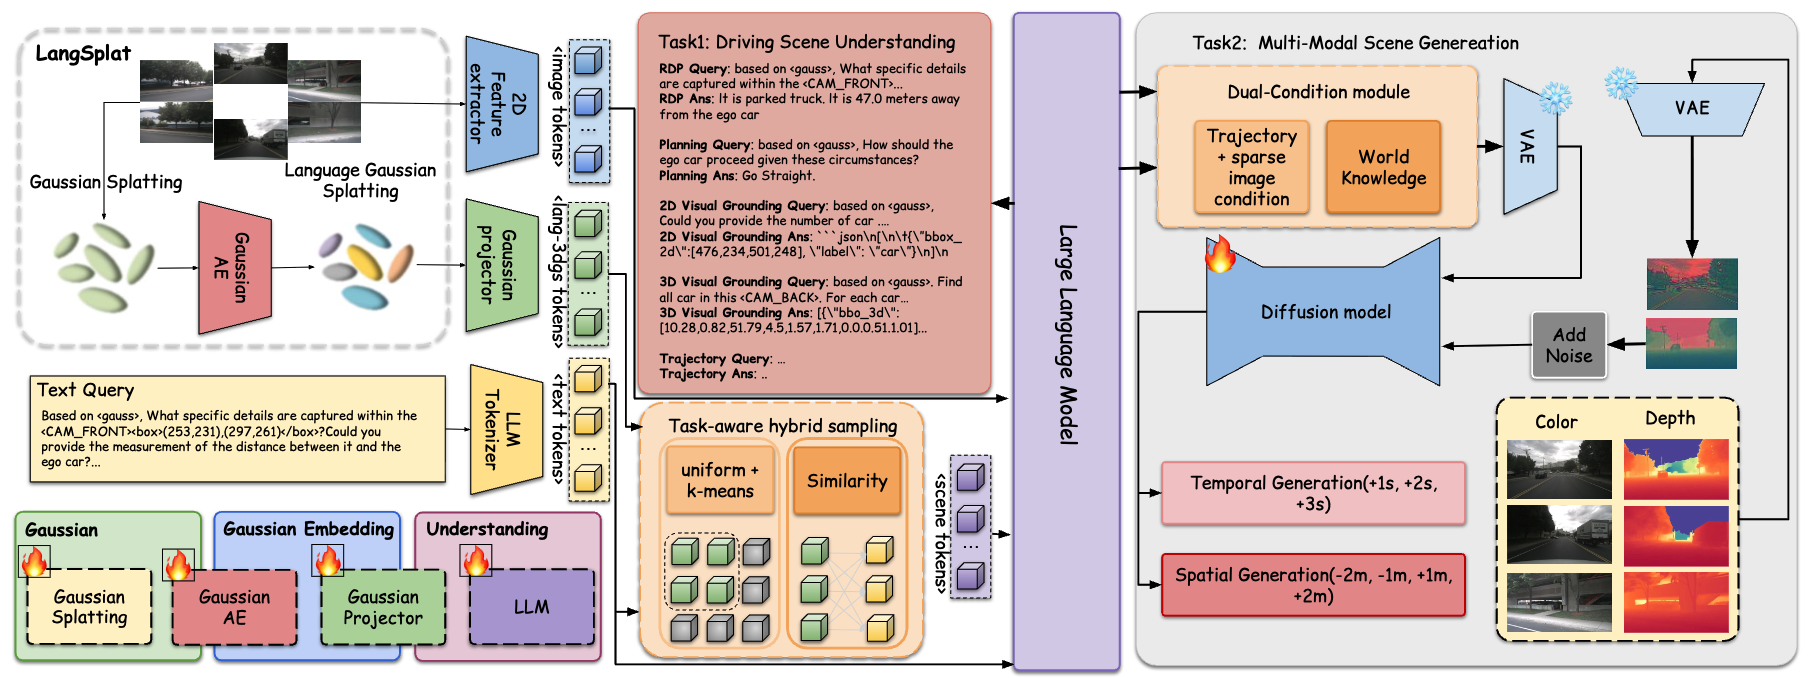
图2。系统概览。论文提出了首个同时支持场景理解和场景生成的基于三维高斯的统一世界模型。论文首先使用场景编码器将语言信息与三维高斯对齐,从而得到语言增强的三维高斯表示。随后,论文设计高斯投影器,将三维高斯标记、二维图像标记和文本标记对齐到统一的潜在空间中。接着,论文采用任务感知的混合采样策略,选择与当前查询最相关的三维高斯标记,并将其输入大语言模型。大语言模型同时生成文本答案和封装世界知识的高级语言特征,后者随后用于引导多模态场景生成。
2.1 世界标记器(World Tokenizer)
世界标记器将世界观测信息,即当前的多视角图像,编码为紧凑的连续三维高斯表示。随后,本文通过高斯投影器将选定的三维特征对齐到文本空间,然后再由视觉语言模型进行处理。
3DGS标记器(3D Gaussian Tokenizer) 为了保留纹理、三维结构以及语言对齐信息,本文采用3DGS作为大语言模型输入的场景表示。本文基于LangSplat构建3DGS语言场,其中每个高斯都附加了一个语言嵌入 f i f_i fi。这些嵌入由CLIP特征获得,并继承了通过SAM提取的层次化语义信息。随后,本文遵循标准的3DGS渲染策略,将语言信息直接融入高斯基元中。
F ( v ) = ∑ i ∈ N f i α i ∏ j = 1 i − 1 ( 1 − α j ) ( 1 ) F(v)=\sum_{i\in\mathcal{N}} f_i\alpha_i\prod_{j=1}^{i-1}(1-\alpha_j) \quad(1) F(v)=i∈N∑fiαij=1∏i−1(1−αj)(1)
其中, F ( v ) F(v) F(v) 表示在像素 v v v 处渲染得到的语言嵌入, α i = o i G i 2 D ( v ) \alpha_i=o_iG_i^{2D}(v) αi=oiGi2D(v)。其中, o i o_i oi表示第 i i i个高斯的透明度, G i 2 D ( ⋅ ) G_i^{2D}(\cdot) Gi2D(⋅)表示第 i i i个高斯投影到二维平面后的函数。为了进一步降低内存消耗并提高效率,本文引入了一个按场景训练的语言自动编码器 E E E,将CLIP嵌入 F ( v ) ∈ R D F(v)\in\mathbb{R}^{D} F(v)∈RD 映射为 H ( v ) = E ( F ( v ) ) ∈ R d H(v)=E(F(v))\in\mathbb{R}^{d} H(v)=E(F(v))∈Rd,其中 d ≪ D d\ll D d≪D 。本文设置 d = 3 d=3 d=3、 D = 512 D=512 D=512。随后,本文训练一个解码器 Ψ \Psi Ψ 来重建CLIP特征。该自动编码器在保留语义保真度的同时,能够显著降低内存需求。
3DGS投影器(3D Gaussian Projector) 本文首先将提取出的3DGS标记对齐到文本空间。对于每个高斯基元 G i G_i Gi,本文将其属性表示为 G i = ( x i , o i , s i , r i , f i ) G_i=(x_i,o_i,s_i,r_i,f_i) Gi=(xi,oi,si,ri,fi)。其中, x i ∈ R 3 x_i\in\mathbb{R}^3 xi∈R3 表示三维空间位置, o i o_i oi 表示透明度, s i s_i si 表示尺度, r i r_i ri 表示旋转, f i f_i fi 表示对应的CLIP特征。对于高斯标记器,本文首先对三维坐标 x i x_i xi 应用可学习的傅里叶嵌入:
γ ( x i ) = [ sin ( 2 k π x i ) , cos ( 2 k π x i ) ] k = 0 L − 1 ( 2 ) \gamma(x_i)=\left[\sin(2^k\pi x_i),\cos(2^k\pi x_i)\right]_{k=0}^{L-1} \quad(2) γ(xi)=[sin(2kπxi),cos(2kπxi)]k=0L−1(2)
其中, L L L 设置为10。对于透明度 o i o_i oi,本文应用Sigmoid激活函数,将其约束在区间 [ 0 , 1 ] [0,1] [0,1] 内: o ^ i = σ ( o i ) \hat{o}_i=\sigma(o_i) o^i=σ(oi)。对于CLIP特征 f i f_i fi,本文使用经过预训练的按场景训练的解码器,将其投影到512维空间: f ~ i = Ψ ( f i ) ∈ R N × 512 \tilde{f}_i=\Psi(f_i)\in\mathbb{R}^{N\times512} f~i=Ψ(fi)∈RN×512。其中, N N N 表示高斯椭球体的数量。随后,本文使用一组多层感知机投影器,将高斯属性映射到一个共享的4096维特征空间: h i x = ϕ x ( γ ( x i ) ) , h i o = ϕ o ( o ^ i ) , h i s = ϕ s ( s i ) , h i r = ϕ r ( r i ) , h i f = ϕ f ( f ~ i ) h_i^x=\phi^x(\gamma(x_i)),\quad h_i^o=\phi^o(\hat{o}_i),\quad h_i^s=\phi^s(s_i),\quad h_i^r=\phi^r(r_i),\quad h_i^f=\phi^f(\tilde{f}_i) hix=ϕx(γ(xi)),hio=ϕo(o^i),his=ϕs(si),hir=ϕr(ri),hif=ϕf(f~i)。其中, γ ( ⋅ ) \gamma(\cdot) γ(⋅) 表示傅里叶嵌入,每个 ϕ ⋅ ( ⋅ ) \phi^{\cdot}(\cdot) ϕ⋅(⋅) 均表示一个可学习的多层感知机。最后,本文通过可学习的权重融合投影后的特征,得到高斯场景标记 G i G_i Gi: G i = ∑ p ∈ { x , o , s , r , f } α i p h i p G_i=\sum_{p\in\{x,o,s,r,f\}}\alpha_i^p h_i^p Gi=∑p∈{x,o,s,r,f}αiphip。其中,每个 α i p \alpha_i^p αip 都是一个可训练标量,并通过Softmax进行归一化。对于文本查询,本文将输入提示词标记化为词汇表索引和文本标记 T T T,以供大语言模型处理。
2.2 场景理解(Scene Understanding)
本节介绍世界理解模块。大语言模型根据用户指令,利用世界标记器输出的 G i ∈ R N × C G_i\in\mathbb{R}^{N\times C} Gi∈RN×C 对驾驶场景进行解释。随后,大语言模型解析用户指令 T i T_i Ti,从驾驶场景中提取世界知识,并同时生成文本答案 t i t_i ti 和语言特征表示 C L C_L CL,后者随后被用作场景生成的条件信号。该特征编码了高级世界知识和空间信息,并在后续过程中作为场景生成的条件。本文使用广泛采用的Qwen3模型实现大语言模型。整体架构表示为:
{ t i , C i l } = L L M ( G i , T i ) ( 3 ) \{t_i,C_i^l\}=\mathrm{LLM}(G_i,T_i) \quad(3) {ti,Cil}=LLM(Gi,Ti)(3)
任务感知的语言引导采样(Task-aware Language-guided Sampling) 然而,将所有高斯直接转换为标记会超过大语言模型的最大标记长度限制,而高斯集合的高度冗余也会使大语言模型难以推理不同视角之间的空间交互关系。为了解决这一问题,本文针对三维高斯表示设计了一种任务感知的混合采样策略。对于场景理解任务,本文采用全局采样策略,通过选取具有代表性的高斯子集来保留整体场景信息。本文结合均匀采样和Top- k k k 采样,从场景中的数十万个高斯中选取 N = 4096 N=4096 N=4096 个高斯标记,并将其输入大语言模型。相比之下,对于二维和三维视觉定位任务,本文进一步引入了语言引导采样模块,根据文本查询将稠密的场景表示重新标记化为更加紧凑且稀疏的形式。具体而言,本文计算3DGS特征与文本查询之间的相似度,以识别并保留与查询最相关的高斯。该设计对于二维和三维定位任务十分有效,因为它能够有选择地将最相关的三维空间信息注入语言推理过程。与此前的HERMES框架相比,本文基于3DGS的大语言模型能够有效回答有关驾驶环境的查询,提供场景描述和视觉问题的答案。此外,本文还支持二维和三维视觉定位任务,并在平均指标方面取得了当前最优性能。
训练策略(Training Strategy) 与许多视觉语言模型的训练协议类似,本文采用由对齐阶段和微调阶段组成的两阶段训练策略。在第一阶段,本文冻结整个视觉语言模型,并使用完整参数训练对齐器,进行5000步预热训练,以实现视觉表示与文本空间之间的对齐。在第二阶段,本文进一步使用LoRA对大语言模型进行30000步适配。两个阶段采用相同的训练目标。具体而言,本文采用前缀语言建模。模型以输入前缀为条件,并以自回归方式生成目标后续内容:
L ( θ , B ) = − ∑ { t p r e f i x , t g t } ∈ B ∑ i = 1 ∣ t g t ∣ log p θ ( t g t ( i ) ∣ t g t ( < i ) , t p r e f i x ) ( 4 ) \mathcal{L}(\theta,\mathcal{B})= -\sum_{\{t^{\mathrm{prefix}},t^{\mathrm{gt}}\}\in\mathcal{B}} \sum_{i=1}^{|t^{\mathrm{gt}}|} \log p_{\theta}\left(t_{\mathrm{gt}}^{(i)} \mid t_{\mathrm{gt}}^{(<i)},t^{\mathrm{prefix}}\right) \quad(4) L(θ,B)=−{tprefix,tgt}∈B∑i=1∑∣tgt∣logpθ(tgt(i)∣tgt(<i),tprefix)(4)
其中, θ \theta θ 表示模型参数, B \mathcal{B} B 表示样本批次, t p r e f i x t^{\mathrm{prefix}} tprefix 表示前缀输入,包括文本标记、图像标记和3DGS标记, t g t t^{\mathrm{gt}} tgt表示真实响应。 t g t ( i ) t_{\mathrm{gt}}^{(i)} tgt(i)表示真实响应序列中的第 i i i 个标记。
2.3 多模态场景生成(Multi-modal Scene Generation)
本节介绍一种双条件多模态场景生成模型。该模型由一个去噪UNet和一个冻结的预训练VAE组成,其中VAE用于将RGB图像
I
i
I_i
Ii 和深度图
D
i
D_i
Di 编码到统一的潜在空间中。为了满足VAE的输入规范,本文通过复制通道将深度图转换为伪RGB图像。VAE的编码过程可以表示为:
z
I
=
E
(
I
i
)
,
z
D
=
E
(
D
i
)
z^I = E(I_i),\qquad z^D = E(D_i)
zI=E(Ii),zD=E(Di)。在解码过程中,VAE解码器
D
D
D根据潜变量
z
i
z_i
zi重建RGB图像和深度图:
I
^
i
=
D
(
z
I
)
,
D
^
i
=
1
3
∑
c
=
1
3
D
(
z
D
)
c
\hat{I}_i = D(z^I),\qquad \hat{D}_i = \frac{1}{3}\sum_{c = 1}^{3}D(z^D)_c
I^i=D(zI),D^i=31∑c=13D(zD)c。对于深度图,本文对解码结果的三个输出通道取平均值,以获得最终的单通道深度预测。在训练阶段,本文在已知的相机轨迹上进行随机采样,并通过VAE编码器获取对应彩色图像和深度图像的潜代码
z
I
z^I
zI 和
z
D
z^D
zD。在每个时间步
t
t
t,本文向采样数据中加入噪声。随后,本文使用投影矩阵将
t
t
t 时刻的周围点云投影到
t
+
n
t+n
t+n 时刻,作为低级图像条件
{
C
I
,
C
D
}
\{C^I,C^D\}
{CI,CD}。然后,本文将每种模态的带噪潜在表示与低级图像控制信号以及来自大语言模型的高级语言控制信号
C
L
C^L
CL 进行拼接,并将其输入去噪扩散网络。该模型采用
v
v
v预测目标。目标
v
t
v_t
vt定义为:
v
t
=
α
t
ϵ
t
−
σ
t
d
t
v_t = \alpha_t\epsilon_t-\sigma_t d_t
vt=αtϵt−σtdt。其中,
ϵ
t
∼
N
(
0
,
I
)
\epsilon_t\sim\mathcal{N}(0,I)
ϵt∼N(0,I) 表示采样得到的高斯噪声,
α
t
\alpha_t
αt和
σ
t
\sigma_t
σt表示随时间变化的噪声调度系数,
d
t
d_t
dt表示需要去噪的带噪输入模态。训练目标定义为:
L = E d , ϵ , t , s ∥ F θ ( d t , d r e f , C I , C D , C L , s ) − v t ∥ 2 2 ( 5 ) \mathcal{L} = \mathbb{E}_{d,\epsilon,t,s} \left\| F_{\theta}(d_t,d_{\mathrm{ref}},C^I,C^D,C^L,s)-v_t \right\|_2^2 \quad(5) L=Ed,ϵ,t,s Fθ(dt,dref,CI,CD,CL,s)−vt 22(5)
低级条件 C I C^I CI和 C D C^D CD表示场景的纹理信息和几何信息,用于引导生成过程。同时,高级语言特征 C L C^L CL封装了从大语言模型中提取的全面世界知识。通过在多个层级上对生成过程施加条件约束,本文能够实现更加准确且一致的时间和空间合成。
对于空间生成,本文利用查询帧的空间变换投影周围点云,从而获得稀疏条件图。对于时间生成,本文利用前端大语言模型预测的轨迹投影点云,并构造时间稀疏条件图,从而实现时间上连贯的场景生成。
本文的生成模型支持空间场景生成,即在 1 m 1\ \mathrm{m} 1 m或 2 m 2\ \mathrm{m} 2 m空间偏移下的新视角合成;也支持时间场景生成,即对未来 1 s 1\ \mathrm{s} 1 s和 2 s 2\ \mathrm{s} 2 s的场景进行预测。
2.4 结论
论文提出了一种新型统一驾驶世界模型框架,在同一架构中同时支持场景理解和场景生成。论文通过将三维高斯场景表示与任务感知的混合高斯采样策略相结合,有效弥合了场景理解与场景生成之间的差距,并实现了世界查询信息向大语言模型中的有效注入。大量实验验证了论文方法的有效性,结果表明该方法能够显著提升场景理解能力和场景生成能力。论文认为,这是朝向结合三维高斯场景表示的统一驾驶世界模型迈出的重要一步。
三、论文实验部分 🧪
3.1 实施细节
论文在两个数据集上评估了场景理解和场景生成任务。nuScenes是一个广泛使用的自动驾驶数据集。论文使用六个周围视角的相机图像作为输入。NuInteract是一个近期提出的场景理解基准,提供约150万条标注,并支持多种任务,包括二维感知和三维视觉定位。对于场景理解,论文采用标准的语言和图像描述评估指标,包括gCIDEr、BLEU-4和ROUGE。对于场景生成,论文使用FID评估图像,使用FVD评估视频。
论文的训练流程包括三个阶段。在第一阶段,论文独立训练高斯标记器、投影器和所提出的采样策略。随后,论文将这些组件与大语言模型集成并进行联合微调。该阶段的所有模型均使用16块NVIDIA A100 GPU进行训练。在第二阶段,论文训练多模态生成模块。论文首先训练低分辨率的RGB视频生成模型,分辨率为 224 × 400 224\times400 224×400;随后将其扩展为低分辨率RGB-D生成模型;最后,论文使用混合帧长度策略将其优化为高分辨率RGB-D视频生成器,分辨率为 424 × 800 424\times800 424×800。模型采用无仿真的整流流和 v v v预测损失进行优化。在最后阶段,论文对所有组件进行端到端联合优化,以确保场景理解与场景生成之间的一致性。
环境 为了全面分析高斯世界模型的能力,论文在两个合成环境和一个真实世界环境中进行评估。
- 第一,Meta-World,这是一个用于学习机器人操作强化学习策略的合成环境。
- 第二,RoboCasa,这是一个大规模、多尺度的合成模仿学习基准,包含厨房环境中的多种机器人操作任务。
- 第三,Franka-PnP,这是一个使用Franka Emika FR3机械臂构建的真实世界抓取放置环境。
任务 论文精心设计了四类任务,以系统评估高斯世界模型在不同测试环境中的能力。
- 第一,动作条件场景预测,用于评估高斯世界模型进行世界建模和未来预测的能力。
- 第二,基于高斯世界模型的模仿学习,用于研究其表示质量以及对模仿学习的帮助。
- 第三,基于高斯世界模型的强化学习,用于探索其在基于模型的强化学习中的潜力。
- 第四,真实世界任务部署,用于评估其在真实机器人操作中的鲁棒性。
3.1 场景理解(Scene Understanding)
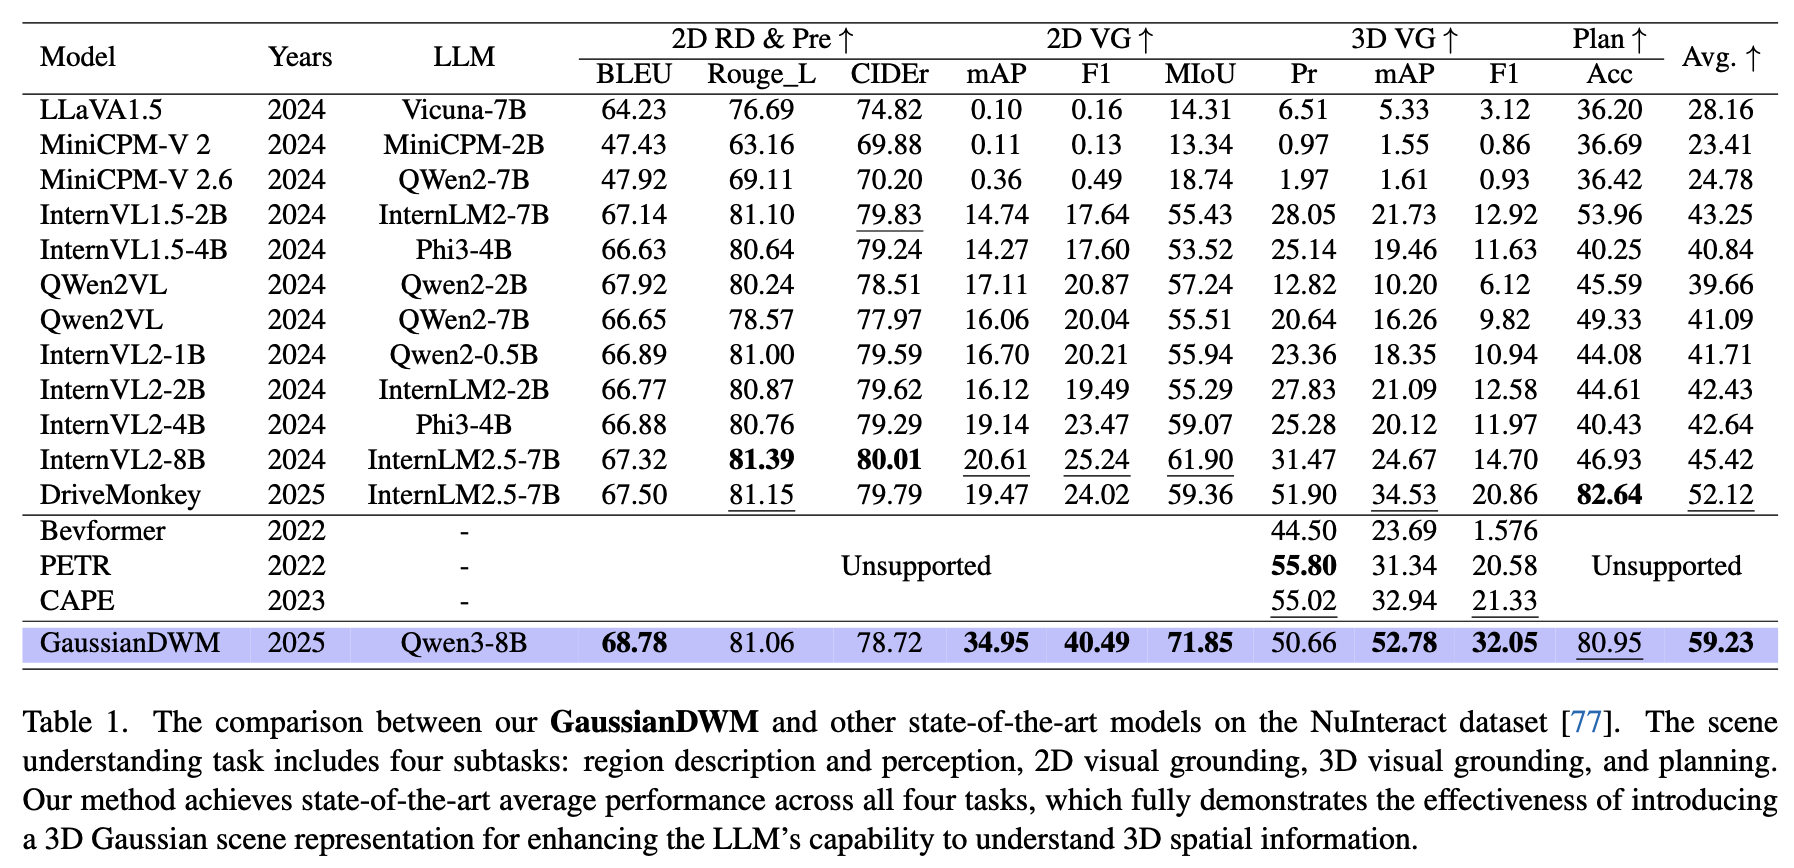
本节介绍场景理解结果,实验任务分为四类:区域描述与感知、规划、二维视觉定位和三维视觉定位。结果如表1所示。实验设置严格遵循DriveMonkey。论文主要比较两类方法:(1)LLaVA和InternVL等基于大语言模型的视觉定位方法;(2)BEVFormer、PETR和CAPE等专门的三维检测模型。如表1所示,在NuInteract测试数据集上,论文方法在所有任务的平均指标方面均显著优于此前的视觉语言模型。在RDP、二维视觉定位、三维视觉定位和规划任务上,论文方法在平均指标方面取得了当前最优性能,相比此前的最优方法实现了13.6%的相对提升,充分证明了引入三维高斯场景表示对于增强大语言模型三维场景理解能力的重要性。与此前基于点云和鸟瞰视角的场景表示相比,论文的三维高斯表示能够实现三维结构、纹理和语言特征之间的显式对齐,从而向大语言模型注入更加高效且语义一致的信息。此外,论文提出的任务感知混合采样策略能够高效地选择与查询文本最相关的高斯标记,同时过滤冗余的三维高斯。与当前最优的视觉问答方法DriveMonkey相比,论文方法在二维和三维视觉定位任务上均表现出明显优势,同时在专门用于三维视觉定位的检测模型所达到的性能水平附近取得了具有竞争力的结果。表1。论文方法与NuInteract数据集上其他当前最优模型之间的比较。场景理解任务包括区域描述与感知、二维视觉定位、三维视觉定位和规划四个子任务。论文方法在四项任务的平均性能上均取得当前最优结果,充分说明引入三维高斯场景表示能够增强大语言模型理解三维空间信息的能力。
3.2 场景生成(Scene Generation)
本节介绍多模态场景生成评估,其中包括空间场景生成和时间场景生成。所有实验均在nuScenes数据集上进行。与此前的工作一致,论文将2Hz关键帧标注插值到12Hz的更高帧率,实验设置严格遵循相关工作。
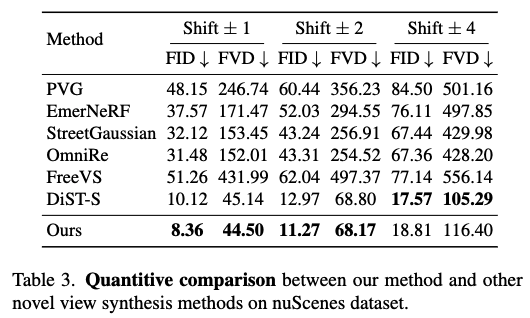
论文将该方法与具有代表性的街景合成方法进行比较,包括PVG、EmerNeRF、StreetGaussian、OmniRe、FreeVS和DiST-4D。如表3所示,论文方法优于所有现有方法,并取得当前最优性能。由于空间偏移后不存在真实数据,论文使用FID和FVD作为评估指标。在极端视角偏移条件下,即视角偏移为正负 4 m 4\mathrm{m} 4m时,论文方法表现出更好的一致性和真实感,并优于直接重建方法。这表明,论文框架能够有效结合三维高斯场景表示和基于扩散的生成建模的优势。在双条件机制的引导下,同时利用高级世界知识和低级几何线索,论文方法在较大视点变化下实现了当前最优的空间保真度和纹理保真度。
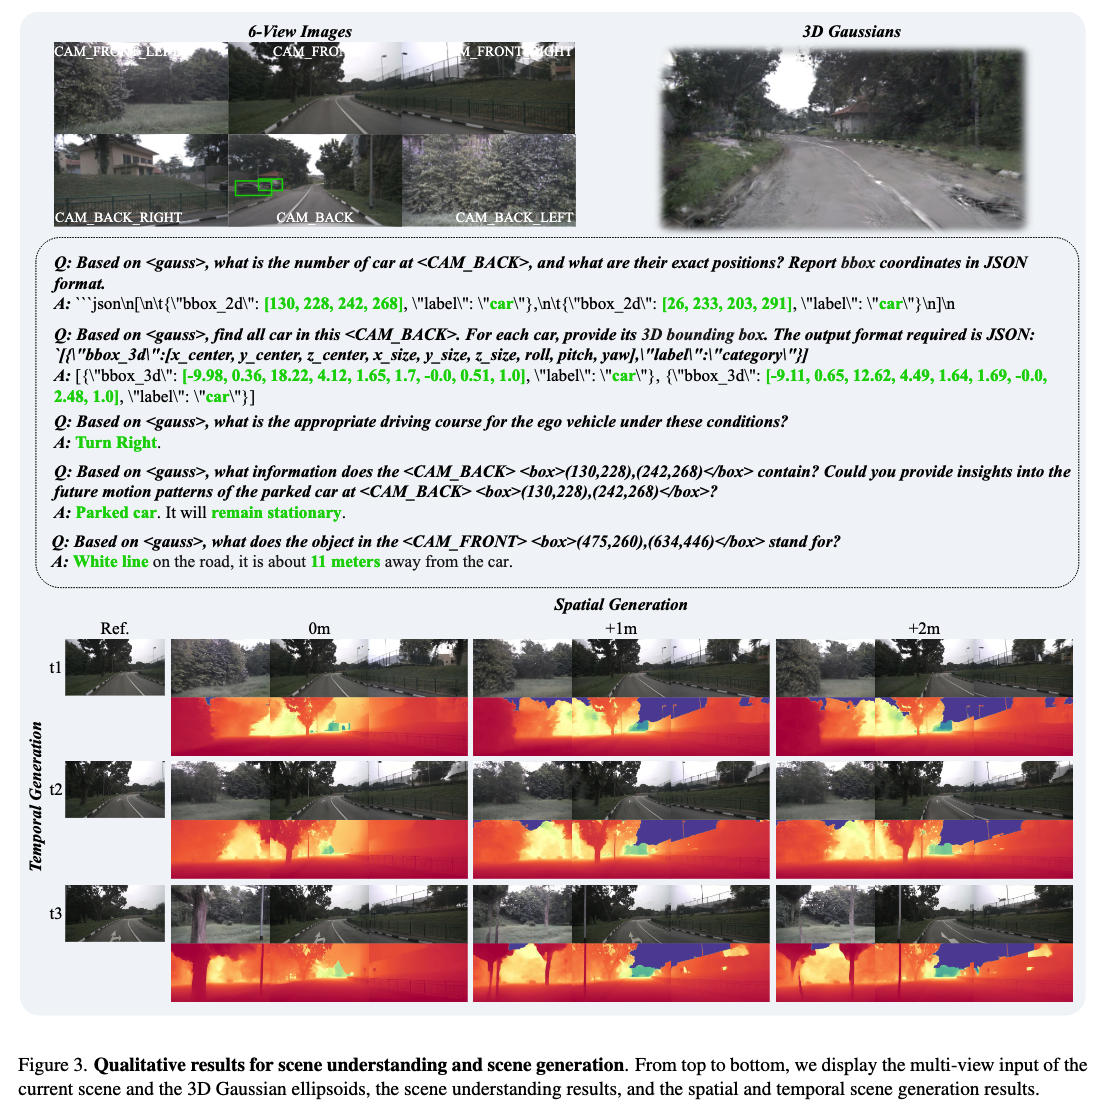
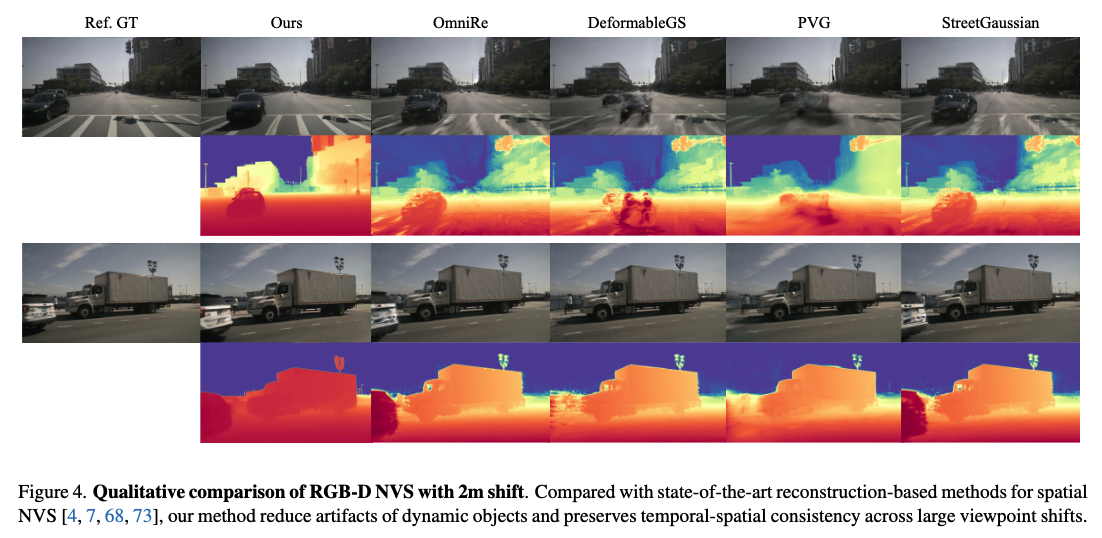
论文还在图3中展示了空间场景生成的定性结果。论文进一步将方法与多个现有的新视角合成方法进行比较,定性结果如图4所示。结果表明,论文生成的RGB图像和深度图具有逼真的视觉效果,展示了世界知识、基于扩散的生成模型和三维高斯场景表示之间的互补优势。
论文提出的双条件设计使高级世界知识能够有效引导时间场景生成中的未来推理,同时使低级稀疏条件约束二维纹理和风格的一致性。这表明,在世界模型中引入显式世界知识能够改善时间场景生成的语义一致性和空间一致性。总体而言,论文能够同时理解和生成复杂的驾驶场景,凸显了统一场景理解与场景生成这一世界建模方向的潜力。
3.3 消融研究( Ablation Study)
本节开展全面的消融研究,以验证所提出框架中各个组件的有效性。论文系统分析了三维高斯场景表示、混合采样策略和双条件生成设计等关键模块,进而验证这些模块各自的作用。
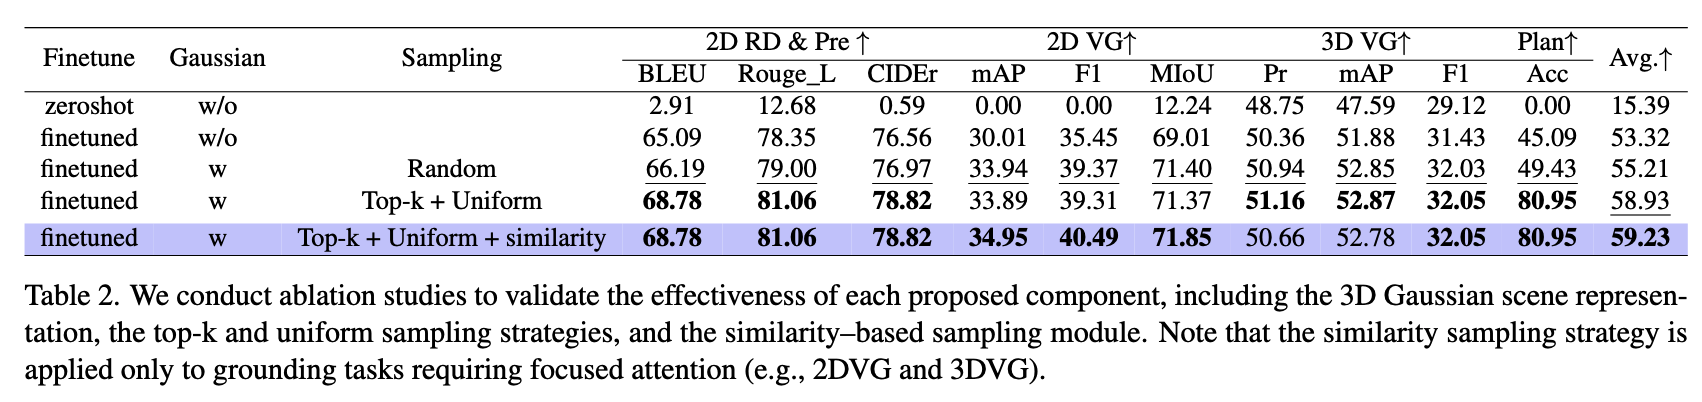
3DGS表示(3D Gaussian Representation) 与其他场景表示相比,三维高斯场景表示具有更强的环境特征编码能力,包括纹理信息和几何信息,并且能够通过语言特征直接对齐到三维空间。相关结果如表2所示。通过消融研究,论文充分验证了引入3DGS表示能够增强大语言模型的三维场景理解能力,使模型能够更好地感知场景中的几何信息和语义信息。
混合采样(Hybrid Sampling) 针对三维高斯场景表示中存在的冗余问题,论文设计了一种混合采样策略,用于提取环境中信息量最大的成分。相关结果如表2所示。通过比较随机采样、均匀采样加Top- k k k采样以及基于相似度的采样可以观察到,当在文本查询与三维高斯标记之间应用基于相似度的采样时,模型能够更加有效地选择与任务相关的高斯标记,从而提升场景理解性能。
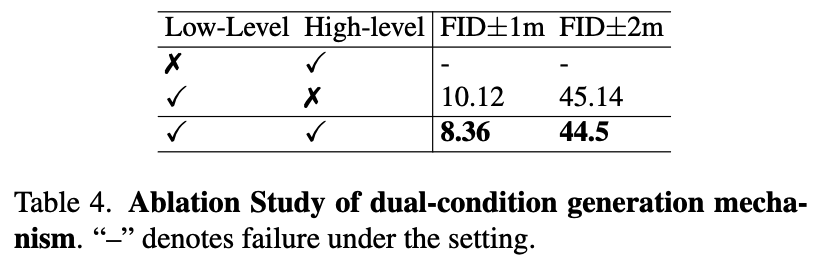
高级世界知识(High-level World Knowledge) 与其他世界模型和场景生成框架相比,论文设计了一种能够在不同层级控制场景生成的双条件引导框架。该部分的消融结果如表4所示。可以观察到,论文方法在长序列预测和大视角变化条件下表现更好,这证明了引入世界知识的有效性。
四、论文代码解读 💻
待补充。
写在最后
由于笔者🖊️精力有限且本文更多的目的是通过📒博客记录学习过程并分享更多知识,因此文中部分描述不太具体,如有不太理解💫的地方可在评论区👀留言。非特殊赶deadline⏰或假期⛱️期间,笔者会经常上线回复💬。如有不便之处,请海涵~
如果想了解更多关于3DGS的加速⏰压缩⚡️新工作,可以关注笔者的Github仓库:Awesome-3DGS-Compress-Accelerate。
另外,创造不易,转载请注明出处💗💗💗~

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 4
 0
- 0


 已为社区贡献1条内容

所有评论(0)