用C++17从零手搓一个深度学习张量引擎:自动微分、广播、神经网络全打通
一、这玩意儿到底是干嘛的?
说白了,这是一个用纯C++17写的小型深度学习计算库。它能做的事情和PyTorch/TensorFlow的核心部分很像——创建多维数组(张量)、做各种数学运算、自动求导、搭建神经网络、训练模型。
但它有个特点:除了标准库,几乎不依赖任何外部东西。可选的BLAS加速也只是锦上添花,没有也能跑。整个代码量不大,但五脏俱全:张量内存管理、自动微分引擎、广播机制、神经网络层、SGD和Adam优化器,全都有。
你可以把它理解成一个"迷你版PyTorch内核"的C++实现。写它的目的不是替代PyTorch,而是让你搞清楚:loss.backward() 背后到底发生了什么。
二、为什么要自己造轮子?
现在市面上已经有PyTorch、TensorFlow、JAX这些成熟框架了,为什么还要自己写一个?
原因有几个:
第一,学原理。 很多人用PyTorch写了几年神经网络,但问到"反向传播是怎么遍历计算图的"、“transpose为什么不需要拷贝数据”、“广播的梯度怎么还原”,就答不上来了。自己手写一遍,这些细节就全明白了。
第二,C++性能。 Python的GIL(全局解释器锁)是个老大难问题。如果你的应用场景对延迟敏感、或者要在嵌入式设备上跑,纯C++实现就有优势。
第三,可控性。 自己写的代码,每一行在干嘛都门儿清。出了问题不用翻PyTorch源码,直接看自己的代码就行。
三、核心设计思路:三层架构
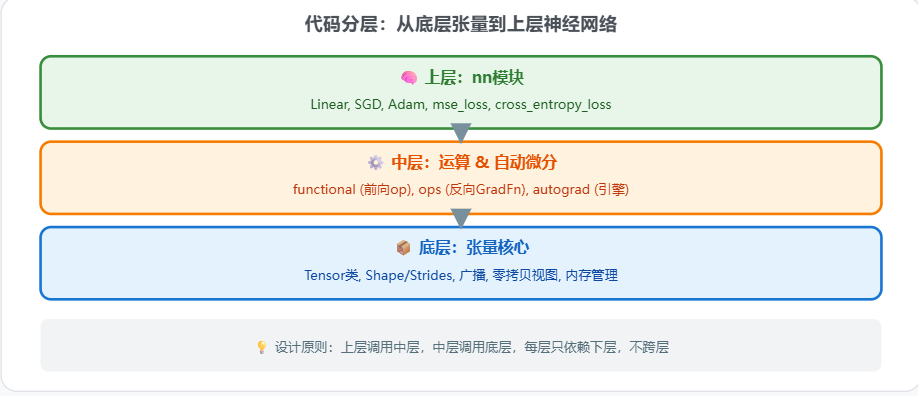
整个库的设计可以概括为三层金字塔:
| 层级 | 内容 | 作用 |
|---|---|---|
| 底层 | Tensor类、Shape/Strides、内存管理、广播 | 所有计算的基础设施 |
| 中层 | 运算函数、GradFn反向节点、自动微分引擎 | 前向计算 + 反向求导 |
| 上层 | Linear层、损失函数、SGD/Adam优化器 | 直接拿来搭神经网络 |
设计原则很简单:上层调用中层,中层调用底层,每层只依赖下层,不跨层。 这样结构清晰,也方便扩展。
四、张量内存模型:一个"壳子"套着一块共享内存
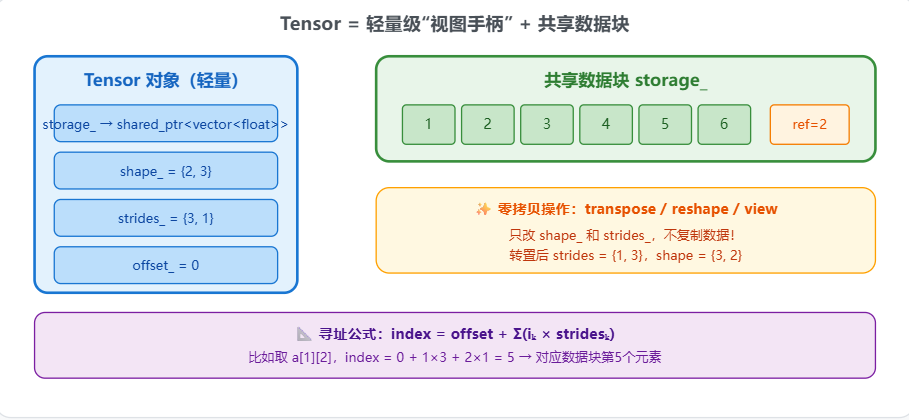
这是整个库最基础也最关键的部分。很多人以为Tensor就是"一个多维数组",但其实没那么简单。
4.1 Tensor不是数据,是"数据的视图"
在这个实现里,Tensor本身只是一个轻量级的"壳子",里面存了四样东西:
storage_:指向实际数据块的智能指针(shared_ptr<vector<float>>)shape_:张量的形状,比如{2, 3}表示2行3列strides_:每一维的步长,比如{3, 1}表示沿第0维走3个元素、沿第1维走1个元素offset_:数据块里的起始偏移
真正的数据只存在 storage_ 指向的那个 vector<float> 里。
4.2 零拷贝:transpose/reshape 为什么不复制数据?
这是很多人好奇的点。比如你做 a.t()(转置),数据明明"看起来"变了,但实际上底层数据根本没动。
秘密就在于 strides:
原始张量 a: shape={2,3}, strides={3,1}
数据在内存里排布: [1, 2, 3, 4, 5, 6]

转置后 a.t(): shape={3,2}, strides={1,3}
数据在内存里还是: [1, 2, 3, 4, 5, 6] ← 没变!
转置只是交换了 shape 和 strides,数据块还是同一块。reshape、unsqueeze、squeeze 也是同理——都是零拷贝操作。
只有当布局真的不连续了,调用 make_contiguous() 才会触发一次数据复制。
4.3 怎么根据下标找到元素?
公式很简单:
index = offset + i₀×strides₀ + i₁×strides₁ + ... + iₙ×stridesₙ
比如 a[1][2],index = 0 + 1×3 + 2×1 = 5,直接取数据块第5个元素就行。这个设计让任意维度的切片、转置都能高效实现。
4.4 梯度怎么存?
如果张量设置了 requires_grad=true,它会额外分配一个 GradHolder(共享指针包装)。这个设计很巧妙:
- 当你
Tensor y = x时,y 和 x 共享同一个GradHolder - 无论通过 x 还是 y 的反向传播路径,梯度都会累加到同一个地方
- 没有垃圾回收,靠
shared_ptr的引用计数自动管理生命周期
五、自动微分引擎:前向建图,反向传播
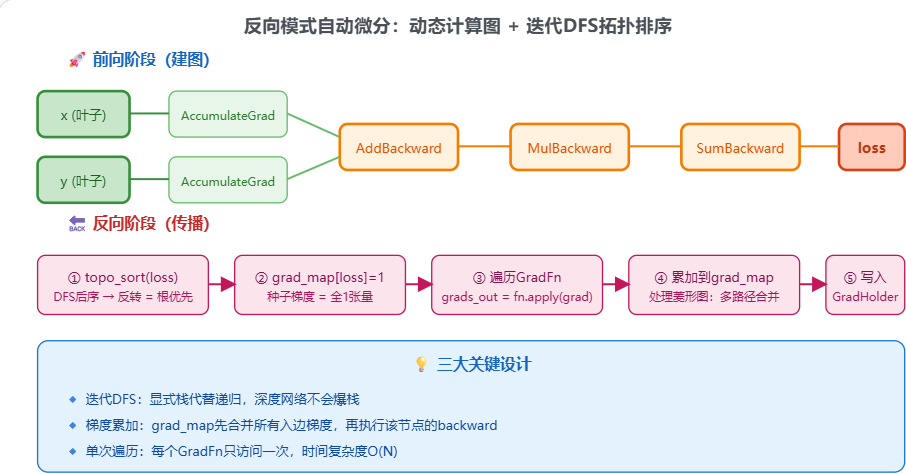
这是深度学习框架的灵魂。PyTorch的 autograd 到底怎么工作的?这里给你拆解清楚。
5.1 前向阶段:隐式动态建图
每次做运算(比如 add、matmul、relu),框架都会在背后悄悄搭一张"计算图"。
这张图由两类节点组成:
- AccumulateGrad:叶子节点(你自己创建的张量)的终点,负责把最终梯度写回
GradHolder - 各种 Backward 节点:比如
AddBackward、MulBackward、MatMulBackward,每个运算对应一个
举个例子:
x ──[AccumulateGrad]──┐
                       ├── AddBackward ── MulBackward ── SumBackward ──▶ loss
y ──[AccumulateGrad]──┘
这张图是动态的——每次前向传播都会重新建,不是静态固定的。好处是你可以写条件分支、循环,图会自动跟着变。
每个 Backward 节点会保存两样东西:
next_edges:指向父节点的边,告诉反向传播下一步往哪走saved_tensors:做反向计算需要的数据(比如MatMulBackward要保存输入矩阵 a 和 b)
注意:saved_tensors 存的是脱离梯度追踪的拷贝,不是原始张量。这是为了防止循环引用导致内存泄漏——如果 Backward 节点持有原始张量的智能指针,而原始张量又指向这个 Backward 节点,就死锁了。
5.2 反向阶段:拓扑排序 + 单次遍历
调用 loss.backward() 时,引擎做三件事:
第一步,拓扑排序。 用迭代DFS(显式栈,不是递归)把计算图排成"根优先"的顺序。迭代DFS很重要——如果是递归,深层网络(比如Transformer)会直接爆栈。
第二步,种子梯度。 给 loss 节点塞一个全1的张量作为初始梯度。
第三步,逐个执行 backward。 按拓扑顺序遍历每个 Backward 节点:
- 调用
fn.apply(grad)算出输出梯度 - 把梯度累加到
grad_map中对应父节点的槽位 - 如果某个节点有多条入边(菱形图),
grad_map会先合并所有梯度,再执行该节点的 backward
最后,AccumulateGrad 把梯度写回叶子张量的 GradHolder,完事。
整个过程每个节点只访问一次,时间复杂度 O(N),N 是图中节点数。
六、广播机制:形状不一样也能算
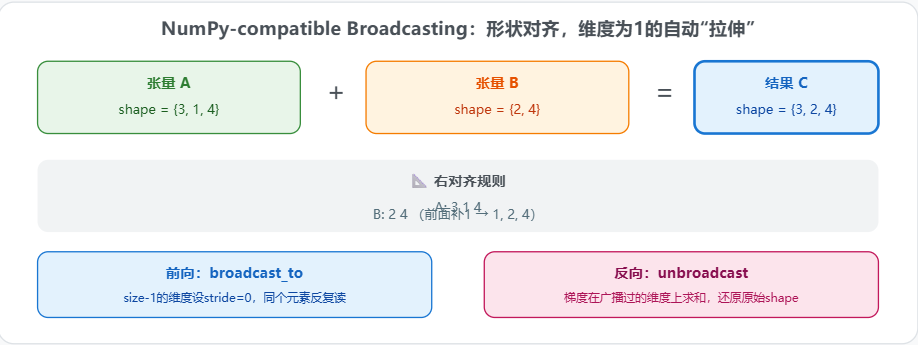
这是NumPy/PyTorch里很常用的功能。比如你想把一个 {3,1,4} 的张量和一个 {2,4} 的张量相加,形状明显对不上,但框架能自动帮你"拉伸"到 {3,2,4} 再算。
6.1 规则很简单
两个形状右对齐,从最后一维往前比:
- 如果维度相等,直接过
- 如果其中一个维度是1,自动"复制"成另一个维度的大小
- 其他情况报错
A:     3    1    4
B:     1    2    4  (前面补1对齐)
结果:  3    2    4
6.2 前向:broadcast_to
被广播的维度,stride 设为0。这意味着读取的时候,同一个元素会被反复读到,但内存里只存了一份,零开销。
6.3 反向:unbroadcast
广播的逆操作。如果某个维度是被"拉伸"出来的,反向传播时要把梯度在那个维度上求和,还原回原始形状。
比如一个标量被广播成了 {3,4},它的梯度就是所有12个位置梯度的总和。这是数学上正确的做法。
七、神经网络模块:从线性层到优化器
7.1 Linear 层
就是全连接层:y = x @ W.T + b
- 权重 W 用 Kaiming/He 初始化:
W ~ N(0, sqrt(2 / fan_in)),这是ReLU网络的标配初始化 - 偏置 b 初始化为0
parameters()返回{&weight, &bias}的原始指针,优化器直接原地修改
7.2 损失函数
- MSE Loss:均方误差,
(pred - target)²的平均 - Cross Entropy Loss:把 softmax 和交叉熵合在一起算,数值更稳定。反向传播直接是
(softmax - one_hot) / batch_size,避免重复计算 softmax
7.3 优化器
SGD:支持动量(momentum)和权重衰减(weight decay)
Adam:标准实现,带偏差修正
m_t = β₁·m_{t-1} + (1-β₁)·g_t
v_t = β₂·v_{t-1} + (1-β₂)·g_t²
m̂ = m_t / (1 - β₁^t)
v̂ = v_t / (1 - β₂^t)
θ ← θ - α · m̂ / (√v̂ + ε)
和PyTorch的Adam行为一致。
八、相关领域知识点速览
| 知识点 | 一句话解释 |
|---|---|
| 反向模式自动微分 | 从输出往输入传播梯度,适合"多输入、少输出"的场景(比如神经网络) |
| 计算图 | 记录运算关系的DAG(有向无环图),反向传播时按拓扑序遍历 |
| Strided Memory Layout | 用 shape + strides + offset 描述多维数组,支持零拷贝视图 |
| 引用计数 | shared_ptr 管理共享数据块的生命周期,自动释放 |
| 广播 | 自动对齐不同形状张量的运算规则,NumPy标准 |
| Kaiming 初始化 | 针对ReLU激活函数设计的权重初始化,防止梯度消失/爆炸 |
| 数值梯度检验 | 用有限差分法验证解析梯度的正确性,是写自动微分的必备测试 |
| BLAS加速 | 矩阵乘法自动检测OpenBLAS/MKL,用 cblas_sgemm 替代朴素循环 |
九、怎么跑起来?编译和测试手把手教
9.1 环境要求
- CMake ≥ 3.14
- C++17 编译器(GCC 9+ 或 Clang 10+)
- Linux 或 macOS
- 可选:OpenBLAS 或 MKL(矩阵乘法会自动用,没有就回退到朴素实现)
9.2 编译
Release 版本(推荐):
cmake -B build -DCMAKE_BUILD_TYPE=Release
cmake --build build -j$(nproc)
Debug 版本(带 AddressSanitizer):
cmake -B build-debug -DCMAKE_BUILD_TYPE=Debug
cmake --build build-debug -j$(nproc)
检查 BLAS 是否被检测到:
cmake -B build | grep -i blas
如果输出了 BLAS 相关的信息,说明矩阵乘法会自动走加速路径。
9.3 运行测试
./build/tensort_tests
正常输出应该是:
[doctest] test cases: 32 | 32 passed | 0 failed
[doctest] assertions: 148 | 148 passed | 0 failed
测试分三类:
- 16个运算测试:每个可微运算都用数值梯度检验(有限差分法)验证解析梯度
- 10个自动微分测试:链式法则、菱形图、ReLU死神经元、Sigmoid饱和、长链梯度等
- 6个神经网络集成测试:XOR问题用2→16→1的MLP训练2000轮,loss必须收敛到0.02以下,实际通常到1e-4
想看详细输出:
./build/tensort_tests -s          # 显示所有断言
./build/tensort_tests -tc="grad*" # 只跑名字带grad的测试
9.4 跑 XOR 演示
./build/xor_mlp
这个demo用一个小型MLP学XOR函数(输入两个bit,输出异或结果)。训练2000轮后loss会降到非常小的值,证明整个链条(前向、反向、优化器)都工作正常。
9.5 自己写代码试试
...

int main() {
    // 创建张量
    Tensor a = Tensor::randn({3, 4}, true);  // true = 需要梯度
    Tensor b = Tensor::ones({4, 2});

    // 前向:矩阵乘法 + ReLU + 求平均
    auto c = relu(matmul(a, b));   // shape {3, 2}
    auto loss = mean(c);            // 标量

    // 反向传播
    loss.backward();

    // 查看梯度
    // a.grad()->shape() == {3, 4}

    // 搭个神经网络训练XOR
    Linear fc1(2, 16), fc2(16, 1);
    auto p1 = fc1.parameters(), p2 = fc2.parameters();
    std::vector<Tensor*> params(p1.begin(), p1.end());
    params.insert(params.end(), p2.begin(), p2.end());

    Adam opt(params, 0.01f);

    Tensor X = Tensor::from_data({0,0, 0,1, 1,0, 1,1}, {4, 2});
    Tensor Y = Tensor::from_data({0, 1, 1, 0}, {4, 1});

    for (int epoch = 0; epoch < 2000; ++epoch) {
        opt.zero_grad();
        auto h = relu(fc1(X));
        auto pred = sigmoid(fc2(h));
        auto loss = mse_loss(pred, Y);
        loss.backward();
        opt.step();
    }
}
If you need the complete source code, please add the WeChat number (c17865354792)
十、总结
这个库虽然不大,但把深度学习框架的核心机制都覆盖到了:
- 张量内存:用 shape + strides + offset 实现零拷贝视图,transpose/reshape 不花一分钱
- 自动微分:动态建图 + 迭代DFS拓扑排序 + 梯度累加,支持任意复杂的计算图
- 广播:NumPy兼容的前向广播和反向还原,数学上严谨
- 神经网络:从线性层到Adam优化器,能直接跑通XOR训练
如果你一直想搞清楚 PyTorch 底层是怎么工作的,但又不想啃几十万行源码,这就是一个很好的切入点。代码量可控、结构清晰、测试完善,读完之后你会对"自动微分"四个字有完全不同的理解。
Welcome to follow WeChat official account【程序猿编码】

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 8
 0
- 0


 已为社区贡献4条内容

所有评论(0)