大数据毕设做什么好?基于大数据的电商客户行为数据分析与可视化,用Spark+Python实现RFM分层与可视化大屏
精彩专栏推荐订阅:在下方主页👇🏻👇🏻👇🏻👇🏻
💖🔥作者主页:计算机毕设木哥🔥 💖
一、项目介绍
在电商行业竞争日益激烈的当下,用户行为数据的价值挖掘已成为精准营销与精细化运营的关键。然而,面对海量、异构且快速增长的数据,传统分析方法在深度与效率上逐渐显露疲态。如何从繁杂的数据中有效识别用户偏好、预判消费趋势并定位高价值客群,成为电商平台亟待解决的难题。本文通过开发一个基于大数据的电商客户行为数据分析与可视化系统,用以帮助解决客户分群不清晰、行为模式难洞察的运营困境。
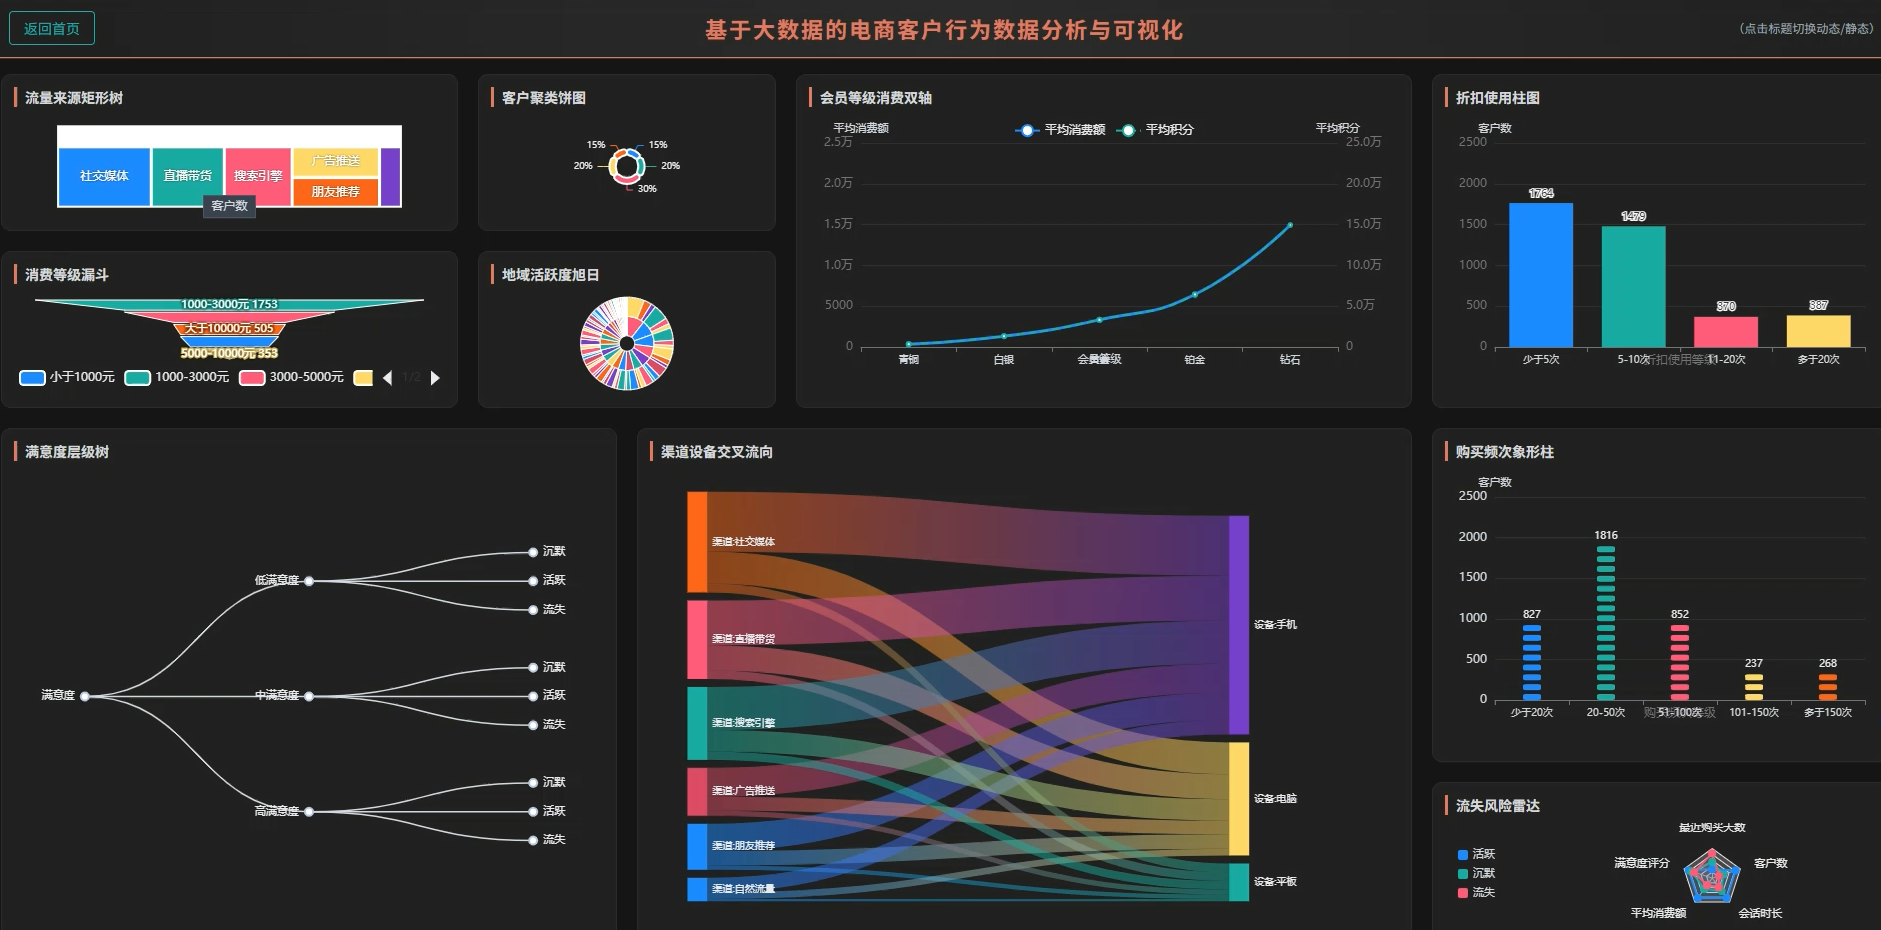
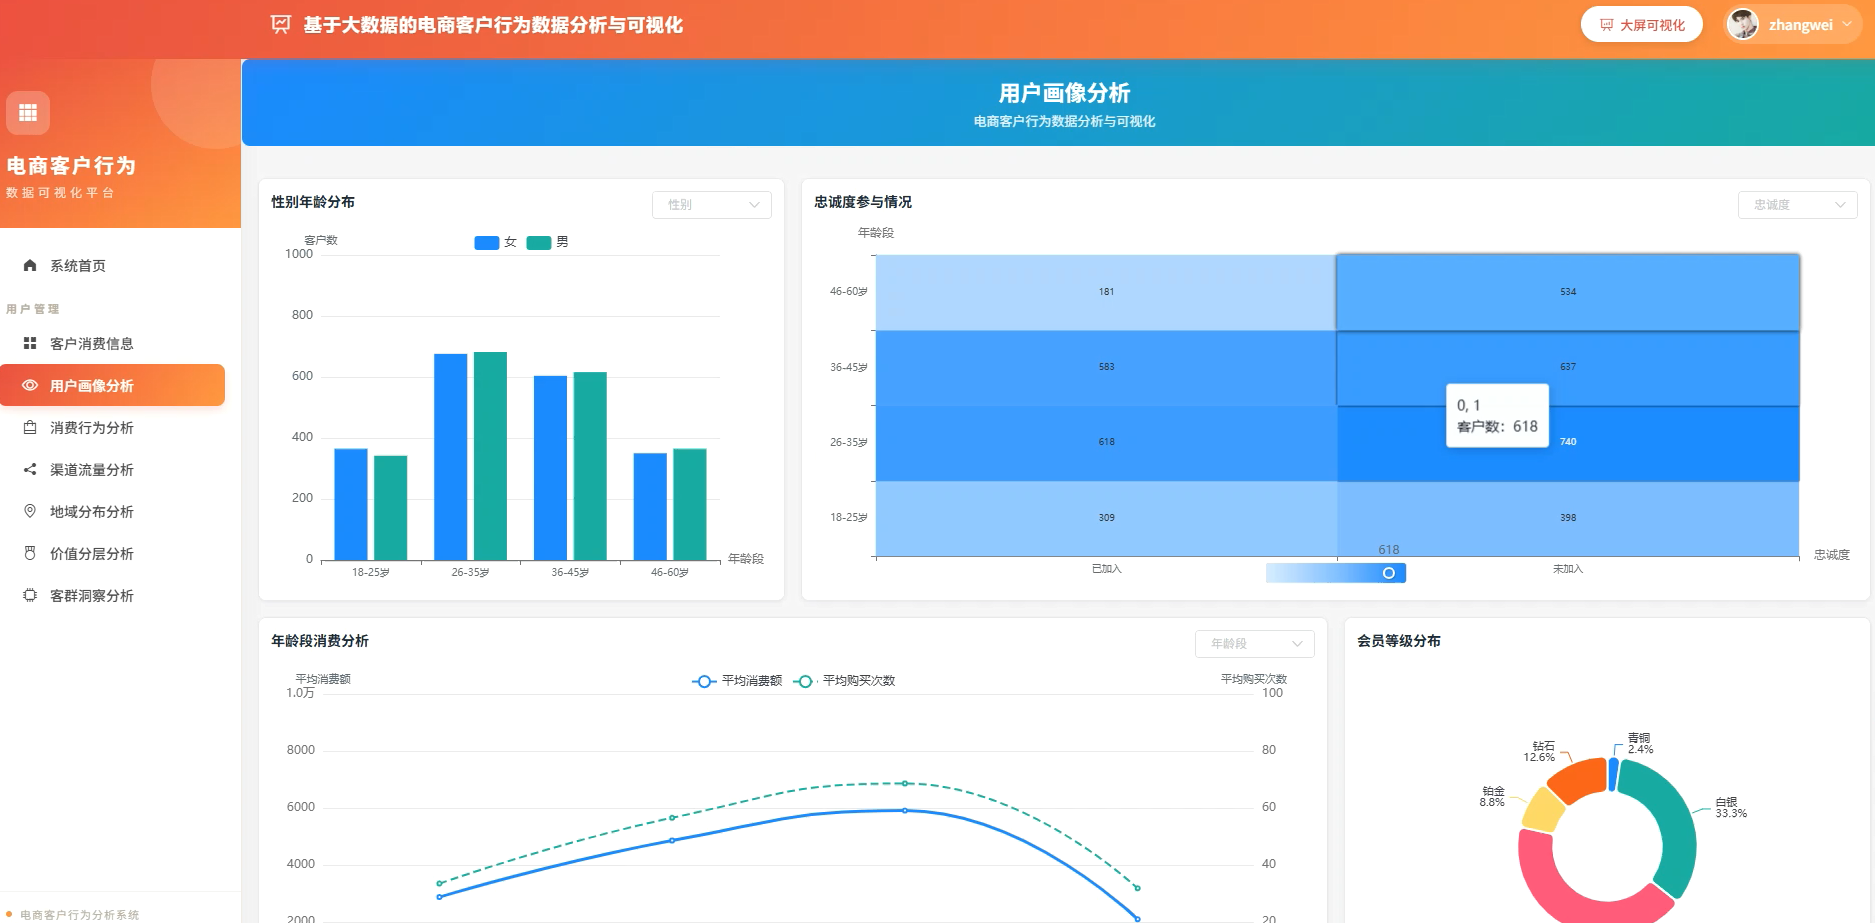
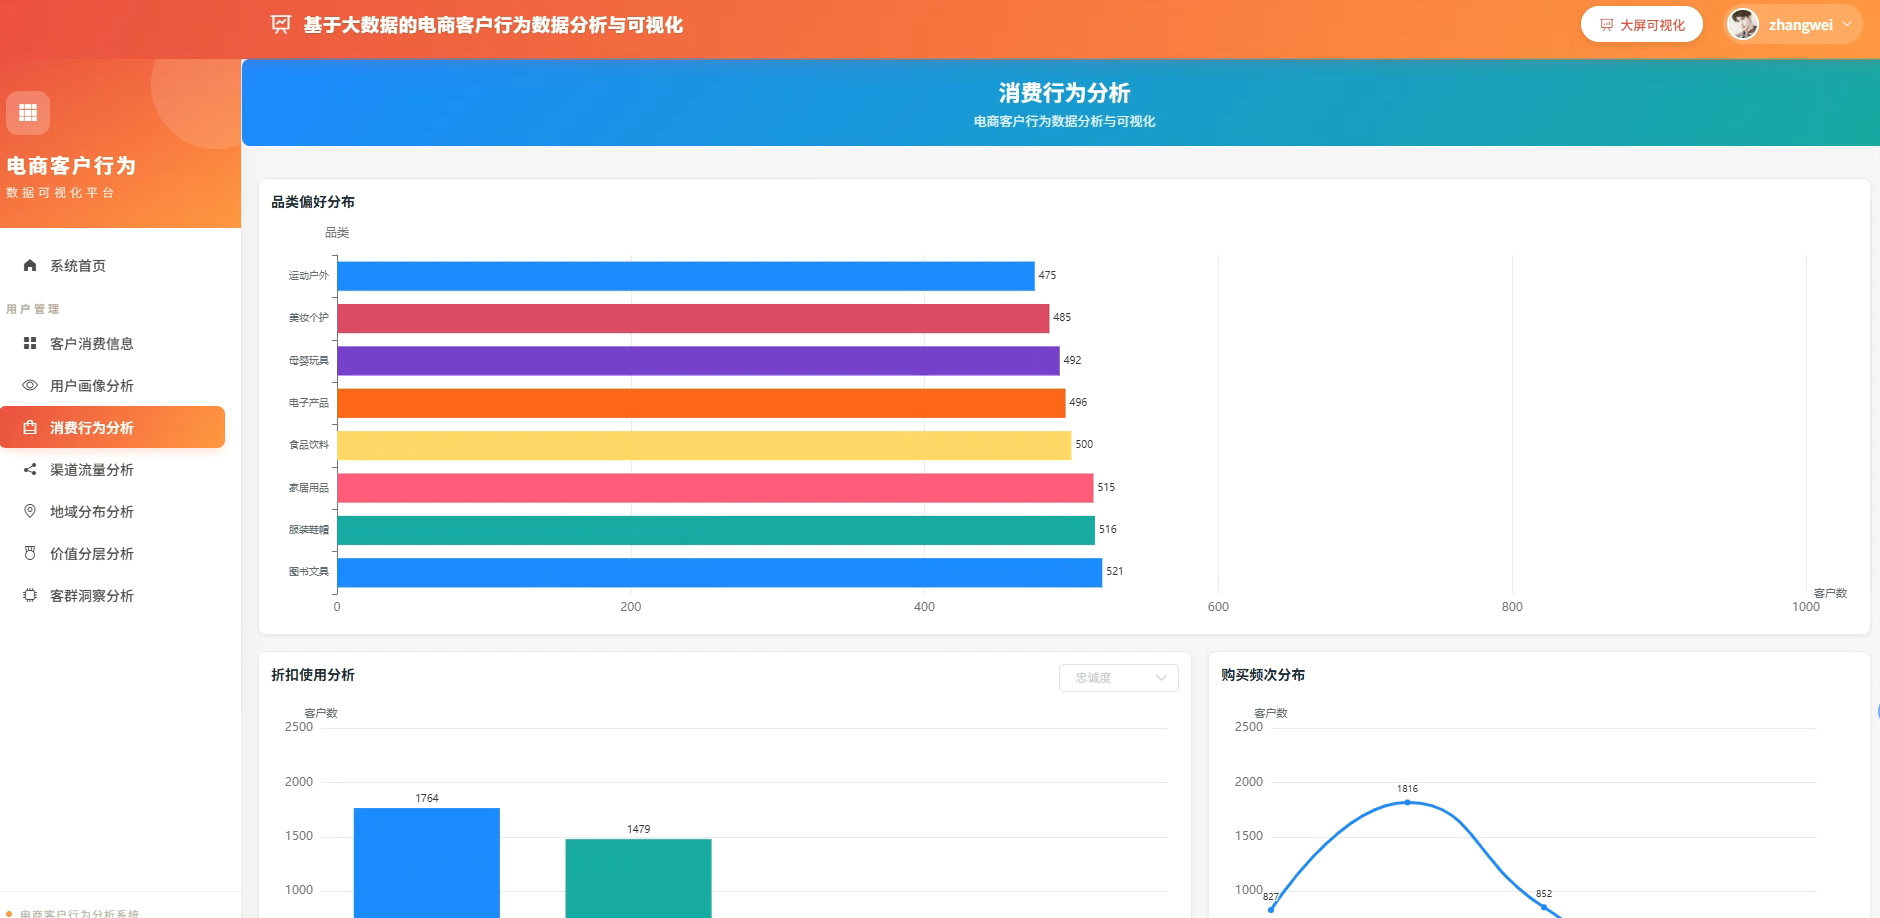
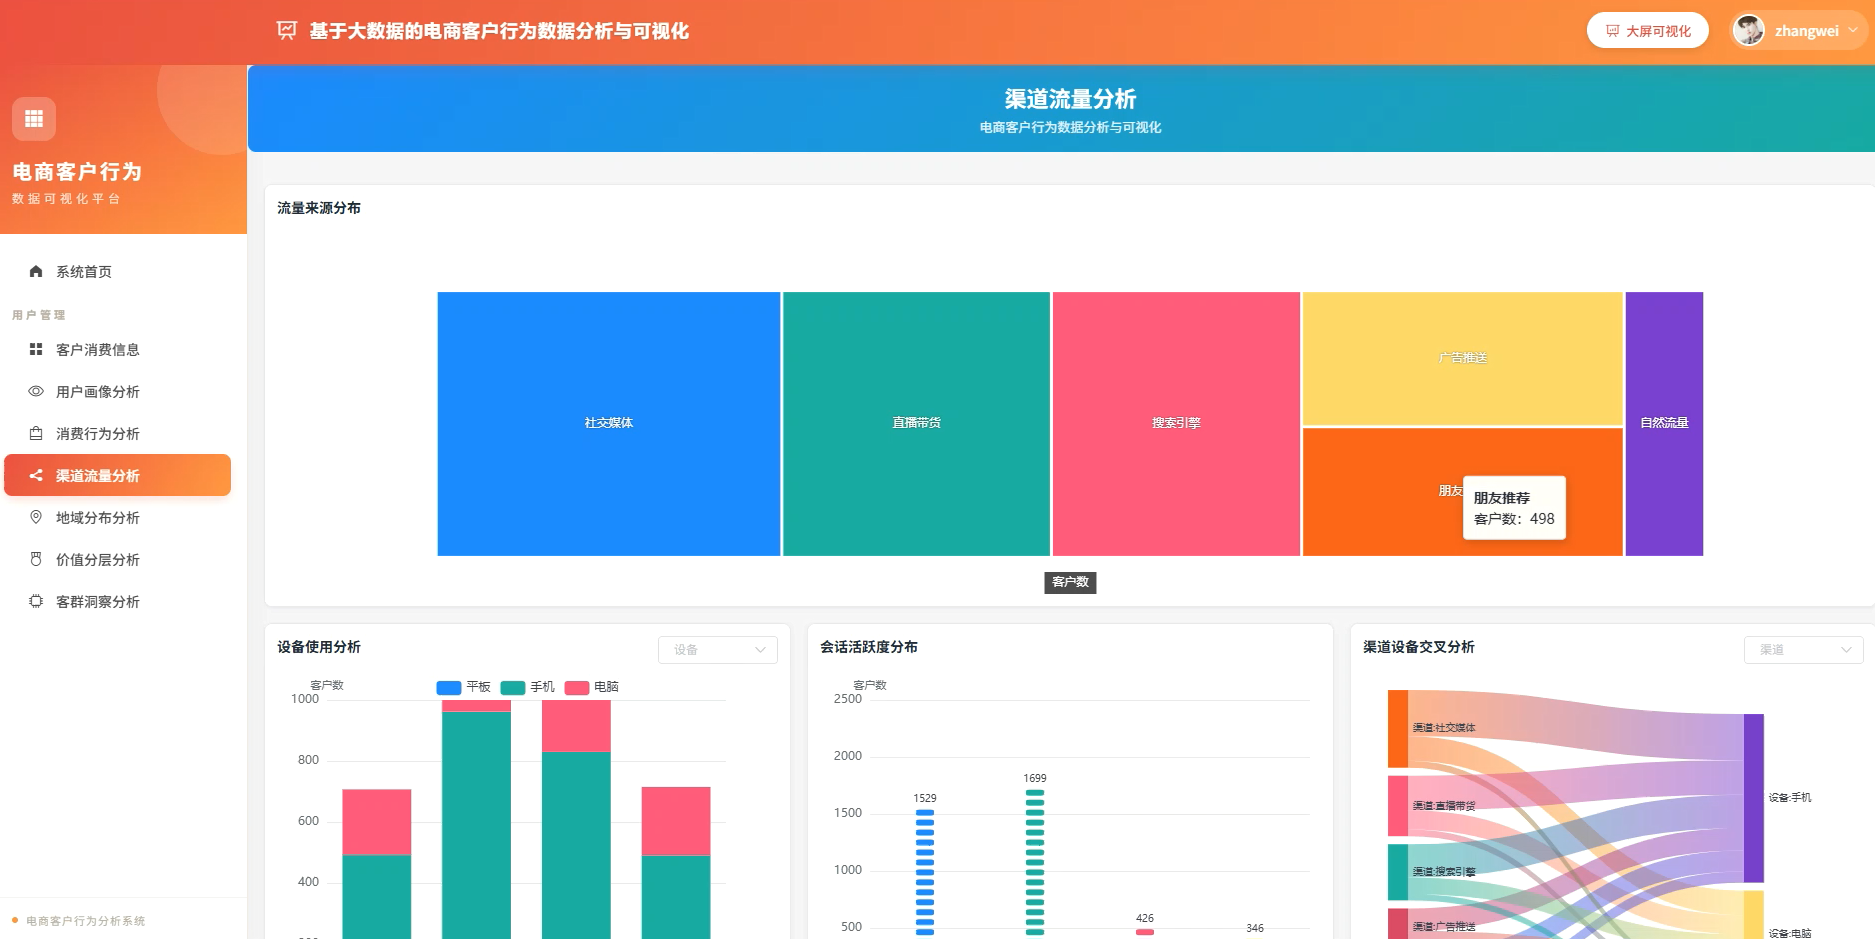
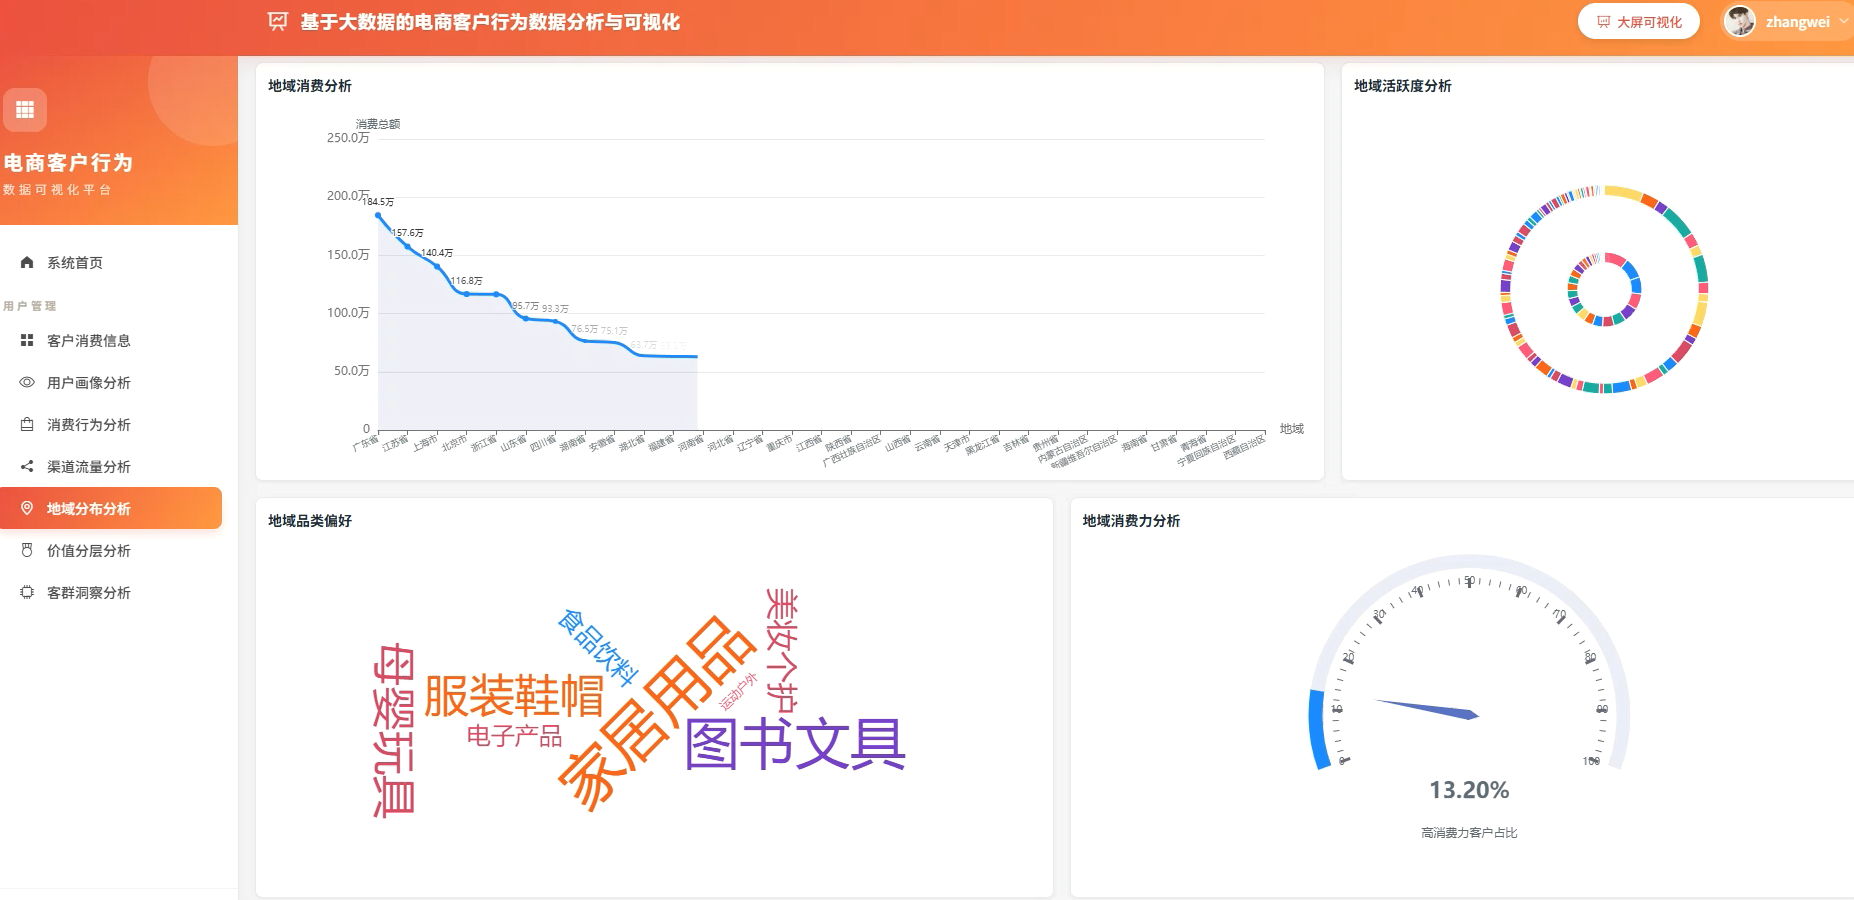
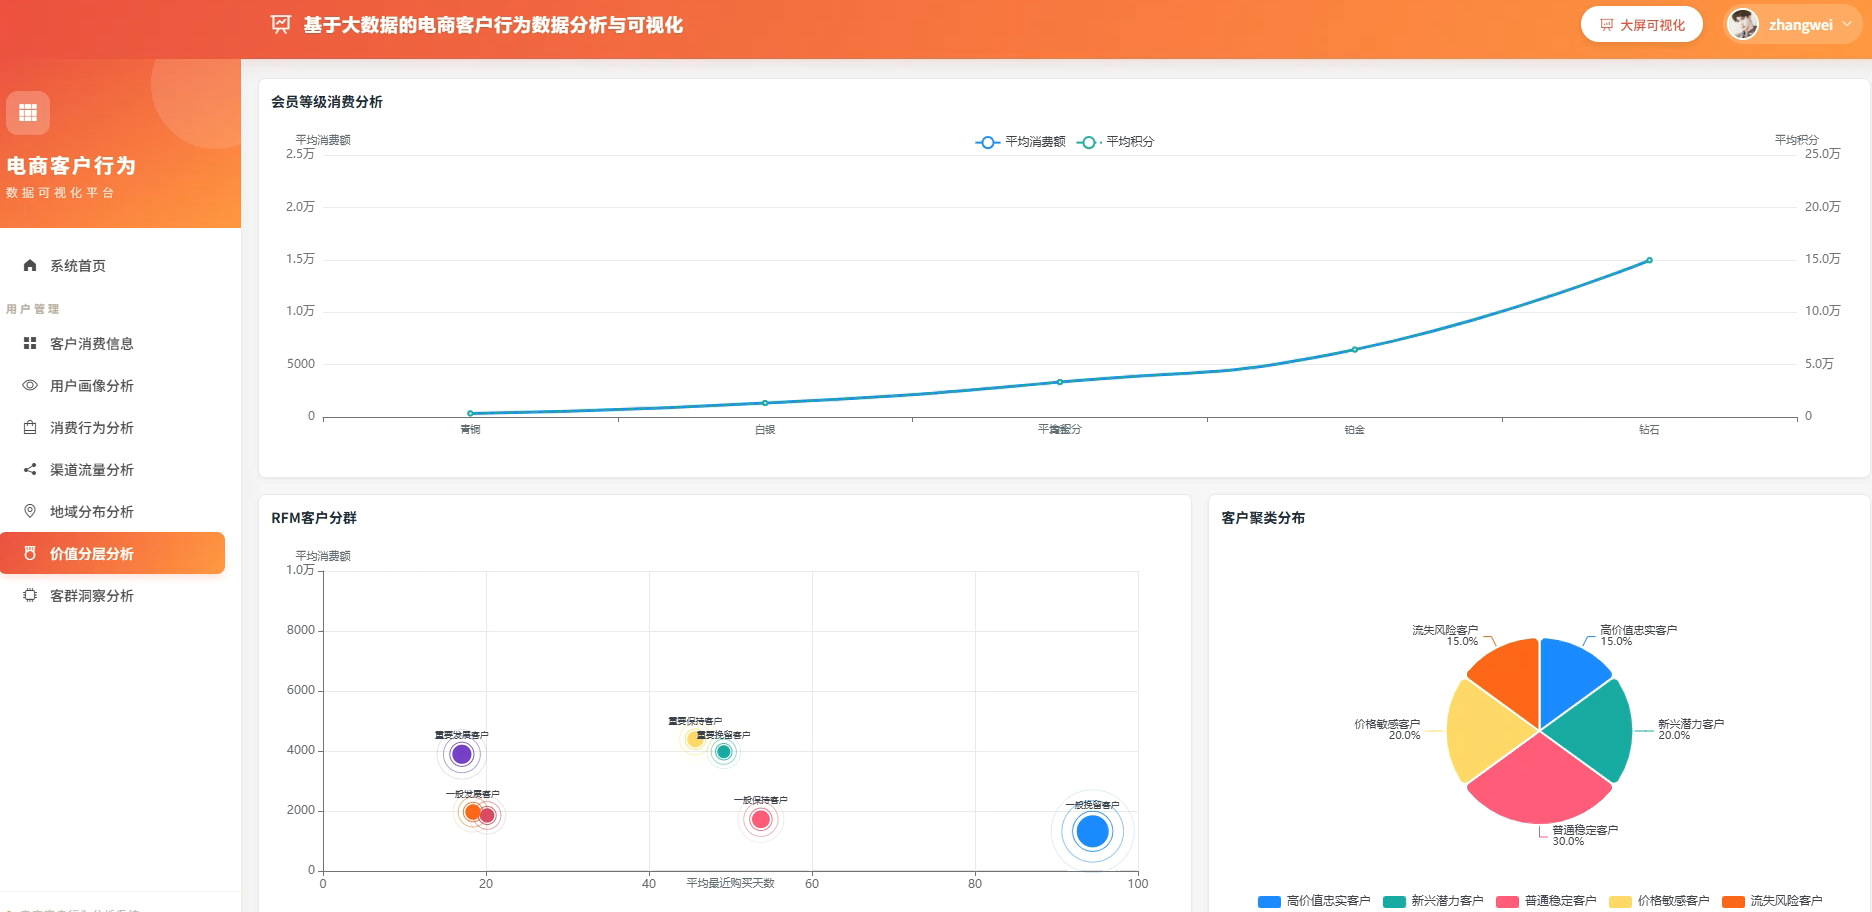
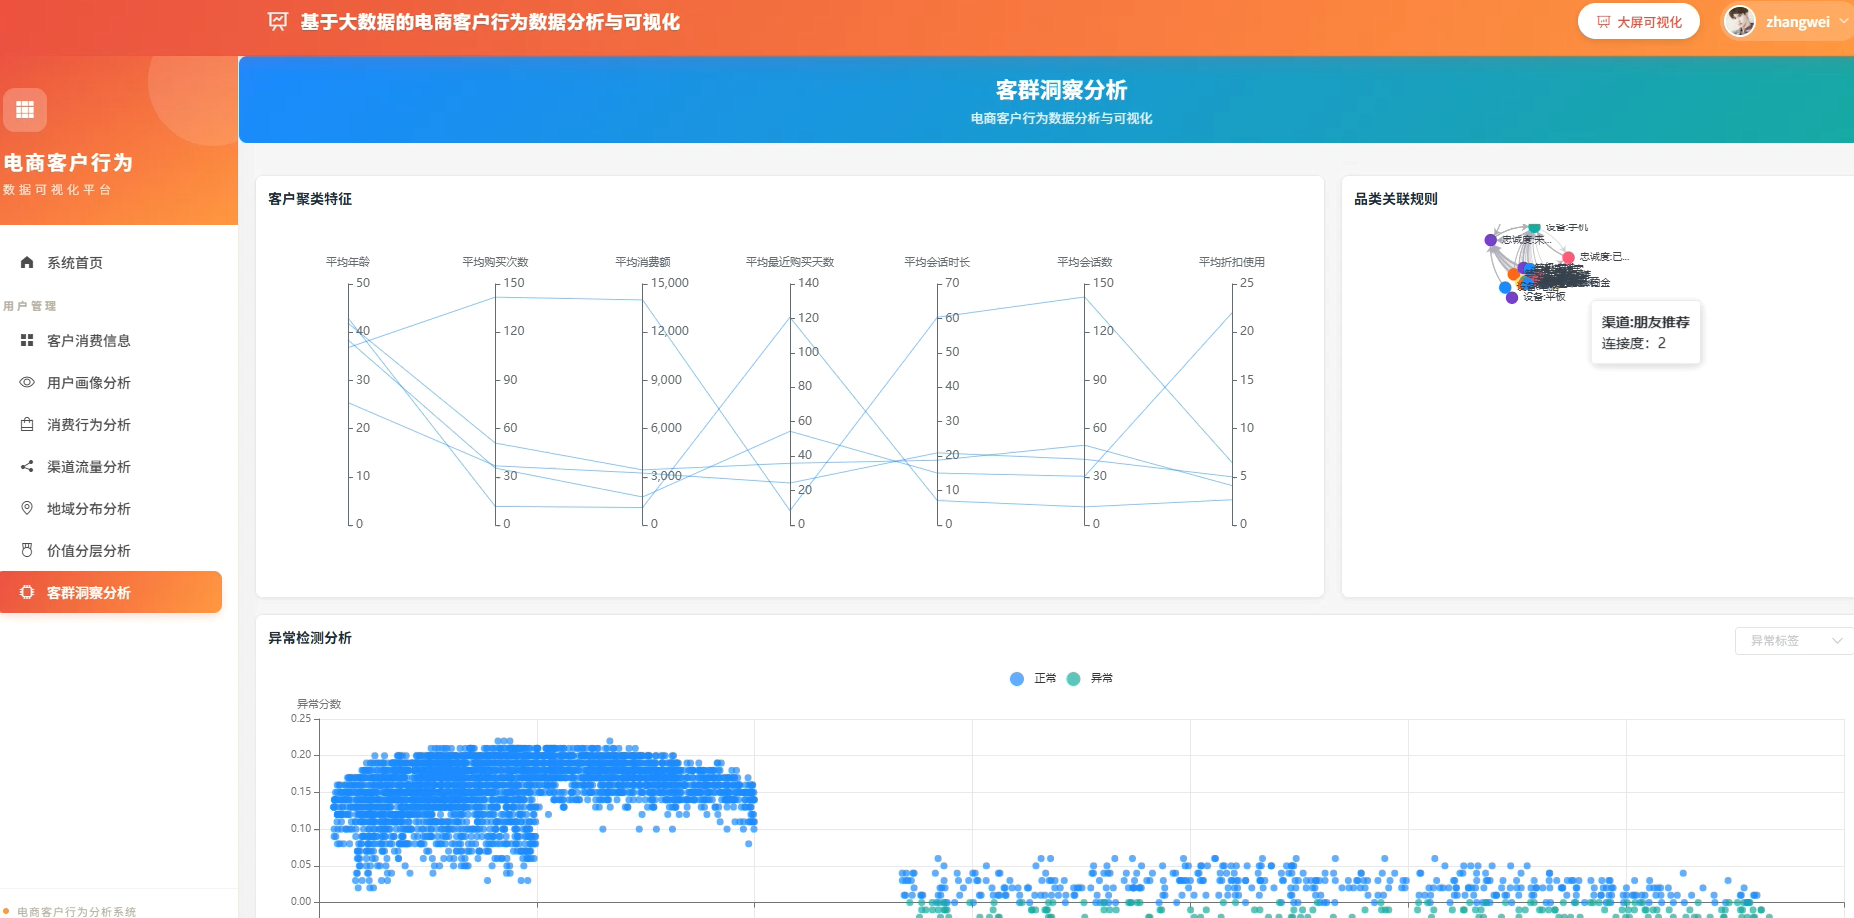
系统以Hadoop和Spark为核心数据处理引擎,对合并后的4000条电商客户数据进行ETL预处理。功能模块涵盖用户画像、消费行为、渠道流量、区域分布及价值分层五大分析维度。在此基础上,系统进一步集成了K-Means聚类算法用于挖掘自然客群,采用FP-Growth关联规则发现品类与渠道间的组合模式,并引入孤立森林算法进行异常消费检测。所有分析结果以CSV形式输出,并最终通过Vue与ECharts构建的可视化大屏进行多图联动展示。
经过系统测试与验证,本系统能够帮助电商运营人员清晰掌握客户结构、消费偏好与区域特征,精准识别高价值客户与异常行为模式。其分析结果可为营销策略制定、选品优化及风险防控提供切实的数据支撑,具备良好的实用价值与应用前景。
二、视频展示
大数据毕设做什么好?基于大数据的电商客户行为数据分析与可视化
三、开发环境
- 大数据技术:Hadoop、Spark、Hive
- 开发技术:Python、Django框架、Vue、Echarts
- 软件工具:Pycharm、DataGrip、Anaconda
- 可视化 工具 Echarts
四、系统展示
系统页面模块展示:
五、代码展示
# 数据预处理:两文件合并,字段语义化,类型规范化
from pyspark.sql import SparkSession
from pyspark.sql.functions import lit, col, when, row_number, monotonically_increasing_id
from pyspark.sql.window import Window

spark = SparkSession.builder.appName("EcommerceETL").getOrCreate()

# 读取两个数据源,统一表头结构
df1 = spark.read.csv("hdfs://path/ecommerce_customer_clustering_dataset.csv",
                      header=True, encoding='utf-8-sig', inferSchema=True)
df2 = spark.read.csv("hdfs://path/system_customers_dataset.csv",
                      header=True, encoding='utf-8-sig', inferSchema=True)

# 添加来源标记,纵向合并
df1 = df1.withColumn("data_source", lit("电商聚类"))
df2 = df2.withColumn("data_source", lit("系统客户"))
df_merged = df1.union(df2)

# 将loyalty_program的0/1转为中文语义,便于可视化
df_merged = df_merged.withColumn(
    "loyalty_program",
    when(col("loyalty_program") == 1, "已加入").otherwise("未加入")
)

# 数据类型规范化(年龄、积分等转为整数;金额、时长保留两位小数)
df_merged = df_merged.withColumn("age", col("age").cast("int")) \
                     .withColumn("points", col("points").cast("int")) \
                     .withColumn("total_spending", col("total_spending").cast("decimal(10,2)")) \
                     .withColumn("session_duration", col("session_duration").cast("decimal(5,2)"))

# 重新生成全局唯一ID(1-4000)
df_merged = df_merged.withColumn("new_id", row_number().over(Window.orderBy(monotonically_increasing_id())))
df_merged = df_merged.drop("id").withColumnRenamed("new_id", "id")

# 输出预处理结果
df_merged.coalesce(1).write.csv("hdfs://path/preprocessed_data/data.csv", header=True, mode="overwrite")
六、项目文档展示

七、项目总结
本课题围绕电商客户行为数据分析的实际需求,设计并实现了一个集数据存储、处理、分析与可视化于一体的综合系统。选题紧扣大数据时代企业精细化运营的痛点,将数据挖掘技术引入电商客群洞察领域,具有明确的业务价值与现实意义。
在开发过程中,首先完成了两个异源客户数据集的合并与预处理,解决了字段统一、来源标记、ID重建等问题,形成了4000条完整、规范的全量样本数据。随后,围绕用户画像、消费行为、渠道流量、区域分布、价值分层五大业务维度,设计了共计22项分析指标,覆盖性别年龄、会员等级、品类偏好、消费金额、来源渠道、地域分布、RFM分层等核心业务场景。在算法层面,系统集成了K-Means聚类用于客户自然分群,FP-Growth关联规则用于挖掘品类-渠道共现模式,以及孤立森林算法用于异常消费行为检测,有效提升了分析深度与洞察能力。前端采用Vue框架与ECharts图表库构建可视化大屏,实现了多维度联动筛选与地图、柱状图、饼图等多种图表展示。
经过系统测试,本系统能够帮助电商运营人员快速掌握客户结构、消费偏好与区域特征,精准定位高价值客群与流失风险客户,为营销策略制定与运营决策提供切实的数据支撑,具有良好的实用价值。
大家可以帮忙点赞、收藏、关注、评论啦 👇🏻
💖🔥作者主页:计算机毕设木哥🔥 💖

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 7
 0
- 0


 已为社区贡献2条内容

所有评论(0)