深度学习入门:初识深度学习
深度学习入门:初识深度学习
前言:本文是“深度学习入门”系列的第一篇。从本章开始,我们将正式进入深度学习的领域。如果说机器学习是让计算机从数据中学习规律,那么深度学习就是让计算机自己发现数据中的规律。它通过模拟人脑神经网络的结构,让机器能够自动提取特征,在图像识别、语音识别、自然语言处理等领域取得了革命性的突破。
目录
- 一、从人工智能到深度学习
- 二、神经网络核心构造
- 三、激活函数
- 四、损失函数
- 五、正则化惩罚
- 六、梯度下降
- 七、BP 反向传播
- 八、总结
一、从人工智能到深度学习
1.1 人工智能、机器学习、深度学习的关系
三者是包含关系:
| 概念 | 说明 |
|---|---|
| 人工智能(AI) | 让机器具备人类智能的宏大目标 |
| 机器学习(ML) | 实现 AI 的一种方法:让机器从数据中学习 |
| 深度学习(DL) | 机器学习的一个分支:使用多层神经网络 |
通俗理解:人工智能是“让电脑变聪明”这个目标,机器学习是“让电脑自己看书学习”这个方法,深度学习是“让电脑模仿人脑结构”这种更高级的学习方式。
1.2 深度学习是什么?
深度学习(Deep Learning)是一种基于人工神经网络的机器学习方法。它的核心特点是用多层神经网络自动从数据中提取特征,并通过反向传播算法不断优化网络参数,最终实现对复杂数据的建模与分类。
1.3 深度学习的应用场景
| 领域 | 应用 |
|---|---|
| 图像识别 | 人脸识别、自动驾驶、医学影像诊断 |
| 语音识别 | 智能助手、语音输入、语音翻译 |
| 自然语言处理 | 机器翻译、文本生成、情感分析 |
| 推荐系统 | 短视频推荐、商品推荐、广告投放 |
二、神经网络核心构造
2.1 神经元模型
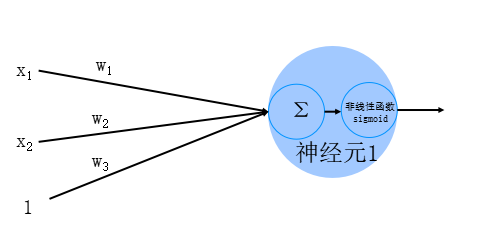
神经网络的基本单元是神经元(Neuron),它模拟了生物神经元的信号传递方式。
一个神经元接收多个输入信号 x₁, x₂, ..., xₙ,每个输入带有不同的权重 w₁, w₂, ..., wₙ,经过线性加权求和后,再通过一个激活函数输出结果。
2.2 权重的作用
权重(Weight)决定了输入信号对神经元的影响程度。可以类比为:外界信号在传入神经元的过程中会有损耗,实际传入的信号是 wx。
- 权重越大,该输入对神经元的影响越大
- 权重越小,该输入对神经元的影响越小
- 训练神经网络的核心任务,就是找到最优的权重值
2.3 感知器
感知器(Perceptron) 是最简单的神经网络——只有输入层和输出层两层结构。
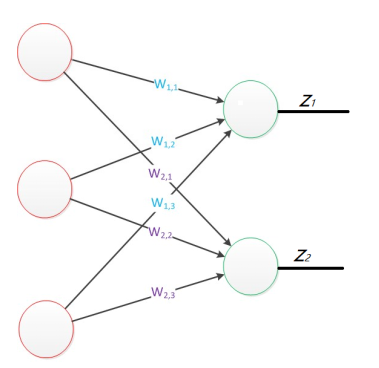
感知器可以用矩阵运算表示:
z = g ( W ⋅ x ) z = g(W \cdot x) z=g(W⋅x)
其中 ( W ) 是权重矩阵,( x ) 是输入向量,( g ) 是激活函数。
局限性:感知器只能处理线性可分的问题,无法解决异或(XOR)等非线性问题。
2.4 多层感知器
为了解决非线性问题,需要在输入层和输出层之间加入隐藏层(Hidden Layer)。
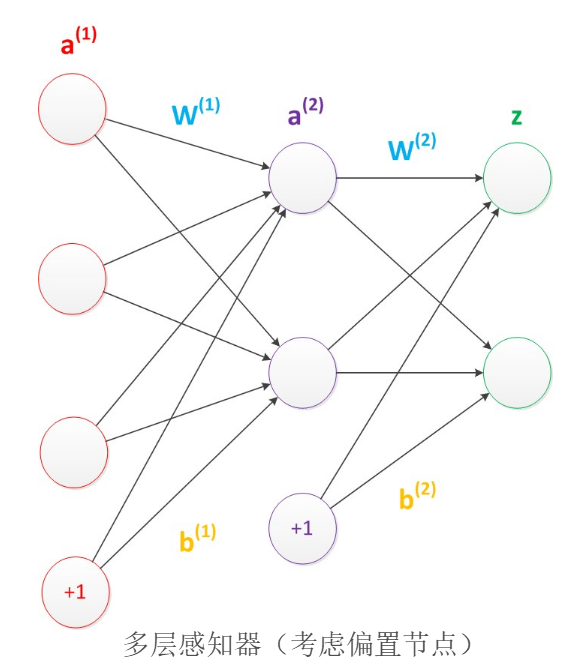
多层感知器的关键能力:隐藏层使神经网络能够处理非线性分类问题。隐藏层越多,网络的表达能力越强。
2.5 偏置节点
在神经网络的每一层中,除了正常的神经元外,还存在一个偏置节点(Bias)。它的值是固定的 1。
- 偏置节点没有前一层输入
- 它本质上是一个存储值为 1 的单元
2.6 设计神经网络的要点
| 设计要点 | 说明 |
|---|---|
| 输入层节点数 | 等于特征的维度 |
| 输出层节点数 | 等于目标的维度 |
| 隐藏层节点数 | 没有固定规则,通常通过实验确定最佳值 |
| 权重 | 每个连接线对应一个权重,训练的目标就是找到最优权重 |
三、激活函数
3.1 什么是激活函数
激活函数的作用是引入非线性。如果没有激活函数,无论多少层网络都只是线性变换,无法解决非线性问题。
3.2 常用激活函数
| 激活函数 | 表达式 | 特点 |
|---|---|---|
| Sigmoid | f ( x ) = 1 1 + e − x f(x) = \frac{1}{1 + e^{-x}} f(x)=1+e−x1 | 输出 0~1,适合二分类输出层 |
| Tanh | f ( x ) = e x − e − x e x + e − x f(x) = \frac{e^x - e^{-x}}{e^x + e^{-x}} f(x)=ex+e−xex−e−x | 输出 -1~1,零中心化 |
| ReLU | f ( x ) = max ( 0 , x ) f(x) = \max(0, x) f(x)=max(0,x) | 计算简单,常用在隐藏层 |
| Softmax | f ( x i ) = e x i ∑ j e x j f(x_i) = \frac{e^{x_i}}{\sum_j e^{x_j}} f(xi)=∑jexjexi | 多分类输出层,输出概率分布 |
3.3 Softmax 详解
Softmax 的作用是将一组数值转换为概率分布(所有值在 0~1 之间,且和为 1)。
输入: [5, 4.9, -2]
取指数: [148.4, 134.3, 0.135]
归一化: [0.4748, 0.5247, 0.0005]
在多分类任务中,Softmax 输出每个类别的概率,选择概率最大的类别作为预测结果。
四、损失函数
4.1 什么是损失函数
损失函数衡量预测值与真实值之间的差距。模型训练的目标就是让损失值尽可能小。
通俗理解:损失函数就像考试分数——分数越低(损失越小),说明模型预测得越准。
4.2 常见损失函数
| 损失函数 | 适用场景 |
|---|---|
| 均方差损失 | 回归问题 |
| 平均绝对差损失 | 回归问题(对离群点更鲁棒) |
| 交叉熵损失 | 分类问题(最常用) |
| 合页损失 | SVM 分类 |
| 0-1 损失 | 理论分析 |
4.3 交叉熵损失
交叉熵是分类问题中最常用的损失函数。以三分类为例,某次训练的真实标签是“猫”(第 1 类),预测结果为:
| 类别 | 预测概率 | 真实标签 |
|---|---|---|
| 猫 | 0.5247 | 1 |
| 狗 | 0.4748 | 0 |
| 鸟 | 0.0005 | 0 |
交叉熵损失为:
Loss = − log ( 0.5247 ) ≈ 0.28 \text{Loss} = -\log(0.5247) \approx 0.28 Loss=−log(0.5247)≈0.28
取 -log 的原因:
- 预测概率越接近 1 →
-log(p)越接近 0(损失小,预测正确) - 预测概率越接近 0 →
-log(p)越大(损失大,预测错误)
这就是为什么分类时“分对了损失小,分错了损失大”。
五、正则化惩罚
5.1 为什么需要正则化
训练神经网络时,模型可能过拟合——在训练集上表现很好,但在测试集上表现差。正则化的作用是防止过拟合,让模型更关注所有特征,而不是过度依赖某几个特征。
5.2 L1 和 L2 正则化
| 正则化 | 表达式 | 特点 |
|---|---|---|
| L1 正则化 | ∑ i ∣ w i ∣ \sum_i |w_i| ∑i∣wi∣ | 产生稀疏权重,可做特征选择 |
| L2 正则化 | ∑ i w i 2 \sum_i w_i^2 ∑iwi2 | 权重更均匀,整体效果更好 |
5.3 直观理解
假设输入 x = [1, 1, 1, 1],两种权重方案:
| 权重方案 | 与 x 的乘积 | 特点 |
|---|---|---|
w₁ = [1, 0, 0, 0] | 1 | 只学习第一个特征,容易过拟合 |
w₂ = [0.25, 0.25, 0.25, 0.25] | 1 | 每个特征都学到,泛化能力更强 |
L2 正则化倾向于第二种方案——让权重“雨露均沾”,从每个输入特征中都学习信息,从而提升泛化能力。
六、梯度下降
6.1 梯度与偏导数
对于一个多元函数,偏导数是函数关于某个变量的导数(其他变量保持不变)。
梯度是所有偏导数构成的向量。梯度向量的方向是函数值增长最快的方向。
6.2 梯度下降法
梯度下降法(Gradient Descent)的核心思想是:沿着梯度相反的方向更新参数,使损失函数值逐步减小。
w new = w old − η ⋅ ∂ Loss ∂ w w_{\text{new}} = w_{\text{old}} - \eta \cdot \frac{\partial \text{Loss}}{\partial w} wnew=wold−η⋅∂w∂Loss
其中 η \eta η 是学习率。
6.3 学习率的选择
| 学习率 | 效果 |
|---|---|
| 太大 | 步子太大,容易越过最低点,无法收敛 |
| 太小 | 步子太小,训练速度极慢,容易陷入局部最优 |
| 适中 | 稳定收敛到最优解 |
6.4 如何避免局部最优
梯度下降可能陷入局部最优,而非全局最优。常用的解决方案:
- 多次随机初始化:从不同位置开始搜索
- 使用动量优化器:如 Adam、SGD with Momentum
七、BP 反向传播
7.1 什么是 BP
BP(Back Propagation,反向传播)是训练神经网络的核心算法。它通过前向传播计算预测结果,再通过反向传播将误差逐层传回,更新每一层的权重。
7.2 算法流程
| 步骤 | 说明 |
|---|---|
| 1. 前向传播 | 输入数据从输入层进入,逐层计算,最终得到输出预测结果 |
| 2. 计算损失 | 将预测结果与真实标签对比,通过损失函数计算损失值 |
| 3. 反向传播 | 从输出层开始,逐层向前计算每个权重的偏导数(梯度) |
| 4. 更新权重 | 根据偏导数和学习率,沿梯度反方向更新所有连接权重 |
| 5. 循环迭代 | 重复 1-4 步,直到损失值小于设定阈值或达到最大迭代次数 |
7.3 前向传播
数据从输入层进入,经过每层的加权求和 + 激活函数,最终得到输出结果。这个过程就是“前向传播”。
7.4 反向传播
从输出层开始,计算每个权重的偏导数,将误差逐步“传回”到前面的层。
核心思想:通过链式求导法则,将最终的损失反向分配到每一个权重上,从而指导权重的更新方向。
八、总结
核心知识点速查
| 知识点 | 关键概念 |
|---|---|
| AI → ML → DL | 包含关系:人工智能 > 机器学习 > 深度学习 |
| 神经元 | 加权求和 + 激活函数 |
| 权重 | 决定输入信号的影响程度,训练目标就是找最优权重 |
| 激活函数 | 引入非线性,Sigmoid、Tanh、ReLU、Softmax |
| 损失函数 | 衡量预测与真实值的差距,交叉熵最常用 |
| 正则化 | 防止过拟合,L1(稀疏)/ L2(均匀) |
| 梯度下降 | 沿梯度反方向更新参数,学习率是关键 |
| BP 反向传播 | 前向计算损失 + 反向传播误差 + 更新权重 |
注意事项
| 要点 | 说明 |
|---|---|
| 隐藏层设计 | 没有固定规则,通过实验确定最佳节点数 |
| 学习率选择 | 过大不收敛,过小训练慢,需要调参 |
| 偏置节点 | 每层默认存在,值为 1,结构图中通常不画 |
| 权重初始化 | 一般使用随机初始化,避免对称性 |
| Softmax 与交叉熵 | 常搭配使用,是多分类的标准配置 |
系列直达
- 本篇:深度学习入门:初识深度学习(本文)
- 下篇:深度学习入门:PyTorch 环境搭建与 MNIST 手写数字识别

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 11
 0
- 0


 已为社区贡献1条内容

所有评论(0)