最新大数据毕业设计选题推荐-基于大数据的电动汽车故障数据分析与可视化-大数据-Spark-Hadoop-Bigdata
✨作者主页:IT研究室✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、微信小程序、Golang、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
精彩专栏推荐⬇⬇⬇
Java项目
Python项目
安卓项目
微信小程序项目
一、前言
系统介绍
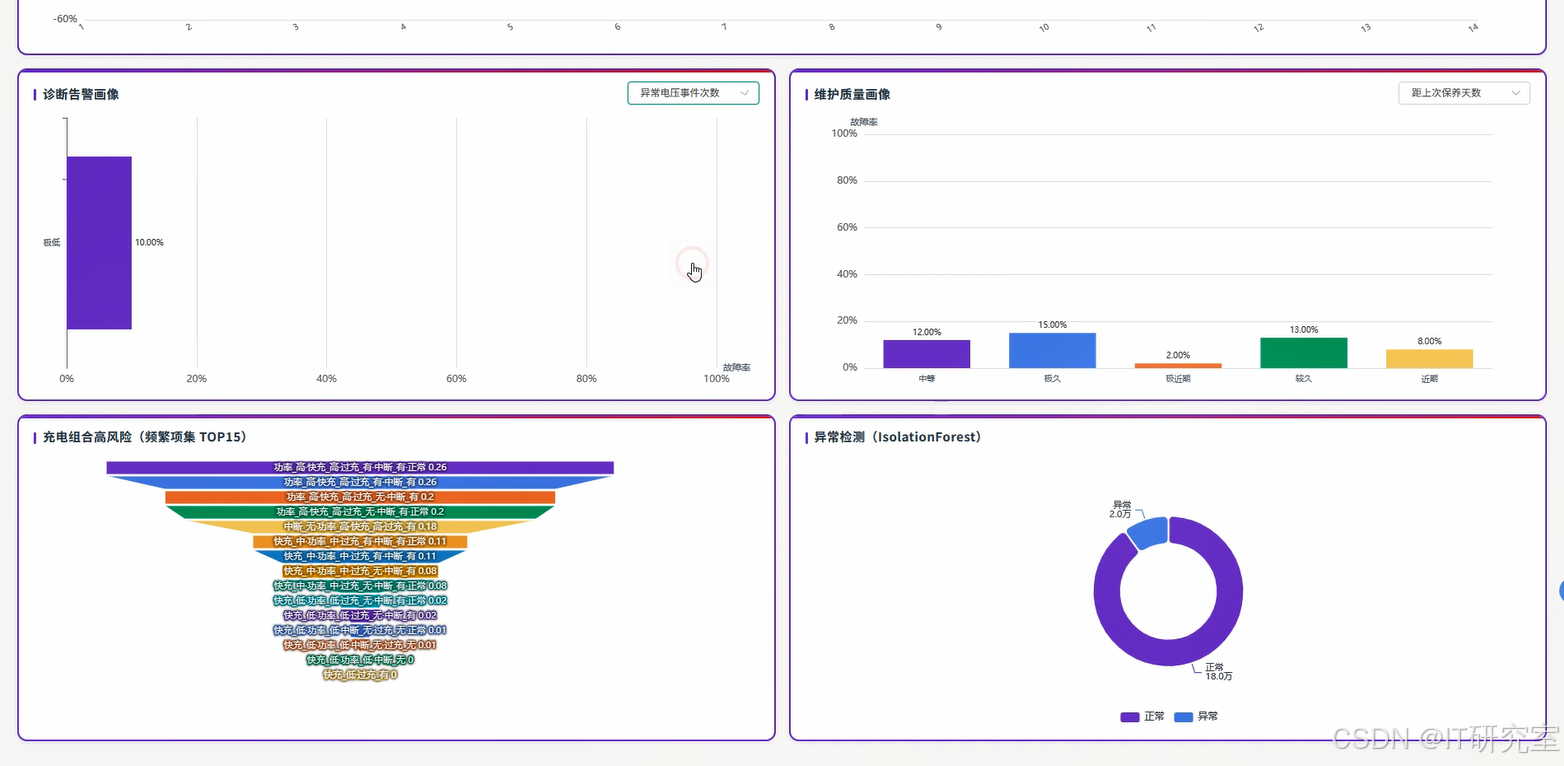
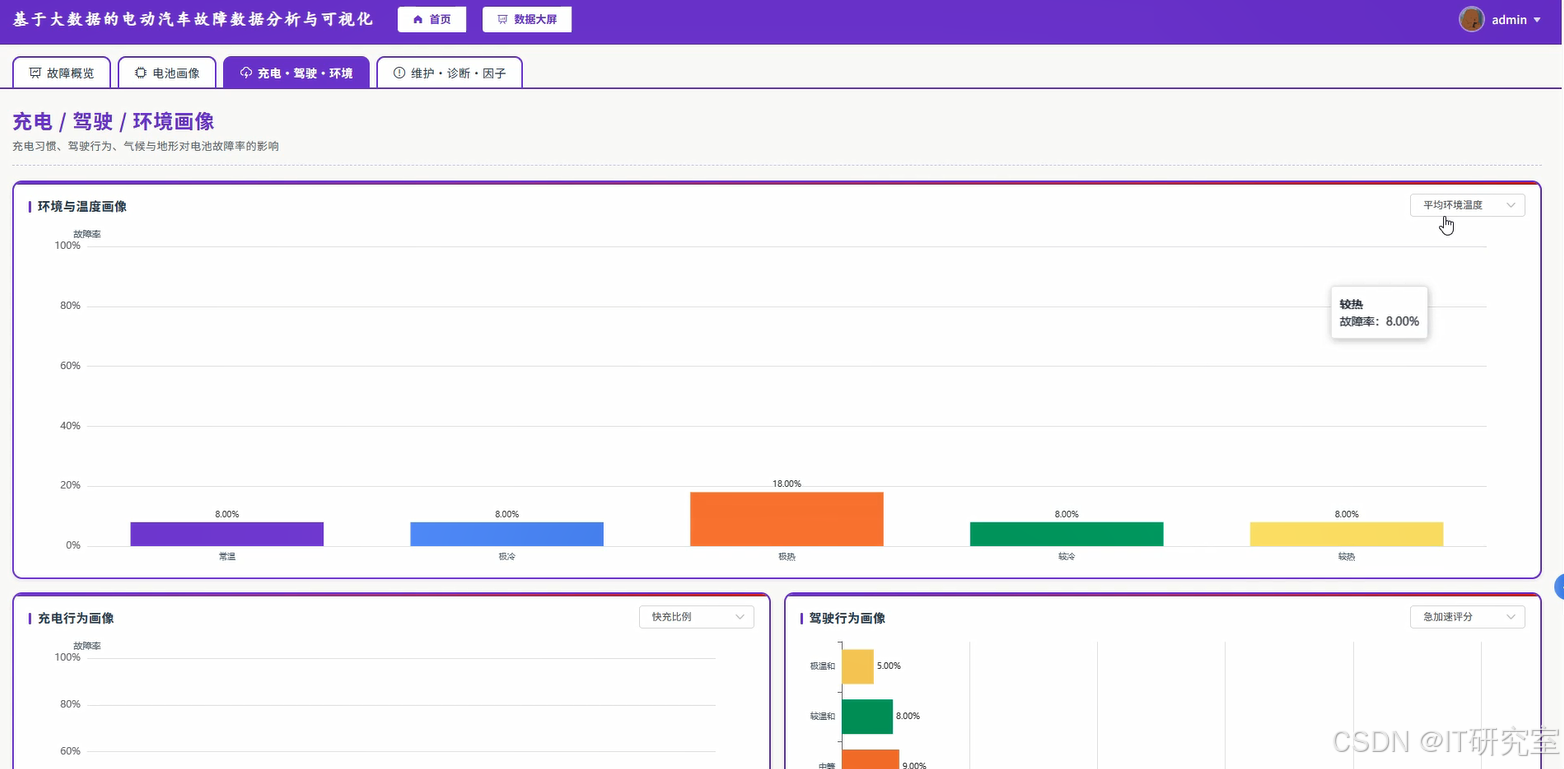
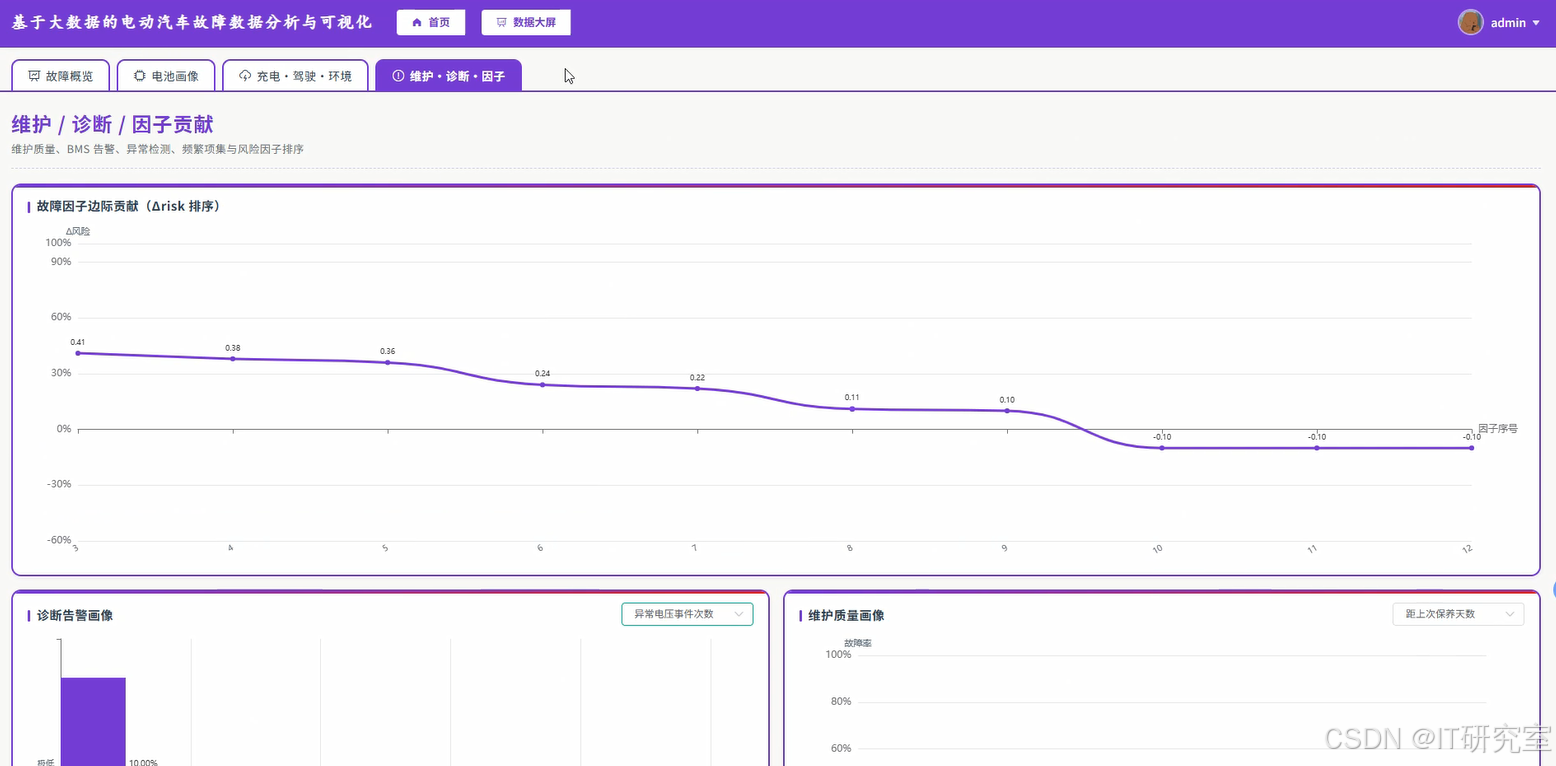
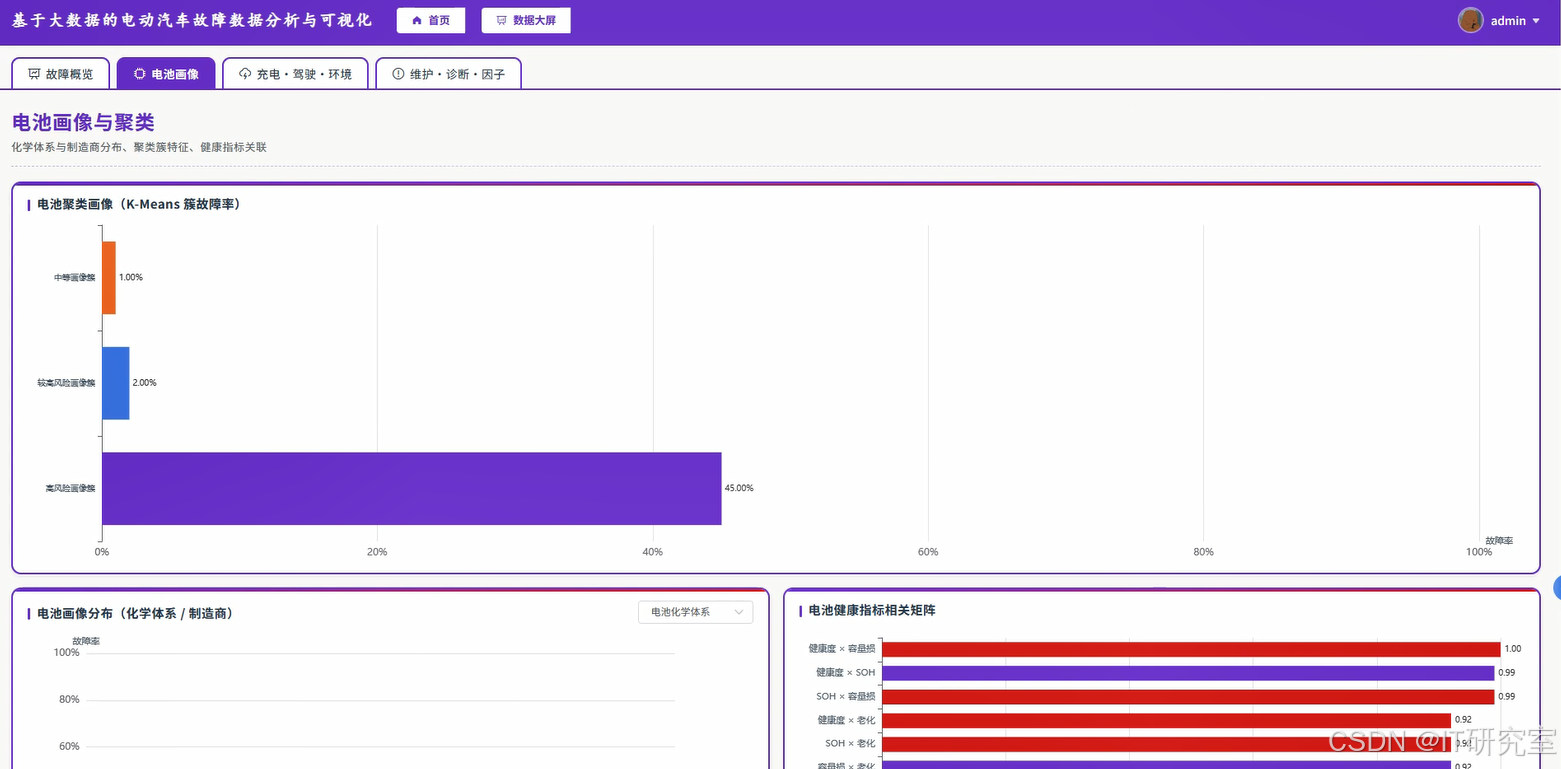
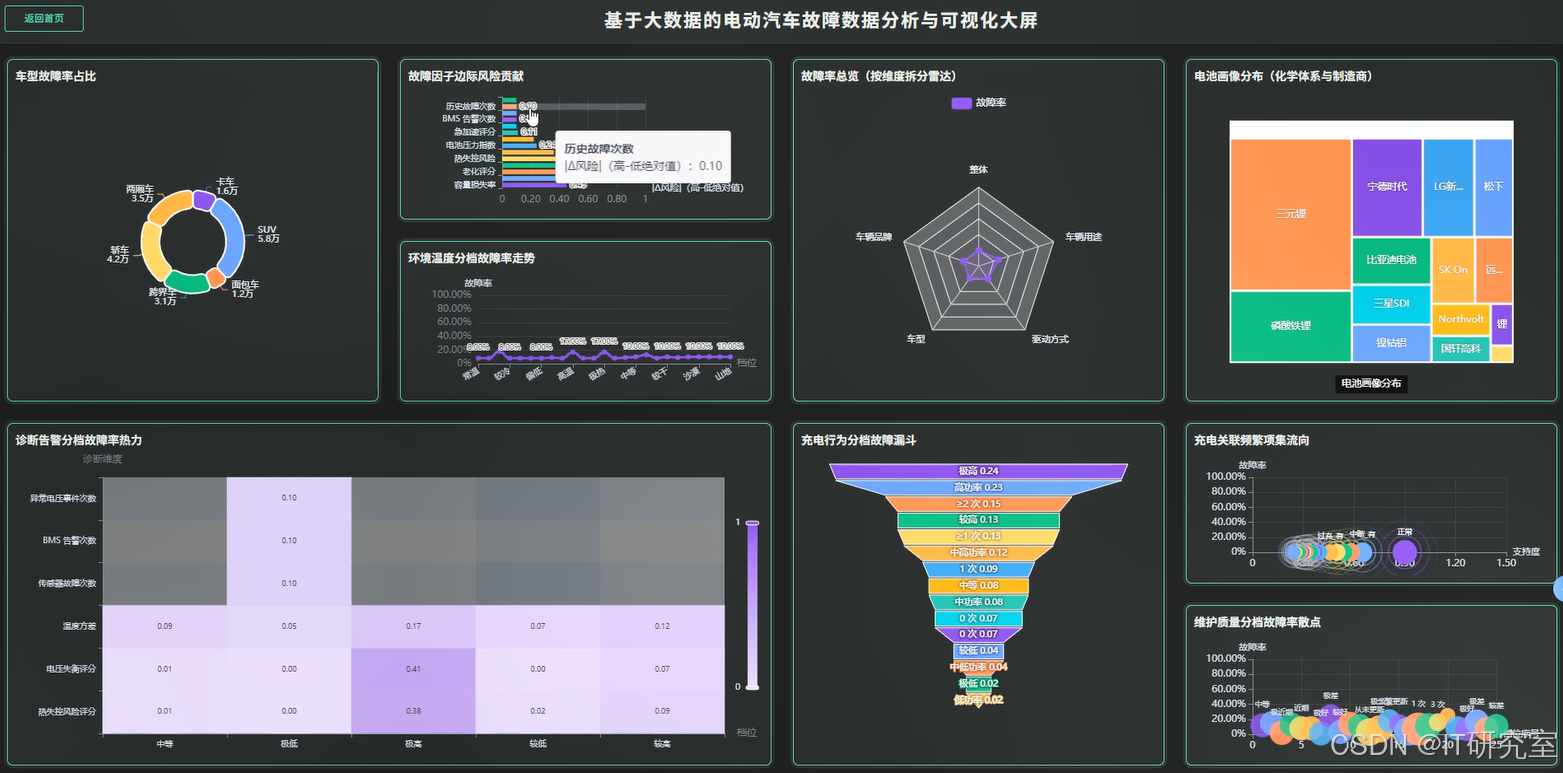
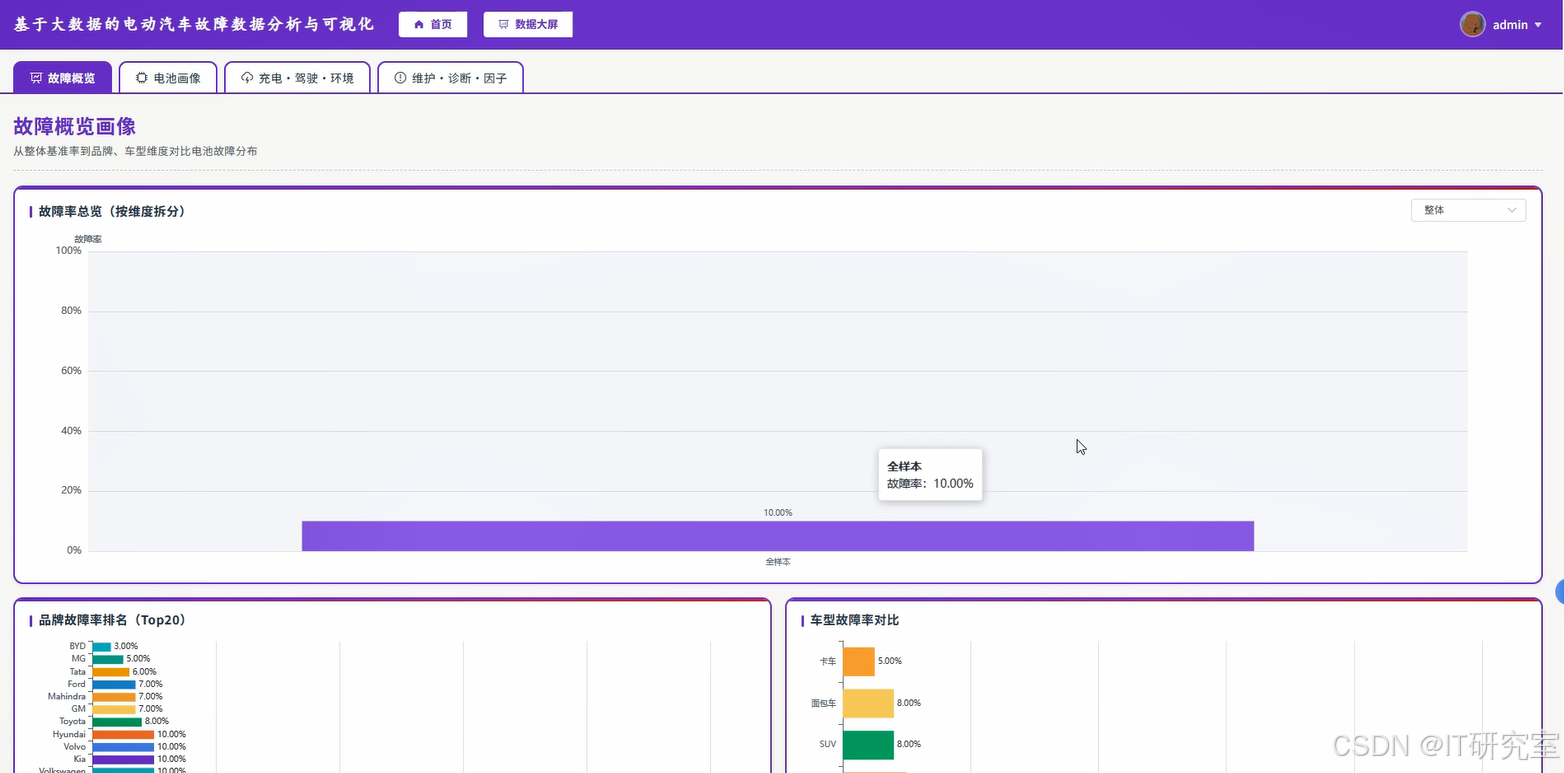
《基于大数据的电动汽车故障数据分析与可视化》系统以Hadoop分布式文件系统(HDFS)为核心存储底座,依托Spark分布式计算引擎对电动汽车海量运行数据进行高效清洗、转换与聚合分析,在此基础上采用Spring Boot构建后端服务接口,Vue与ECharts搭配完成前端交互与图表渲染,MySQL负责管理诊断因子、用户信息等结构化业务数据。系统面向充电驾驶环境、电池数据、故障概览等实际业务场景,围绕电池数据管理、电池画像构建、诊断因子维护等功能模块展开,能够对车辆上报的多维传感器数据进行批处理与多维度交叉对比,最终以可视化看板呈现电池健康状态、故障分布规律及潜在风险趋势,为电动汽车故障研判提供数据支撑。
选题背景
近年来新能源汽车产业持续高速发展,电动汽车保有量快速增长,随之而来的电池老化、充电异常、驾驶工况突变等故障问题日益凸显。车辆运行过程中产生的数据规模呈指数级上升,传统单机处理工具面对TB级日志与传感器数据时存在明显的性能瓶颈,难以支撑快速分析与实时响应需求。Hadoop与Spark等大数据技术为海量车况数据的存储与计算提供了有效解决路径,但当前不少计算机专业学生在毕设阶段对这类分布式技术栈的实际落地仍感到陌生,从环境搭建到任务调度的完整流程缺乏系统认知。本课题正是基于这样的现实需求,将大数据处理框架与电动汽车故障分析场景相结合,帮助学生打通数据采集、清洗、计算到可视化展示的全链路。
选题意义
从实际应用层面来看,本课题能够为电动汽车运维人员提供一个直观查看电池状态与故障分布的工具,减少人工翻阅日志的繁琐操作,提升日常数据排查效率。从技术训练层面来说,课题涉及HDFS存储、Spark SQL批处理、后端接口设计、前端图表渲染等多个环节,能够帮助学生巩固大数据处理与Web开发的核心技能,积累真实项目经验。从课题普适性角度讲,这套架构与代码组织方式可以迁移至设备日志分析、传感器监控、智能运维等类似场景,具备一定的参考复用价值。总体而言,本课题的定位是一个中等规模的大数据实战项目,不求算法创新或性能优化上的突破,重在把现有技术栈用对、用顺、用完整,让学生把书本上的分布式概念落到可运行的代码和可视化的图表上,在动手过程中加深对大数据处理流程的理解,这才是一个毕业设计应有的务实目标。
二、开发环境
- 大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
- 开发语言:Python+Java(两个版本都支持)
- 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
- 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
- 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
- 数据库:MySQL
三、系统界面展示
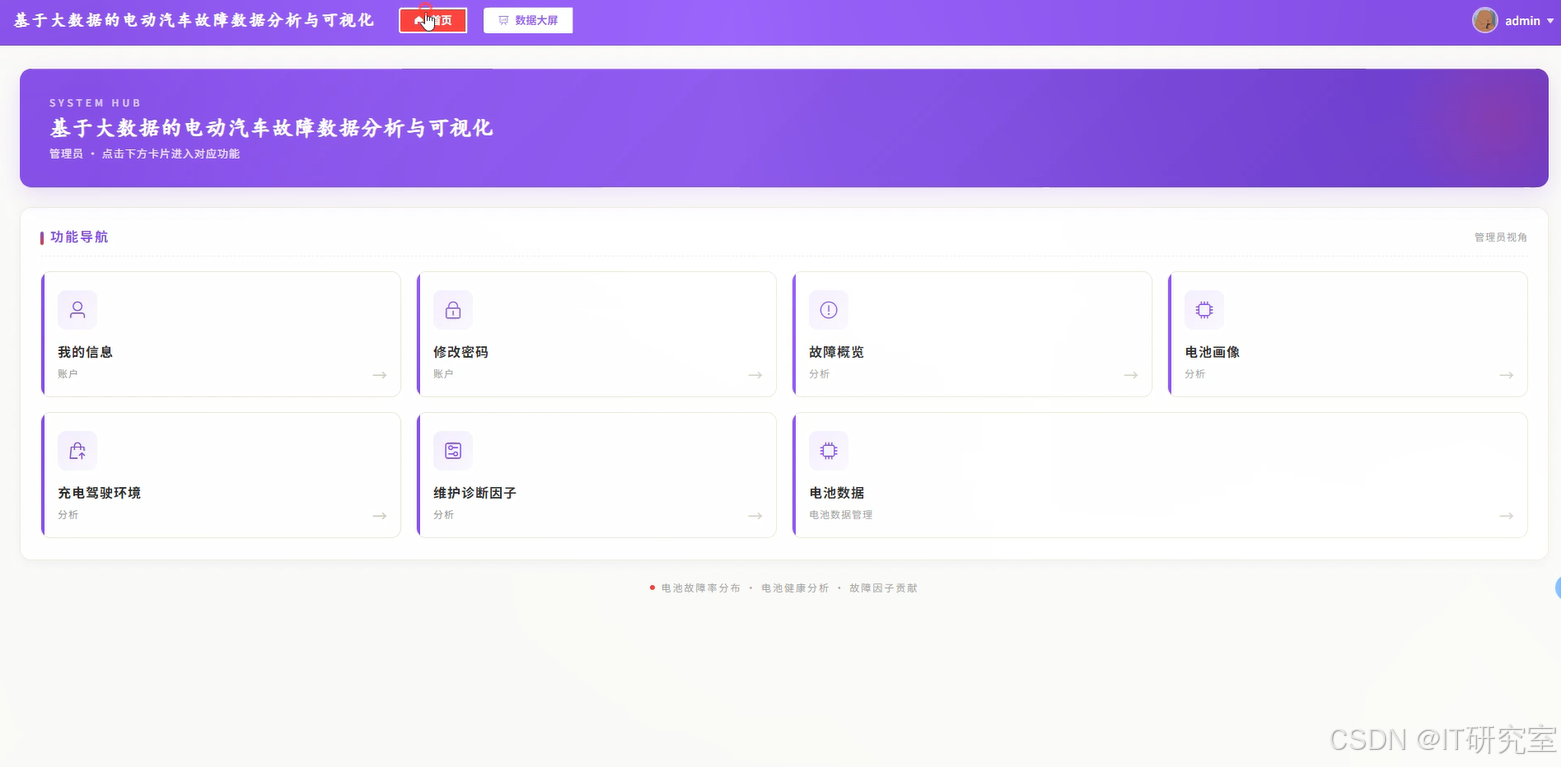
- 基于大数据的电动汽车故障数据分析与可视化界面展示:
四、代码参考
- 项目实战代码参考:
@RestController
@RequestMapping("/api/battery")
public class BatteryController {
    @Autowired
    private BatteryService batteryService;

    @PostMapping("/process")
    public Result processBatteryData(@RequestParam String date) {
        SparkSession spark = SparkSession.builder()
                .appName("BatteryDataAnalysis")
                .master("local[*]")
                .config("spark.sql.shuffle.partitions", "10")
                .getOrCreate();
        Dataset<Row> df = spark.read().option("header", "true")
                .csv("hdfs://localhost:9000/ev_data/" + date + "/*.csv");
        Dataset<Row> cleaned = df.filter(col("battery_voltage").isNotNull())
                .filter(col("battery_current").isNotNull())
                .filter(col("temperature").isNotNull())
                .filter(col("battery_voltage").cast(DataTypes.DoubleType).gt(0));
        Dataset<Row> aggResult = cleaned.groupBy("vehicle_id")
                .agg(avg("battery_voltage").alias("avg_voltage"),
                     max("battery_current").alias("max_current"),
                     min("temperature").alias("min_temp"),
                     avg("temperature").alias("avg_temp"));
        aggResult.write().mode("overwrite")
                .json("hdfs://localhost:9000/result/" + date + "/agg_result.json");
        List<BatteryStat> stats = new ArrayList<>();
        for (Row row : aggResult.collectAsList()) {
            BatteryStat stat = new BatteryStat();
            stat.setVehicleId(row.getString(0));
            stat.setAvgVoltage(row.getDouble(1));
            stat.setMaxCurrent(row.getDouble(2));
            stat.setMinTemp(row.getDouble(3));
            stat.setAvgTemp(row.getDouble(4));
            stats.add(stat);
        }
        spark.stop();
        batteryService.saveBatch(stats);
        return Result.success(stats);
    }

    @GetMapping("/faultOverview")
    public Result getFaultOverview() {
        SparkSession spark = SparkSession.builder()
                .appName("FaultOverview")
                .master("local[*]")
                .getOrCreate();
        Dataset<Row> faultDf = spark.read().option("header", "true")
                .csv("hdfs://localhost:9000/fault_logs/*.csv");
        Dataset<Row> grouped = faultDf.filter(col("fault_code").isNotNull())
                .groupBy("fault_code")
                .agg(count("*").alias("occurrence"));
        List<FaultStat> list = new ArrayList<>();
        for (Row row : grouped.collectAsList()) {
            FaultStat fs = new FaultStat();
            fs.setFaultCode(row.getString(0));
            fs.setOccurrence(row.getLong(1));
            list.add(fs);
        }
        spark.stop();
        return Result.success(list);
    }

    @GetMapping("/batteryProfile")
    public Result getBatteryProfile(@RequestParam String vehicleId) {
        SparkSession spark = SparkSession.builder()
                .appName("BatteryProfile")
                .master("local[*]")
                .getOrCreate();
        Dataset<Row> df = spark.read().option("header", "true")
                .csv("hdfs://localhost:9000/ev_data/*/*.csv");
        Dataset<Row> filtered = df.filter(col("vehicle_id").equalTo(vehicleId))
                .select(col("timestamp"), col("battery_voltage"),
                        col("battery_current"), col("temperature"),
                        col("state_of_charge"));
        List<BatteryProfile> profiles = new ArrayList<>();
        for (Row row : filtered.collectAsList()) {
            BatteryProfile bp = new BatteryProfile();
            bp.setTimestamp(row.getString(0));
            bp.setBatteryVoltage(row.getDouble(1));
            bp.setBatteryCurrent(row.getDouble(2));
            bp.setTemperature(row.getDouble(3));
            bp.setSoc(row.getDouble(4));
            profiles.add(bp);
        }
        spark.stop();
        return Result.success(profiles);
    }
}
五、系统视频
基于大数据的电动汽车故障数据分析与可视化项目视频:
演示视频
结语
最新大数据毕业设计选题推荐-基于大数据的电动汽车故障数据分析与可视化-大数据-Spark-Hadoop-Bigdata
想看其他类型的计算机毕业设计作品也可以和我说~ 谢谢大家!
有技术这一块问题大家可以评论区交流或者私我~
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 10
 0
- 0


 已为社区贡献9条内容

所有评论(0)