深度学习-手写数字识别
一、代码的结构解析
代码逻辑非常清晰,完全按照深度学习的标准流程走:数据加载 -> 定义模型 -> 训练 -> 测试。
1. 1数据集加载与预处理
首先导入代码所用到的相关模块
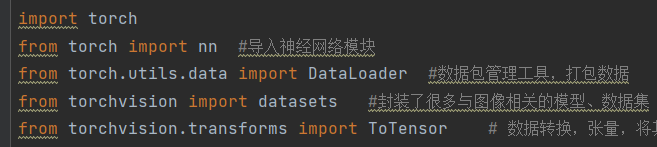
1.2 加载与预处理数据集
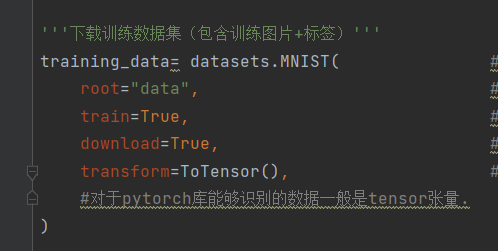
代码root="data"是数据存放路径;train=True是加载训练集;transform=ToTensor()是将图片转换为pytorch能够处理的张量,并进行归一化。
1.3搭建神经网络
这是一种三层全连接神经网络(MLP):
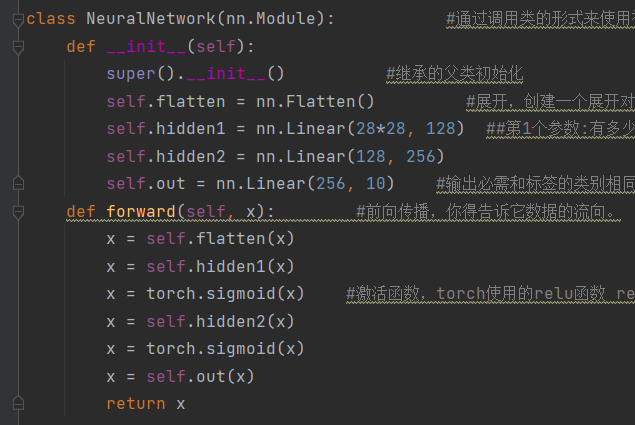
nn.Flatten()(展平层):MNIST 的原始图片是一个二维的 28×28 的像素矩阵。但全连接神经网络不认识二维数组,它只认一维的向量。所以第一件事就是把这 784 个像素点“拉直”,变成一个长度为 784 的一维向量。这就是28*28的由来。
nn.Linear(28*28,128)(第一层全连接层):隐藏层首先输入784维,输出128维,然后再输入128维,输出256维,最后出层输入256维,输出10维。
通过第一个全连接层后,用sigmoid激活函数,引入非线性,通过第二个隐藏层再次用sigmoid函数激活。
1.4训练与优化
损失函数:nn.CrossEntroyLoss()交叉熵损失,非常适合多分类任务。
优化器:torch.optim.SGD随机梯度下降。
训练循环:将数据搬到GPU上(X.to(device)),进行前向传播计算预测值,计算损失,清空梯度,反向传播更新权重。
添加打印语句:每隔 100 个 batch 打印一次当前的 Loss,方便观察训练是否收敛。
二、训练结果
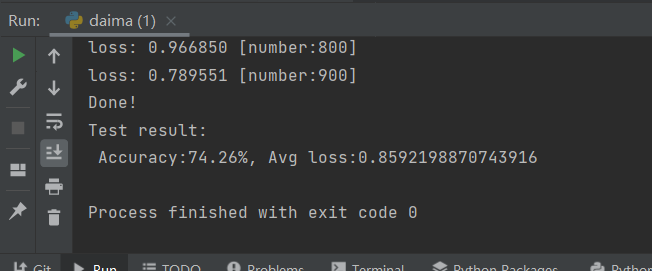
我设置了epochs = 10,使用 SGD 优化器(学习率为 0.01)。虽然只是个极其简单的网络,但在 MNIST 上的表现很稳定:
随着训练轮数增加,Loss值不断下降,最终的测试集准确率具体取决于激活函数和超参数。
三、优化建议
激活函数的选择:代码里用的是torch.sigmoid。在深层网络中sigmoid容易导致梯度消失。如果你想让模型学得更快,强烈建议换成torch.relu(ReLU激活函数),收敛速度会显著提升。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 7
 0
- 0


 已为社区贡献1条内容

所有评论(0)