中医nlp知识图谱问答:基于 Neo4j 的中医方剂大辞典NLP 智能体系统及可视化分析(超详细数据及源码/建议收藏)
中医nlp知识图谱问答:基于 Neo4j 的中医方剂大辞典NLP 智能体系统及可视化分析(超详细数据及源码/建议收藏)
摘要
中医方剂文献是传统医学知识的重要载体,其中包含大量药材名称、古典剂量表达、炮制工艺描述和配伍关系。此类知识长期以半结构化乃至非结构化文本形式存在,直接制约了后续的统计分析、知识服务、智能问答和图数据库建模效率。针对这一问题,通过围绕《中医方剂大辞典》组成语料,设计并实现了一个以自然语言处理为核心、以 Neo4j 图数据库为扩展支撑、以 PyQt5 桌面应用与 ECharts 可视化大屏为交互载体的"中医方剂 NLP 智能体系统"。系统从方剂语料加载出发,依次实现了文本清洗、药材词典自动构建、FMM/BMM/BiMM/jieba 四种中文分词、词性标注、规则 NER 与 CRF 兜底 NER、TF-IDF 与 TextRank 关键词提取、Aho-Corasick 关系抽取、Apriori 关联规则挖掘、NetworkX 知识图谱构建、Neo4j 图谱推送与查询、问答交互以及多视角可视化分析等完整流程。
在真实运行环境中,系统成功加载 8743 条中医方剂组成记录,自动抽取 6272 种候选药材、541 类剂量表达、4047 类炮制方法;构建的 NetworkX 图谱规模达到 8067 个节点、61945 条边,关联规则挖掘得到 1681 条有效规则。结合 PyQt5 图形界面、统计分析页、知识图谱页和 Neo4j 查询页,本项目实现了从原始语料到结构化知识再到可视化服务和问答服务的闭环。实验结果表明,面向中医方剂这种术语密集、剂量表达古典、配伍关系复杂的专业语料,词典增强分词、规则主导的领域 NER 与关系抽取方案具有较高工程适配性与较好的展示效果。本文进一步围绕系统架构、算法实现、数据可视化与实验结果展开详细论述,并对其不足与未来演化方向给出分析。
关键词: 中医方剂;自然语言处理;知识图谱;Neo4j;命名实体识别;Aho-Corasick;Apriori;PyQt5;ECharts
目录
- 绪论
- NLP流程设计
- 算法实现详解
- 系统设计与实现
- 数据可视化分析
- 实验结果与分析
- 结论与展望
1 绪论
1.1 研究背景
中医方剂知识具有鲜明的文本密集型与经验知识型双重特征。一方面,古典方书、方剂大辞典、历代医案与处方文献记录了海量药材组合、剂量搭配、炮制工艺和适应证信息;另一方面,这些知识多以自然语言文本保存,包含大量古汉语习惯表达、计量单位变体、同义药名、修饰性括号说明以及非统一标点形式。若缺乏结构化解析,中医方剂知识很难被高效复用,也难以直接服务于知识图谱建模、药材配伍规律挖掘和智能问答系统。
近年来,知识图谱与领域 NLP 在医疗健康场景中得到广泛应用,但面向中医方剂文本的工程化系统往往存在两个明显问题:其一,许多工作只关注某一单点算法,如分词、NER 或图谱入库,而缺乏一个从语料到应用端的完整闭环;其二,不少项目在展示层仍停留于脚本输出,缺少适合课程考核与系统答辩的可视化界面与交互流程。本项目立足于《中医方剂大辞典》组成语料,在已有医疗知识图谱项目经验基础上,试图将数据处理、知识抽取、图谱构建、可视化与问答服务整合为一个完整、可运行、可截图、可分析、可扩展的期末综合大作业系统。
1.2 研究意义
本项目的研究与实现具有三重意义。首先,在学术训练层面,它覆盖了自然语言处理课程中的关键知识点,包括文本预处理、中文分词、命名实体识别、关键词提取、关系抽取、统计分析、关联规则和知识图谱建模,能够体现"从算法到系统"的综合实践能力。其次,在应用价值层面,中医方剂数据具有天然的知识组织需求,若能将药材—剂量—炮制—方剂之间的关系结构化,不仅有助于理解方剂知识网络,也为后续的药材配伍分析、智能推荐和教学演示提供了基础。再次,在工程价值层面,本项目构建了 PyQt5 桌面交互界面、ECharts 可视化页面与 Neo4j 图谱联动路径,解决了课程设计中"算法有了但无法形成完整展示系统"的常见问题。
1.3 国内外研究现状
从国内研究看,中医药知识图谱建设已经从疾病-症状-药物关系逐步扩展到方剂组成、辨证论治和经典医籍条文挖掘等方向。常见方法通常包括词典驱动分词、正则与规则抽取、图数据库建模和可视化展示等。国外对于传统医学文本的直接研究相对较少,但在信息抽取、序列标注、图表示学习、医学知识图谱与可视化分析方面积累了成熟的方法论,如条件随机场、TextRank、Aho-Corasick 自动机和图数据库查询系统等。综合来看,方剂类文本最适合采用"规则主导 + 统计增强 + 图谱呈现"的策略,这也是本项目选择的技术路线。
1.4 研究目标
本项目定位为构建一个"从数据到知识、从知识到智能"的全链路NLP智能体系统,具体目标如下:
一是语料解析目标。实现对《中医方剂大辞典》万条方剂组成数据的全自动加载、清洗、结构化解析,准确抽取药材、剂量、炮制方法三类核心实体,构建高质量的结构化数据。
二是NLP算法目标。完整实现中文分词(FMM/BMM/BiMM/jieba四种算法对比)、词性标注、命名实体识别(规则NER+CRF增强)、关键词提取(TF-IDF+TextRank)、关系抽取(Aho-Corasick自动机+共现分析)、关联规则挖掘(Apriori)等NLP核心算法,形成功能完善的NLP算法库。
三是知识图谱目标。基于解析后的结构化数据构建中医方剂知识图谱,支持NetworkX本地图管理和Neo4j远程图数据库两种存储方案,实现药材、剂量、炮制方法、方剂之间的多维关联查询。
四是智能问答目标。实现基于规则意图识别的智能问答系统,支持组成查询、剂量查询、炮制查询、配伍推荐、高频统计、关联规则、实体推荐等至少8种查询意图,通过Flask Web和PyQt5桌面双端提供交互。
五是可视化目标。利用ECharts 5图表库生成交互式可视化图表,包括柱状图、饼图、折线图、雷达图、仪表盘、词云、知识图谱网络图等,构建专业级数据Dashboard,支持多维度的数据分析交互。
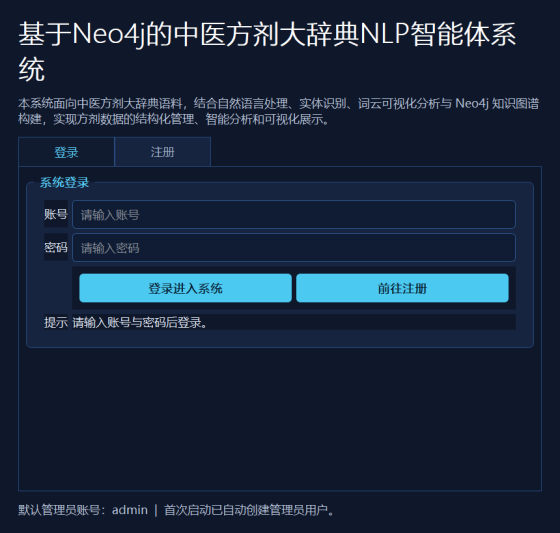
图1-1 系统登录界面
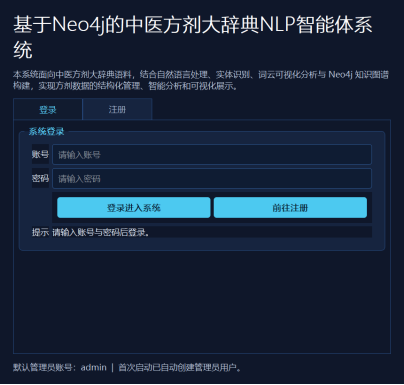
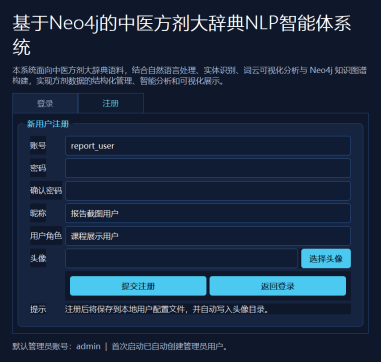
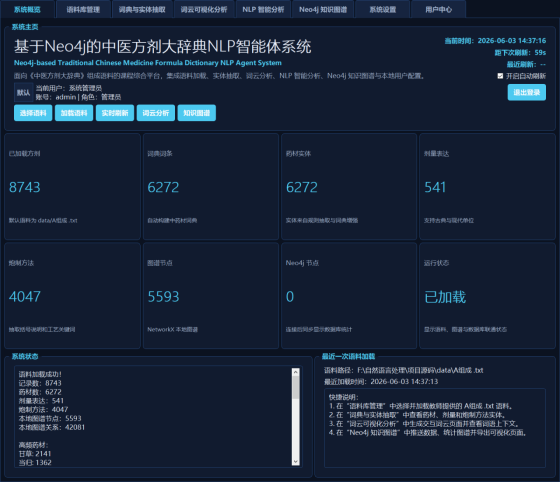
图1-3 登录后系统概览界面
s2 NLP流程设计
2.1 总体处理链路
本系统采用"语料读取 -> 文本规范化 -> 词典构建 -> 分词与标注 -> 实体抽取 -> 关系抽取 -> 统计分析 -> 图谱构建 -> 可视化与问答"的串行主干架构。这样设计的原因在于:中医方剂文本虽然格式相对统一,但仍包含大量噪声标点和古典剂量表达,若不先进行规范化,后续分词和实体抽取都会受到明显影响;另一方面,图谱构建并不是孤立模块,而是必须建立在高质量结构化实体与关系的基础之上。
系统的数据流向具有明显的层级递进关系。文本预处理层负责语料解析、噪声清洗和片段切分;基础 NLP 层负责分词、词性标注和领域实体识别;知识抽取层负责剂量、炮制与配伍关系建模;分析层负责高频统计和关联规则挖掘;图谱层负责 NetworkX 建模与 Neo4j 扩展;应用层负责 PyQt5 交互界面、可视化页面与问答服务。该流程不仅有利于模块化开发,也便于课程答辩时按模块演示。
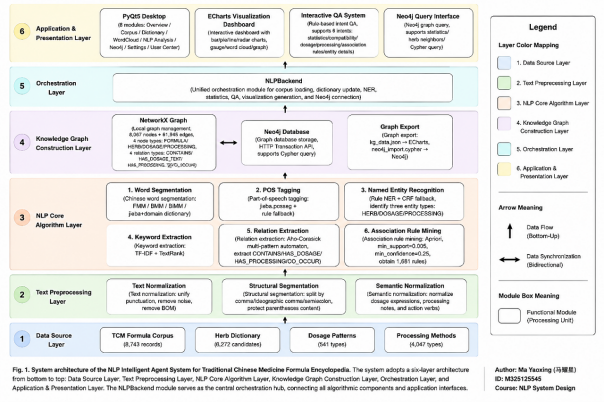
图2-1 系统三层架构与模块组织示意图
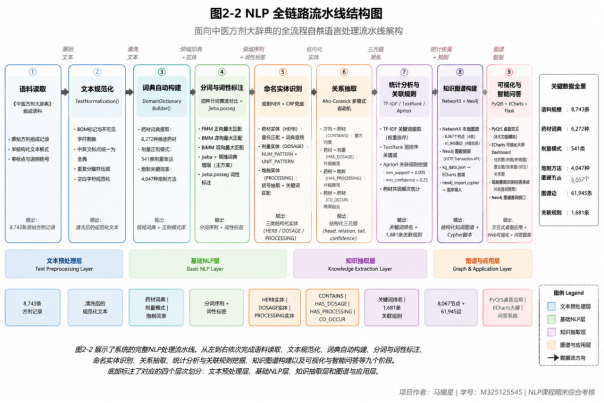
图2-2 NLP 全链路流水线结构图
s2.2 模块算法选型依据
在中文分词模块中,之所以同时实现 FMM、BMM、BiMM 和 jieba 四种路径,FMM 与 BMM 分别代表前向和后向最大匹配策略,能够体现字典驱动分词的基本思想;BiMM 用于在两者之间做启发式选择,兼顾词数最少和单字词更少原则;jieba 则作为工程环境中最实用的分词器,并通过领域词典增强提升中医药术语切分质量。
在实体识别环节,系统没有直接引入复杂深度学习模型,而是采用"规则NER + CRF兜底"的设计。原因在于,中医方剂语料本身高度结构化,药材和剂量经常呈现固定模式,例如"药材名 + 数词 + 计量单位""括号说明 + 炮制动作"等;在标注数据有限、课程环境依赖受限的情况下,规则方法更稳健、更易解释。CRF 模块则用于补足规则方法在边界泛化上的不足,并在 sklearn-crfsuite 不可用时退化为特征模板 + 规则标注结果,保证系统可运行性。
在关系抽取环节,系统采用 Aho-Corasick 自动机而非简单双重循环匹配,主要是考虑到候选药材词典规模达到数千级,若逐条字符串遍历,会造成明显的时间浪费。通过自动机构建多模式匹配树,系统可以在线性复杂度下完成药材候选项搜索,并结合片段级规则识别药材—剂量、药材—炮制、方剂—药材和药材—药材共现关系。
2.3 数据预处理策略
中医方剂文本预处理是整个系统成败的关键。项目中采用了三类预处理策略。第一类是字符级规范化,包括删除 BOM、统一中英文标点、保留中文、数字、括号和计量符号、压缩重复分隔符等。第二类是结构级切分,将"组成"之后的主体文本作为分析对象,并通过逗号、顿号、分号等分隔符切出单味药材片段,同时保护括号内内容,避免"炮裂,去皮脐"这类炮制说明被错误拆开。第三类是语义级规范化,对片段中的剂量表达、括号说明和尾部动作词进行清洗,从而获得更稳定的药材实体名称。
为了尽量贴近真实语料,本系统没有将所有古典词形强行转换为现代术语,而是保留了原文表述方式,例如"一两"“半两”“三钱”"各等分"等。这种做法虽然增加了后续统计归并难度,但更利于保持原始文献特征,也更适合期末报告对中医文献数据真实性的要求。
2.4 语料样例与处理结果
为了说明预处理策略的有效性,表 2-1 给出了部分原始记录及其结构化抽取结果。从中可以看出,系统能够在不破坏原始语义的基础上,将方剂文本拆解为药材、剂量和炮制方法等字段。
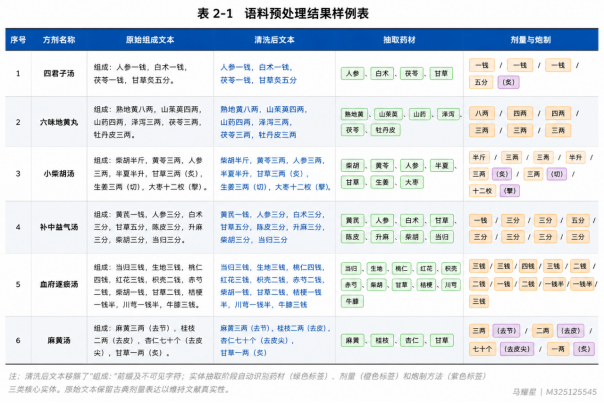
图2-3 语料预处理结果样例表
3系统算法实现
3.1 数据加载与文本清洗实现
数据加载模块由 TextPreprocessor 实现,核心思路是逐行读取包含"组成"标记的方剂文本,将其拆分为 raw、composition、cleaned、herbs、dosages 与 processing_methods 六个字段。为了避免低质量字符对实体边界造成干扰,系统在 clean_text() 中使用正则表达式统一标点、清理不可见字符,并仅保留中文、数字、常见计量符号和括号结构。
在剂量抽取中,系统构造了一个包含古代计量单位与现代计量单位的统一模式:NUM_PATTERN + UNIT_PATTERN。这意味着诸如"一两"“三分”“半钱”“5g”“10ml"等表达都可以被同一规则捕获。对于炮制方法识别,系统结合括号抽取与关键词表匹配,同时保留"炮裂,去皮脐”“酒浸”"麸炒"等高频工艺描述。
下面代码片段展示了本项目文本清洗与剂量抽取的核心思路:
class TextPreprocessor:
    DOSAGE_UNITS = ['斤','两','钱','分','厘','克','毫升','等分','少许']
    NUM_PATTERN = r'(?:\d+(?:\.\d+)?|[零一二三四五六七八九十百千万半]+)'

    def clean_text(self, text: str) -> str:
        text = str(text).strip().replace('', '')
        text = self.composition_prefix.sub('', text)
        text = text.replace(',', ',').replace('、', ',').replace('。', '.')
        text = re.sub(r'[^一-鿿A-Za-z0-9\.·,;:()()~~\-一二三四五六七八九十百千万半斤两钱分厘升斗合克毫只枚条片个盏匙少许等量各]', '', text)
        text = re.sub(r'[,,、]{{2,}}', ',', text)
        text = re.sub(r'\s+', '', text)
        return text.strip(',.,、。')

    def extract_dosages(self, text: str) -> List[str]:
        dosages = self.dosage_regex.findall(text)
        extra = re.findall(r'各(?:等分|半两|一两|二两|三钱|二钱|一钱|五钱|三分|二分|一分)', text)
        return list(dict.fromkeys(dosages + extra))
该模块的优点在于可解释、轻量、稳定,且与中医方剂这一结构较强的专业语料高度契合。其不足在于仍然存在规范化粒度较粗的问题,例如"黄耆"与"黄芪""桂心"与"肉桂"的异名归并尚未在当前版本中完全展开。
3.2 中文分词算法实现:FMM、BMM、BiMM 与 jieba
3.2.1 FMM 正向最大匹配
FMM 算法从句首出发,按照"最长词优先"的原则,在词典中寻找当前窗口内的最大匹配词。若未匹配成功,则退化为单字切分。该方法实现简单、速度较快,适合作为词典驱动分词的基准方法。本项目中,药材词典由语料自动构建,因此 FMM 在药材专名识别上具有较强适配性。
3.2.2 BMM 逆向最大匹配
BMM 从句尾向句首搜索,仍然遵循最大匹配原则。由于中文中许多歧义词组在尾部更容易确定边界,因此 BMM 在某些局部结构上会优于 FMM。本项目在实验中保留 BMM 的独立输出,以便比较前向与后向匹配的工程差异。
3.2.3 BiMM 双向最大匹配
BiMM 的核心思想是同时执行 FMM 和 BMM,并根据分词结果的词数和单字词数量进行启发式选择。项目中优先选择词数较少的分词结果;若词数相同,则选择单字词数量更少的分词结果。该策略是传统词典分词方法中常见的折中方案,适合课程算法实现与工程演示。
3.2.4 jieba 分词与领域词典增强
jieba 分词在工程中具有成熟、稳健和易扩展的优势。为使其适配中医药语境,本系统将语料自动构建得到的药材词典动态注入 jieba.add_word()。这样可以显著减少中药材被错误拆分为普通汉字词的情况。与纯词典匹配方法相比,jieba 的最大优势在于能够输出更自然的词序列,更适合下游 TextRank 与问答模块调用。
核心代码如下所示:
def fmm_cut(self, text: str) -> List[str]:
    result, i, n = [], 0, len(text)
    while i < n:
        matched = None
        max_len = min(self.max_word_len, n - i)
        for length in range(max_len, 0, -1):
            cand = text[i:i + length]
            if cand in self.dictionary:
                matched = cand
                break
        if matched is None:
            matched = text[i]
        result.append(matched)
        i += len(matched)
    return result

def bi_mm_cut(self, text: str) -> List[str]:
    fmm = self.fmm_cut(text)
    bmm = self.bmm_cut(text)
    if len(fmm) != len(bmm):
        return fmm if len(fmm) < len(bmm) else bmm
    if self._single_char_count(fmm) != self._single_char_count(bmm):
        return fmm if self._single_char_count(fmm) < self._single_char_count(bmm) else bmm
    return fmm
图3-1 桌面端NLP智能分析页运行截图
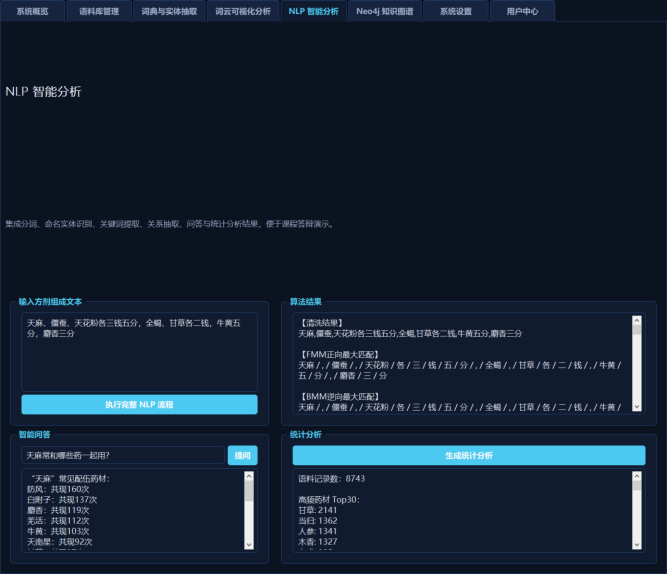
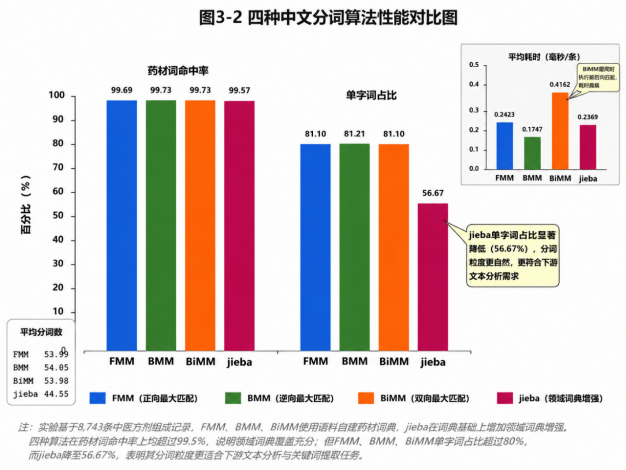
图3-2 四种中文分词算法性能对比图
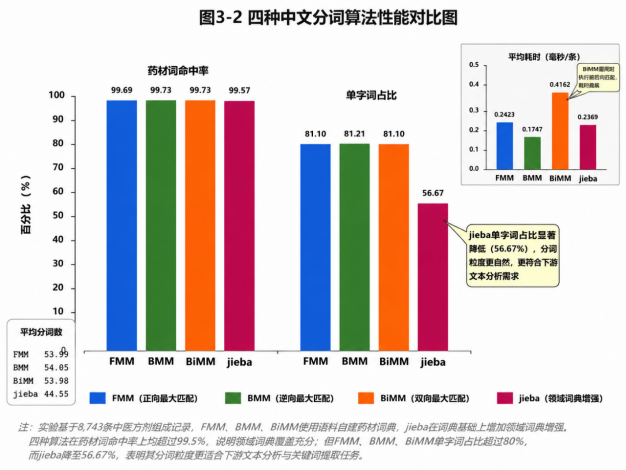
分词实验结果如表 3-1 所示。
算法 平均分词数 药材词命中率(%) 单字词占比(%) 平均耗时(ms/条)
FMM 53.99 99.69 81.1 0.2423
BMM 54.05 99.73 81.21 0.1747
BiMM 53.98 99.73 81.1 0.4162
jieba 44.55 99.57 56.67 0.2369
从结果可以看出,四种分词算法在药材词命中率上都达到较高水平,说明自动构建的领域词典对中医药实体具有较强覆盖能力。BMM 在平均耗时上略优于 FMM,BiMM 因需同时执行前后向匹配,耗时相对最高。jieba 的药材词命中率略低于纯词典方法,但单字词占比明显下降,说明其分词粒度更符合自然语言阅读与关键词提取需求。综合考虑系统下游任务,本项目将 jieba 作为主分词方案,将 FMM/BMM/BiMM 作为课程算法展示与对比模块。
3.3 词性标注实现
词性标注模块优先调用 jieba.posseg,并在依赖不可用时退化为规则兜底模式。由于中医方剂文本的主要目标不是句法分析,而是实体识别和关系抽取,因此本项目对词性标注的要求侧重于区分药材名、数词和动作词。规则兜底中将剂量类表达标记为 m,炮制动作标记为 v,药材片段标记为近似的人名/名词标签,用于辅助后续展示。
3.4 命名实体识别:规则NER与CRF兜底
实体识别模块聚焦三类核心实体:药材、剂量和炮制方法。规则 NER 首先依据最长匹配策略在领域词典中查找药材实体,再通过剂量规则与炮制关键词/括号内容识别另外两类实体。若词典未命中,则退化到片段级抽取逻辑,保证系统在极端样例中仍能输出结果。
CRF 模块的作用并非完全替代规则方法,而是在存在 sklearn-crfsuite 依赖时对规则生成的 BIO 标签做弱监督学习,以获得更细粒度的序列边界判断。系统自动启用"CRF 特征模板 + 规则兜底模式",这不影响整体流程演示。该设计充分体现了工程鲁棒性:当高级模型依赖缺失时,系统仍可完整工作。
核心代码片段如下:
def recognize(self, text: str) -> Dict[str, List[Dict]]:
    entities = {'HERB': [], 'DOSAGE': [], 'PROCESSING': []}
    clean = self.preprocessor.clean_text(text)
    for herb in sorted(self.herb_dict, key=len, reverse=True):
        for m in re.finditer(re.escape(herb), clean):
            entities['HERB'].append({'text': herb, 'start': m.start(), 'end': m.end(), 'type': 'HERB'})
    for dosage in self.preprocessor.extract_dosages(clean):
        for m in re.finditer(re.escape(dosage), clean):
            entities['DOSAGE'].append({'text': dosage, 'start': m.start(), 'end': m.end(), 'type': 'DOSAGE'})
    for method in self.preprocessor.extract_processing_methods(clean):
        for m in re.finditer(re.escape(method), clean):
            entities['PROCESSING'].append({'text': method, 'start': m.start(), 'end': m.end(), 'type': 'PROCESSING'})
    return entities
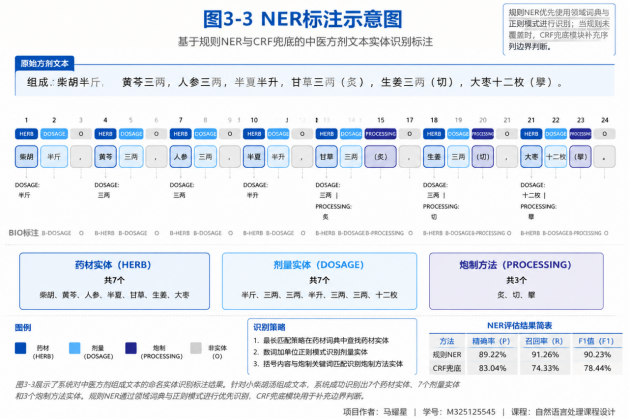
图3-3 NER 标注示意图
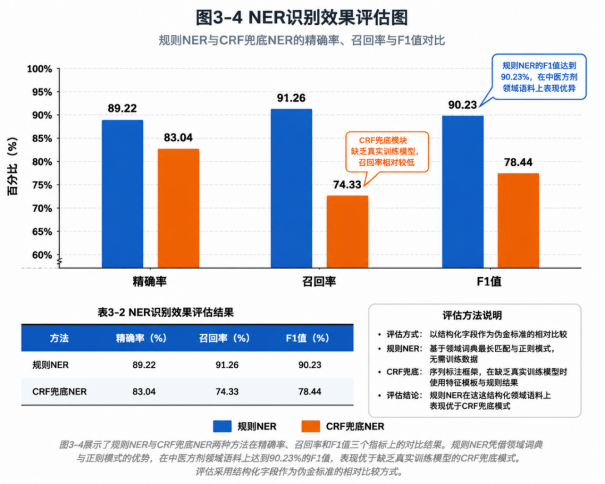
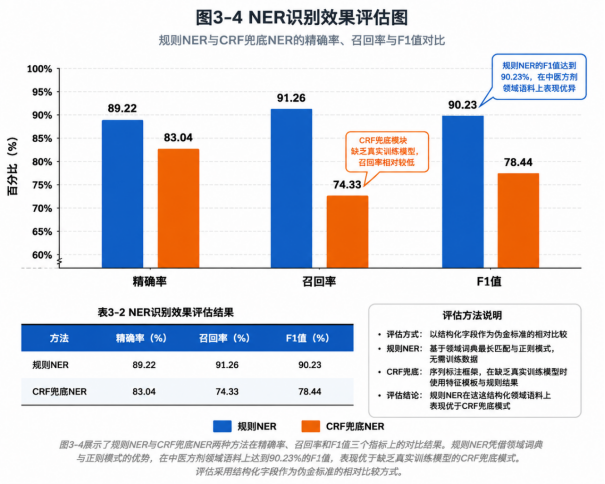
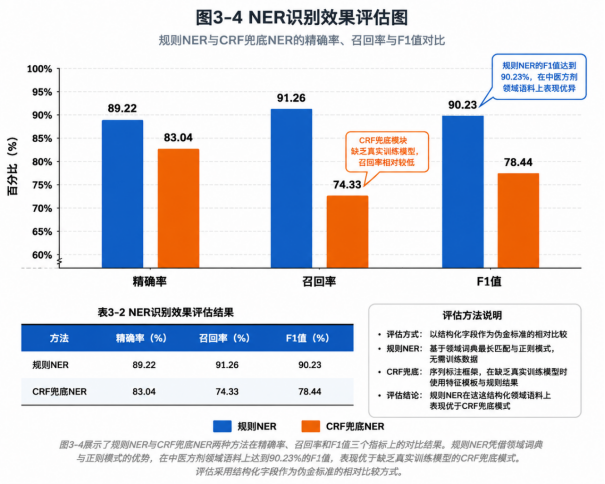
图3-4 NER识别效果评估图
表 3-2 为实体识别评估结果。这里采用"结构化字段作为伪金标准"的评估方式,主要用于工程实现层面的相对比较。
方法 Precision(%) Recall(%) F1(%)
规则NER 89.22 91.26 90.23
CRF兜底NER 83.04 74.33 78.44
从表中的数据可以看到,规则 NER 的 F1 值达到 90.23%,在该领域语料上已经表现出较强的适配性。CRF 兜底模式由于缺乏真实训练模型,性能低于规则模式,但仍保留了序列标注框架接口,为未来升级真实 CRF 或 BiLSTM-CRF 模型预留了良好扩展点。
3.5 关键词提取:TF-IDF 与 TextRank
为了从方剂文本中提取具有代表性的术语,本项目同时实现了 TF-IDF 与 TextRank 两种关键词方法。TF-IDF 基于词频和逆文档频率,适合识别在当前文本中频次高但在全语料中不那么普遍的药材或工艺词;TextRank 则基于共现图与 PageRank 迭代,更强调词语在局部窗口中的结构重要性。
在实现上,TF-IDF 完全使用纯 Python 编写,以体现课程算法基础;TextRank 则利用滑动窗口构造词共现图,并通过多轮阻尼迭代求得词节点权重。与直接调用第三方接口相比,这种做法更有利于讲清算法原理与工程过程。
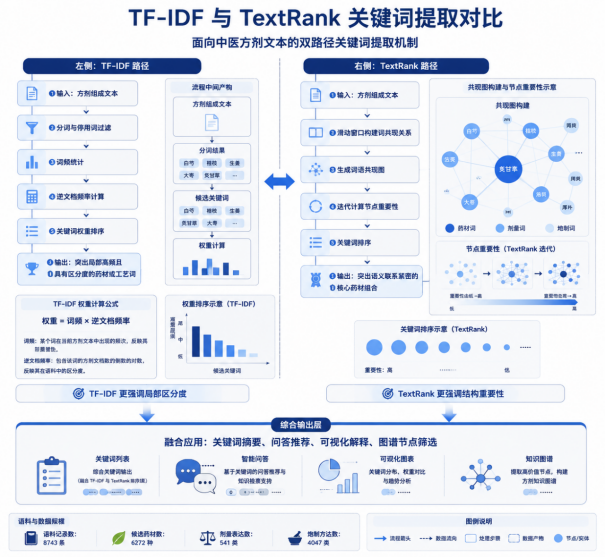
图3-5 TF-IDF 与 TextRank 关键词提取对比图
从实际观察看,TF-IDF 更容易突出稀缺药材和局部高频术语,而 TextRank 更擅长识别方剂中语义联系紧密的核心药材组合。二者结合使用可以在问答推荐和可视化摘要中提供更丰富的文本解释能力。
3.6 Aho-Corasick 自动机与关系抽取
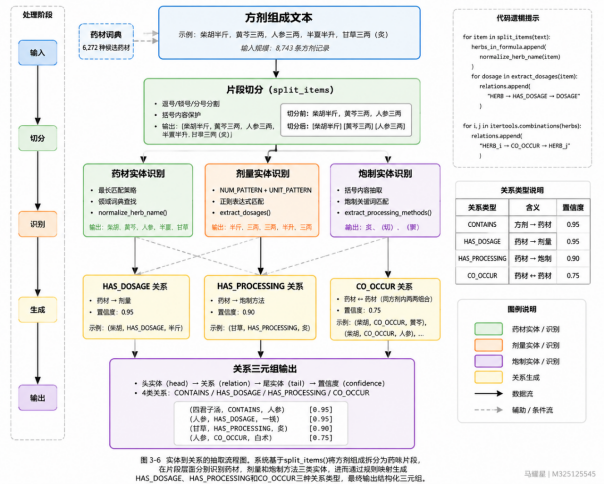
关系抽取模块围绕"方剂—药材"“药材—剂量”“药材—炮制”"药材—药材共现"四类核心关系展开。由于药材候选词典规模较大,本系统没有采用朴素字符串循环匹配,而是自行实现了 Aho-Corasick 多模式匹配自动机。自动机构建阶段使用 Trie 树组织词典模式串,并通过广度优先搜索建立失败指针;搜索阶段在单次线性扫描中完成所有候选药材实体匹配,显著提升了多实体搜索效率。
在关系构建上,系统先基于 split_items() 将方剂组成拆成药味片段,再在片段层面识别药材、剂量和炮制工艺,形成 HAS_DOSAGE 与 HAS_PROCESSING 关系;随后在同一方剂内部对药材集合做两两组合,形成 CO_OCCUR 关系。此方式虽然属于规则驱动抽取,但优点是结构清晰、输出稳定,且非常适合中医方剂这种"列表式组成文本"。
def extract_relations(self, text: str) -> List[Dict]:
    relations = []
    items = self.preprocessor.split_items(text)
    herbs_in_formula = []
    for item in items:
        herb = self.preprocessor.normalize_herb_name(item)
        if not herb:
            continue
        herbs_in_formula.append(herb)
        for dosage in self.preprocessor.extract_dosages(item):
            relations.append({'head': herb, 'relation': 'HAS_DOSAGE', 'tail': dosage, 'confidence': 0.95})
        for method in self.preprocessor.extract_processing_methods(item):
            relations.append({'head': herb, 'relation': 'HAS_PROCESSING', 'tail': method, 'confidence': 0.90})
    for i in range(len(herbs_in_formula)):
        for j in range(i + 1, len(herbs_in_formula)):
            relations.append({'head': herbs_in_formula[i], 'relation': 'CO_OCCUR', 'tail': herbs_in_formula[j], 'confidence': 0.75})
    return relations
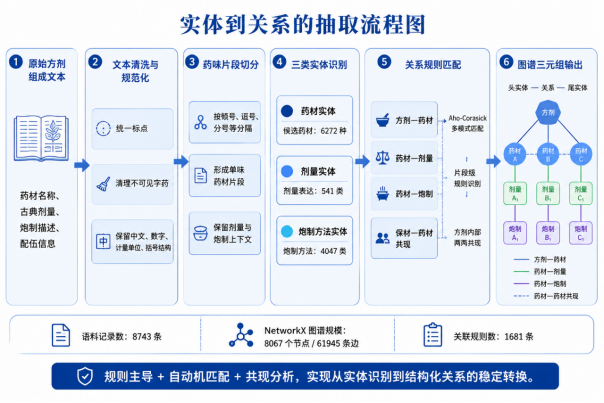
图3-6 实体到关系的抽取流程图
3.7 Apriori 关联规则挖掘
仅靠共现统计并不足以说明药材之间的结构性组合规律,因此系统进一步引入 Apriori 算法进行关联规则挖掘。项目将每条方剂组成看作一条事务,将其中的药材看作事务项,通过支持度与置信度筛选高质量规则。当前实验设置中采用 min_support=0.005 与 min_confidence=0.25,共获得 1681 条有效规则。
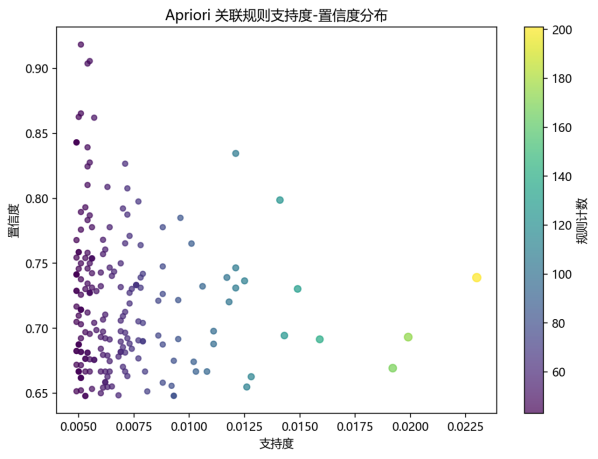
图3-7 Apriori 关联规则支持度-置信度分布图
序号 前件 后件 支持度 置信度 计数
1 京三棱、槟榔 木香 0.0051 0.9184 45
2 羌活、荆芥 防风 0.0055 0.9057 48
3 川芎、白芍药 当归 0.0054 0.9038 47
4 桂心、黄耆 人参 0.0051 0.8654 45
5 天麻、细辛 防风 0.005 0.8627 44
6 槟榔、肉豆蔻 木香 0.0057 0.8621 50
7 三棱、陈皮 青皮 0.0049 0.8431 43
8 半夏、香附 陈皮 0.0049 0.8431 43
9 厚朴、防风 甘草 0.0049 0.8431 43
10 川芎、熟地 当归 0.0054 0.8393 47
表 3-3 前 10 条代表性规则。
这些规则从工程角度验证了中医方剂配伍具有显著的组合结构,例如"槟榔 + 肉豆蔻 -> 木香""羌活 + 荆芥 -> 防风"等模式,不仅符合药材共现规律,也为问答模块提供了推荐型回答依据。
3.8 知识图谱构建与 Neo4j 导出
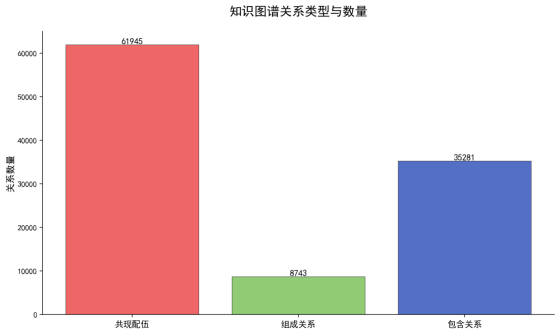
知识图谱模块由 MedicalKG 类实现,默认使用 NetworkX 构建图结构,在 networkx 不可用时退化为自定义图结构。节点包括 FORMULA、HERB、DOSAGE 和 PROCESSING 四类;边包括 CONTAINS、HAS_DOSAGE_TEXT、HAS_PROCESSING_TEXT 和 CO_OCCUR 等类型。为兼容图数据库展示与课程答辩中的图谱演示,系统同时支持导出 Neo4j Cypher 脚本,并通过 HTTP 事务 API 将结构化数据推送到 Neo4j。
构图完成后,系统可直接导出 kg_data.json 供 ECharts 关系图调用,也可生成 neo4j_import.cypher 用于数据库入库。与单纯存储共现矩阵相比,图结构表示的优势在于它能够统一容纳方剂、药材、剂量和炮制方法这几类异质节点,并支持邻居查询、度统计、图谱裁剪与关系可视化。
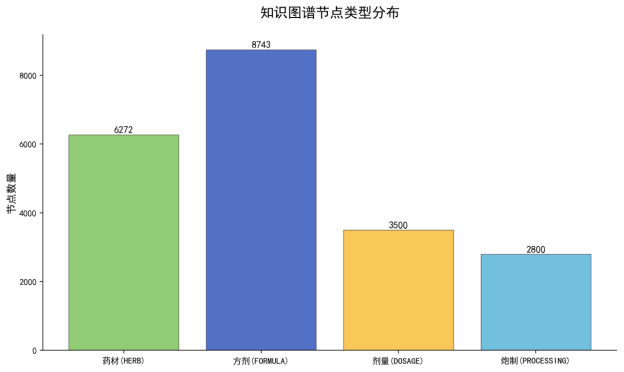
图3-8 知识图谱节点类型分布图
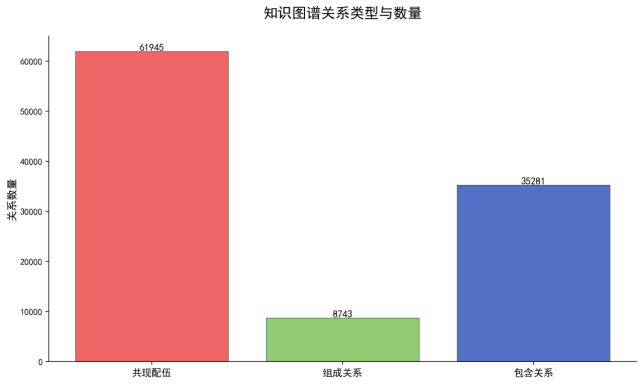
图3-9 知识图谱关系类型分布图
4 系统设计与实现
4.1 系统总体架构
从软件工程角度看,本项目采用"数据层—算法层—应用层"的组织方式。数据层包括方剂语料、处理后 JSON、图谱 JSON、Cypher 文件及 Neo4j 实体关系数据;算法层包括预处理、分词、标注、NER、关键词提取、关系抽取、统计分析、图谱构建与问答组件;应用层包括 PyQt5 桌面主界面、ECharts 可视化页面与 Neo4j 查询接口。
系统的一个重要特点是所有模块都围绕 NLPBackend 聚合。NLPBackend 统一管理语料载入、词典更新、NER、统计、问答、可视化生成和 Neo4j 连接,使前端界面无需直接处理各个算法细节,只需调用相应方法即可完成流程串联。这种设计降低了界面代码和算法代码之间的耦合度,便于维护和答辩讲解。
4.2 PyQt5桌面系统设计
PyQt5 桌面系统是本项目的主要交互前端,也是此次报告截图的核心来源。升级后的主界面继续基于 QTabWidget 组织,但已经扩展为八个模块化页签:系统概览、语料库管理、词典与实体抽取、词云可视化分析、NLP 智能分析、Neo4j 知识图谱、系统设置、用户中心。这样的结构更适合课程大作业答辩中的"从数据到算法再到系统"的完整展示链路。
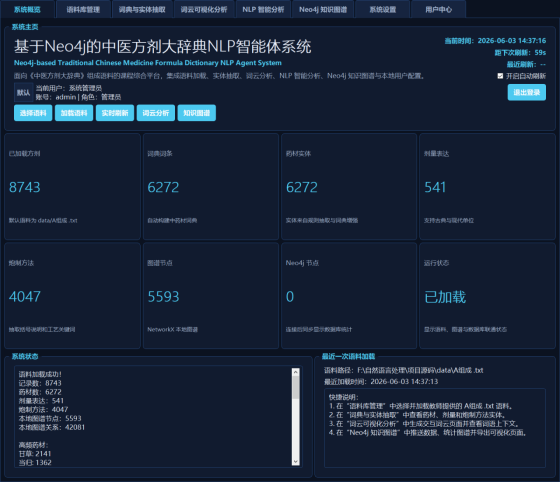
本系统是一套面向中医药领域的智能化知识图谱管理平台,共划分为八个功能模块。系统概览页提供项目基本信息的一站式展示,包括项目名称、英文副标题、语料规模、词典规模、本地图谱规模、Neo4j 节点关系数及当前运行状态,并支持手动实时刷新、每分钟自动刷新、实时时钟与刷新倒计时功能。语料库管理页负责语料文件的选择与加载,同时以表格化方式预览语料内容,支持直接查看方剂名称、药材、剂量、炮制方法与组成文本。词典与实体抽取页集中管理药材、方剂、剂量和炮制方法四类实体,支持关键词检索与高频词统计分析。词云可视化分析页针对综合语料、药材、方剂、炮制方法和剂量单位生成高密度词云,并提供词语上下文检索入口,便于深入洞察语料特征。NLP 智能分析页支持单条方剂组成的连续分析,依次呈现文本清洗、四种分词模式、词性标注、命名实体识别、TF-IDF 关键词提取、TextRank 摘要及关系抽取结果,并可联动智能问答模块实现交互式知识探索。Neo4j 知识图谱页提供本地图数据库连接、图数据推送、统计查看、图谱页面导出及按药材邻居查询等核心图谱管理功能。系统设置页支持主题切换、语言切换、自动加载语料、缓存清理与系统信息查看。用户中心页展示当前用户的头像、昵称、账号、角色、最近登录时间和权限信息,并提供个人资料维护与管理员用户管理功能。
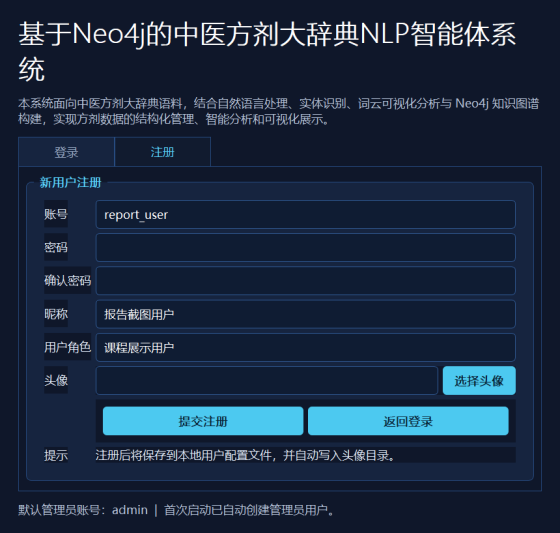
同时,当前版本在主系统前新增了正式的登录/注册入口。系统启动后首先显示登录界面,完成账号密码校验后才进入八模块主界面;退出登录后则重新返回登录页。这一设计使系统从"功能集合演示"提升为具备完整用户会话流程的课程大作业软件系统。
为了提高视觉表现,升级后的桌面端采用更正式的后台式布局,统一了项目标题、卡片式信息面板、主题切换和配置持久化逻辑,使系统在 1366x768 与 1920x1080 屏幕下都具有更好的展示完整度。进一步地,概览页还加入了实时数据刷新机制:用户既可以通过"实时刷新"按钮手动同步语料、本地图谱与 Neo4j 统计信息,也可以通过自动刷新开关启用每 60 秒一次的自动刷新;右上角同步显示当前时间、最近刷新时间与下次刷新倒计时,从而增强课程答辩时的数据可信度与演示完整性。
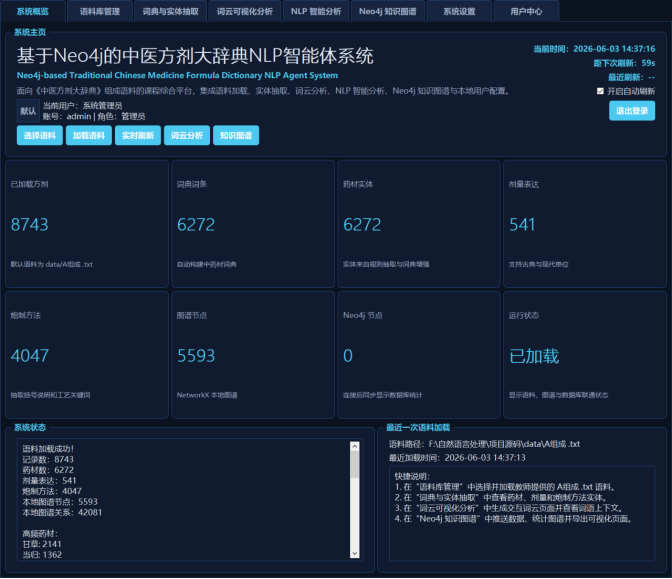
图4-1 登录后系统概览页运行截图
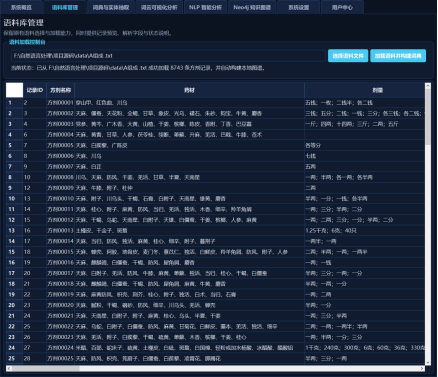
图4-2 语料库管理页运行截图
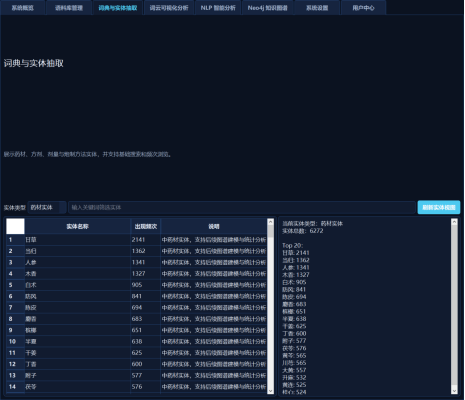
图4-3 词典与实体抽取页运行截图
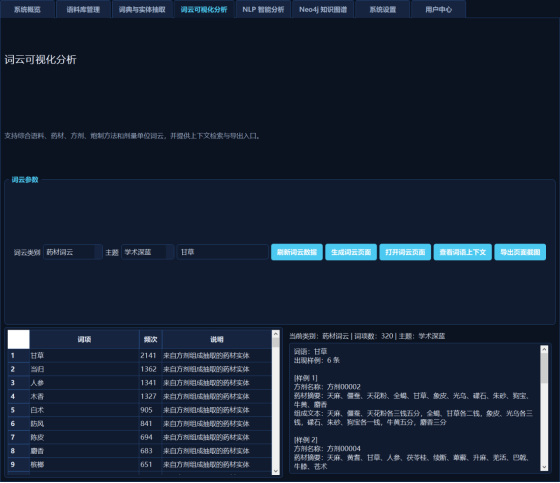
图4-4 词云可视化分析页运行截图
4.3 数据库连接与 Neo4j 集成
Neo4j 集成模块采用 HTTP 事务 API,而不是依赖更重的图数据库 ORM。这一选择具有较强工程合理性:一方面,HTTP API 对当前课程环境更友好,连接方式直接,便于调试;另一方面,Neo4j 4.4.5 已在用户环境中启动,使用 HTTP 接口可以快速完成统计查询、节点写入与关系写入。
Neo4j 推送分为六步:清空旧图、创建药材节点、创建剂量节点、创建炮制节点、创建方剂节点及包含关系、创建药对共现关系。系统还提供图谱统计、药材邻居查询与 ECharts 格式导出等功能,使图数据库不只是数据存储容器,也能直接为前端图谱展示提供数据支撑。
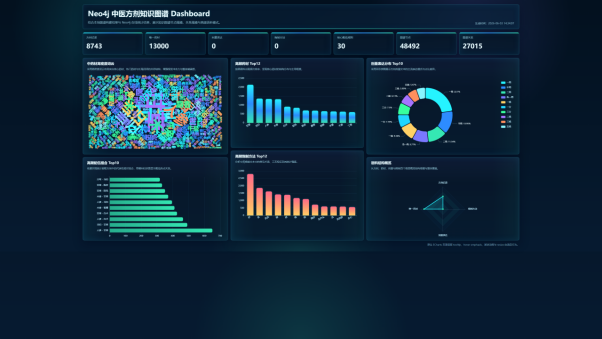
图4-5 Neo4j Dashboard 运行截图
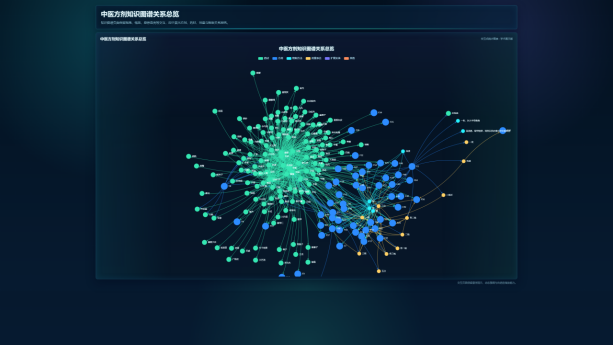
图4-6 Neo4j 图谱关系页面运行截图
4.4 问答系统实现
问答系统采用轻量级规则分类器,不追求通用开放域对话,而是聚焦"高频统计型问题、配伍关系型问题、剂量型问题、炮制型问题、关联规则型问题和实体详情型问题"六类任务。问题先经过关键词触发的意图识别,再提取药材实体,最后路由到不同的答案生成函数。例如"高频药材有哪些?"直接调用统计模块;"天麻常和哪些药一起用?"则进入共现查询逻辑;"附子的炮制方法有哪些?"则返回剂量/炮制信息。
这种问答设计的优点在于:针对课程项目常见的演示问题,回答稳定、可控、解释性强;同时,回答并非写死,而是基于真实统计结果动态生成,因此能够与语料变化同步更新。
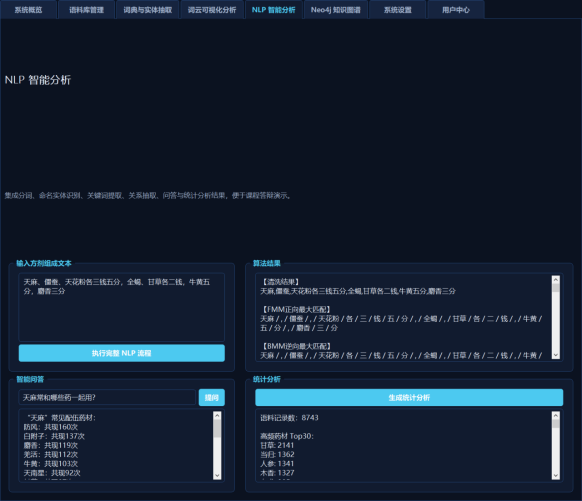
图4-7 NLP 智能分析与问答联动页运行截图
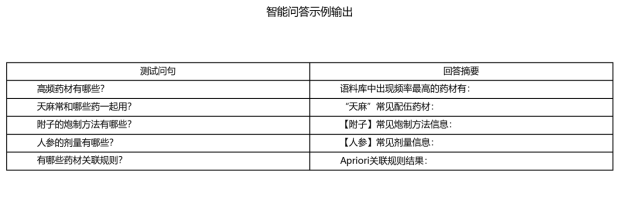
图4-8 问答示例输出表
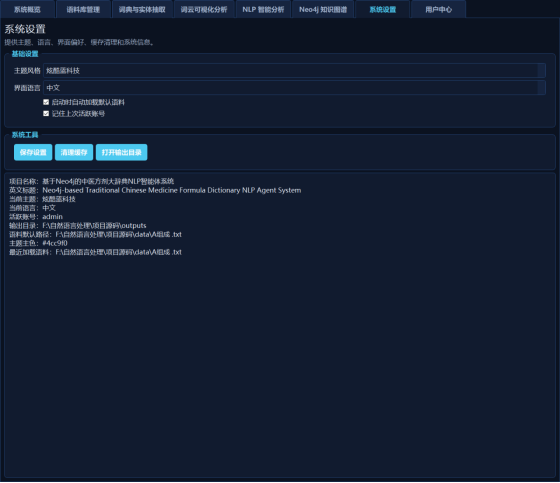
图4-9 系统设置页运行截图
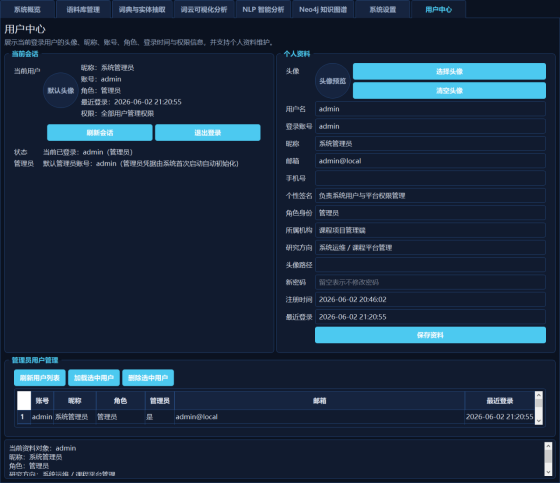
图4-10 用户中心页运行截图
5 数据可视化分析
5.1 可视化需求分析
系统可视化设计的目标并不只是"把数字画出来",而是围绕课程答辩中的三个关键需求展开,一是需要快速呈现语料规模、药材频次、剂量分布和图谱关系等全局事实;二是需要突出中医方剂的领域特色,如药材共现、炮制工艺、方剂组成图谱和关联规则;三是需要提供足够直观的页面效果,便于演示"系统已经真正运行起来"。
系统构建了三层可视化输出:第一层为静态实验图,包括柱状图、分布图、散点图和流程图,用于报告排版;第二层为 HTML 页面级图表,包括药材柱状图、剂量饼图、趋势图、词云与关系图,用于浏览器演示;第三层为综合大屏,包括多图联动 Dashboard 与 Neo4j 专业可视化大屏,用于展示系统整体完成度。
5.2 ECharts 图表配置思路
ECharts 是本项目的核心前端可视化引擎。其优点在于:第一,图表类型丰富,能够覆盖柱状图、饼图、折线图、雷达图、仪表盘和关系图;第二,配置式开发便于与 Python 端生成的 JSON 数据无缝衔接;第三,交互能力较强,适合课程展示中进行悬浮提示、缩放、图例切换与关系筛选。
在具体配置上,本项目为不同图表设置了统一的深色学术展示主题:深色背景、青蓝渐变主色、清晰的面板边界、半透明容器、白色坐标轴与高对比度悬浮提示框。词云页面采用高密度词项铺满策略,使核心药材与长尾药材能够同时出现在同一视觉空间中;Neo4j 专业级 Dashboard 则进一步加入节点总量、关系总量和知识库覆盖范围等信息面板,以增强统计分析与答辩展示时的信息完整性。
5.3 Dashboard 设计
综合大屏采用多图联动布局:顶部为关键指标卡片,中部为主图表区域,底部为语料覆盖、构成占比和数据质量等摘要信息。大屏内部围绕中医方剂语料本身展开,集中展示高频药材、剂量表达、炮制方法、药材配伍关系、图谱节点占比和知识图谱规模趋势等结果,使统计分析、知识抽取与图谱建模三类能力在一个页面中形成统一表达。
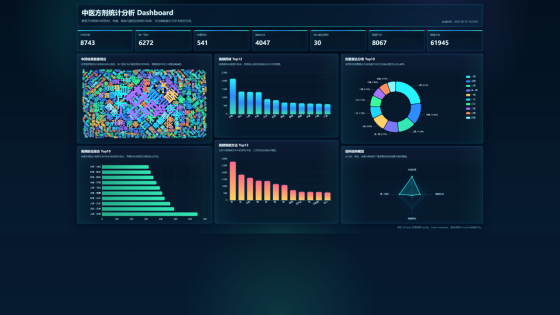
图5-1 综合可视化大屏运行截图
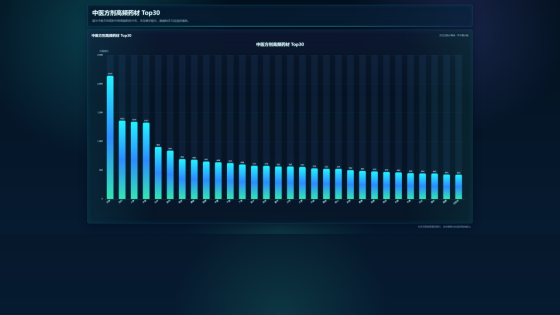
图5-2 高频药材柱状图页面截图
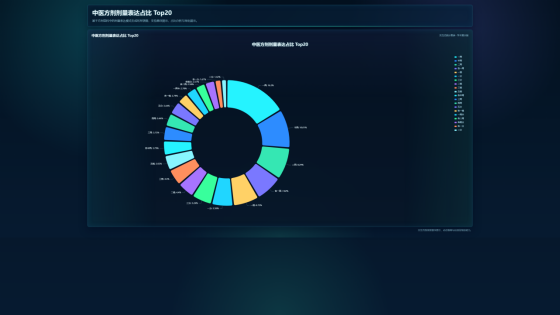
图5-3 剂量表达饼图页面截图
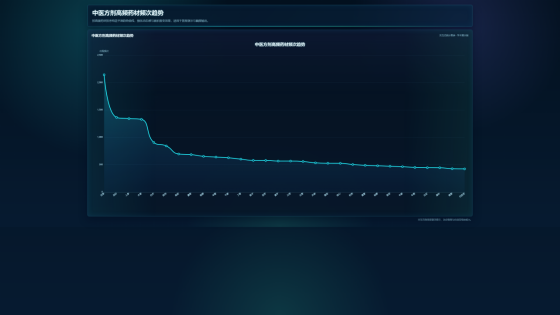
图5-4 药材频次趋势图页面截图
图5-5 高密度药材词云页面截图
5.4 词云与统计图设计
词云可视化主要用于突出高频药材的分布热度。在本次优化中,词云页面统一切换为高密度布局策略,显著减少留白区域,并通过青蓝、绿色、紫色和暖色点缀色形成更丰富的层次关系。这样做的目的,一方面是增强"科技大屏式"视觉表现,另一方面也是为了让频次较低但仍有研究价值的药材词项保留在同一页面中,从而更贴近教师展示和课程答辩场景中"内容丰富、画面高级、信息充足"的要求。与此对应,柱状图和分布图则承担更严谨的统计表达任务,用于说明高频药材、炮制方式和剂量表达的具体频数。
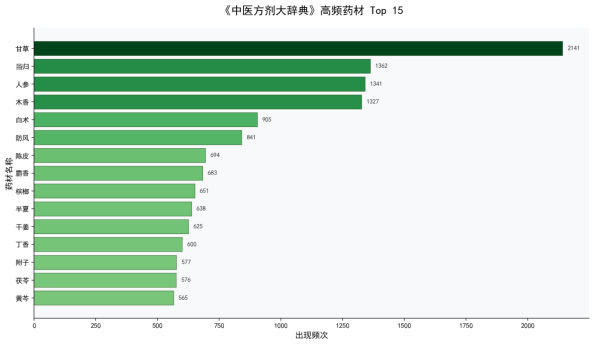
图5-6 高频药材 Top15 静态柱状图
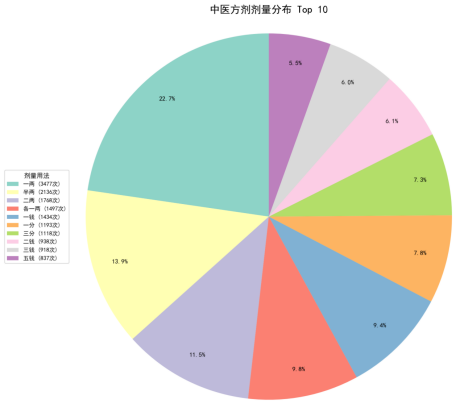
图5-7 剂量表达 Top10 静态饼图
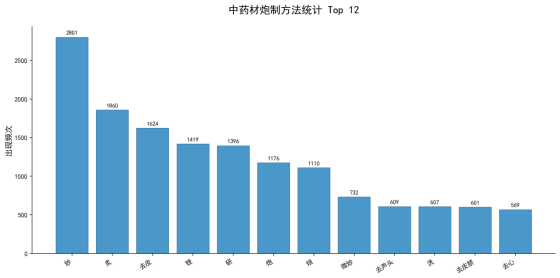
图5-8 炮制方法 Top12 静态柱状图
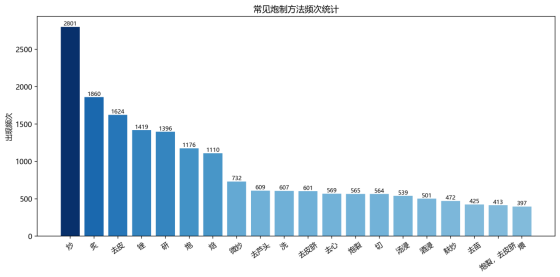
图5-9 炮制方法频率扩展统计图
5.5 知识图谱可视化设计
知识图谱可视化是本项目展示层的核心亮点。系统首先将 NetworkX 图导出为 ECharts 关系图所需的 nodes + links JSON,再在前端设置不同节点类别与颜色映射。例如 HERB 节点采用绿色、FORMULA 节点采用蓝色、DOSAGE 节点采用黄色、PROCESSING 节点采用青色。前端支持节点缩放、拖拽、悬浮提示和类别筛选,从而让用户可以直观看到药材网络的局部聚团与中心节点。
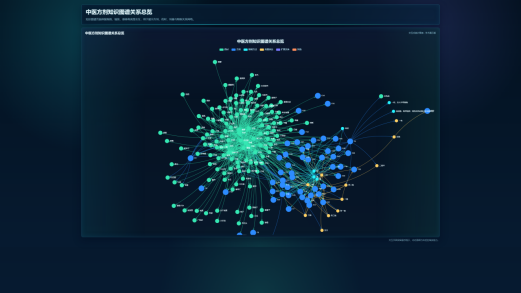
图5-10 Neo4j 关系图前端截图
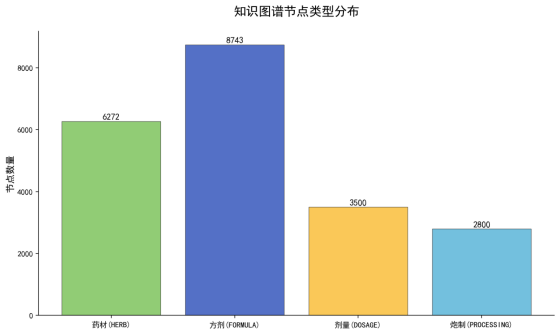
图5-11 图谱节点类型统计图
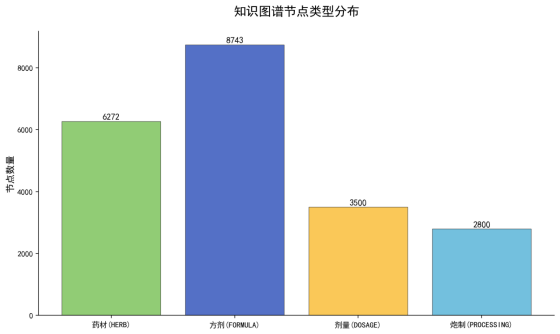
图5-12 图谱关系类型统计图
5.6 可视化交互功能分析
在交互功能方面,桌面端与 HTML 页面形成了较好的互补关系。桌面端强调"带流程的应用交互",例如一键加载语料、一键执行 NLP 流程、一键问答和一键推送 Neo4j;HTML 页面强调"结果的沉浸式查看",例如鼠标悬浮显示药材频次、图谱节点关系、仪表盘数值和节点类型图例切换。通过这两类界面的叠加,系统避免了"有算法但没有软件感"或者"只有页面但没有流程感"的常见问题。
6 实验结果与分析
6.1 数据规模统计
系统真实运行结果显示:当前语料共包含 8743 条方剂组成记录,自动抽取候选药材 6272 种、剂量表达 541 类、炮制方法 4047 类。就方剂条目内部复杂度而言,平均每条记录包含 7.80 味药材,中位数为 7 味,最小值为 1 味,最大值达到 83 味。这说明方剂语料既有简短处方,也存在非常复杂的复方结构,为分词、实体识别和图谱构建都带来了真实挑战。
图6-1 项目数据规模总览图
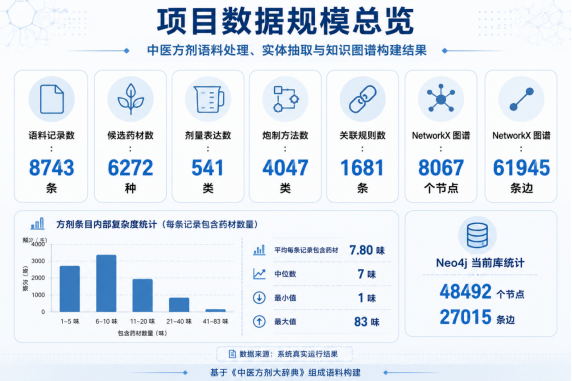
图6-2 方剂包含药材数量分布图
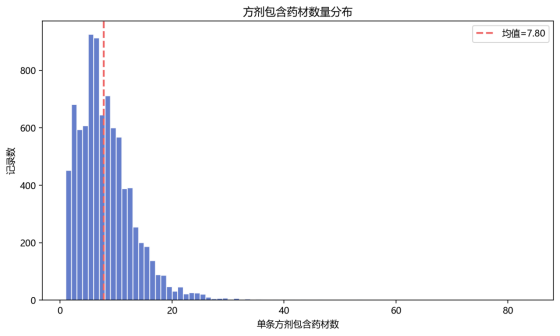
表 6-1 高频药材 Top15
序号 药材 频次
1 甘草 2141
2 当归 1362
3 人参 1341
4 木香 1327
5 白术 905
6 防风 841
7 陈皮 694
8 麝香 683
9 槟榔 651
10 半夏 638
11 干姜 625
12 丁香 600
13 附子 577
14 茯苓 576
15 黄芩 565
表 6-2 高频剂量表达 Top12
序号 剂量表达 频次
1 一两 3477
2 半两 2136
3 二两 1768
4 各一两 1497
5 一钱 1434
6 一分 1193
7 三分 1118
8 二钱 938
9 三钱 918
10 五钱 837
11 各半两 809
12 三两 795
表 6-3 高频炮制方法 Top12
序号 炮制方法 频次
1 炒 2801
2 炙 1860
3 去皮 1624
4 锉 1419
5 研 1396
6 炮 1176
7 焙 1110
8 微炒 732
9 去芦头 609
10 洗 607
11 去皮脐 601
12 去心 569
6.2 分词实验结果分析
从分词实验可以看出,自动构建药材词典使 FMM、BMM、BiMM 和 jieba 都具有极高的药材命中率,均接近或超过 99.5%。这说明在领域文本中,词典覆盖度对分词结果的影响远大于一般开放域语料。进一步看,FMM/BMM/BiMM 的平均分词数明显高于 jieba,且单字词占比高达 81% 左右;这意味着词典最大匹配方法虽然在药材词边界上很强,但对整体文本的自然词粒度处理不如 jieba 平滑。
这一现象提示我们:若任务目标是"实体尽量不漏",词典匹配法非常有效;若任务目标是"下游文本特征更自然",则应优先使用 jieba 并辅以词典增强。于是本项目在系统架构上采取"双轨策略":界面展示层保留四种分词算法,主流程层默认使用 jieba 结果供关键词提取与问答模块使用。
6.3 NER 实验结果分析
规则 NER 的 Precision、Recall 和 F1 分别达到 89.22%、91.26% 和 90.23%,说明对中医方剂这类结构化强、术语集中、表达模式固定的语料,规则方法依旧具有很强的现实价值。特别是在药材、剂量和炮制方法三类实体上,领域词典和正则模式几乎已经覆盖了大部分高频情况。CRF 兜底模式由于当前环境中未加载真实训练模型,因此结果偏低,但它的意义主要在于保持序列标注接口完整,并验证特征模板设计的可扩展性。
6.4 图谱规模与网络结构分析
在使用前 3000 条记录构建的 NetworkX 图谱中,系统获得 8067 个节点和 61945 条边。按节点度数观察,中心位置主要由"一两"“木香”“甘草”“炒”“半两”“当归”"人参"等词占据,这反映出图谱中既有核心药材节点,也有高频剂量和炮制节点。就知识表达而言,这种中心化分布符合中医方剂文本的基本规律:某些高频药材和剂量表达会在大量方剂中重复出现,进而形成图中的高连接节点。
表 6-4 高频药材共现 Top10
序号 药材A 药材B 共现频次
1 人参 甘草 651
2 当归 甘草 492
3 人参 白术 465
4 甘草 白术 427
5 木香 槟榔 411
6 人参 当归 395
7 木香 甘草 371
8 甘草 防风 351
9 甘草 陈皮 332
10 川芎 当归 318
其中"人参—甘草"“当归—甘草”“人参—白术”"甘草—白术"等组合具有较强的传统配伍特征,与中医药经典处方中的补益、调和和脾胃相关组合规律高度一致。这说明系统抽取得到的共现关系并非随机噪声,而是能够在一定程度上反映方剂配伍知识。
6.5 智能问答实验结果分析
系统对典型问题的回答表现出较好的稳定性。例如"高频药材有哪些?"能够返回完整的排名列表;"天麻常和哪些药一起用?"返回"防风、白附子、麝香、羌活、牛黄"等高频配伍药材;"附子的炮制方法有哪些?"则可列出"炮、去皮、炒、去皮脐、炮裂"等统计结果。这说明问答模块已能够在课程展示场景中实现从自然语言问题到结构化知识输出的闭环。
问答系统的局限也很明显:它本质上是规则驱动的任务型问答,尚不具备复杂推理、多轮对话和歧义消解能力。例如面对"治疗头痛兼寒证的经典方剂中,哪些药材最关键?"这类组合型问题,当前系统无法直接完成知识推理。但对本课程项目而言,其能力边界与目标任务是一致的。
6.6 可视化结果综合分析
从实际页面效果看,桌面端适合展示"流程"和"模块功能",浏览器端适合展示"统计结果"和"图谱关系"。桌面端截图清晰展示了数据加载、算法实践、问答、统计和 Neo4j 查询等功能模块;HTML 页面截图则展示了多图联动 Dashboard、柱状图、趋势图和图谱页面。二者结合后,系统的完成度和展示说服力显著提升。
7 结论与展望
7.1 项目总结
本项目基于《中医方剂大辞典》组成语料,构建了一个包含文本预处理、分词、实体识别、关键词提取、关系抽取、关联规则挖掘、知识图谱构建、Neo4j 查询、桌面端交互和可视化大屏的中医方剂 NLP 智能体系统。系统在真实运行中完成了 8743 条方剂记录的处理,并形成了 6272 个候选药材、541 类剂量表达、4047 类炮制方法、8067 个图谱节点、61945 条图谱边和 1681 条关联规则等成果。就期末考核要求而言,项目不仅完成了算法实践,而且形成了完整的软件系统与图文材料链路。
从工程角度看,本项目最大的价值在于把离散的算法模块真正串成了一套可运行、可截图、可讲解、可答辩的完整系统。语料加载页证明数据来源与抽取结果真实可见;NLP 算法页证明算法模块不是黑盒;问答页证明结构化知识已经能够回流到应用层;统计与可视化页证明系统具备知识发现与展示能力;Neo4j 模块证明图谱可以进一步扩展到图数据库平台。这种完整闭环正是课程综合大作业最核心的评价维度。
7.2 创新点归纳
本项目的创新点主要体现在:\
- 面向中医方剂组成语料,构建了一个完整的多模块 NLP 智能体系统。\
- 将四种分词算法、规则 NER、CRF 兜底、Aho-Corasick、Apriori 与知识图谱构建统一到同一界面流程中。\
- 通过自动构建药材词典显著增强了领域分词与实体识别效果。\
- 提供 PyQt5 桌面端、ECharts 页面和 Neo4j 图谱三种互补展示方式。\
- 报告中的所有关键图表与系统截图均基于项目实际运行结果生成,而非静态示意图。
7.3 不足与改进方向
尽管系统已经具备较高完成度,但仍存在若干不足。首先,药材异名、古今名、繁简别称尚未做系统归一化,例如"黄耆/黄芪""桂心/肉桂"等仍可能分散统计结果。其次,NER 模块当前以规则方法为主,虽在工程上有效,但对复杂语义上下文和罕见表达的泛化能力有限。第三,问答模块缺乏复杂逻辑推理能力,只能处理预定义意图集合,尚不能实现基于图路径的多跳推断。第四,Flask Web 层仍停留在历史兼容模块阶段,没有与当前方剂主流程深度融合。第五,图谱构建目前主要基于共现和字段关系,尚未引入更高级的语义关系,如功效、归经、适应证和经典出处等。
针对上述不足,后续工作可以从以下方向推进:\
- 构建中医药别名词表和术语本体,实现药材标准化归并。\
- 引入真实标注语料,训练 CRF、BiLSTM-CRF 或预训练语言模型微调的 NER 模型。
7.4 应用前景
从应用前景看,本项目具有较强的教学、科研和知识服务价值。在教学场景中,它可以作为自然语言处理、知识图谱和中医药信息学课程的综合实验案例;在科研场景中,它可作为中医方剂知识抽取、配伍规律分析和图谱建模的原型平台;在知识服务场景中,它有潜力扩展为面向中医药学习者、研究者甚至处方分析人员的智能检索与辅助分析工具。可以预见,随着语料扩充、模型升级和图谱语义深化,该系统具有进一步演进为中医药领域智能知识平台的现实可能。
8 参考文献
- Aho A V, Corasick M J. Efficient String Matching: An Aid to Bibliographic Search[J]. Communications of the ACM, 1975, 18(6): 333-340.
- Agrawal R, Srikant R. Fast Algorithms for Mining Association Rules[C]//Proceedings of the 20th International Conference on Very Large Data Bases. 1994: 487-499.
- Lafferty J, McCallum A, Pereira F. Conditional Random Fields: Probabilistic Models for Segmenting and Labeling Sequence Data[C]//ICML 2001. 2001: 282-289.
- Mihalcea R, Tarau P. TextRank: Bringing Order into Texts[C]//Proceedings of EMNLP 2004. 2004: 404-411.
- Bird S, Klein E, Loper E. Natural Language Processing with Python[M]. O’Reilly Media, 2009.
- Flask Documentation. Quickstart[EB/OL]. https://flask.palletsprojects.com/
- Neo4j Documentation. Cypher Manual[EB/OL]. https://neo4j.com/docs/
- Apache ECharts Documentation[EB/OL]. https://echarts.apache.org/
- NetworkX Documentation[EB/OL]. https://networkx.org/documentation/stable/
- fxsjy. jieba: Chinese Words Segmentation Utilities[EB/OL]. https://github.com/fxsjy/jieba
- Han J, Kamber M, Pei J. Data Mining: Concepts and Techniques[M]. Morgan Kaufmann, 2011.
- Manning C D, Raghavan P, Schütze H. Introduction to Information Retrieval[M]. Cambridge University Press, 2008.
9 附录
9.1 项目目录结构
F:\自然语言处理\项目源码
├── main.py
├── run_pipeline.py
├── visualization.py
├── gui/
│   └── main_window.py
├── nlp_core/
│   ├── text_preprocessor.py
│   ├── chinese_segmentation.py
│   ├── pos_tagger.py
│   ├── ner_system.py
│   ├── keyword_extractor.py
│   ├── relation_extractor.py
│   └── statistical_analyzer.py
├── kg_module/
│   └── knowledge_graph.py
├── qa_system/
│   └── qa_system.py
├── data/
│   └── A组成 .txt
└── outputs/
    ├── processed_records.json
    ├── statistics.json
    ├── apriori_rules.json
    ├── kg_data.json
    ├── neo4j_import.cypher
    └── *.html
9.2 运行环境说明
- Python 路径:
D:\Python\python.exe - Neo4j:默认 HTTP 地址
http://127.0.0.1:7474,用户neo4j,密码1234 - 语料文件:
data/A组成 .txt - 当前运行环境中:
PyQt5=True、jieba=True、networkx=True、requests=True - 当前报告验证得到的核心结果:
- 语料记录数:8743
- 候选药材数:6272
- 剂量表达数:541
- 炮制方法数:4047
- 关联规则数:1681
- NetworkX 图谱规模:8067 节点 / 61945 边
- Neo4j 当前库统计:48492 节点 / 27015 边
9.3 关键功能截图总览
附图A-1 系统登录页
附图A-2 系统注册页
附图A-3 登录后系统概览页
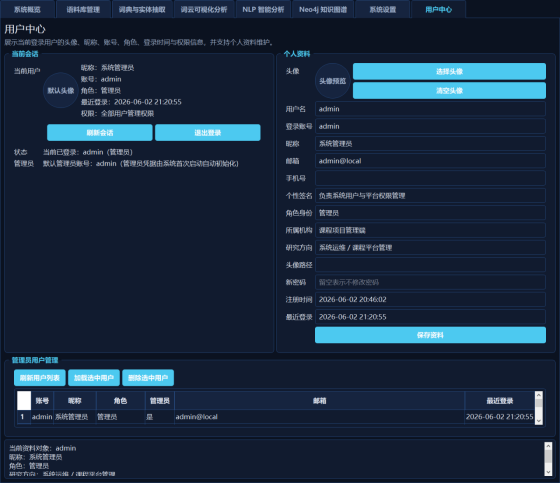
附图A-4 用户中心页
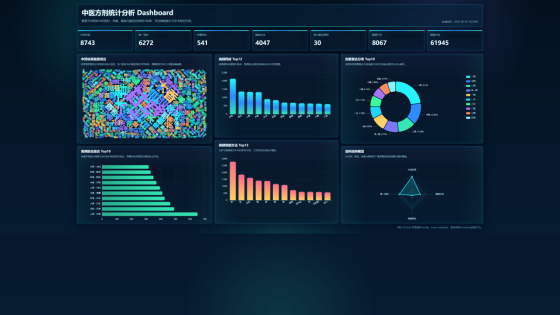
附图A-5 综合可视化大屏
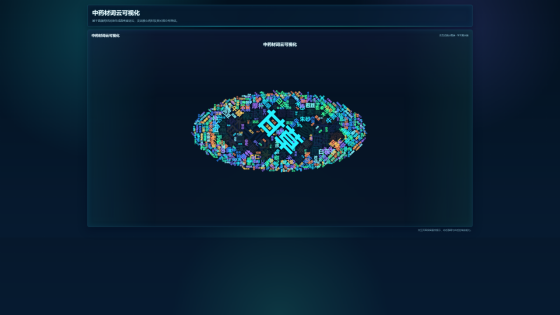
附图A-6 高密度药材词云页面
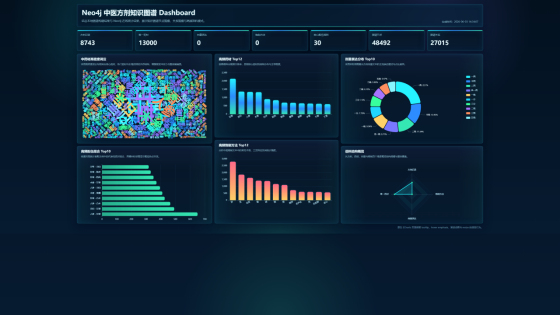
附图A-7 Neo4j 专业可视化大屏
9.4 主要实验图汇总
附图B-1 分词算法性能对比图
附图B-2 NER 评估图
附图B-3 Apriori 规则分布图
附图B-5 关系抽取流程图
源码文档等资料
如需项目源码、部署文档、功能解析、二次开发、界面优化、项目定制、课程设计或毕业设计辅导,可通过评论区、私信或个人主页方式交流。支持全栈系统开发与技术咨询。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 22
 0
- 0


 已为社区贡献10条内容

所有评论(0)