不靠大算力!结构化Prompt重新定义文生图训练标准
文章目录
P.S. 推荐一个大神的教程给想要了解或者学习人工智能知识的读者,这个教程里内容讲解通俗易懂且风趣幽默,对我帮助很大。我想与大家分享这个宝藏教程,请点击下方链接查看, 传送门https://blog.csdn.net/qq_74013365
搞文生图的圈子这几年卷得特别有规律。
就跟大家约好了似的,比谁模型参数大,比谁训练数据多,比谁算力烧得狠,三板斧轮着抡,卷到现在都快卷出火星子了。
结果最近字节Seed团队扔出来个新研究,直接给大伙整懵了:你们卷了半天,有没有想过——给模型看的“题干”本身,可能就没写明白?
1. 你写的长prompt,可能大部分都是废话
很多人都有个直觉:prompt写得越长,细节给得越多,模型生成的图就越好。
就像你给外包提需求,总觉得写得越详细,对方越不容易跑偏。
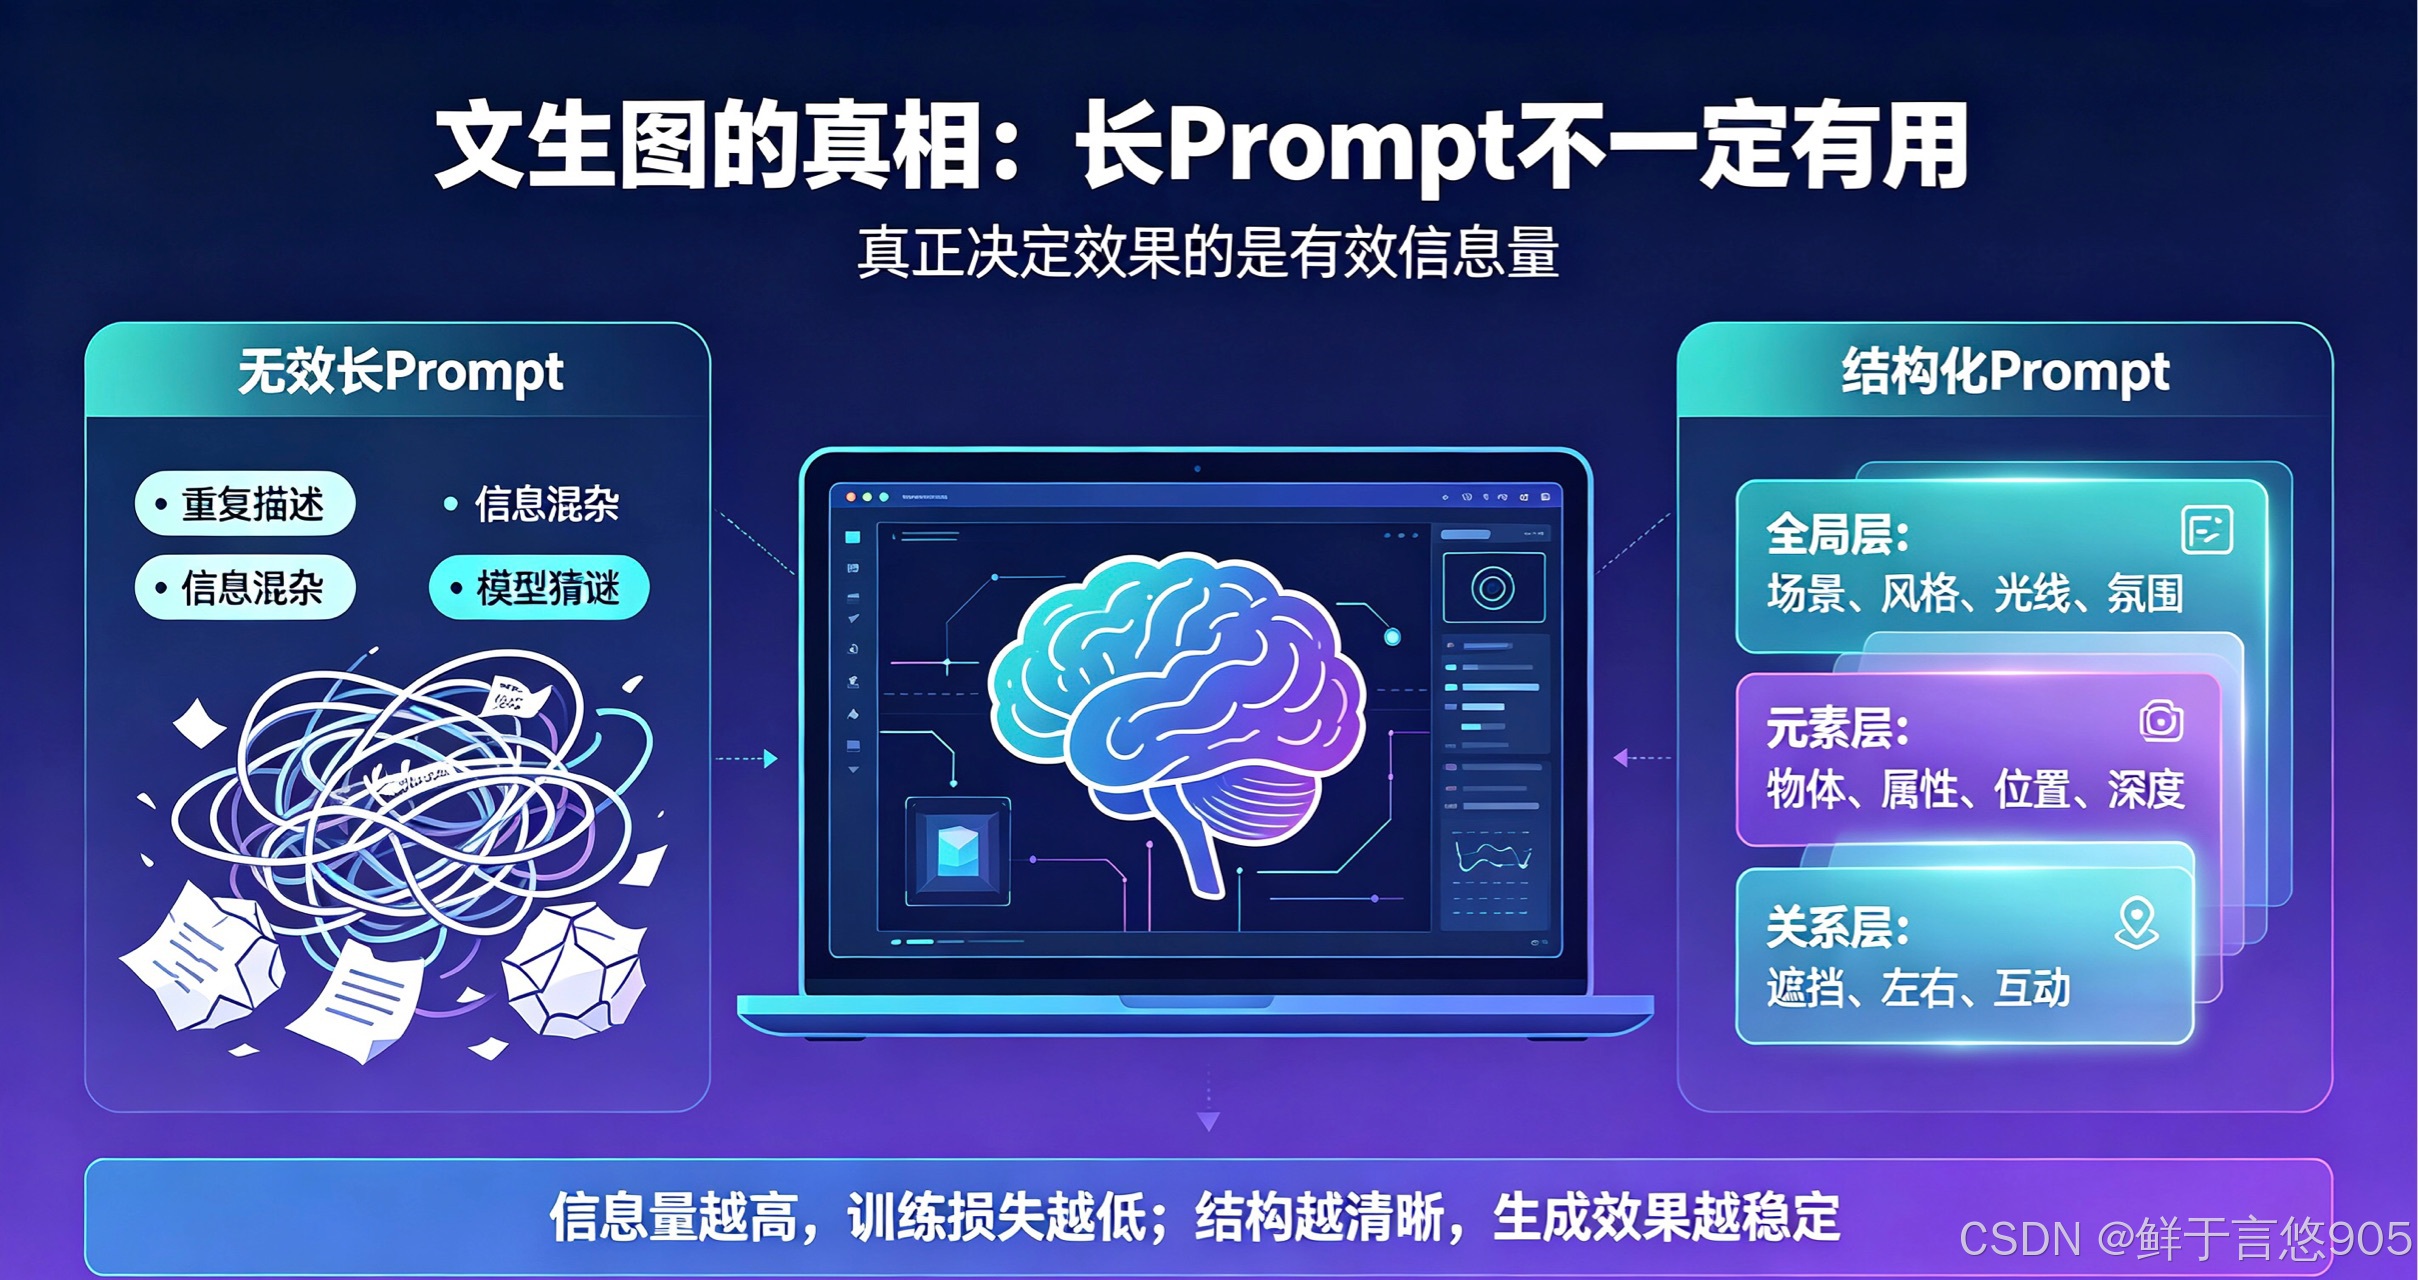
但现实很打脸:自然语言的prompt,长度稍微加一点就饱和了,再往长了写,不仅没提升,搞不好效果还往下降。
1.1 凑字数的活儿,模型不吃这一套
团队专门做了个实验,同一张参考图,从同一份标注出发,做了四版越来越长的描述。
说白了就是不断加修饰、补铺垫、换说法,把一句话抻成一段话,字数翻了好几倍。
结果呢?图像还原的质量基本没涨。
新增的那些话,大多是换个说法重复已经说过的内容,根本没加新的、模型能用的视觉信息。
这就跟你写作文凑字数似的,“今天天气很好”扩写成“今天的天空格外湛蓝,云朵洁白柔软,微风拂过脸颊十分惬意”,老师一眼就看出来是水字数,模型也一样,不吃这套。
2. 啥才是真正有用的信息量?
既然长度不靠谱,那总得有个东西能衡量,caption里到底有多少真东西。
团队整出来两个互补的指标,专门算这个。
2.1 第一个:看图猜文的提升幅度
这个指标叫GPG,大白话很好理解:同一句话,让视觉语言模型分别在“看图”和“不看图”的状态下去预测,看图之后预测准度提升了多少。
提升越大,说明这句话里和图片绑定的信息就越多,不是空口说白话。
2.2 第二个:说的内容有多少能对上
第二个叫ED,更直白:caption里说的那些物体、属性,有多少真的在图里,又覆盖了多少图里的内容。
简单说就是不吹牛,说一个是一个,每个描述都有图里的东西对应上。
这就跟相亲看简历似的,不是写得越长越优秀,得每条都能落地,说自己年薪百万结果是月薪三千,那全是无效信息。
2.3 这俩指标,能直接预判训练效果
最狠的是啥?团队测了15种不同的caption配置,发现caption的长度和最终训练效果根本没什么稳定关系。
但换成这两个信息量指标,结果就特别有规律:信息量越高,模型最终的训练损失就越低,准得离谱。
这意味着啥?以前你想试个新的caption写法,得花几十万电费训完模型才知道好不好。
现在不用,先拿这俩指标算一算,大概效果就有数了,省下来的钱够喝一年咖啡。
3. 怎么把信息量拉满?结构化安排上
知道了核心是信息量,下一步就是怎么把信息量做足,还得让模型好消化。
团队搞了个叫Structured Prompt的东西,说白了就是用结构化的JSON格式来描述一张图。
3.1 三层结构,清清楚楚
这套结构分三层,各管各的。
第一层是全局层,管整个画面的基调:什么场景、什么风格、什么光线、什么氛围,统统一目了然。
第二层是元素层,管画面里每个东西:是什么、长啥样、在干啥、在哪个位置,甚至前后深度都标明白。
第三层是关系层,管东西和东西之间:谁挡着谁、谁在谁左边、俩东西在干啥互动,都写得明明白白。
3.2 为啥结构化比自由文本强?
以前的自然语言caption,就像一袋混装的零件,所有信息搅在一块,哪个属性归哪个物体,哪个位置对应哪个东西,模型得自己猜。
结构化之后就不一样了,每个信息都有自己的格子,标签贴得清清楚楚,模型拿过来直接用,不用花精力猜谜。
就像你收拾衣柜,把衣服、裤子、袜子分抽屉放,找的时候肯定比扔在一堆里快得多。
3.3 批量生成?有完整流水线
训练数据那么多,总不能人工一个个写JSON。
团队搭了套完整的流水线,通用大模型负责语义内容,专门的模型负责补人体姿态、深度信息、分割掩码,最后再统一整理成完整的结构化描述。
相当于流水线作业,各工种干自己擅长的活,最后拼出来的成品又准又全。
4. 用户不会写JSON?大模型来转
训练的时候用结构化描述没问题,但用户用的时候总不能让人家自己写JSON吧?
总不能用户输入“画只猫”,你回“请先提供符合schema的JSON格式描述”,那用户得直接跑了。
所以还得有个“翻译”的角色,把用户的自然语言需求,转成高质量的结构化提示。
4.1 大模型越强,转得越好
团队先试了试零样本直接转,发现大模型尺寸越大,转出来的质量就越高。
再加个思维链,让模型先想想再输出,效果还能再上一个台阶。
就跟你让助理订餐厅一样,新手助理只会问你想吃啥,厉害的助理直接根据你的口味、预算、位置,给你列好几个选项,差距就在这。
4.2 专门训练,效果再升级
零样本虽然能用,但还是不够顶。
团队又搞了三阶段训练,一步步把这个“翻译官”训到极致。
先学格式和内容分布,再学怎么从用户需求反推完整结构,最后让它自己生成、自己渲染、自己优化,越练越顺手。
5. 还有个隐藏福利:改图特别方便
结构化描述还有个特别实用的好处:改起来省事。
以前生成的图不对,你得琢磨怎么重写一整段prompt,改了前面怕影响后面,越改越乱。
现在不用,哪不对改哪。猫的颜色错了,就改元素层里的颜色字段;位置不对,就改坐标;前后关系错了,就改关系层。
精准打击,不用全盘推翻。
5.1 迭代个两三轮,基本就到位了
团队还做了个循环修正的机制,生成、判断、修改,一轮一轮来。
实际测下来,平均改个两三轮就差不多达标了,再往多了改,提升也很小。
毕竟大方向对了,小细节修修补补就行,总不能无限改下去,改到天荒地老也没必要。
6. 最终效果到底咋样?
说了这么多,最关键的还是实际效果。
这套组合拳打下来,在开源模型里基本是第一梯队,很多任务上甚至能跟闭源系统掰手腕。
尤其是那种复杂组合、空间关系、需要点常识推理的任务,优势特别明显。
6.1 真不是模型大,是方法对
有人可能会说,是不是偷偷加了训练量或者换了更大模型?
团队专门做了对照实验,一模一样的模型架构、一模一样的训练数据、一模一样的训练预算,一组用结构化描述,一组用普通自然语言。
结果自然语言那组提升很有限,跟结构化的差一大截。
说白了,不是模型不行,是你给模型的“说明书”没写明白。说明书写清楚了,同一个模型能干的活直接升级。
其实这个研究最有意思的地方,是给行业指了个新方向。
以前大家卷文生图,都盯着模型本身卷,拼参数拼数据拼算力,卷到成本越来越高,普通人越来越玩不起。
但这个研究告诉我们,换个思路,把给模型的条件做扎实,把信息捋清楚,同样的模型、同样的数据,也能出更好的效果。
就像打仗不能只拼武器好不好,情报准不准、指令清不清晰,同样能决定胜负。
以后再有人跟你说prompt越长越好,你就可以告诉他:别凑字数了,整点有用的。
P.S. 推荐一个大神的教程给想要了解或者学习人工智能知识的读者,这个教程里内容讲解通俗易懂且风趣幽默,对我帮助很大。我想与大家分享这个宝藏教程,请点击下方链接查看,传送门https://blog.csdn.net/qq_74013365

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 6
 0
- 0


 已为社区贡献1条内容

所有评论(0)