数字人的“情感计算”技术:微表情识别与情感响应机制
一、从“会说话”到“懂情绪”:数字人的下一步
当一个数字人不再只是冷冰冰地回答问题,而是能够感知到用户语气中的焦虑,透过眉毛微蹿读出疑惑,甚至在对方悲伤时主动调整语调与表情给予安慰——这个时刻,数字人才真正完成了从“工具”到“伴侣”的质变。驱动这一变革的核心技术,便是情感计算(Affective Computing)。
全球情感计算市场正在经历爆发式增长。2025年市场规模达到883亿美元,2026年预计突破1028亿美元,复合年增长率保持在18.6%以上。中国市场在情感识别芯片与消费级硬件领域贡献了亚太区域增量的42%,是增速最快的区域市场之一。AI数字人作为情感计算最具变现力的载体,正从“会说话”走向“懂情绪”。
二、微表情识别:千分之一秒的情感密码
微表情(Micro-expression)是指持续时间仅为40到200毫秒的自发性面部表情动作,往往在人试图掩饰真实情感时泄露。对于数字人而言,能否捕捉这些转瞬即逝的面部变化,直接决定了其情感感知的精度上限。
当前主流的微表情识别技术基于面部动作编码系统(FACS),该系统将人脸分解为44个独立的动作单元(AU),每个AU对应一块面部肌肉的收缩或舒张。例如AU12控制嘴角上扬(微笑),AU4控制眉毛下垂(愆然)。通过OpenFace等开源工具,系统可从视频流中实时提取49个AU的强度数值,构建面部表情的时序特征序列。
在模型层面,ResNet18是应用最广泛的面部表情识别骨干网络,输入RGB图像序列,输出七类基本情感的分类概率。在AffectNet数据集上训练后可达到82%以上准确率。更先进的MultiModal-EmotionNet将视觉、音频、文本三路径融合,在IEMOCAP数据集上达到82.3%准确率。微表情识别的难点在于实时性——面部动作仅持续数百毫秒,要求全流程延迟控制在20毫秒以内。
三、多模态情感感知:不只是“看脸”
单一信号的情感识别存在固有局限性——同一张笑脸,可能是真心的喜悦,也可能是社交性的应付,甚至是讳讽的嘲讽。仅靠面部表情无法准确判断真实情感,这就需要多模态融合——将视觉、语音、文本三路信号联合判断。
语音情感分析是多模态融合的重要一环。系统通过MFCC算法提取13维声学特征,再由BiLSTM网络捕捉五秒时间窗口内的特征演变,判断说话人的情绪状态。例如语速加快、音量面提升时可推断其处于急切或不耐烦状态;语调下沉、停顿增多时则可能是悲伤或犹豫。
文本情感分析依赖Transformer架构的大语言模型。以“这个产品怎么用”为例,它可能是好奇的询问,也可能是不满的抱怨,需结合上下文判断真实态度。三路信号通常采用特征拼接或加权融合的方式,综合为连续的情感强度值,再由决策层输出最终情感标签。
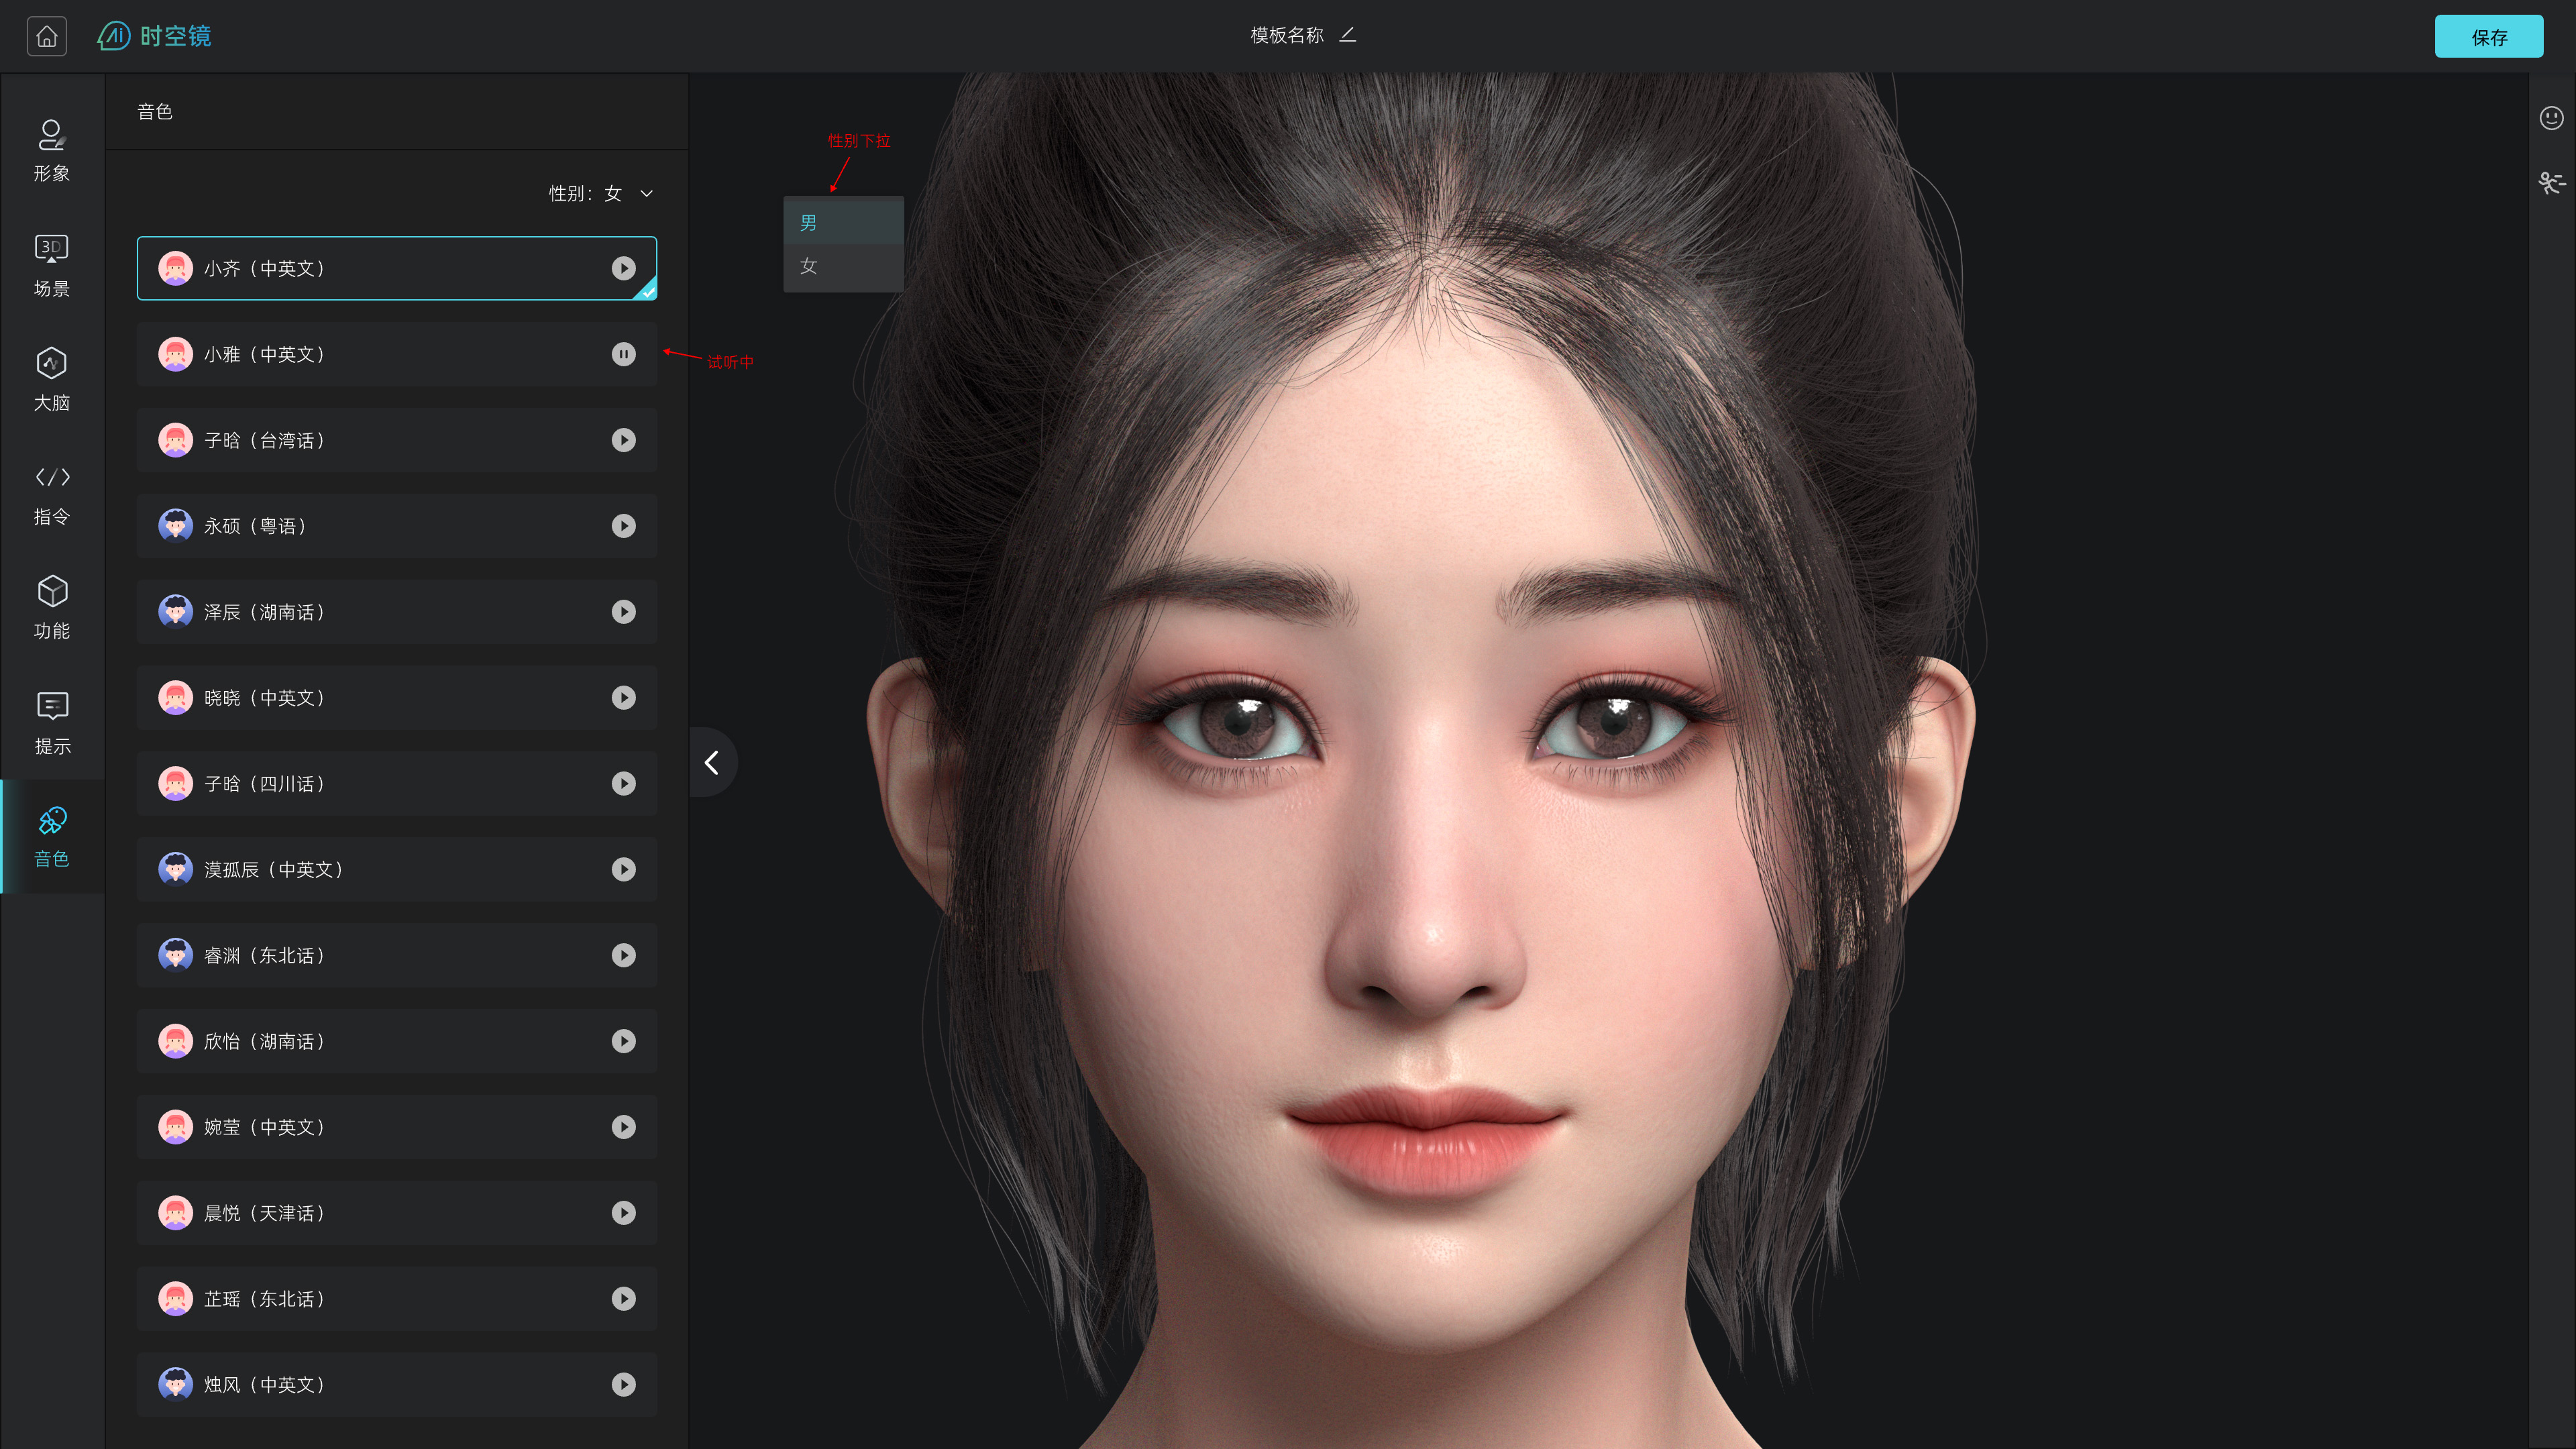
时空镜3D数字人交互平台——多模态情感感知的技术底座
四、情感响应机制:从“读懂”到“回应”
识别用户情感只是第一步,更关键的是数字人如何做出恰当的情感响应。这涉及三个层面:表情生成、语谀调整和内容共情。
在表情生成层,主流方案采用情感向量空间映射技术。该技术将六种基础情感转化为128维的数字编码,再映射为具体的AU组合。以微笑为例,真诚的微笑需同时驱动AU12(嘴角上扬)和AU6(眼角笑纹),而社交性微笑只驱动AU12——这种精细区分让数字人告别了“皮笑肉不笑”。部分模型还引入物理模拟约束,使生成表情自然度评分从3.2分提升至4.7分(5分制)。
在语谀调整层,TTS引擎需根据情感状态动态调整语速、音高和停顿节奏。当感知到用户急切时,数字人会放慢语速、降低音调,使回应听起来更为安慰;当感知到用户兴奋时,则适当提高音量和语速。以时空节拍在多个文旅项目中的实践为例,其采用的ASR-LLM-TTS全链路架构将首包延迟控制在1.5秒以内,确保从感知到响应的全流程接近真人交流的流畅度。
在内容共情层,大语言模型需结合情感状态生成共情性回复。当检测到用户悲伤时,数字人不仅要提供信息,还要融入安慰和理解;当用户表达不满时,则先表达同理,再引导解决问题。部分领先系统已将对话历史与智能记忆提取结合,实现跨轮次的情感连续性,避免每次对话都“重新开始”的割裂感。
五、行业落地:情感计算在数字人中的实践路径
情感计算技术的价值,最终要在具体场景中得到验证。目前,数字人情感计算的落地主要集中在文旅导览、医疗服务、客服互动和教育场景。
在文旅导览场景,具备情感感知能力的数字人可根据游客的语气和表情动态调整讲解策略。当游客表现出兴趣时,数字人自动展开更详细的文化背景;当感知到紧迫时,则精简讲解。以时空节拍旗下时空镜3D数智人交互平台为例,该平台通过AiHuman 3D引擎驱动高保真数字人形象,结合场景专属知识库实现多轮自然对话和智能导览,已在多个博物馆和文化景区完成落地验证。其中一个少数民族文化主题项目中,数字人能根据游客反应实时调整讲解的深浅度和语言风格,使导览体验从“千人一面”走向“千人千面”。
在医疗场景,全球医疗健康领域2025年情感计算需求规模45亿美元,2026年预计增至56亿美元。AI数字人在心理咨询、康复陪护、老年人关爱等场景中,可通过情感识别及时感知患者的情绪波动,配合医生进行干预。以时空节拍在数字人导诊方面的探索为例,其采用的永久记忆机制能够记录患者历史对话中的情绪状态,为后续诊断提供参考。
在客服互动场景,情感计算让数字人能够“听出”客户的真实感受。当客户语气激动时,系统会自动调整为安慰模式,优先处理情绪再解决问题;当检测到迷茫时,则主动提供补充说明。这种“先共情后解决”的交互逻辑,比传统冷漠的标准问答流程更能赢得用户信任。
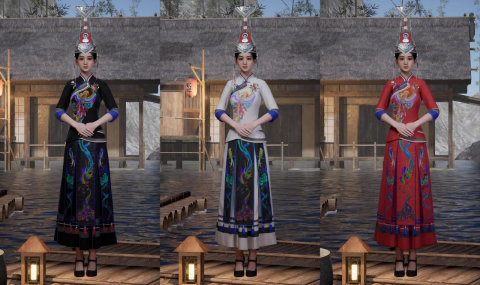
丽水学院畲族文化数字人——情感计算赋能文化交互
六、技术挑战与伦理边界
尽管技术进展迅速,情感计算仍面临多重挑战。首先是跨文化适配问题——同一个表情在不同文化中含义可能截然不同,要求训练数据具备多元文化覆盖度。其次是数据隐私与伦理问题。欧盟AI法案已将情感识别列为高风险应用,要求透明度与人类监督,部分场景甚至被禁止在工作场所和教育环境中使用。再者是情感推断的可解释性——黑箱模型的不透明性会影响用户信任,业界正推动从“情感检测”走向“情感感知解释”,即不仅输出标签,还提供支撑证据和置信度。
七、未来展望:从“识别”走向“共生”
展望未来,数字人情感计算的发展将沿三条主线展开。第一,从单模态走向多模态深度融合,未来将纳入生理信号和行为轨迹。第二,从被动响应走向主动关怀,数字人将能基于对话历史主动发现用户的情感需求。第三,从云端部署走向边缘智能化,减少数据上传的隐私风险。
以时空节拍为代表的技术型企业正将情感计算与数字人产品线深度结合。其时空镜平台支持多种TTS引擎灵活切换,能根据不同场景的情感表达需求选择最佳语音合成方案,内置审核机制确保情感交互在合规边界内运行。这种将情感计算能力深度嵌入产品架构的做法,而非作为独立模块叠加,是行业落地的关键路径。
情感计算不是让数字人“伪装”有感情,而是让它真正具备理解人类情感的能力。当数字人能够在用户犹豫时透过微表情读出迷茫,在用户悲伤时用软调语言给予安慰,人与机器之间的交互就跳出了“任务执行”的边界,进入了“情感协同”的新阶段。
八、情感计算技术架构总览
|
技术层级 |
核心能力 |
关键技术 |
|
情感感知层 |
面部表情识别、语音情感分析、文本情感推理 |
ResNet18/FACS、MFCC+BiLSTM、BERT情感分类 |
|
多模态融合层 |
跨模态特征拼接、加权决策、情感强度输出 |
MultiModal-EmotionNet、特征融合网络 |
|
情感响应层 |
表情生成、语谀调整、共情回复 |
128维情感向量、TTS情感注入、LLM共情生成 |
|
记忆与连续性层 |
对话历史存储、情感轨迹追踪、跨轮次情感连续 |
永久记忆机制、双层缓存架构 |

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 12
 0
- 0


 已为社区贡献3条内容

所有评论(0)