“高通芯杀进边缘 AI:QCS8550 开发板的旗舰算力到底有多强“
高通芯杀进边缘 AI:QCS8550 开发板的旗舰算力到底有多强
之前聊的 RK3576 和 RV1126B 都是瑞芯微的芯片。今天这本规格书翻开一看——高通 QCS8550。八核 Kryo CPU、Adreno 740 光追 GPU、48 TOPS NPU、8K@60fps 解码——这不是手机 SoC 的参数,这是一块边缘 AI 开发板。
AIO-8550JD4,把高通旗舰移动 SoC QCS8550 做成了 Linux 边缘计算板。我翻完 19 页规格书之后的感觉就是:这颗芯的规格,已经把目前主流边缘 AI 板卡的上限往上拉了一大截。
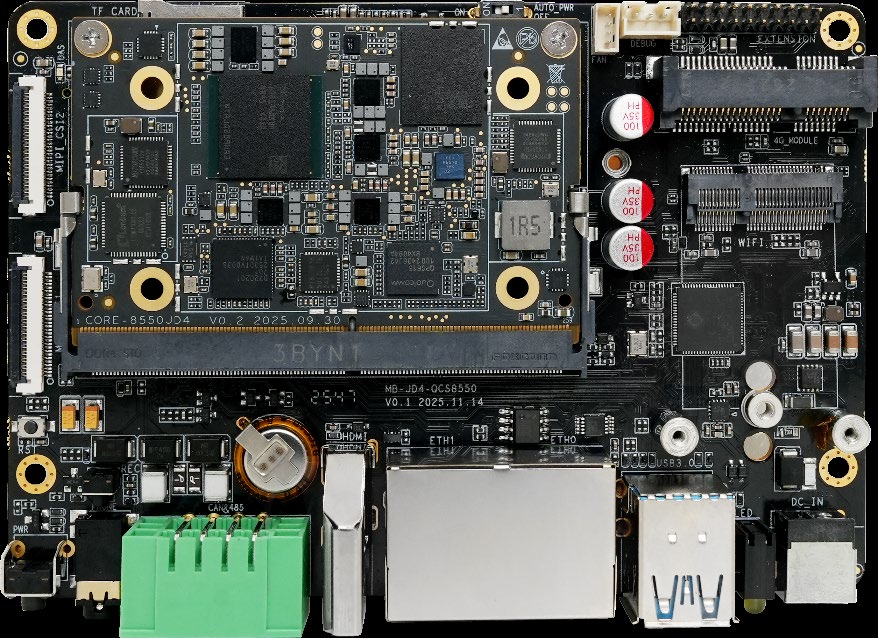
一、QCS8550 是一颗什么级别的 SoC?
先把核心参数摊开:
| 模块 | 参数 |
|---|---|
| CPU | 高通 Kryo:1×GoldPlus@3.2GHz + (2+2)Gold@2.8GHz + 3×Silver@2.0GHz,4nm 工艺 |
| GPU | Adreno 740,支持光线追踪,Vulkan 1.2 / OpenCL 3.0 |
| NPU | 双 eNPU V3:4 个 HVX + 1 个 HMX,48 TOPS(INT8)/ 12 TOPS(FP16) |
| ISP | 高通 Spectra 认知 ISP,3 个 18 位 3600 万像素 ISP |
| 视频解码 | 8K@60fps / 4K@240fps(H.265/VP9/AV1) |
| 视频编码 | 8K@30fps / 4K@120fps(H.265/H.264) |
| 内存 | 16GB LPDDR5x |
| 存储 | 256GB UFS4.0 + M.2 M-KEY SSD 扩展 + TF Card |
| 工艺 | 4nm 先进制程 |
几个让我停下来多看两眼的数字:
48 TOPS NPU。 之前 RK3576 是 6 TOPS,RK3588 是 6 TOPS(带 3 倍 NPU 也是 6 TOPS)。QCS8550 直接把 NPU 算力拉到 48 TOPS——差了整整 8 倍。这意味着不光是 YOLO 级别的目标检测可以跑,更接近云端推理的模型精度和吞吐都能在边缘端实现。
Adreno 740 光追 GPU。 边缘 AI 板卡上出现支持光线追踪的 GPU,这在以前很难想象。OpenGL ES 3.2、Vulkan 1.2、OpenCL 3.0 全配置——图形渲染和 GPU 通用计算的能力,对云游戏、数字孪生、AR/VR 这类场景的价值比单纯的 TOPS 数字更大。
8K@60fps 视频解码。 这是一个很夸张的数字。RK3588 是 8K@60fps 解码,但 QCS8550 的 8K@60fps 解码 + 8K@30fps 编码,并且支持无线显示场景下 4K 解码编码并发。对需要多路视频流的场景(多 camera 融合、视频墙、直播推流),这套编解码引擎是实打实的优势。
二、48 TOPS NPU:边缘端的算力天花板
NPU 是 QCS8550 在边缘 AI 场景中最核心的卖点。
双 eNPU V3 架构:
- 4 个 HVX(Hexagon 向量扩展)处理向量运算
- 1 个 HMX(Hexagon 矩阵扩展)处理矩阵乘加
- INT8 下 48 TOPS,FP16 下 12 TOPS
- 支持 INT4/INT8/INT16/FP16 混合运算
规格书里列的支持模型列表很全:Deepseek-R1 系列、Gemma 系列、Llama 系列、Qwen 系列、Phi 系列——主流的大语言模型都能跑。48 TOPS 的算力意味着参数规模可以比 RK3588/3576 大一个数量级,不需要降量化精度就能获得合理的推理速度。
高通还提供了 QNN(Qualcomm Neural Networks)AI 推理框架,加上 TensorFlow、PyTorch、ONNX 等主流框架的支持,模型迁移路径比较清晰。
说实话,目前边缘端能跑到 48 TOPS NPU 的板卡,一只手数得过来。
三、和 RK3588 的全面对比
RK3588 是目前边缘 AI 领域最主流的 SoC 之一,直接对比最能看清 QCS8550 的定位:
| 对比项 | AIO-8550JD4(QCS8550) | AIO-3588JD4(RK3588) |
|---|---|---|
| 工艺 | 4nm | 8nm |
| CPU | Kryo:1×3.2GHz + 4×2.8GHz + 3×2.0GHz | 4×A76@2.4GHz + 4×A55@1.8GHz |
| GPU | Adreno 740(光线追踪) | Mali-G610 MC4 |
| NPU | 48 TOPS(INT8)/ 12 TOPS(FP16) | 6 TOPS(INT8) |
| 内存 | 16GB LPDDR5x | 最高 32GB LPDDR4/LPDDR5 |
| 存储 | 256GB UFS4.0 + M.2 SSD 扩展 | eMMC 最高 256GB + TF Card |
| 视频解码 | 8K@60fps / 4K@240fps | 8K@60fps / 4K@120fps |
| 视频编码 | 8K@30fps / 4K@120fps | 8K@30fps / 4K@120fps |
| ISP | Spectra 认知 ISP,3×18 位 36MP | 内置 48MP ISP,120dB HDR |
| 典型功耗 | 4.8W | ~8W(整机) |
| 最大功耗 | 18W | ~28W(整机) |
| 以太网 | 2 × 千兆 RJ45 | 2 × 千兆 RJ45 |
| 高速接口 | M.2 M-KEY / E-KEY / B-KEY / Mini PCIe | M.2 M-KEY / Mini PCIe |
| 无线扩展 | M.2 E-KEY WiFi6 / BT5.2,Mini PCIe 4G,M.2 B-KEY 5G | Mini PCIe 4G/5G |
| 视频输入 | 4 × MIPI CSI(D/C PHY) | 1 × MIPI CSI |
| 视频输出 | HDMI2.0(4K@60Hz) | HDMI2.1(8K@60Hz) |
| 工业接口 | RS485 + RS232 + CAN 2.0 | RS485 + RS232 |
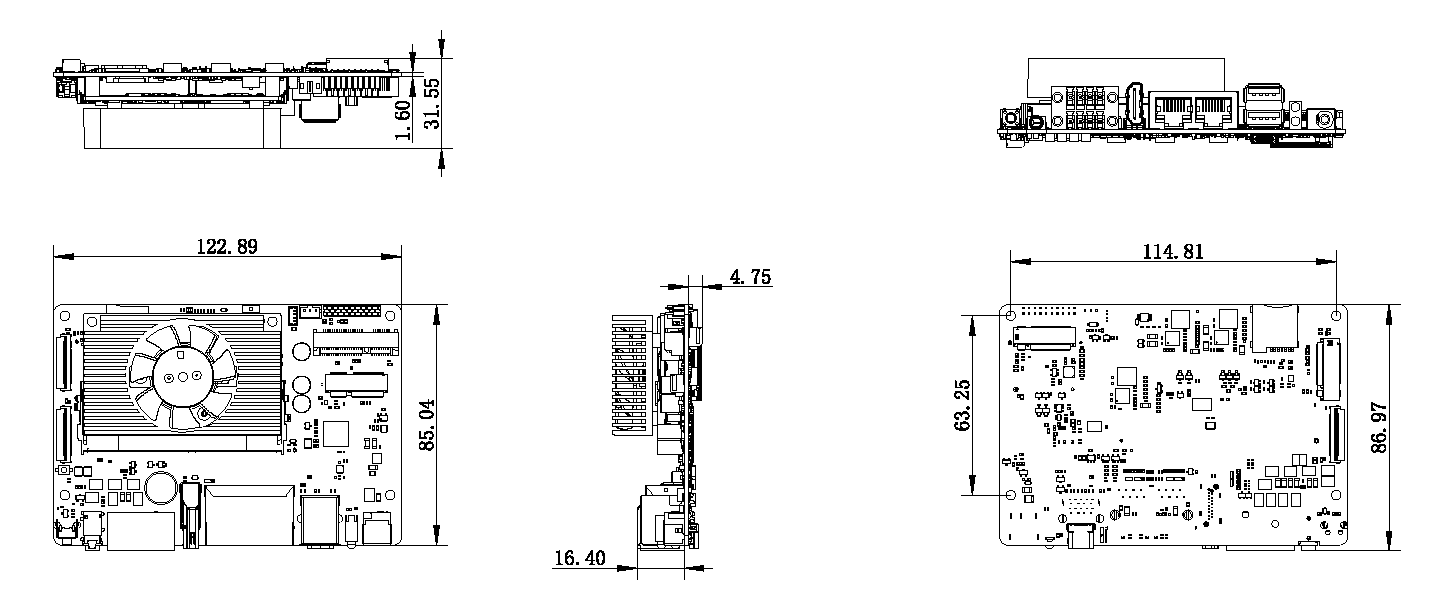
| 尺寸 | 122.89 × 85.04 × 31.55mm | 约 120×80mm |
| 系统 | Linux | Linux / Android / RTLinux |
几个关键差异:
1. NPU 算力差距 8 倍。 这是最核心的差异。48 TOPS vs 6 TOPS,意味着 QCS8550 可以跑更大的模型、更复杂的推理流水线,或者在同一个模型上获得更高的 FPS。如果应用需要跑 7B 以上的 LLM 或高精度多模态模型,QCS8550 的 NPU 储备量完全不同。
2. 4 路 MIPI CSI 输入。 RK3588 通常只有 1 路 MIPI CSI,而 QCS8550 提供了 4 个 MIPI CSI 接口(支持 DPHY 和 CPHY),支持最多 4 路摄像头同时接入。对多目相机、全景拼接、多视角检测这类场景来说,这是一个非常实用的硬件能力。
3. 扩展接口更丰富。 AIO-8550 不仅有 M.2 M-KEY(SSD),还有 M.2 E-KEY(WiFi/BT 模块)、M.2 B-KEY(5G 模块)、Mini PCIe(4G 模块)——三个独立插槽覆盖了几乎所有无线通信扩展需求。RK3588 这边通常只有 Mini PCIe。
4. 工业端子更全。 凤凰端子座上同时引出了 RS485、RS232 和 CAN 2.0。RK3588 的规格书里通常只有 RS485。做机器人、车载、工业控制的团队,CAN 总线是硬需求。
5. 功耗优势。 4.8W 典型 / 18W 最大 vs 约 8W / 28W——QCS8550 的 4nm 工艺带来了能效优势。算力 8 倍于 RK3588,功耗反而更低(典型值)。
6. RK3588 保留优势: HDMI2.1 支持 8K@60Hz 输出(QCS8550 是 HDMI2.0 4K@60Hz)、RTLinux 硬实时支持、更多成熟行业应用案例。
四、接口详解
AIO-8550JD4 的接口布局非常丰满:
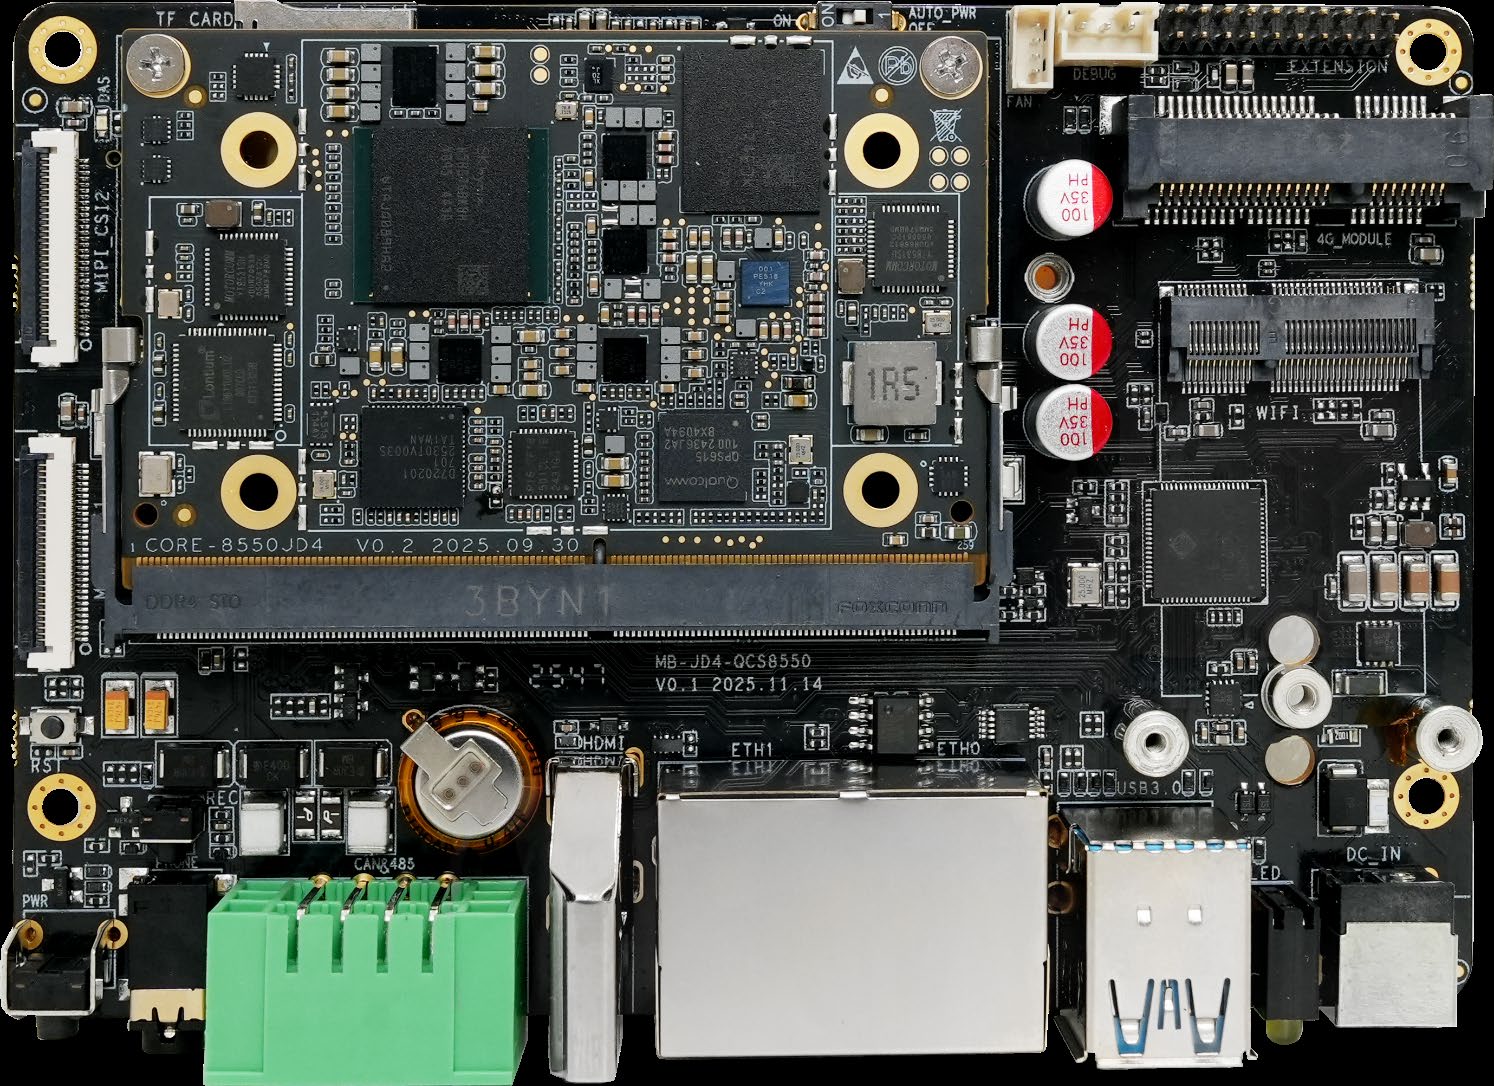
正面接口:
- 2 × RJ45 千兆以太网口
- 2 × USB3.0(限流 1A)
- HDMI2.0(4K@60Hz)
- 3.5mm 音频接口(MIC 录音,美标 CTIA)
- DC 12V 电源(5.5×2.1mm,支持 12V~24V 宽压)
- 电源键、Reset、Recovery
- 自动上电拨码开关
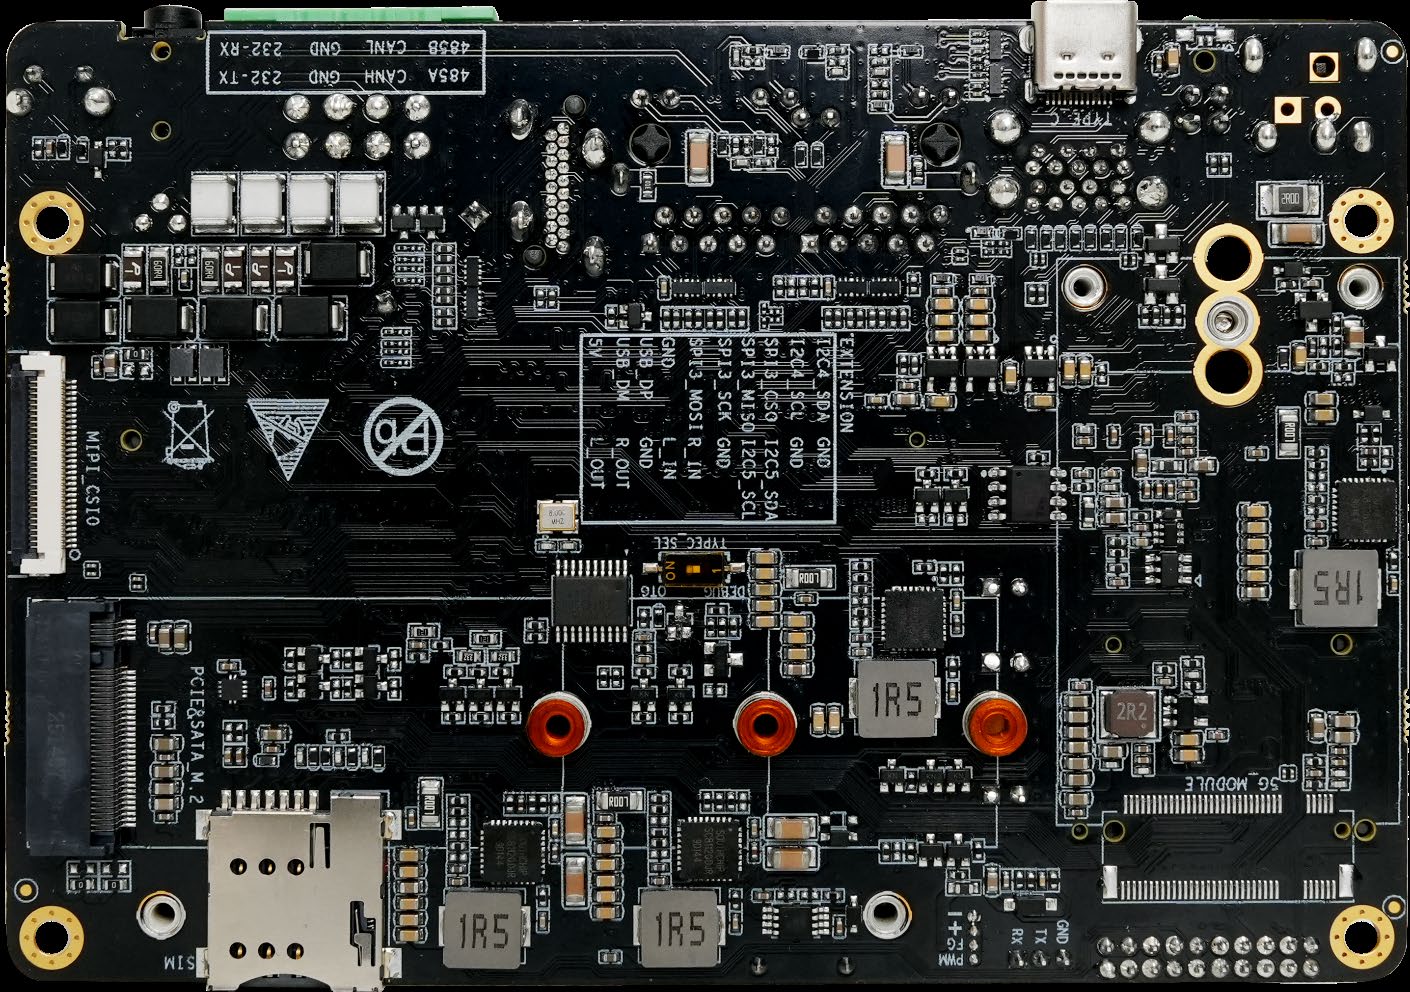
背面接口:
- MIPI CSI × 4(D/C PHY,30Pin-0.5mm)
- M.2 M-KEY(SSD,2242/2260/2280)
- M.2 E-KEY(WiFi/BT 模块)
- M.2 B-KEY(5G 模块,默认不贴)
- Mini PCIe(4G 模块)
- 凤凰端子座(8Pin-3.5mm)
- Type-C(烧录)、SIM Card、Debug、FAN、TF Card
完整接口清单:
| 接口 | 数量 | 说明 |
|---|---|---|
| 千兆以太网 | 2 | RJ45,1000Mbps |
| USB3.0 | 2 | 限流 1A |
| MIPI CSI | 4 | D/C PHY,2×4Lane + 2×2Lane |
| HDMI | 1 | 2.0,4K@60Hz |
| M.2 M-KEY | 1 | SATA/PCIe NVMe SSD,2242~2280 |
| M.2 E-KEY | 1 | WiFi/BT 模块 |
| M.2 B-KEY | 1 | 5G 模块(默认不贴) |
| Mini PCIe | 1 | 4G 模块 |
| 凤凰端子 | 1 | 8Pin-3.5mm:RS485 + RS232 + CAN 2.0 |
| Type-C | 1 | 烧录口 |
| SIM Card | 1 | 配合 4G/5G |
| 双排排针 | 20Pin | USB2.0 / UART / I2C / GPIO |
| FAN | 4Pin-1.25mm | 散热风扇 |
凤凰端子座的引脚定义(RS485 + RS232 + CAN):
| 引脚 | 信号 |
|---|---|
| 1 | RS485_A |
| 2 | RS485_B |
| 3 | CAN_H |
| 4 | CAN_L |
| 5 | GND |
| 6 | GND |
| 7 | RS232_TXD |
| 8 | RS232_RXD |
五、M.2 三插槽设计:边缘 AI 的通信中枢
QCS8550 的 M.2 扩展方案在边缘板卡里非常少见——同一个板子上集成了三个独立的 M.2 插槽:
- M.2 M-KEY(SSD):PCIe/SATA NVMe SSD,解决大模型权重的本地存储问题。256GB UFS4.0 + 扩展 SSD,跑大模型不需要担心存储空间。
- M.2 E-KEY(WiFi/BT):WiFi6 + 蓝牙 5.2 双频模块。
- M.2 B-KEY(5G):蜂窝网络扩展,适用于没有有线网络覆盖的户外/移动场景。
加上 Mini PCIe 的 4G LTE 插槽,四路无线通信扩展在同尺寸的板卡里很少见。
六、适用场景
48 TOPS 的算力、Adreno 740 GPU、8K 编解码、4 路 MIPI CSI、三路 M.2 扩展——这套配置可以覆盖的场景很宽:
| 场景 | 关键能力 |
|---|---|
| 机器人与自动驾驶 | 48 TOPS NPU 做多模态感知 + CAN 总线做电机控制 + 多路 CSI 做视觉融合 |
| 云游戏 / 算力服务 | Adreno 740 光追 GPU 做渲染 + 8K 编解码做推流 + 千兆双网口做网络 |
| 多路智能安防 | 4 路 MIPI CSI 同时接入 + 8K@60fps 编码 + 48 TOPS 做多路 AI 分析 |
| 边缘 AI 服务器 | 48 TOPS NPU + 大模型私有化部署 + UFS4.0 + M.2 SSD 做本地存储 |
| 工业边缘计算 | RS485 + RS232 + CAN + 双千兆网口 + 宽压电源 |
| 5G 边缘节点 | M.2 5G + Mini PCIe 4G + WiFi6,覆盖所有无线通信需求 |
写在最后
翻完 AIO-8550JD4 的格书,我的感受是:这不是一颗和 RK3588 竞争的产品——它的规格在另一层。
RK3588 是边缘 AI 的中坚力量,6 TOPS NPU、8K 编解码、双千兆,覆盖了当前 80% 边缘计算场景。而 QCS8550 把 NPU 算力拉到 48 TOPS,加上 Adreno 740 GPU、4 路 CSI、三路 M.2 扩展——它瞄准的是需要更大算力储备的边缘场景:多模态大模型推理、多路高清视频 AI 分析、云游戏渲染推流、自动驾驶的边缘训练。
当然,价格也肯定是另一个级别。但对于算力敏感型的边缘项目来说,QCS8550 把之前只能在云端做的事拉到了本地——而且功耗反而更低。如果项目现在在 RK3588 上跑模型,因为算力不够需要降精度或用 GPU 兜底,AIO-8550JD4 值得认真看一下。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 4
 0
- 0


 已为社区贡献5条内容

所有评论(0)