执行之前,先看引擎会生成什么 SQL:DirectQueryExplain
数据 Agent 生成了一条查询,下一步应该立刻执行吗?
更稳妥的做法是先把“编译”和“执行”拆开:先看依赖、看最终 SQL,再决定是否触碰数据源。InfiniSQL 的 DirectQueryExplain 就是这个检查点。
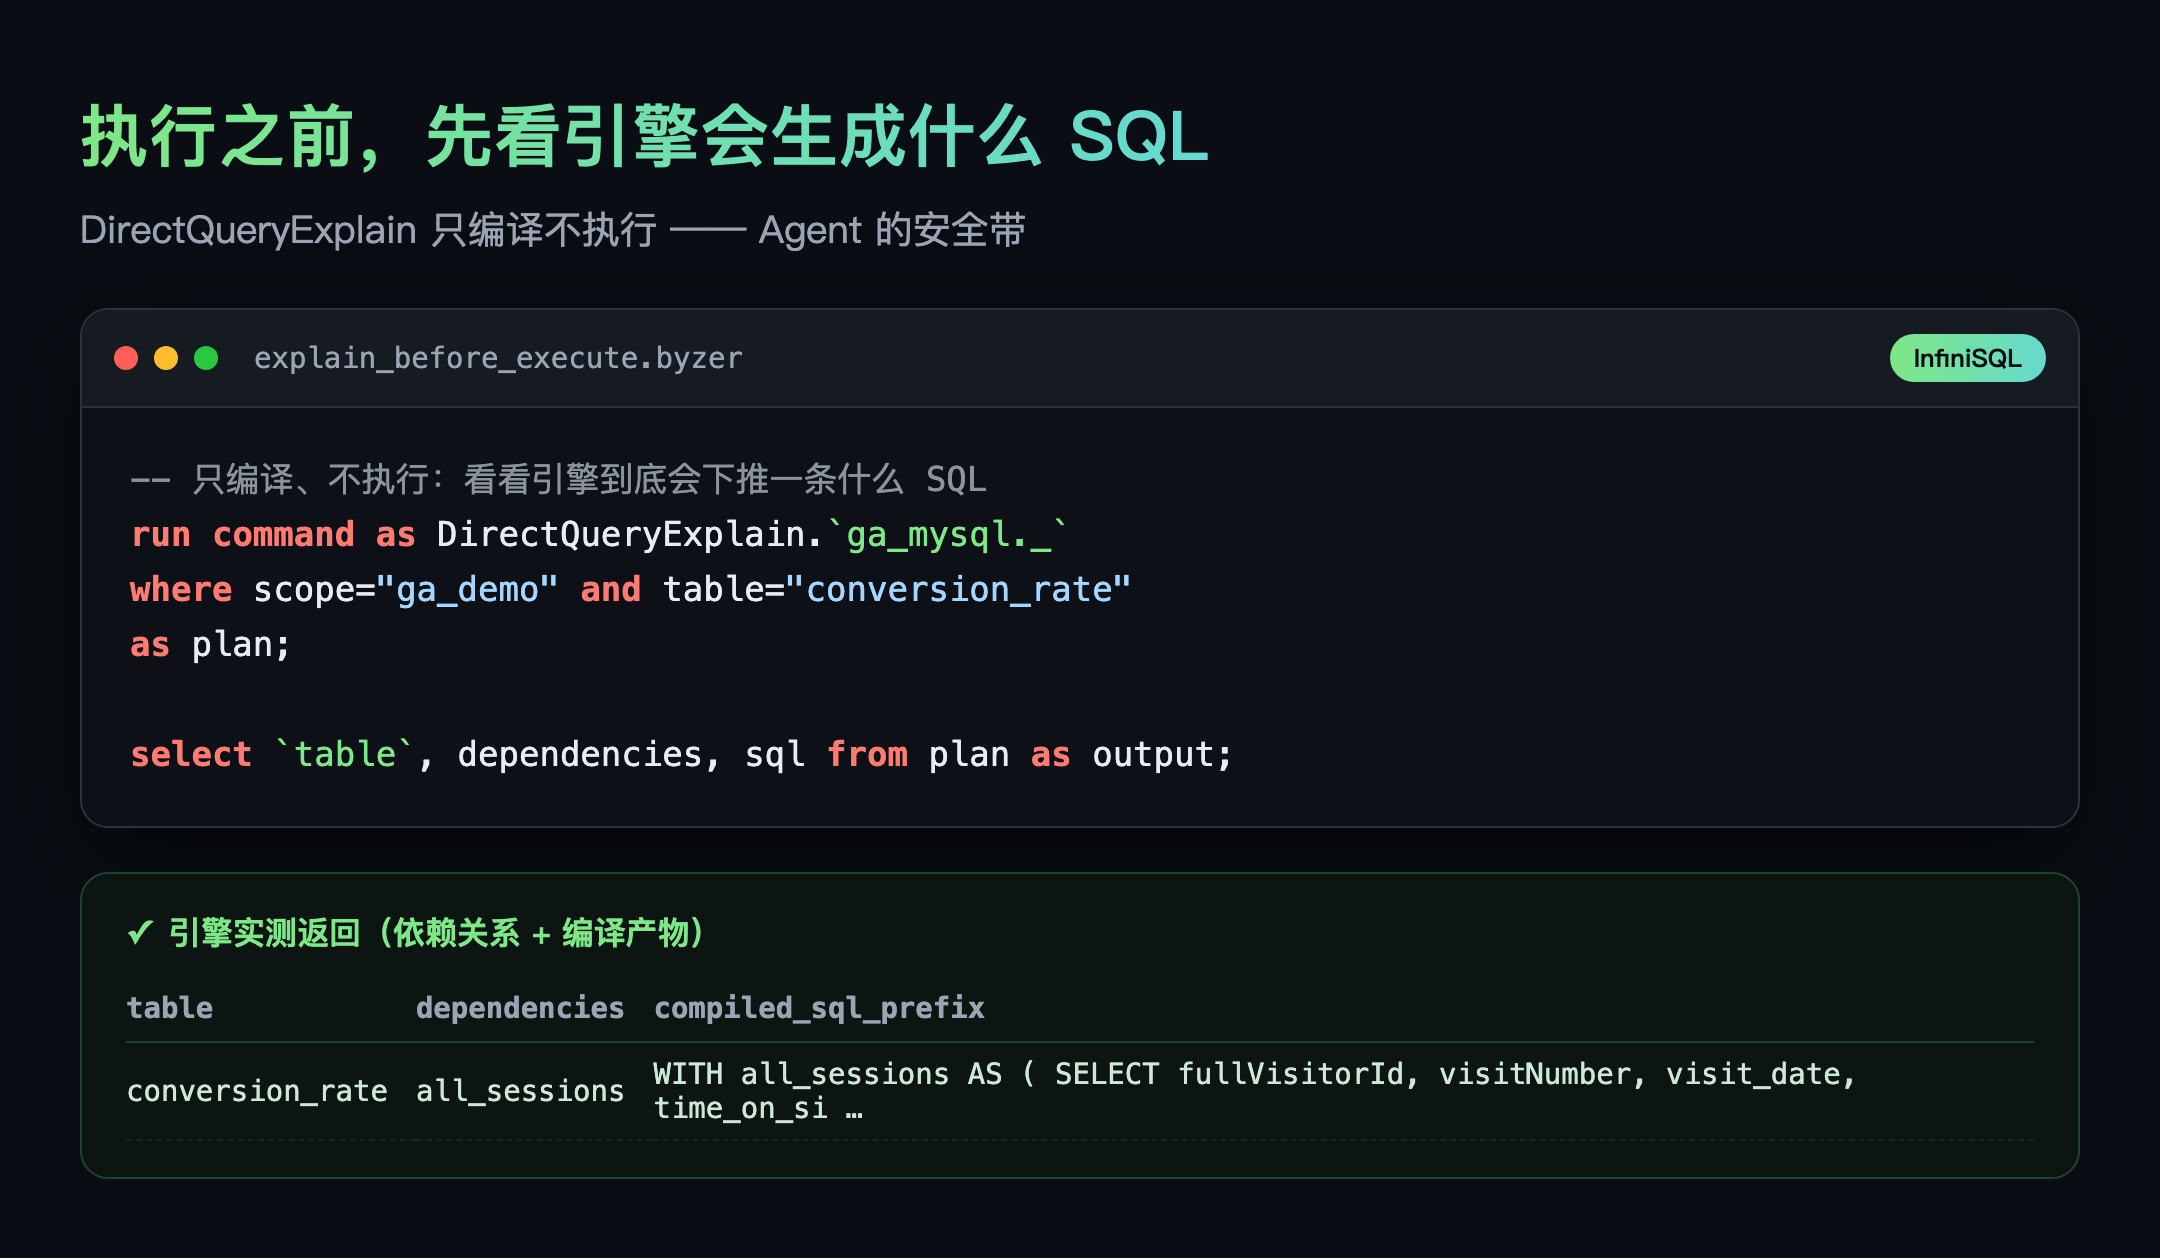
先编译,不执行
run command as DirectQueryExplain.`ga_mysql._`
where scope="ga_demo" and table="conversion_rate"
as plan;

select `table`, dependencies, sql from plan as output;
测试环境返回的结果包含三类信息:
[{
  "table": "conversion_rate",
  "dependencies": "all_sessions",
  "compiled_sql_prefix": "WITH\nall_sessions AS (\nSELECT fullVisitorId, visitNumber, ..."
}]
table:这次解释的目标节点;dependencies:它依赖的上游节点;sql:模板展开后的编译产物。
在这次测试里,conversion_rate 的依赖被识别为 all_sessions,SQL 也已展开为可检查的标准查询。
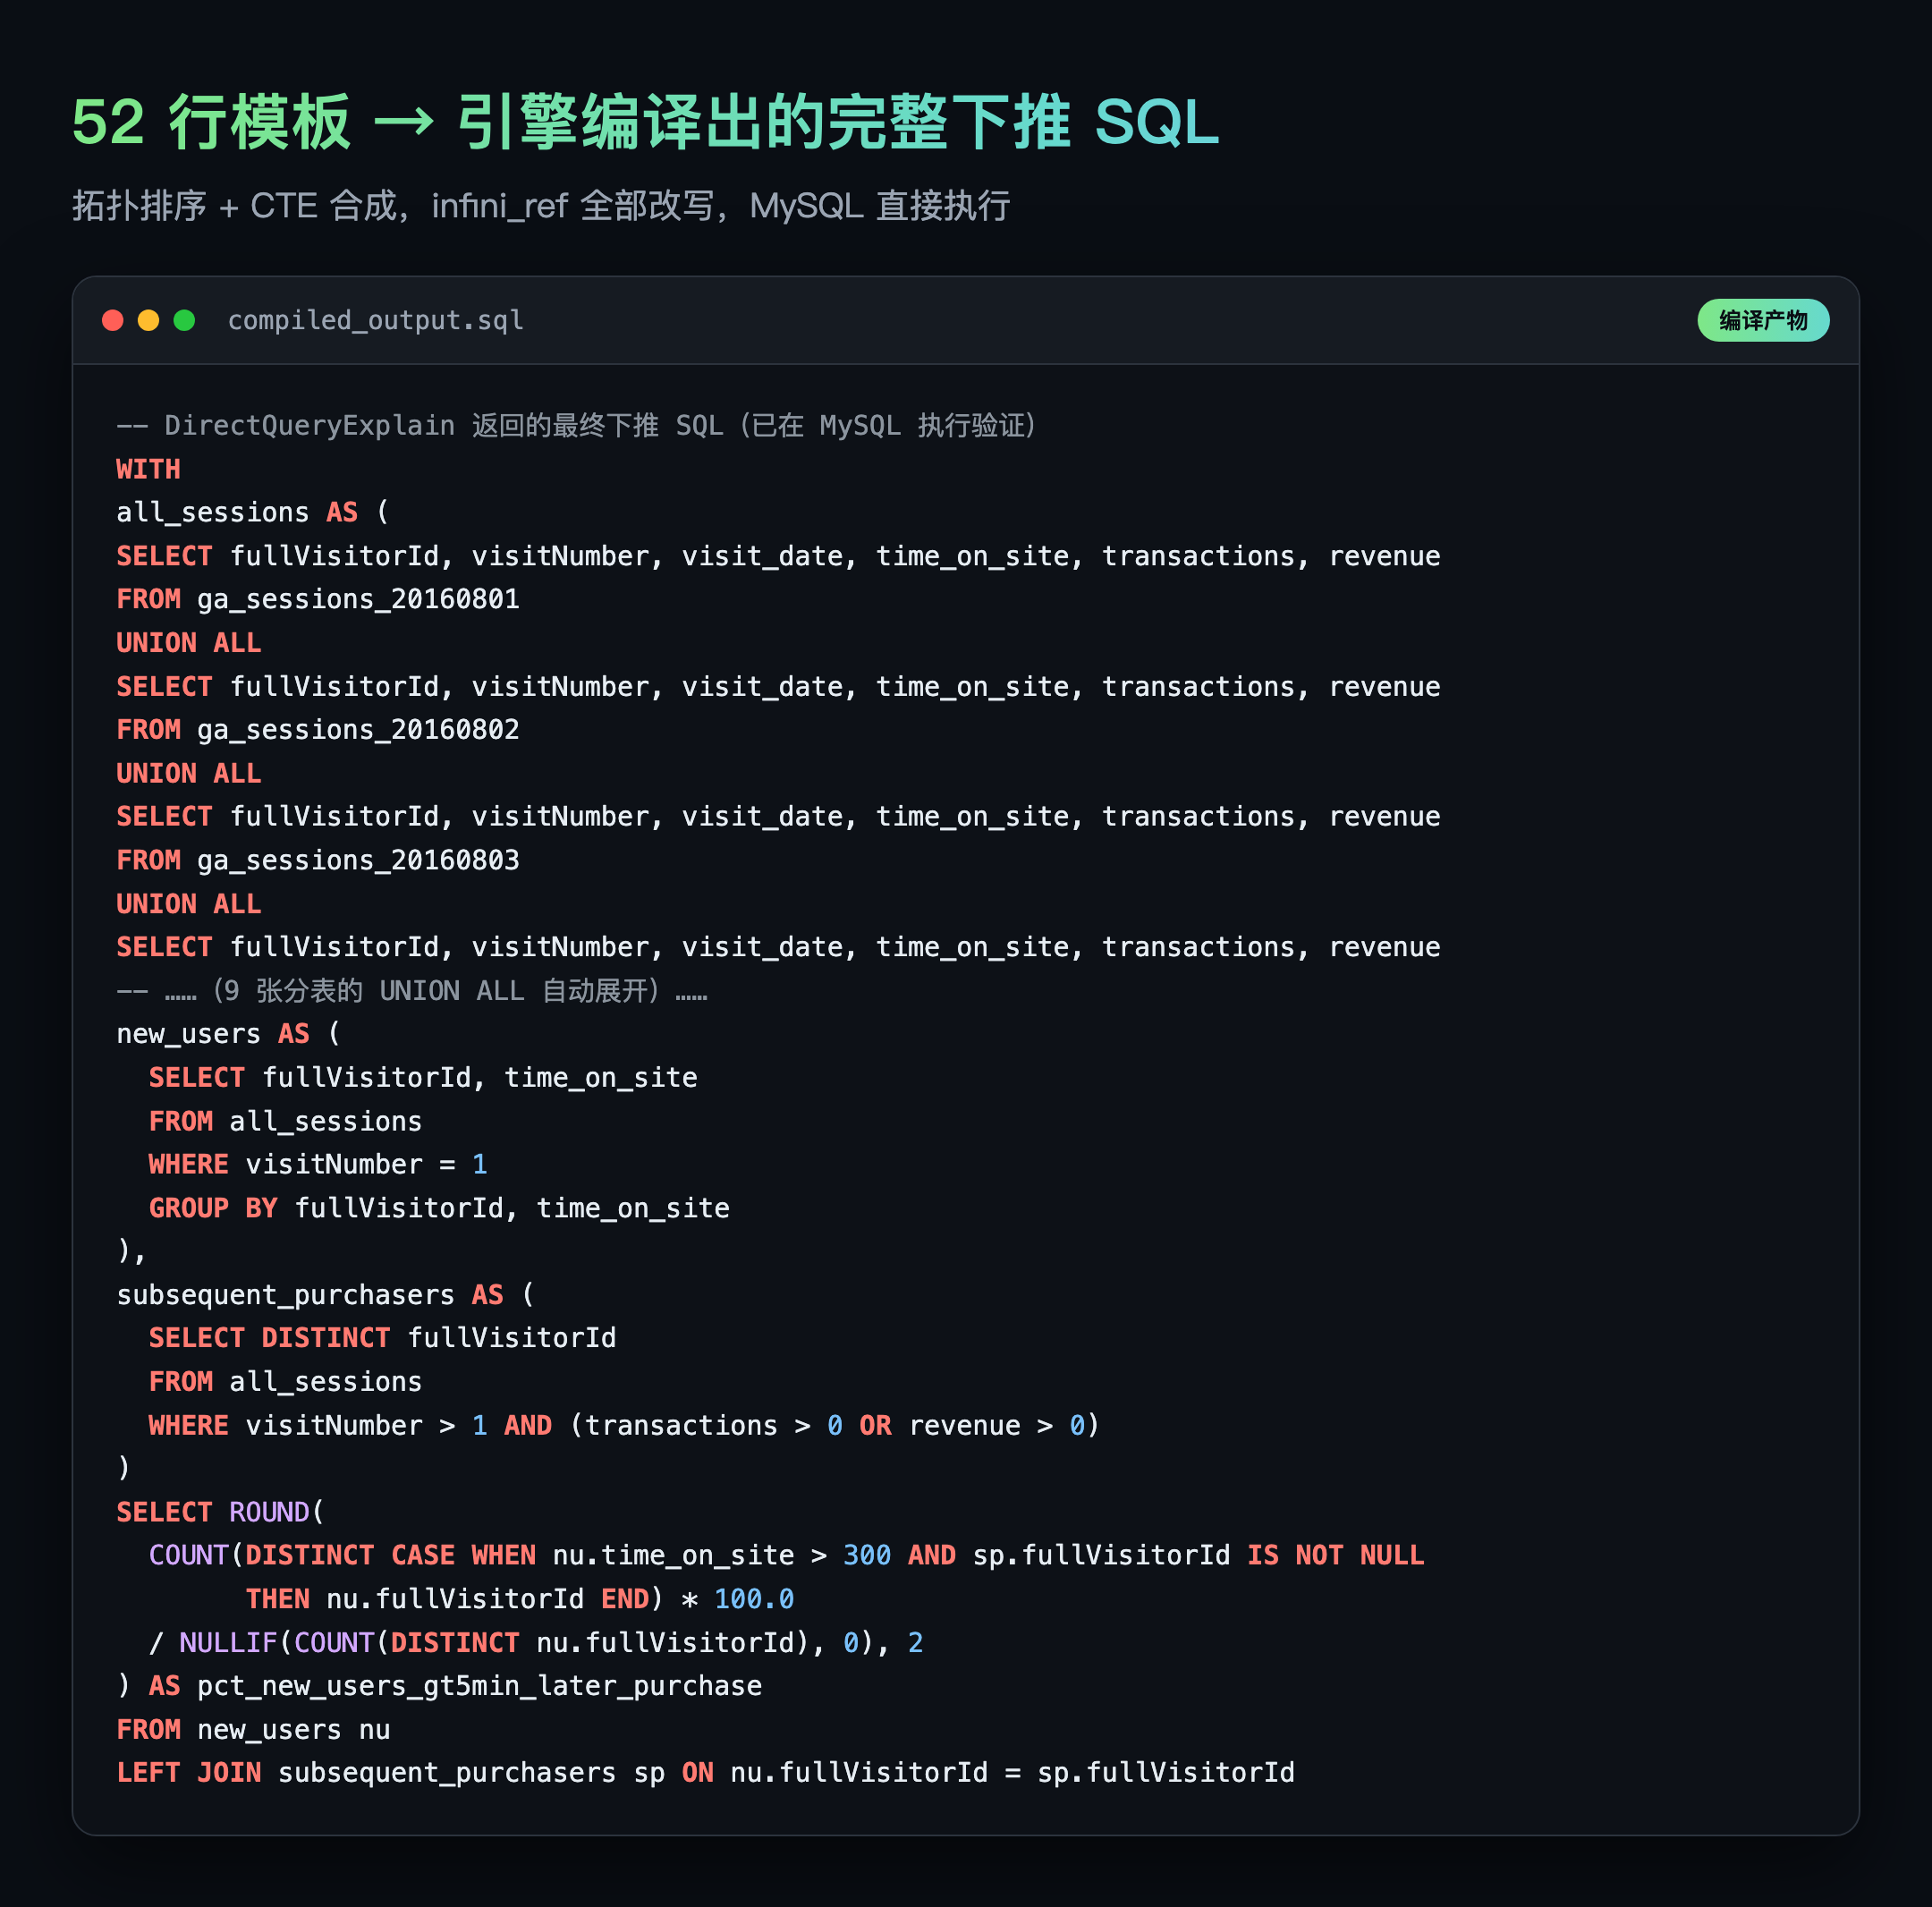
为什么这对 Agent 特别重要
自然语言到数据库动作之间隔着多层转换:意图理解、表和字段选择、模板引用、SQL 编译、下推执行。只看最终数字,很难定位哪一层出了问题。
把编译产物暴露出来后,可以建立三个明确的检查动作。
1. Agent 自查
Agent 可以在执行前重新检查 JOIN 条件、过滤范围、聚合口径和依赖表,发现明显偏差时先修正计划。
2. 人类审计
当业务方质疑一个指标时,讨论对象不再是“模型为什么这么想”,而是一条具体 SQL。分析师、数据工程师和 DBA 可以围绕同一份物证复核。
3. 回归测试
编译产物是文本,可以保存、diff,并进入 CI。模板修改后,下推 SQL 是否发生预期变化,可以由自动化检查回答。
Explain 不能替代什么
Explain 是检查点,不是正确性证明。
- 它能展示依赖与编译 SQL,但不能证明业务口径一定正确;
- 它能让潜在问题更早暴露,但不能替代真实数据上的结果校验;
- 本文证据证明这次测试产生了预期的解释结果,并未外推任何性能结论;
- “未执行”仅指本文这次
DirectQueryExplain测试没有触发目标查询执行,不应扩大解释为整个系统没有其他状态变化。
更完整的链路应该是:
生成计划 → Explain → 人或 Agent 复核 → 执行 → 结果断言
可验证性才是信任的最小单元
数据 Agent 的关键能力,不只是更快生成 SQL,而是把每一步都变成可独立检查的证据。具名表让中间结果可查,Explain 让编译产物可审,!assert 让业务约束可断言。
当这些检查点连起来,团队才有理由把自动化分析从演示环境推进到真实工作流。
让 Agent 快是效率,让 Agent 的每一步可对质才是工程能力。
InfiniSQL 是 InfiniSynapse 数据分析 Agent 的底座引擎。本文编译结果来自 Infinity SQL 测试环境的可复核记录。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 4
 0
- 0


 已为社区贡献3条内容

所有评论(0)