FinanceComplexQA:面向工业级金融文档的智能体推理评测基准
FinanceComplexQA:面向工业级金融文档的智能体推理评测基准
论文网页原文:https://arxiv.org/html/2607.19238v1
摘要
大语言模型驱动的智能体可整合海量金融信息生成专业分析报告,但现有评测体系难以量化不同智能体在真实复杂金融场景下的推理能力。本文首先提出Finance-LaTeX SKILL多智能体数据生成流水线,依托金融领域专家知识批量生成带复杂图文排版的专业财务文档与高质量问答样本;基于该流水线构建FinanceComplexQA双语开放式金融文档问答评测基准。
基准包含1009份真实工业级金融文档、2026道深度调研问答(中英文各1013题),覆盖8大金融场景、9类核心分析任务,具备专家级推理难度、复杂跨版式图文约束、稳定可核验标准答案、多维度智能体裁判自动评测四大核心特性。
本文在轻量RAG、版式检索、代码式智能体三类主流系统上开展大规模对照实验,覆盖闭源/开源7款主流基座模型。实验结果表明现有模型在长文档跨版式证据融合、多步骤数值推理、完整行业综合分析三大任务存在显著性能短板;通过失败案例分类拆解,定位检索、规划、计算、事实保真四大核心缺陷,为金融专用AI智能体优化指明方向。
四大核心贡献
- 设计Finance-LaTeX多智能体数据生成流水线,可规模化产出带表格、图表复杂结构的金融文档与可验证问答对;
- 构建FinanceComplexQA双语金融评测基准,支持跨版式、多步骤深度金融推理标准化评测;
- 提出基于智能体裁判的多维度自动评测方案,从准确率、数值精度、证据覆盖率、事实保真度多角度量化分析质量;
- 完成全谱系检索/智能体系统横向对比,系统性归纳金融推理典型失效模式,给出智能体架构优化落地思路。
1 引言
1.1 研究背景
金融分析对数值精准度、事实严谨性要求极高,微小计算或证据偏差会直接导致错误投资决策。当前LLM、RAG、工具智能体广泛用于财报解读、行业研报分析,但现有金融评测数据集存在明显短板:
- 样本多为短文本片段,缺少完整多页、表格/图表混合长文档;
- 仅支持单步数值抽取,无法模拟分析师多证据交叉综合调研流程;
- 以简答填空为主,缺少开放式专业分析类任务;
- 评测指标单一,仅依靠文本重叠度,无法衡量数值正确性、证据完整度。
现有FinQA、ConvFinQA、FinanceBench等数据集仅覆盖局部数值计算,无法评测真实分析师级综合推理能力。本文构建的FinanceComplexQA基准补齐该空白,同时配套可批量扩产的数据生成流水线。
1.2 核心设计思路
- 双上下文推理机制:答案必须融合文档显性图文证据+隐性行业会计/市场知识;
- 强制跨版式推理:单道问题需同时读取段落、表格、附注等多类异构素材;
- 多维度裁判评测:摒弃单一F1/ROUGE,综合判定结论、数值、证据、完整性;
- 稳定标准答案:依托长期公开财务事实,规避实时股价、动态政策带来答案失效问题。
1.3 论文结构
第2章介绍Finance-LaTeX数据生成流水线;第3章详细说明FinanceComplex基准数据集构造、标注体系与评测规则;第4章大规模对照实验;第5章失效案例、人工评估与基准难点分析;第6章相关工作;第7章总结;附录包含全部提示模板、运行脚本、数据集统计表格。
2 Finance-LaTeX 文档&问答生成流水线
2.1 设计动机
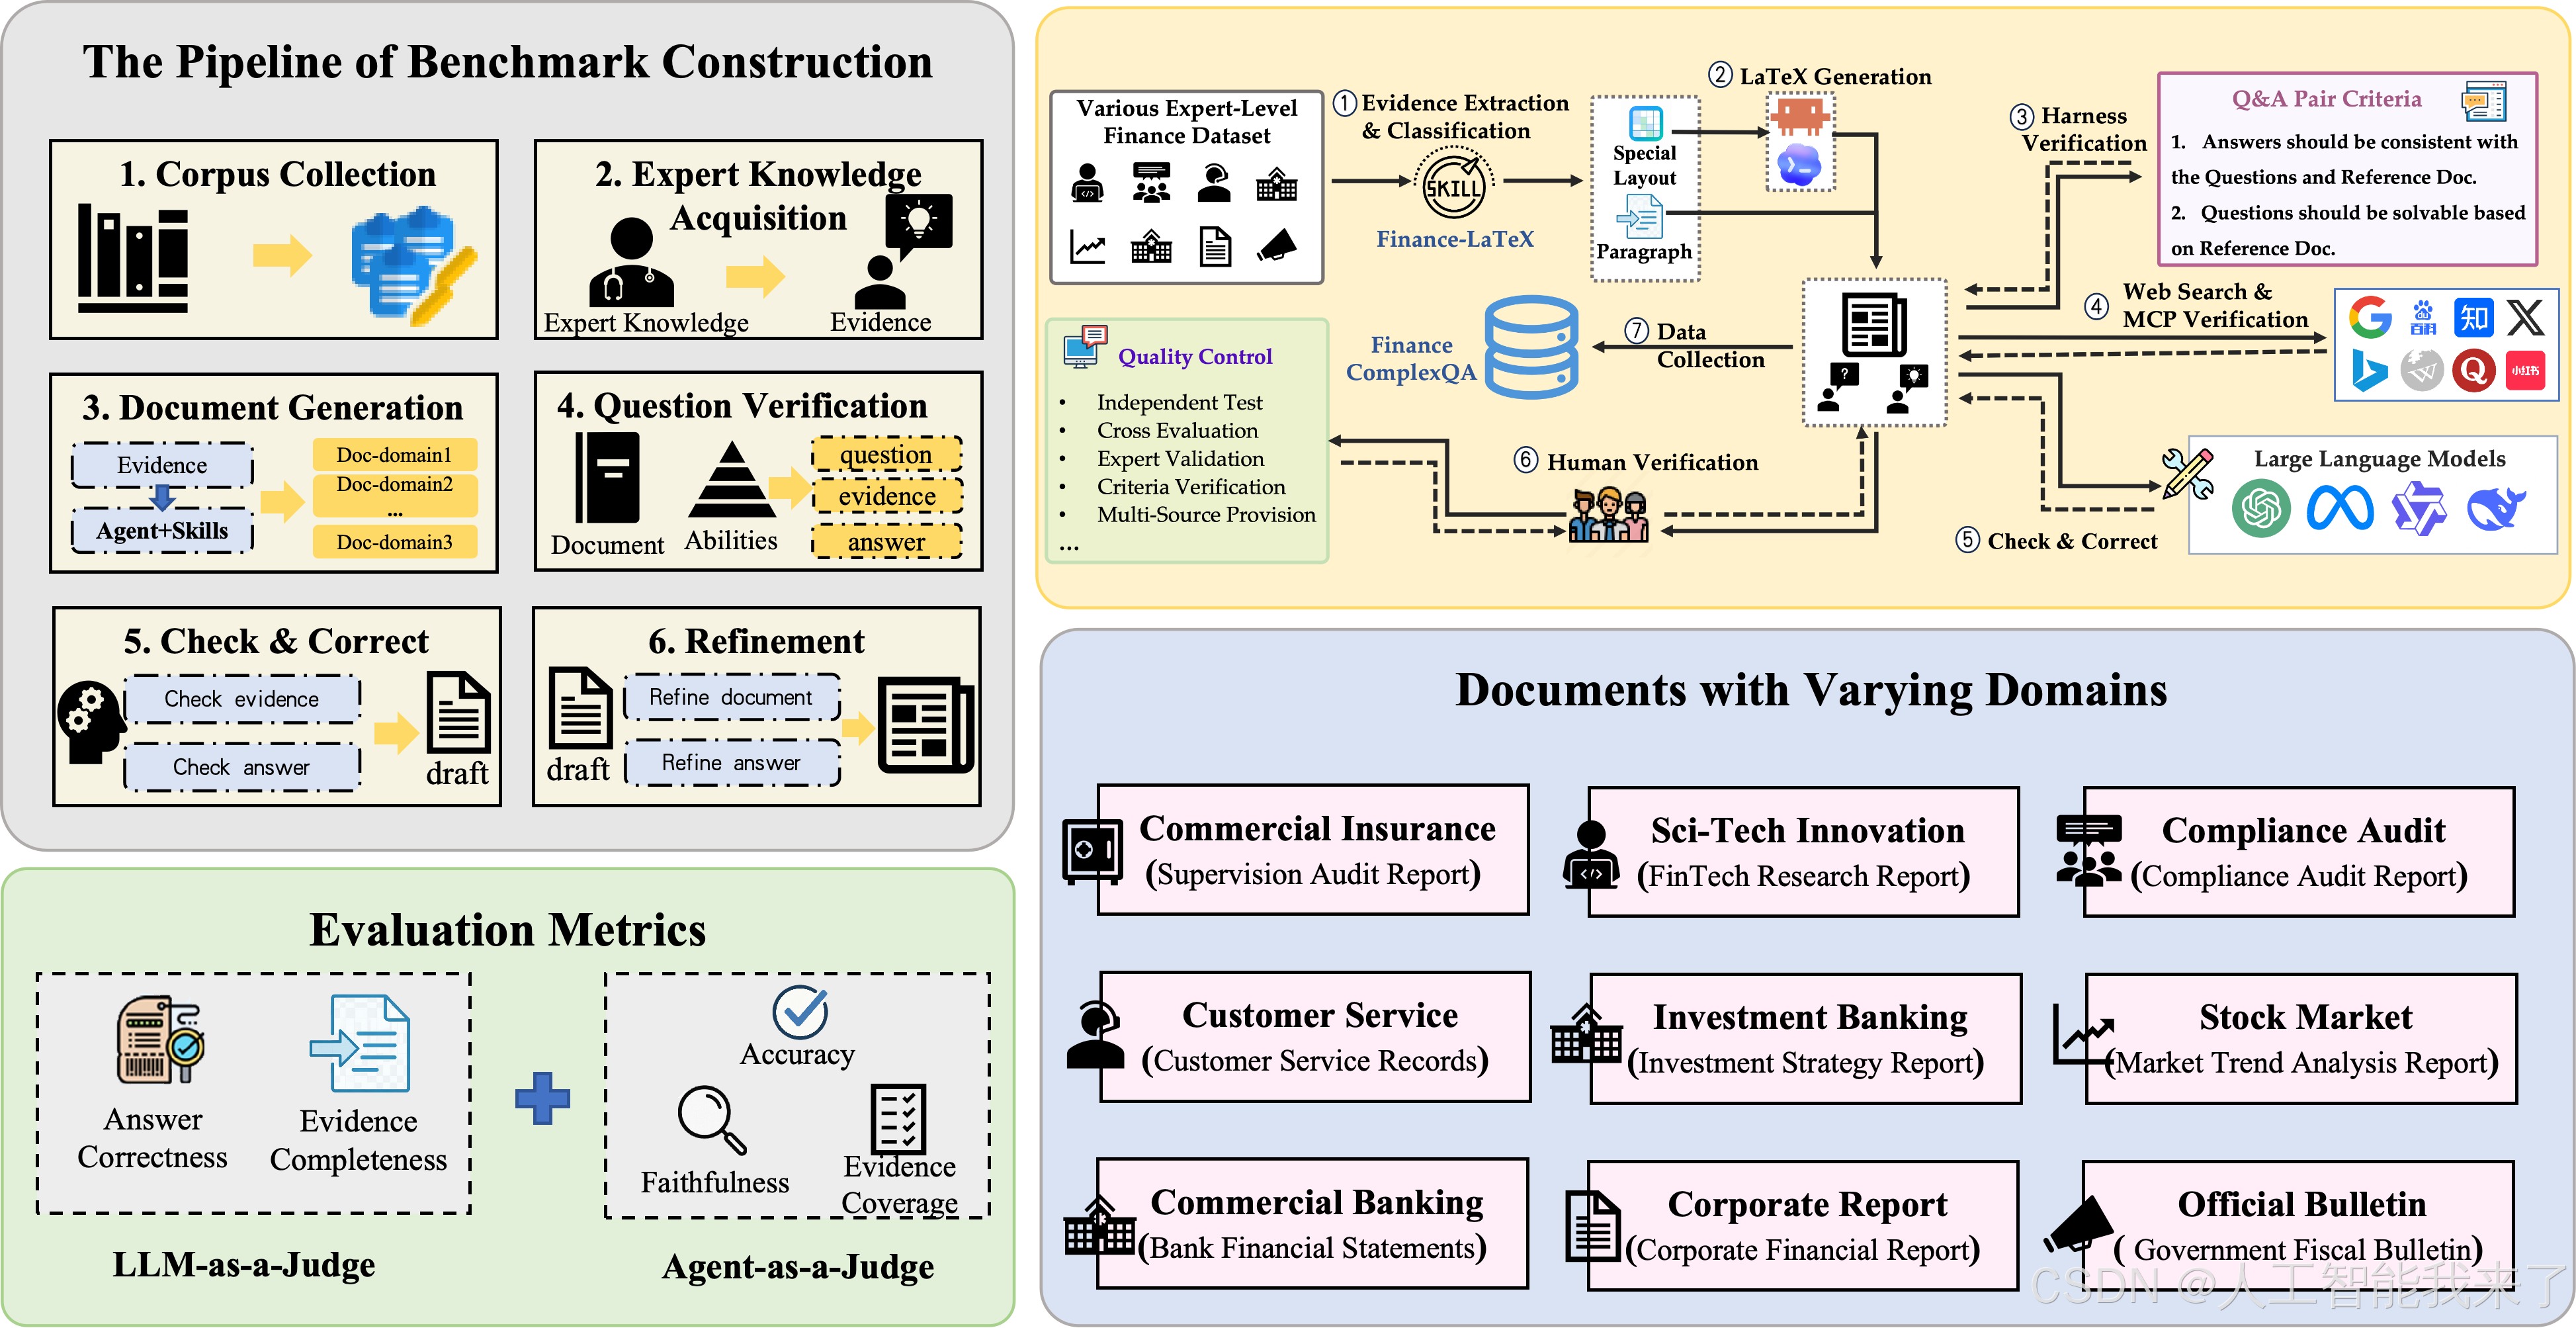
现有金融数据集素材多为简化文本片段,缺少真实研报分层章节、多行列财务表、图表附注、脚注等复杂版式。Finance-LaTeX采用多智能体协同,从专家知识库出发生成结构化LaTeX财务文档,并配套可验证问答对,产出数据可用于模型消融实验与基准扩充。
2.2 专家证据规划阶段
- 智能体选定金融细分领域、文档类型、受众定位;
- 梳理稳定行业知识、会计规则、财务指标关系,过滤时效性极强动态信息;
- 预规划证据分布:哪些数据放正文段落、哪些存入多列表格、图表附注补充约束,同时标记每条证据对应的推理任务(数值对比/多跳推导/行业总结)。
2.3 版式感知LaTeX文档生成
不生成纯文本,输出完整LaTeX分层文档,包含:章节、正文、多行财务表、柱状/折线图说明、注释脚注、单位/时间限定。
核心约束:表格单元格绑定行标题、列周期、计量单位,制造跨版式推理需求——例如营收描述在段落、年度数据在表格、同比约束在图表附注,回答问题必须整合三类素材。
2.4 问答对生成与三重校验
- 根据预规划证据自动生成问题、标准解析流程、完整参考回答;
- 三重校验机制:
- LLM逻辑校验:核算推导步骤、行业逻辑自洽;
- 工具核验:调用计算器、公开行业知识库验证数值;
- 可复现测试:使用生成文档重新作答,确保仅依靠文档即可推出答案;
无法通过校验的样本直接丢弃重生成。
2.5 质量管控与数据划分
文档层面:剔除表格表头丢失、公式错乱、财务逻辑矛盾文件;
问答层面:剔除单段文本即可作答、依赖实时行情、无完整推导的简单样本;
生成的2000份文档、6000条问答仅用于开发消融,不混入正式评测基准FinanceComplexQA。
3 FinanceComplexQA 基准完整架构
3.1 数据集整体规模
总文档1009份,问答2026道,中英文各1013题;
覆盖8大金融场景、9类分析任务,全部为工业级长财务报告,单文档平均16.33页。
场景分类统计
| 场景 | 中文问答数 | 英文问答数 |
|---|---|---|
| 企业财报(CF) | 163 | 253 |
| 投资研报(IS) | 246 | 276 |
| 市场趋势分析(MTA) | 91 | 192 |
| 金融科技报告(FR) | 134 | 157 |
| 客户业务记录(CSR) | 140 | - |
| 监管审计文档(SCA) | 100 | - |
| 政府财政公报(GF) | - | 135 |
任务分类
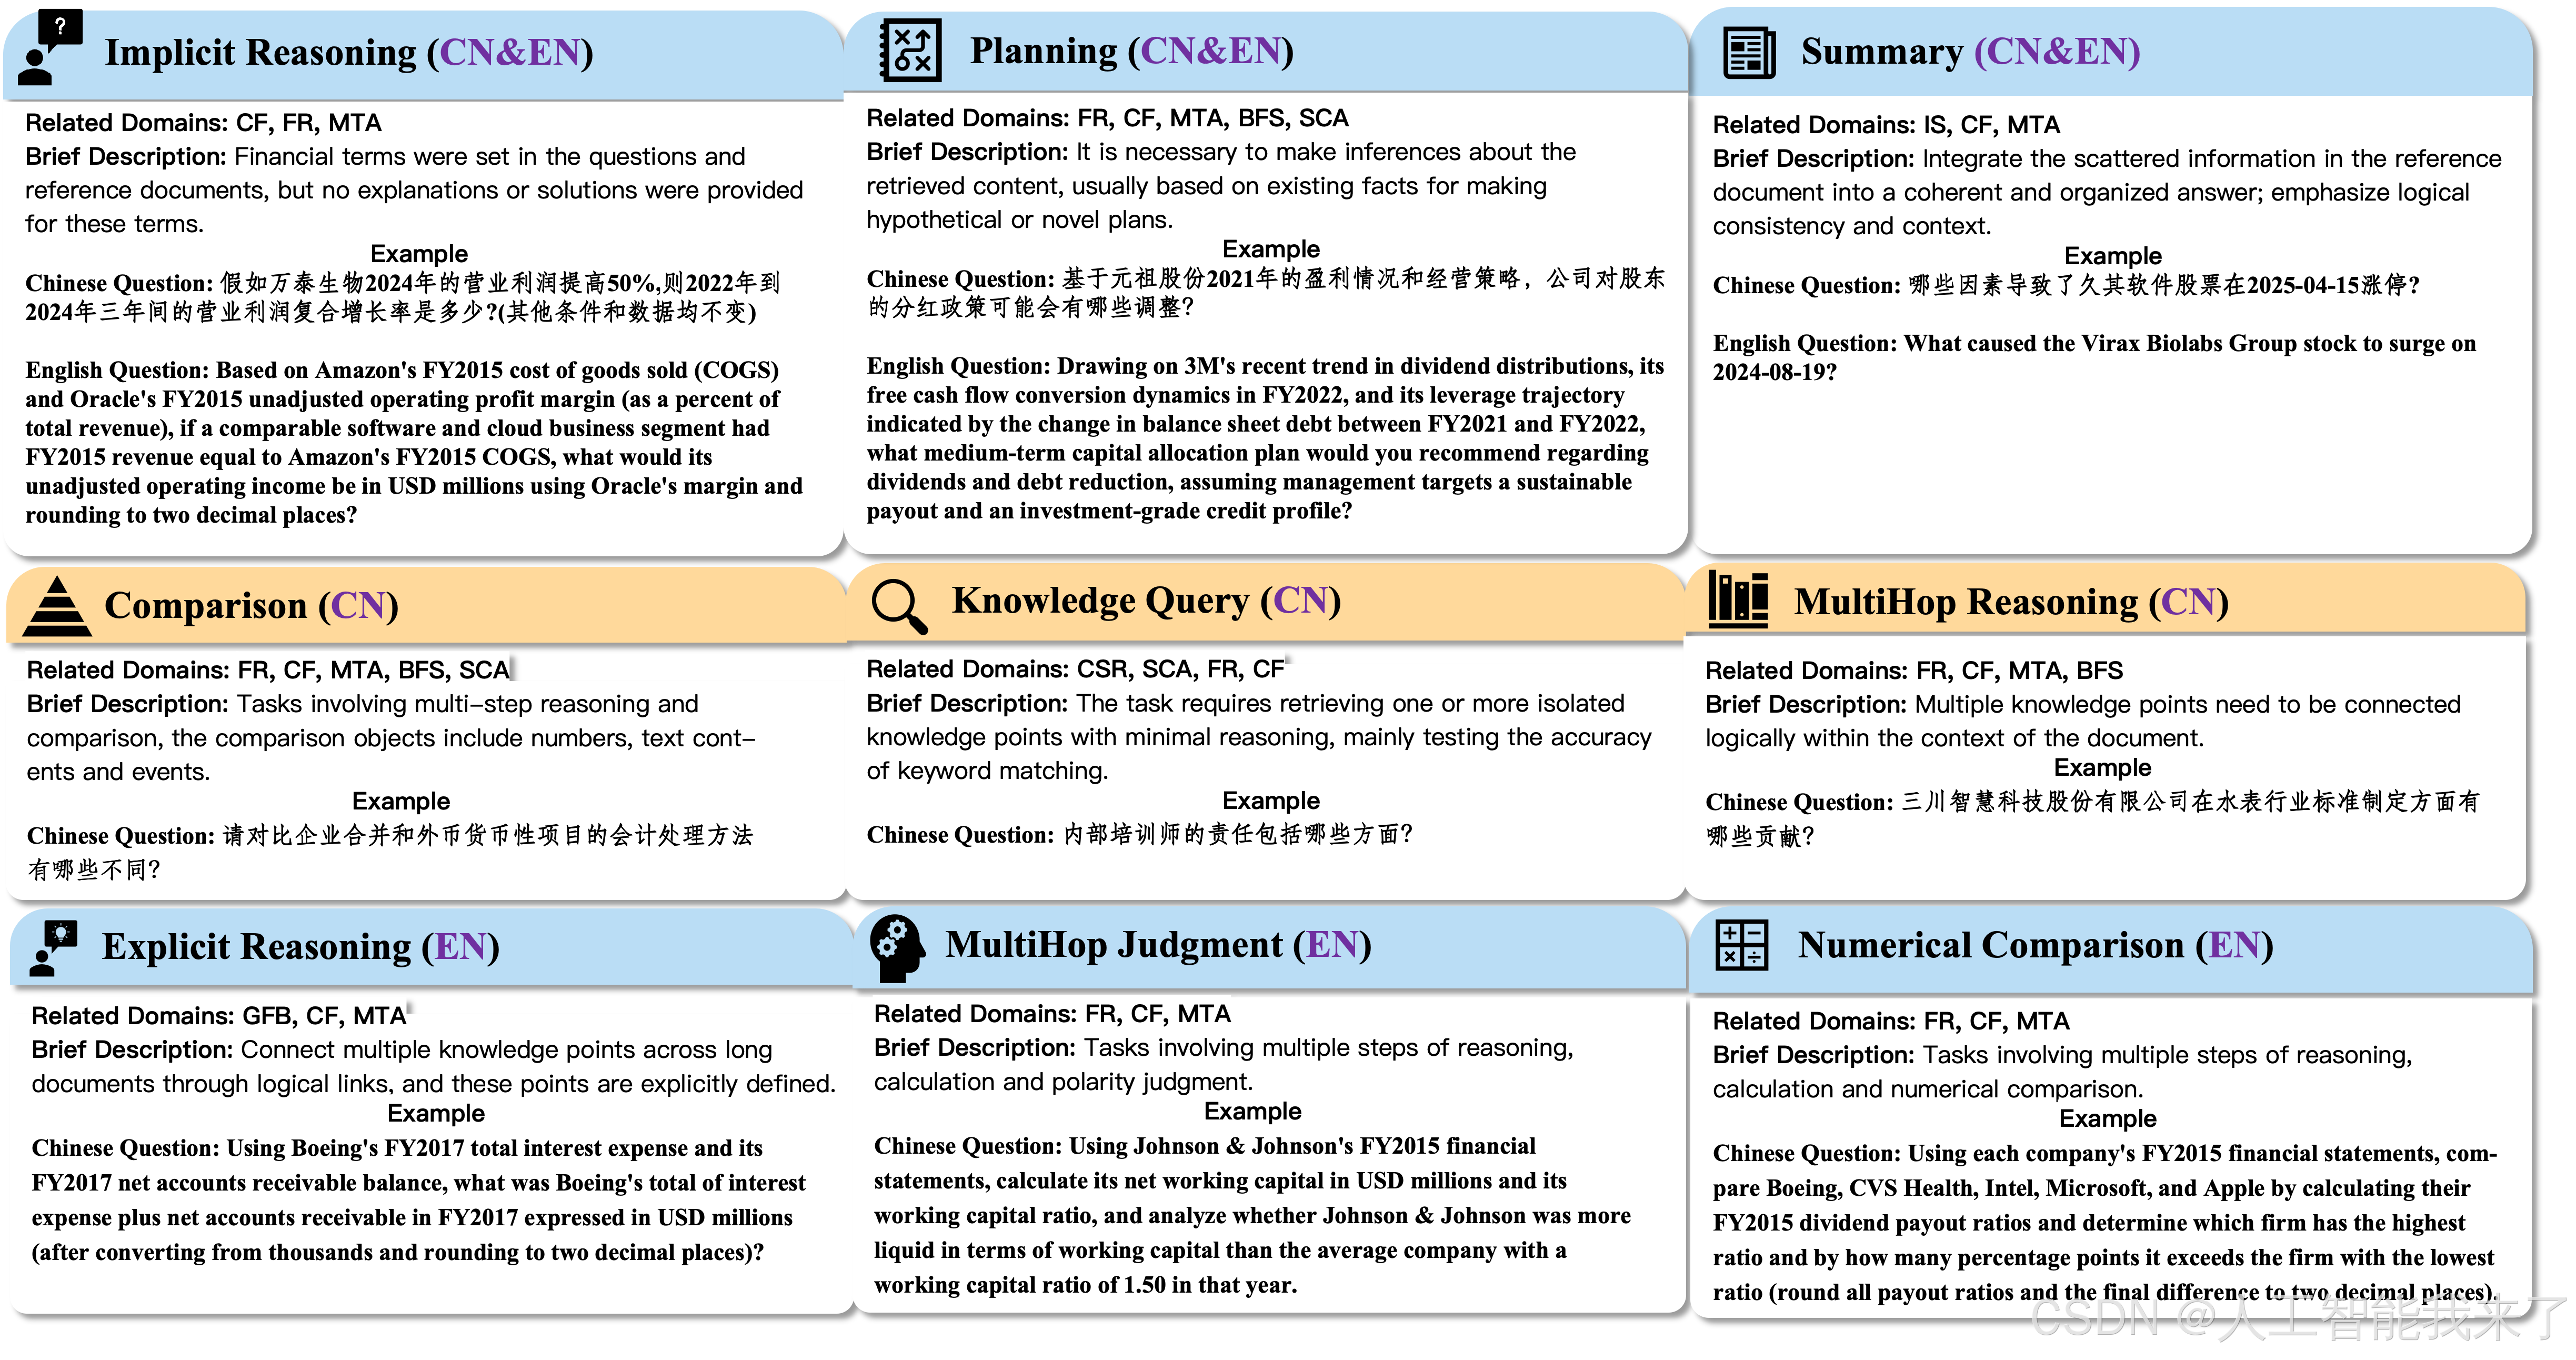
中文任务:对比、隐式推理、知识检索、多跳推导、总结、规划;
英文任务:数值对比、隐式推理、多跳判断、显式推导、总结、规划。
3.2 文档解析与证据单元体系
文档不拆分为纯文本块,保留完整层级结构:章节、段落、表格(行列标题/数值/单位)、图表说明、脚注。
每条证据单元绑定元数据:所属页面、位置、实体范围,系统评测时可判定模型是否遗漏表格、附注等关键跨版式证据。
3.3 双上下文推理核心设定
- 显性上下文:文档内段落、表格、图表原始素材;
- 隐性上下文:固定会计规则、行业周期性、财务指标换算等领域知识;
合格答案必须同时融合两类信息,仅摘抄文本会被判定不完整。
3.4 标准参考答案与智能体裁判评测
参考答案规范
不使用短句填空,完整包含:结论、全部支撑证据、数值计算过程、边界说明/风险提示。
多维度自动评测指标(智能体Judge)
- ACC准确率:最终结论与标准答案是否一致;
- 数值正确性:单位、周期、正负符号、计算公式无偏差;
- 证据覆盖率Cov:是否使用全部必要表格/段落证据;
- 事实保真FS:无文档外编造行业观点;
- 完整度ROUGE:推理链条无缺失步骤;
评测执行流程
输入:问题、模型回答、检索到的文档证据、标准参考;
输出五项标准化打分,同时记录token消耗、推理耗时用于成本评估。
4 大规模对照实验
4.1 参与系统与基座模型
三类主流金融智能体系:
- LightRAG:轻量化基础检索基线;
- PageIndex:保留完整页面表格结构的版式感知检索;
- Codex/Claude Code:工具调用规划式智能体;
基座闭源:GPT-5.4、GPT-5.5、Claude Sonnet 5、Qwen3.7-Plus;
基座开源:Qwen3.5-Flash、Qwen3.5-Plus、DeepSeek-v4-Flash。
4.2 核心实验结论
- 版式感知检索PageIndex全面优于普通分块LightRAG,证明表格、页面结构是金融推理关键;
- 规划式智能体(Codex/Claude Code)综合准确率最高,但token消耗、推理时长翻倍;
- 性能瓶颈统一集中三类场景:跨版式多跳数值计算、长文档证据全覆盖、行业综合规划总结;
- 不存在全能最优方案:检索类成本低但复杂推理失效,智能体推理强但算力开销极高,生产环境需按任务动态路由。
4.3 场景分层结果
- 投资研报、政府财政公报难度最高,各类系统平均分显著下降;
- 企业常规财报结构化表格丰富,基础检索即可取得中等效果;
- 监管审计文档依赖复杂规则解读,仅智能体可稳定完成完整分析。
4.4 典型五大失效模式
- 数值漂移:公式正确,但周期/单位/正负号出错;
- 证据遗漏:只引用单一段落,忽略配套财务表;
- 版式混淆:表格行列标题匹配错误;
- 过度推演:编造文档无支撑行业观点;
- 规划残缺:总结类回答缺失关键分析维度。
5 深度分析
5.1 人工评估校验
抽取各场景50道样本交由金融专业人工打分,人工与智能裁判打分皮尔相关系数0.89,证明自动评测可信度高;
长英文财政文档、复杂投资研报人工标注分歧更大,是当前基准最难子集。
5.2 基准难点根源
三重约束叠加:
- 长文档远距离证据分散;
- 表格+文本多源交叉数值计算;
- 专业会计规则隐性约束,仅摘抄文本无法完成合规分析。
5.3 对金融智能体设计启发
- 检索层必须保留完整表格层级结构,禁止扁平化文本切割;
- 推理阶段增加独立数值校验工具,单独核算指标;
- 规划任务强制证据覆盖自检步骤;
- 生产环境分级路由:简单知识查询用低成本RAG,复杂综合分析调用工具智能体。
5.4 消融拓展方向
- 移除表格版式元数据,量化结构带来性能衰减幅度;
- 关闭工具计算模块,测试纯LL数值推理缺陷;
- 单轮生成vs分步规划智能体性能对比。
6 相关工作
6.1 金融问答数据集
早期FinQA、ConvFinQA仅短片段单步计算;FinanceBench、DocFinQA拓展长文档但缺少跨版式综合任务;BizFinBench等侧重业务简答,无分析师级开放式调研任务。本文基准首次统一双语、跨版式、多跳综合分析完整评测体系。
6.2 RAG与工具智能体
传统RAG分块检索丢失表格结构;迭代Self-RAG、GraphRAG提升关联检索;Plan&Solve、ReAct类工具智能体支持分步规划,但缺少金融领域专用数值校验逻辑,本文实验量化各类方案在财务场景的适配差距。
7 结论
- 提出Finance-LaTeX流水线,可自动生成带复杂版式金融文档与可验证问答,用于模型迭代与数据集扩充;
- 构建FinanceComplexQA双语工业金融评测基准,覆盖8大场景9类深度分析任务,配套多维度智能裁判自动评测;
- 大规模实验证明版式感知检索、分步规划智能体是金融推理两大核心优化方向,现有模型普遍存在数值、跨证据、总结三大短板;
- 归纳五类高频金融推理失效模式,给出检索、智能体分层落地的工程优化思路。
局限性
- 不覆盖实时行情交易、量化预测类动态金融任务;
- 仅中英双语,未拓展小语种金融素材;
- 自动裁判存在微小评估偏差,关键实验仍需人工抽样复核;
- Finance-LaTeX生成合成数据仅用于开发消融,不替代真实财报基准。
附录
附录A Finance-LaTeX完整提示词模板
- 金融文档生成系统提示;
- 问答证据规划提示;
- 三重校验判定提示;
存放于开源仓库prompts/目录。
附录B 完整运行脚本
- 批量生成文档
gen_fin_latex.py; - 问答生成与校验
qa_generator.py; - FinanceComplexQA批量评测
bench_eval.py; - 指标统计可视化
metric_plot.py。
附录C 数据集全量统计表格
文档页数、文本长度、各场景/任务样本分布、中英文样本拆分原始数据表。
附录D 实验环境与超参
各LLM基座调用参数、PageIndex检索分块规则、智能体最大迭代轮次、token开销统计代码。
资源下载汇总
- 论文HTML原文:https://arxiv.org/html/2607.19238v1
- 论文PDF:https://arxiv.org/pdf/2607.19238
- FinanceComplexQA数据集、生成流水线代码、批量评测脚本、提示模板:论文配套开源GitHub仓库
- 部署文档:仓库README包含环境依赖、批量复现命令、裁判评测启动参数

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 16
 0
- 0


 已为社区贡献8条内容

所有评论(0)