为什么“算力够不够”成了最大难题?
一、算力到底在算什么?——先搞懂几个关键概念
1.1 算力不是只有一个数字
很多人以为“算力”就是显卡的FLOPS(每秒浮点运算次数)。但实际落地中,真正卡脖子的往往是三个东西:
| 算力维度 | 通俗解释 | 为什么重要 |
|---|---|---|
| 算力峰值(FLOPS) | 显卡每秒能做多少次运算 | 决定模型推理/训练的理论速度上限 |
| 显存容量(VRAM) | 显卡上能装下多少数据 | 模型放不放得下,会不会“爆显存” |
| 显存带宽(HBM带宽) | 显存和计算核心之间的“路有多宽” | 数据搬运够不够快,直接影响实际响应速度 |
一个容易被忽视的真相:很多场景下,显存带宽比纯算力更重要——推理是逐Token生成的,每一步都要反复读取模型权重,带宽不够,算力再强也等数据“堵在路上”。
1.2 训练 vs 推理:算力需求完全不同
很多人容易把训练和推理混为一谈,但二者的算力逻辑天差地别:
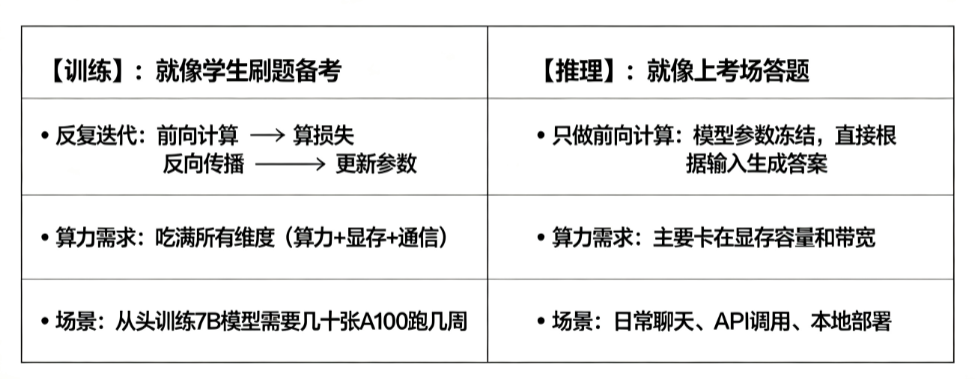
对大多数开发者来说,打交道最多的是“推理” ——你不需要从头训练模型,只需要把现成的模型跑起来。
二、怎么判断模型的算力需求?——三个核心公式
2.1 参数量 → 显存需求(最简单也最重要)
模型参数量直接决定你需要多少显存。一个粗略但好记的公式:
显存需求 ≈ 参数量 × (2~4) GB
为什么是2~4倍?因为精度不同:
| 精度 | 每个参数占多少 | 7B模型需要多少显存 | 适用场景 |
|---|---|---|---|
| FP32(32位浮点) | 4字节 | ~28 GB | 追求极致精度 |
| FP16(16位浮点) | 2字节 | ~14 GB | 大部分推理场景 |
| INT8(8位量化) | 1字节 | ~7 GB | 资源受限场景 |
| INT4(4位量化) | 0.5字节 | ~3.5 GB | 边缘设备部署 |
实战参考:70亿参数的模型在FP16精度下需要约14GB显存,单张RTX 4090(24GB)可以流畅运行;如果部署130亿以上模型,通常需要多卡并行。
选型建议:先确认手头显卡的显存容量,再反推能跑多大的模型。
2.2 吞吐量公式:你的业务需要多少算力
如果业务有明确的并发和响应时间要求,可以用下面这个框架估算(参考Azure的PTU容量计算逻辑):
输入TPM = 峰值RPM × 平均提示Token数
输出TPM = 峰值RPM × 平均响应Token数
归一化TPM = 输入TPM + (输出/输入比例) × 输出TPM
把抽象公式变具体:假设你的应用每分钟有1000次请求,每次请求平均输入200个Token、输出20个Token,用某个模型(输出Token算作8个输入Token的消耗):
-
输入TPM = 1000 × 200 = 200,000
-
输出TPM = 1000 × 20 = 20,000
-
归一化TPM = 200,000 + 8 × 20,000 = 360,000
有了归一化TPM,再对照硬件规格,就能估算出需要多少算力资源。
2.3 黄金指标:找到你的“第一块短板”
中国移动联合合作伙伴在2025年提出了智算推理集群运营黄金标准,核心思路很实用:
在保障用户体验的前提下,找到最先触达性能瓶颈的硬件指标——那就是你的“黄金指标”。
不同场景下的瓶颈完全不同:
| 模型类型 | 可能的瓶颈指标 |
|---|---|
| MoE稀疏大模型(如DeepSeek-R1) | 算力利用率 |
| 稠密大语言模型(如Qwen3-32B) | 显存利用率 |
| 多模态理解模型(如Qwen2.5-VL-72B) | 显存带宽利用率 |
| 多模态生成模型(如Stable Diffusion) | KV Cache利用率 |
实操建议:部署后不要只看“有没有跑起来”,而是监控这四个指标,找到最先卡住的那一个,针对性地优化。
三、怎么评估自己的硬件够不够?——实战速查表
3.1 不同场景的硬件选型参考
根据业务场景和硬件预算,大致可以分成三档:
| 场景 | 推荐模型规模 | 硬件要求 | 典型卡型 |
|---|---|---|---|
| 边缘/轻量场景(毫秒级响应、简单分类) | 1.3B-7B(量化版) | 显存 < 8GB | RTX 3060、国产边缘NPU |
| 企业级服务器(中等复杂度、中等并发) | 7B-13B(FP16/INT8) | 显存 16-32GB | RTX 4090、A10G、昇腾910B |
| 超算/云原生(复杂推理、高并发) | 70B+(需多卡并行) | 多卡集群 | A100/H100、昇腾集群 |
3.2 国产算力的选择
如果涉及到信创要求或数据不出境的需求,国产算力也在快速适配主流开源模型:
-
华为昇腾:已适配DeepSeek、Qwen等主流模型,昇腾910B单卡32GB显存可支撑7B-13B模型推理
-
海光DCU:部分场景下可对标英伟达生态
建议:信创要求高的场景,在选型阶段就把国产GPU对目标模型的适配情况和实测性能纳入验证。
四、VSCode实战:动手评估你的模型选型
4.1 显存需求估算器
def estimate_vram(model_size_b, precision="FP16", kv_cache_tokens=0):
    """
    估算模型部署所需的显存
    model_size_b: 模型参数量(单位:B,如7表示70亿)
    precision: 精度类型 (FP32/FP16/INT8/INT4)
    kv_cache_tokens: KV Cache占用的Token数(多轮对话场景)
    """
    # 每个参数占用的字节数
    bytes_per_param = {
        "FP32": 4,
        "FP16": 2,
        "INT8": 1,
        "INT4": 0.5
    }

    # 模型权重显存
    weight_vram = model_size_b * 1e9 * bytes_per_param[precision] / (1024**3)  # 转为GB

    # KV Cache显存估算(粗略:每1K Token约占用2GB,随模型增大而增加)
    kv_vram = (kv_cache_tokens / 1000) * 2 * (model_size_b / 7)

    # 额外开销(激活值、框架开销等,约20%)
    overhead = (weight_vram + kv_vram) * 0.2

    total = weight_vram + kv_vram + overhead

    return {
        "weight_vram_gb": round(weight_vram, 2),
        "kv_cache_vram_gb": round(kv_vram, 2),
        "overhead_gb": round(overhead, 2),
        "total_vram_gb": round(total, 2)
    }

# 测试不同场景
models = [
    {"name": "Qwen2.5-7B (FP16)", "size": 7, "precision": "FP16", "kv": 2048},
    {"name": "DeepSeek-V3-671B (INT8)", "size": 671, "precision": "INT8", "kv": 4096},
    {"name": "Llama-3-8B (INT4)", "size": 8, "precision": "INT4", "kv": 1024},
    {"name": "Qwen2.5-72B (FP16)", "size": 72, "precision": "FP16", "kv": 2048},
]

print("📊 模型显存需求估算")
print("-" * 60)
for m in models:
    result = estimate_vram(m["size"], m["precision"], m["kv"])
    print(f"{m['name']}")
    print(f"  权重占用: {result['weight_vram_gb']} GB")
    print(f"  KV Cache: {result['kv_cache_vram_gb']} GB")
    print(f"  总需求: {result['total_vram_gb']} GB")
    print(f"  推荐配置: {'单卡24GB+' if result['total_vram_gb'] < 24 else '多卡或专业卡'}")
    print()
运行结果示例:
📊 模型显存需求估算
------------------------------------------------------------
Qwen2.5-7B (FP16)
  权重占用: 13.04 GB
  KV Cache: 0.82 GB
  总需求: 16.63 GB
  推荐配置: 单卡24GB+

DeepSeek-V3-671B (INT8)
  权重占用: 625.19 GB
  KV Cache: 1.83 GB
  总需求: 752.43 GB
  推荐配置: 多卡或专业卡

Llama-3-8B (INT4)
  权重占用: 3.73 GB
  KV Cache: 0.23 GB
  总需求: 4.75 GB
  推荐配置: 单卡24GB+

Qwen2.5-72B (FP16)
  权重占用: 134.12 GB
  KV Cache: 3.66 GB
  总需求: 165.34 GB
  推荐配置: 多卡或专业卡
4.2 选型决策助手
def recommend_model(scenario, max_vram_gb, max_latency_ms, data_scale):
    """
    根据场景和硬件约束推荐模型
    """
    recommendations = []

    # 规则引擎
    if scenario in ["智能客服", "文档分类", "意图识别"]:
        if max_vram_gb >= 16:
            recommendations.append(("7B-13B模型(如Qwen2.5-7B)", "精度高,资源可控"))
        else:
            recommendations.append(("1.3B-3B蒸馏版", "轻量部署,响应快"))

    if scenario in ["代码生成", "法律文书分析", "复杂推理"]:
        if max_vram_gb >= 32:
            recommendations.append(("13B-70B模型", "处理复杂逻辑能力强"))
        else:
            recommendations.append(("7B模型 + RAG增强", "用外部知识弥补模型能力"))

    if scenario in ["实时翻译", "对话机器人"]:
        if max_latency_ms < 500:
            recommendations.append(("3B以下量化模型", "保证毫秒级响应"))
        else:
            recommendations.append(("7B模型 + TensorRT-LLM优化", "平衡精度和速度"))

    if data_scale > 1000000:  # 百万级数据
        recommendations.append(("13B以上模型", "数据量大,需要更强的泛化能力"))

    return recommendations

# 示例
result = recommend_model(
    scenario="代码生成",
    max_vram_gb=24,
    max_latency_ms=1000,
    data_scale=500000
)

print("🔧 推荐方案:")
for model, reason in result:
    print(f"  • {model} ({reason})")
4.3 推理引擎选择建议
模型选好了,还需要推理引擎把它跑起来:
| 推理引擎 | 定位 | 适合场景 |
|---|---|---|
| Ollama | 最简单,上手快 | 本地测试、小模型验证 |
| vLLM | 高吞吐、低延迟 | 生产级高并发场景 |
| llama.cpp | CPU友好、轻量 | 边缘设备、无GPU环境 |
建议:如果是企业内部生产环境,优先选vLLM——它在并发和显存利用上做了深度优化。
五、高质量算力的六个标准
中国信息通信研究院和浪潮信息联合发布的《人工智能算力高质量发展评估体系报告》,提出了“三高三可”六大特征:
| 特征 | 含义 |
|---|---|
| 高算效 | 理论算效 + 实测性能 + 资源利用率 |
| 高智效 | 面向AI业务的处理效率(模算效率) |
| 高碳效 | 全生命周期能耗管理 |
| 可持续 | 技术兼容、供应链完备、生态开放 |
| 可获得 | 普适普惠、成本可控 |
| 可评估 | 有完整评估体系可度量 |
一个扎心的现实:当前算力集群实测性能和理论性能差距过大,部分算力实际性能不足理论性能的10%,GPU平均利用率低于30%。
六、一张表看懂AI算力选型
| 维度 | 核心要点 |
|---|---|
| 算力不只是FLOPS | 显存容量和带宽往往是真正的瓶颈 |
| 训练 vs 推理 | 训练吃所有资源,推理主要卡在显存和带宽 |
| 显存估算 | 参数量 × (2~4) GB(取决于精度) |
| 黄金指标 | 先找到你的瓶颈(算力/显存/带宽/KV Cache) |
| 模型选型原则 | 不是越大越好,匹配业务需求才是关键 |
| 推理引擎 | 生产用vLLM,测试用Ollama,边缘用llama.cpp |
小编建议
-
先算显存再选卡:用上面的估算公式,算出模型需要多少显存,再倒推硬件
-
优先考虑量化版本:INT8量化能省一半显存,精度损失通常可接受
-
不要忽略带宽:推理时显存带宽比算力峰值更关键,买卡时多看HBM带宽参数
-
小规模POC验证:先用蒸馏版或量化版跑通业务逻辑,再决定是否上大模型
-
关注国产算力进展:如果涉及信创要求,昇腾、海光DCU已经在快速适配主流模型

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 10
 0
- 0


 已为社区贡献1条内容

所有评论(0)