GEPA:让 LLM 用“反思”进化提示词,样本效率甚至超过强化学习
一、一句话概述
GEPA 提出了一种面向 LLM workflow 和 agent 的提示词优化方法:它不更新模型权重,而是让模型阅读自己的执行轨迹、错误反馈和评分结果,用自然语言反思出新的 prompt,并通过 Pareto frontier 保留多条有潜力的进化路线。
论文最核心的结论是:在 6 个任务上,GEPA 在 Qwen3-8B 上平均比 GRPO 高 6%,最多高 20%,同时 rollout 数量最多少 35 倍;在 GPT-4.1 Mini 上,它也明显超过 MIPROv2、TextGrad 和 Trace 等 prompt optimizer。
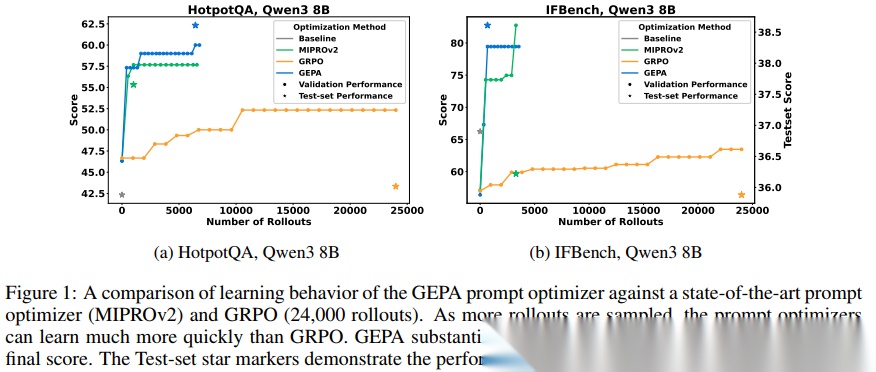
GEPA rollout 学习曲线
图1:GEPA 在 HotpotQA 和 IFBench 上用更少 rollouts 快速提升分数。橙色 GRPO 需要 24,000 次 rollout,蓝色 GEPA 在早期就明显超过基线和 MIPROv2。
二、研究背景与动机
今天很多 AI 应用已经不是“单次问答”了,而是由多个 LLM module、检索器、代码执行器、工具调用和控制流组成的 compound AI system。比如一个多跳问答系统可能先生成检索 query,再总结证据,再继续第二跳检索,最后合成答案。每个模块都有自己的 prompt,也会产生中间推理、工具调用和环境反馈。
传统做法之一是 RLVR,也就是 Reinforcement Learning with Verifiable Rewards。像 GRPO 这类方法会把一次完整 rollout 的最终成功与失败压缩成标量 reward,再用它更新模型权重。这个思路很强,但也有两个现实门槛:第一,训练常常需要成千上万甚至更多 rollouts;第二,很多真实工作流调用工具很贵,甚至闭源大模型根本不能更新权重。
GEPA 的观察很朴素,但很关键:LLM 系统的 rollout 本身往往就是自然语言。系统 prompt、chain-of-thought、工具调用、编译错误、单元测试失败原因、评分 rubrics,这些信息在进入 RL 算法前可能被压缩成一个 0/1 或小数 reward,但对 LLM 来说,它们其实是可读、可解释、可归因的学习材料。
所以论文提出一个问题:既然语言模型擅长理解语言,为什么不直接让它从这些语言轨迹里学习规则,而一定要把 rich feedback 压成稀疏 reward 再做 policy gradient?
这就是 GEPA 的出发点。它把“优化 prompt”看成一个进化过程:每次从候选 prompt 中挑出一个或两个,根据 rollout 和反馈生成新 prompt;如果新 prompt 在 minibatch 上表现更好,就加入候选池;整个过程中不只追逐全局最高分,而是保留在不同样本上各自表现最好的候选,从而避免早早陷入局部最优。
三、核心方法详解
3.1 问题形式:优化 workflow 里的 prompt,而不是模型权重
论文把一个 compound AI system 记作 Φ = (M, C, X, Y)。其中 M 是多个语言模块,C 是控制流,X/Y 是输入输出 schema。每个模块 Mi 包含 prompt πi、模型权重 θi、输入 schema 和输出 schema。
GEPA 的优化目标是提升系统整体指标 μ,比如 exact match、F1、pass rate 或人工 rubric 分数。但和 GRPO 不同的是,GEPA 固定模型权重 Θ,只优化 prompt 集合 Π。换句话说,它更像一个“可解释的 workflow prompt compiler”,不是一个权重微调器。
3.2 总流程:反思变异 + 小批量验证 + 候选池进化
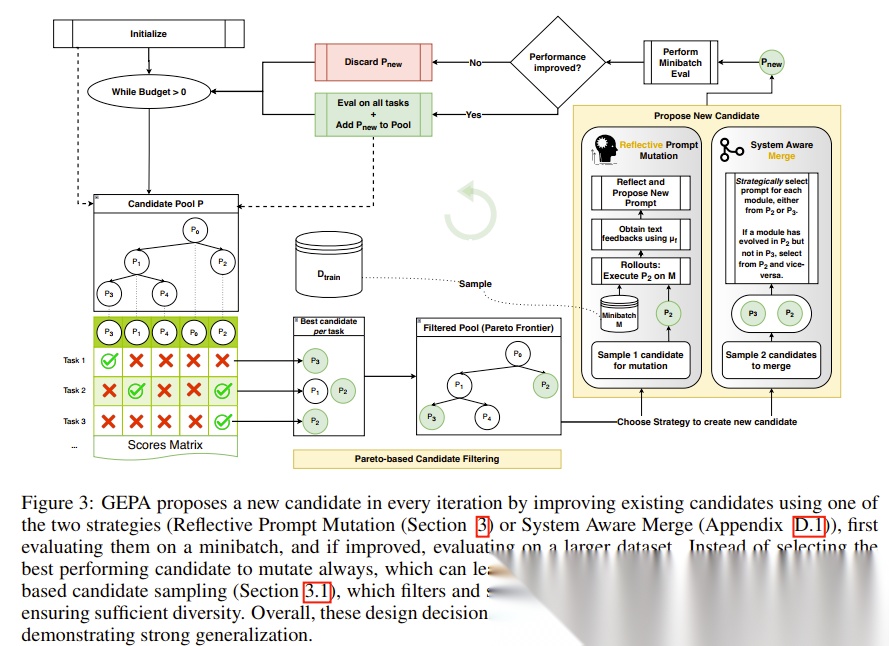
GEPA 总体流程
图2:GEPA 每轮从候选池中选择 prompt,执行 rollout,收集文本反馈,再通过 reflective prompt mutation 或 system-aware merge 产生新候选。
GEPA 的主循环可以拆成 5 步:
🧩 第一步:初始化候选池
候选池 P 最开始只有一个 base system,也就是人工或默认 prompt 组成的原始工作流。
🧩 第二步:选择候选和模块
GEPA 会从当前候选池中挑一个候选系统,再选择其中一个语言模块进行更新。论文实现里模块选择采用 round-robin 策略,保证不同模块都有机会被优化。
🧩 第三步:执行 minibatch rollouts
系统在训练集的一个小批量上运行。GEPA 不只记录最终分数,还记录每个模块的输入、输出、推理轨迹、工具结果和评价器反馈。
🧩 第四步:反思并改写 prompt
一个 reflection LM 会看到当前 prompt、执行轨迹、分数和 feedback text,然后判断失败或成功可能来自哪些 prompt 规则,并提出新的 prompt。
🧩 第五步:只保留有效改动
新 prompt 先在 minibatch 上和父候选比较。如果分数提升,GEPA 才把它加入候选池,并在 Dpareto 上记录每个样本的得分,用于后续选择。
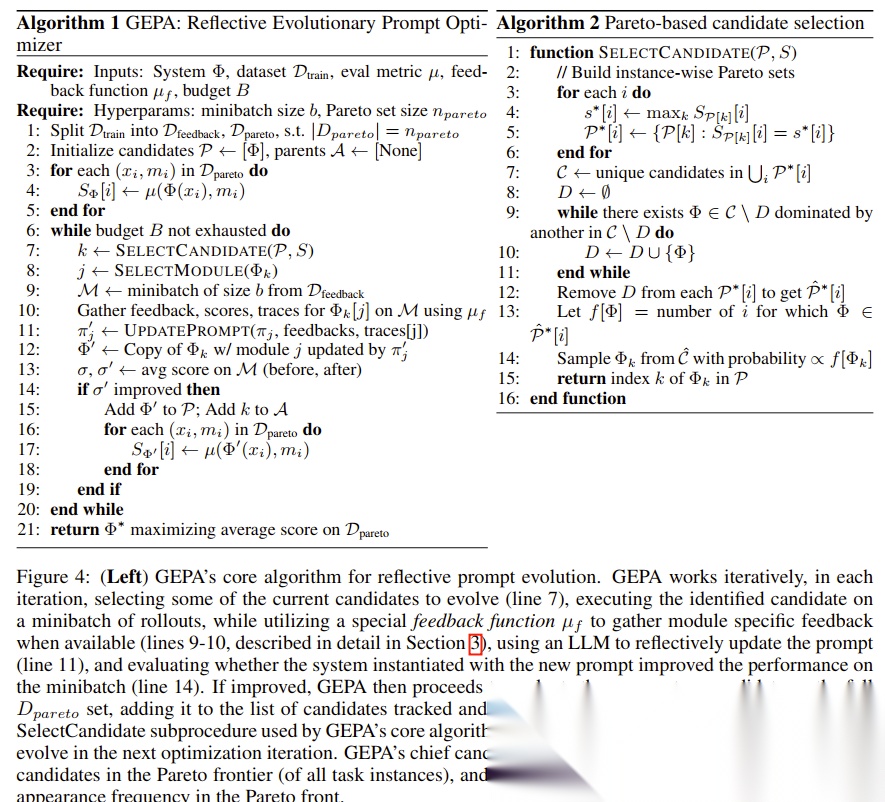
GEPA 算法伪代码
图3:左侧是 GEPA 主算法,右侧是 Pareto-based candidate selection。核心是记录每个候选在各个实例上的表现,而不是只看平均分。
3.3 反思变异:把“失败原因”变成“任务规则”
GEPA 最有意思的部分是 reflective prompt mutation。它不是简单让模型说“请优化这个 prompt”,而是把 rollout 过程里的语言证据作为诊断材料。
例如在代码任务里,环境可能先输出编译错误、运行错误、性能 profiling,再给出最终 reward。如果只看 reward,模型只知道“失败了”;如果看 evaluation trace,它能知道是 include 缺失、张量维度不匹配、CUDA kernel 边界条件错误,还是性能没有超过 baseline。
这种反馈对 prompt 优化非常有价值。GEPA 会把这些诊断信息提炼成高层规则,写回 prompt。它学到的不是某个样本的答案,而是“遇到这类输入时应该采用什么策略”。
GEPA 优化后的 prompt 示例
图4:HotpotQA 多跳问答中,GEPA 把原本一句话的 second-hop query prompt 扩展成带有任务理解、常见失败模式和操作策略的详细指令。
这个例子非常直观。种子 prompt 只有一句:“给定 question 和 summary_1,生成 query。”GEPA 优化后则明确告诉模型:第一跳文档通常只覆盖一个实体;第二跳要寻找与 summary 相关但未被第一跳覆盖的 broader entity 或 missing piece;不要只是改写原问题,也不要重复 summary 中已经有的信息。
这类 prompt 更像“从 trial and error 中总结出的工作指南”。它既不是 few-shot demo,也不是模型权重里的隐式参数,而是人类可读的策略记忆。
3.4 Pareto 选择:不要只盯着平均分最高的候选
如果每一轮都选择当前平均分最高的 prompt 来继续优化,搜索很容易卡住。一个 prompt 可能在大部分样本上不错,但它代表的是单一策略;继续沿这条路线微调,收益会迅速变小。
GEPA 的做法是维护 instance-wise Pareto frontier:对每个训练样本,记录哪些候选拿到了该样本的最高分。只要一个候选在某些样本上是“赢家”,它就值得被保留。后续采样时,GEPA 按候选在多少样本上领先来加权抽样。
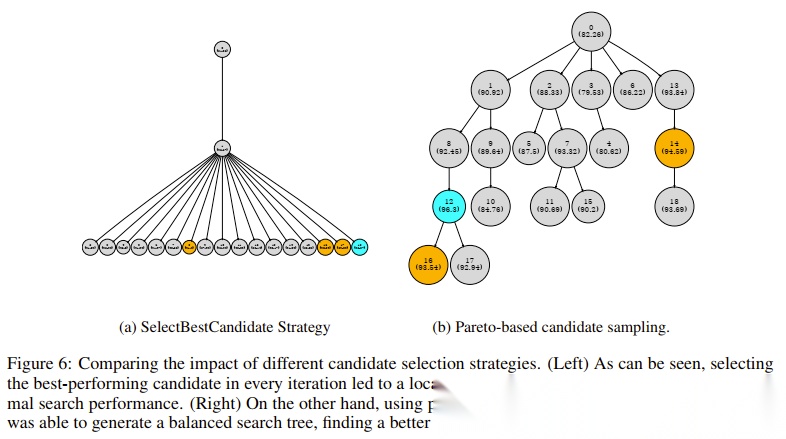
Pareto 选择与贪心选择对比
图5:左侧 SelectBestCandidate 很快集中到一条路线并停滞;右侧 Pareto-based sampling 能保留更多分支,在同等预算下找到更高分候选。
这个设计的意义在于,它把 prompt 搜索从“爬一座山”变成“保留多个局部专长”。某个候选可能不一定平均分最高,但它解决了另一批样本上的关键失败模式。最终这些互补策略可以通过后续变异或 Merge 被整合进更稳健的 prompt。
3.5 System-aware Merge:把不同进化分支的优势拼起来
GEPA+Merge 进一步引入 system-aware crossover。对于多模块工作流,不同候选可能分别优化了不同模块,比如一个候选改好了检索 query 生成器,另一个候选改好了最终 answer synthesizer。
Merge 的思路是:比较两个候选在不同模块上的演化历史,尽量从各自更有贡献的分支中选择模块 prompt,合成新的候选系统。论文结果显示,这个策略在 GPT-4.1 Mini 上尤其有效,但在 Qwen3-8B 上并非总是提升,说明 mutation 和 merge 的预算分配仍需要更细的自适应策略。
四、数据集与任务设置
论文在 6 类任务上评估 GEPA:
📊 HotpotQA:多跳问答,需要检索和组合多个证据。
📊 HoVer:retrieval-augmented verification,需要判断 claim 是否被证据支持。
📊 IFBench:instruction following,测试模型遵循复杂约束的能力。
📊 PUPA:privacy-aware delegation,把用户私有请求改写成可发给外部 LLM 的隐私保护请求。
📊 AIME-2025:数学竞赛题。
📊 LiveBench-Math:数学推理任务。
模型设置包括开源的 Qwen3-8B 和闭源的 GPT-4.1 Mini。对比方法包括 GRPO、MIPROv2、Trace/OptoPrime、TextGrad,以及 MIPROv2-No-Demos 等变体。
比较时需要注意一个细节:GEPA 和 MIPROv2 是 prompt optimization 方法,GRPO 是 weight-space RL 方法。论文的公平性来自统一用 rollout budget 和最终测试集表现衡量系统适应能力,而不是要求它们更新同一种参数。
五、实验与评估
5.1 Qwen3-8B:GEPA 用少得多的 rollout 超过 GRPO
| 方法 | HotpotQA | IFBench | HoVer | PUPA | AIME-2025 | LiveBench-Math | Aggregate | Improvement |
|---|---|---|---|---|---|---|---|---|
| Baseline | 42.33 | 36.90 | 35.33 | 80.82 | 27.33 | 48.70 | 45.23 | - |
| GRPO | 43.33 | 35.88 | 38.67 | 86.66 | 38.00 | 51.26 | 48.91 | +3.68 |
| MIPROv2 | 55.33 | 36.22 | 47.33 | 81.55 | 20.00 | 46.60 | 47.84 | +2.61 |
| GEPA | 62.33 | 38.61 | 52.33 | 91.85 | 32.00 | 51.95 | 54.85 | +9.62 |
| GEPA+Merge | 64.33 | 28.23 | 51.67 | 86.26 | 32.00 | 51.95 | 52.40 | +7.17 |
表1:Qwen3-8B 主结果。GEPA 在 5/6 个任务上超过 GRPO,aggregate improvement 达 +9.62。AIME-2025 是例外,GRPO 的 38.00 高于 GEPA 的 32.00。
样本效率是这里最值得关注的点。GRPO 每个任务使用 24,000 rollouts;GEPA/GEPA+Merge 的总优化预算平均约 3,936 rollouts,不同任务从 1,839 到 7,051 不等。论文进一步指出,如果只看 train rollouts,GEPA 到达最优测试表现只需要 79 到 737 次 train rollouts。
这说明 GEPA 的收益不是“多试几次 prompt”这么简单。它真正利用的是每次 rollout 中的自然语言轨迹,把单次失败转化成可迁移的指令规则。
5.2 GPT-4.1 Mini:闭源模型也能直接受益
| 方法 | HotpotQA | IFBench | HoVer | PUPA | AIME-2025 | LiveBench-Math | Aggregate | Improvement |
|---|---|---|---|---|---|---|---|---|
| Baseline | 38.00 | 47.79 | 46.33 | 78.57 | 49.33 | 58.20 | 53.03 | - |
| Trace (OptoPrime) | 60.33 | 51.19 | 46.00 | 74.18 | 45.33 | 60.74 | 56.30 | +3.27 |
| MIPROv2 | 58.00 | 49.15 | 48.33 | 83.37 | 51.33 | 61.84 | 58.67 | +5.64 |
| TextGrad | 62.33 | 48.64 | 47.67 | 85.68 | 46.67 | 63.84 | 59.14 | +6.11 |
| GEPA | 69.00 | 52.72 | 51.67 | 94.47 | 59.33 | 64.13 | 65.22 | +12.19 |
| GEPA+Merge | 65.67 | 55.95 | 56.67 | 96.46 | 59.33 | 64.13 | 66.36 | +13.33 |
| GEPA-Qwen-Opt | 65.67 | 49.83 | 54.67 | 90.05 | 52.67 | 59.31 | 62.03 | +9.00 |
表2:GPT-4.1 Mini 上的结果。GEPA+Merge 的 aggregate improvement 达 +13.33,显著超过 MIPROv2、TextGrad 和 Trace。
这里有一个很重要的现象:GEPA-Qwen-Opt 是在 Qwen3-8B 上优化出来的 prompt,然后不修改地迁移到 GPT-4.1 Mini 上评估,仍然取得 +9.00 的 aggregate improvement。它甚至超过了直接在 GPT-4.1 Mini 上优化的 MIPROv2、TextGrad 和 Trace。
这说明 GEPA 学到的东西不只是某个模型的“口味”,而是相当一部分任务级规则。比如多跳问答里第二跳 query 应该如何寻找缺失证据,隐私任务里哪些信息必须泛化,代码任务里如何根据编译错误更新策略。这些规则本身具有跨模型可迁移性。
5.3 候选选择消融:Pareto frontier 是关键模块
论文还固定进化框架,只替换下一步候选选择策略。结果显示,Pareto-based sampling 的 aggregate improvement 是 +12.44,而 SelectBestCandidate 是 +6.05,BeamSearch 是 +5.11。
| 选择策略 | HotpotQA | IFBench | HoVer | PUPA | Aggregate | Improvement |
|---|---|---|---|---|---|---|
| Baseline | 42.33 | 36.90 | 35.33 | 80.82 | 48.84 | - |
| SelectBestCandidate | 58.33 | 30.44 | 45.33 | 85.45 | 54.89 | +6.05 |
| BeamSearch | 57.33 | 36.39 | 41.00 | 81.08 | 53.95 | +5.11 |
| GEPA Pareto | 62.33 | 38.61 | 52.33 | 91.85 | 61.28 | +12.44 |
表3:候选选择策略消融。只选择当前最优候选会快速陷入局部最优,Pareto-based sampling 更能保留互补策略。
这组消融很能说明 GEPA 的“遗传”部分不是装饰。反思负责产生高质量变异,Pareto frontier 负责让搜索空间保持多样性。没有后者,反思也可能围绕一个早期策略反复打磨,最后错过更好的路线。
六、案例与可解释性分析
PUPA 任务的演化轨迹很好地展示了 GEPA 如何逐步积累规则。起始 prompt 只是要求“把用户私有查询改写成保护隐私的外部 LLM 请求”。经过几轮反思后,prompt 逐渐加入了识别 PII、泛化名称和地点、区分 reasoning 与 request、禁止部分脱敏、保持任务实用性等细化规则。
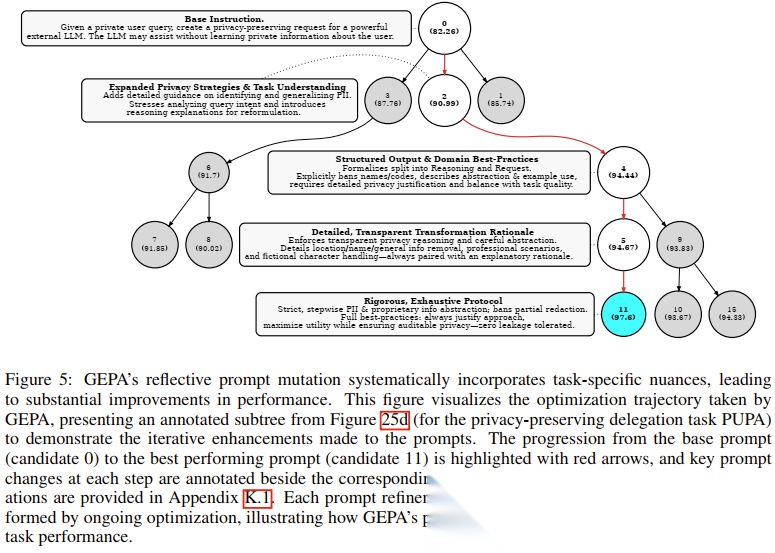
PUPA prompt 演化轨迹
图6:PUPA 任务中,GEPA 从 base prompt 出发,经多次 reflective mutation 把隐私策略、输出结构和审计理由逐步写入 prompt。
这也是 GEPA 相比黑盒 RL 更容易被人理解的地方。它的“学习结果”不是一个权重 diff,而是一份可读 prompt。研究者可以打开中间节点,看到模型学到了什么规则,哪些规则带来了提升,哪些分支没有继续改进。
当然,这种可解释性也不是免费的。GEPA 需要一个足够强的 reflection LM 来读懂轨迹、归因错误并写出更好的指令。如果 reflection LM 本身能力弱,或者任务反馈几乎没有语言信息,GEPA 的优势会被削弱。
七、扩展实验:GEPA 也能做 inference-time search
论文还探索了 GEPA 在代码生成和硬件 kernel 优化中的用途。这里 GEPA 不只是“为未来任务优化 prompt”,而是把待解决的一批任务本身作为训练集和 Pareto 集,在推理时迭代寻找更好的解。
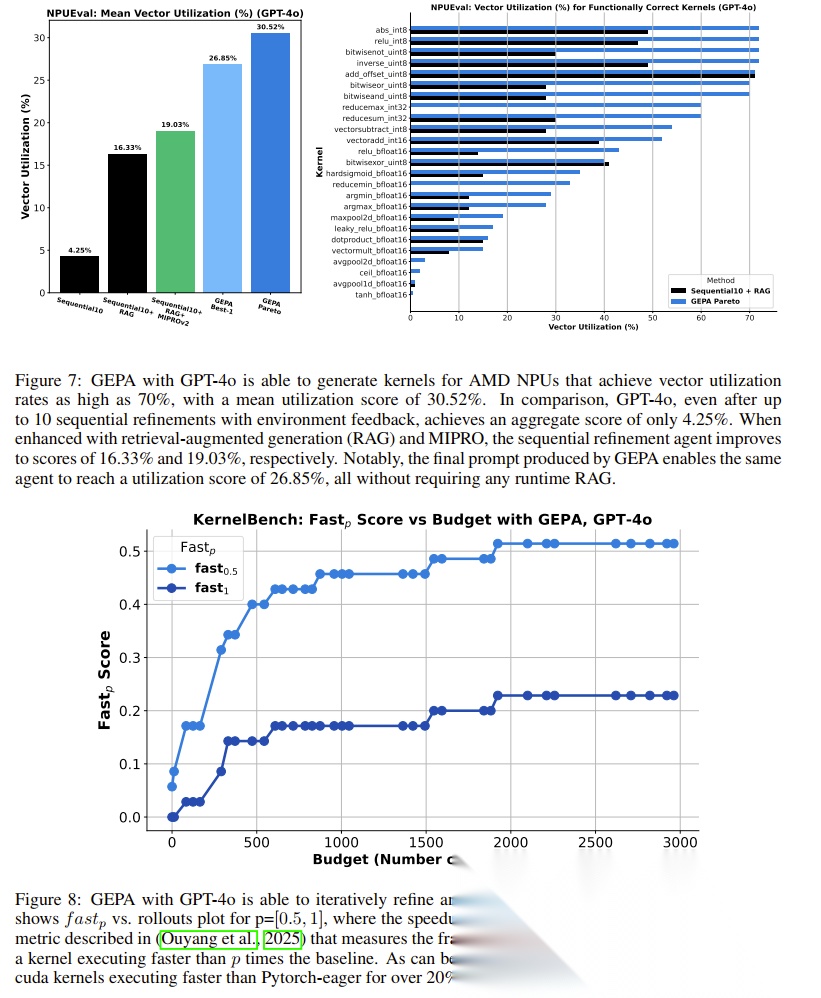
GEPA 在 kernel 生成中的扩展实验
图7:在 NPUEval 上,GEPA Pareto 的平均 vector utilization 达 30.52%,高于 Sequential10 的 4.25%、Sequential10+RAG 的 16.33% 和 Sequential10+RAG+MIPROv2 的 19.03%;在 KernelBench 上,GEPA 让超过 20% 的代表性任务生成了快于 PyTorch eager 的 CUDA kernel。
在 AMD NPU kernel 任务中,普通 GPT-4o Sequential10 的平均 vector utilization 只有 4.25%。加入 RAG 后提升到 16.33%,再加入 MIPROv2 到 19.03%。而 GEPA Pareto 达到 30.52%,单个 GEPA 生成 prompt 也能达到 26.85%,并且不需要 runtime RAG。
这个实验说明,GEPA 很适合那些“失败反馈富含语言信息”的场景。编译错误、profiling 结果、硬件文档片段都可以被当作反思材料。模型不是盲目重试代码,而是把错误转化为下一轮 prompt 中的工程约束。
八、总结
✅ GEPA 的核心贡献是把 rollout 轨迹变成自然语言学习信号。它利用执行轨迹、评价器反馈和分数,让 LLM 反思失败原因并改写 prompt。
✅ 它优化的是 workflow prompt,而不是模型权重。这让 GEPA 可以直接用于闭源模型,也适合不能微调或微调成本高的应用。
✅ Pareto-based candidate selection 是样本效率的关键。它保留在不同样本上各自领先的候选,避免贪心搜索过早陷入局部最优。
✅ 实验结果很强。Qwen3-8B 上 GEPA aggregate improvement 为 +9.62,GPT-4.1 Mini 上 GEPA+Merge 达 +13.33。
✅ GEPA prompt 具备跨模型迁移性。在 Qwen3-8B 上优化出的 prompt 迁移到 GPT-4.1 Mini 仍有 +9.00 的整体提升。
✅ 它还有推理时搜索潜力。在 NPU/CUDA kernel 生成中,GEPA 能利用编译和性能反馈逐步改进代码生成策略。
九、不足与未来方向
9.1 当前不足
🔸 GEPA 依赖可读的反馈信号。如果任务只有一个稀疏 reward,没有错误信息、rubric、轨迹或可解释评价过程,反思模块能利用的信息会少很多。
🔸 reflection LM 的能力会影响上限。GEPA 假设 LLM 能从轨迹中做出合理归因。如果反思模型误判失败原因,它可能把错误规则写进 prompt。
🔸 验证集 rollout 仍占较大预算。论文指出,GEPA 大量 rollout 用于候选选择时的 validation scoring,而不是直接产生学习信号。后续可以研究动态验证子集或更省的 candidate tracking。
🔸 Merge 的收益不稳定。GEPA+Merge 在 GPT-4.1 Mini 上显著提升,但在 Qwen3-8B 上有时会退化。这说明 crossover 何时触发、如何分配预算、怎样判断分支互补性仍需系统研究。
🔸 数学任务不是全面碾压 RL。在 Qwen3-8B 的 AIME-2025 上,GRPO 得到 38.00,GEPA 是 32.00。对于需要模型内部推理能力大幅迁移的任务,权重更新仍可能更有优势。
9.2 未来研究方向
🚀 更智能的反馈函数 μf:不同任务可以设计更细粒度的文字反馈,例如把单元测试失败、检索漏召、格式违规、事实错误分开归因。
🚀 自适应 Pareto 与验证预算:动态选择验证样本,减少候选评估成本,让 GEPA 在更大规模 workflow 上运行。
🚀 更强的模块级 credit assignment:当前模块选择较简单,未来可以根据轨迹自动判断哪一个 LLM module 最该被更新。
🚀 与 RL 或 fine-tuning 结合:GEPA 可以先生成高质量 prompt 和可解释规则,再用这些规则构造数据或 reward shaping,辅助后续权重训练。
🚀 面向生产系统的 prompt 版本管理:GEPA 的进化树天然适合记录 prompt 来源、修改理由和效果差异,未来可与 A/B testing、回滚、审计系统结合。
💡 延伸思考:GEPA 最值得借鉴的地方,不只是“prompt optimizer 又刷高了分数”,而是它把 LLM 系统优化从黑盒梯度更新拉回到语言空间。对真实业务里的 agent 和 workflow 来说,很多失败不是缺一个大模型,而是缺一套能从错误中沉淀规则、保留多条策略、持续演化 prompt 的机制。GEPA 给出的方向是:让模型不只回答问题,也学会阅读自己的工作日志,并把经验写成下一版操作手册。
学AI大模型的正确顺序,千万不要搞错了
🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!
有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!
就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋
📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇
学习路线:
✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经
以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!
我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】


北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 7
 0
- 0


 已为社区贡献47条内容

所有评论(0)