ResAD:用于端到端自动驾驶的归一化残差轨迹建模
文章目录
- 一、前言
- 二、 ResAD:用于端到端自动驾驶的归一化残差轨迹建模
- 三、架构
- 图1:ResAD的核心动机:解决不平衡轨迹数据挑战
- 图2:ResAD框架——归一化残差轨迹建模
- 问题1:完整故事
- 一、完整故事:从"预测轨迹"到"预测为什么要偏离"
- 二、关键公式详解
- 三、DiffDecoder 架构为什么这样设计?
- 四、你特别关心的三个模块
- 五、总结:ResAD 的设计之美
- 问题2:PRNorm 公式和Trajectory Ranker 损失公式
- 一、PRNorm 公式:把残差"压"到一个对称的小区间
- 二、Trajectory Ranker 损失公式
- 一句话总结
- 问题3:BCE损失
- 一、先别管公式,看一个猜硬币的游戏
- 二、公式里的两个字母是什么意思
- 三、为什么公式是"两项相加"?因为它要覆盖两种情况
- 四、在 ResAD 里, S S S 不是 0 或 1,而是 0~1 之间的分数
- 五、一个数值例子
- 六、一句话总结
- 问题4:交叉熵损失
- 一、标准交叉熵:分类问题的"非黑即白"
- 二、ResAD 的改造:轨迹没有唯一正确答案,只有"多接近"
- 三、直观对比:标准 vs ResAD 改造
- 四、一个具体例子
- 五、一句话总结
- 问题5:softmax公式
- 一、标准 Softmax:把"分数"变成"概率"
- 二、ResAD 的 y i y_i yi:看起来很像,但完全不是一回事
- 三、为什么形式像,但本质不同?
- 四、一个具体例子看区别
- 五、一句话总结改动
- 问题6:softmax函数的图
- 三张图分别说明什么
- 一句话总结 Softmax 的图像特征
一、前言
仅供参考,未经实验验证。
二、 ResAD:用于端到端自动驾驶的归一化残差轨迹建模
| 项目 | 内容 |
|---|---|
| 标题 | ResAD: Normalized Residual Trajectory Modeling for End-to-End Autonomous Driving |
| 作者 | Zhiyu Zheng, Shaoyu Chen, Haoran Yin, Xinbang Zhang, Jialv Zou, Xinggang Wang, Qian Zhang, Lefei Zhang |
| 机构 | ① 武汉大学计算机学院 ② 地平线机器人(Horizon Robotics)③ 华中科技大学电子信息与通信学院 |
| 发表 | arXiv:2510.08562v2 [cs.CV],2025年11月22日(目前为预印本,未明确标注具体会议) |
| 代码 | 尚未开源(论文注明 “The code will be released”) |
| 项目主页 | https://zyzheng.me/ResAD/ |
🎯 研究背景与动机
端到端自动驾驶(E2EAD)直接从传感器数据预测未来轨迹,但面临一个根本性的数据难题——轨迹数据的时空不平衡(Spatio-temporal Non-uniformity),导致两个关键问题:
-
虚假相关性(Spurious Correlations)
模型直接学习从高维传感器到复杂轨迹的映射时,容易走"捷径",学到表面关联而非鲁棒的驾驶逻辑。例如:模型可能学会"前车刹车灯亮 → 我刹车",却没理解是红灯导致了前车停下,从而可能在无灯路口盲目跟随前车。 -
规划时间范围困境(Planning Horizon Dilemma)
轨迹数据越往远期越不确定,远期预测与真值偏差大,产生巨大的损失值。这导致优化过程被远期不可预测的大误差主导,反而忽视了近期(0~2秒内)对安全至关重要的精细调整。
💡 核心方法:ResAD 框架
ResAD 的核心思想是将复杂的轨迹预测任务重新建模为"惯性参考 + 归一化残差",把学习问题从"未来轨迹是什么?“转变为"为什么轨迹必须偏离默认路径?”
1. 轨迹残差建模(Trajectory Residual Modeling)
- 惯性参考(Inertial Reference):基于车辆当前状态(位置 p 0 p_0 p0、速度 v 0 v_0 v0),用匀速模型(Constant Velocity)外推一条默认轨迹 τ r e f \tau_{ref} τref。这代表"如果不做任何控制,车会怎么走"的物理先验。
- 残差(Residual): r = τ g t − τ r e f r = \tau_{gt} - \tau_{ref} r=τgt−τref,即人类驾驶员实际轨迹与惯性参考的偏差。残差量化了"必要的控制干预"。
通过这种方式,模型只需学习场景驱动的偏差(如避障、遵守交通规则),而无需从零学习复杂的时空动力学。
2. 逐点残差归一化(Point-wise Residual Normalization, PRNorm)
残差本身仍存在尺度问题:远期残差的数值通常更大,可能在优化中压过近期的小幅但关键调整。PRNorm 对残差进行逐点、逐维度的 Min-Max 归一化:
r ~ t d = 2 γ ⋅ r t d − r m i n d r m a x d − r m i n d + ε 0 − γ \tilde{r}_t^d = 2\gamma \cdot \frac{r_t^d - r_{min}^d}{r_{max}^d - r_{min}^d + \varepsilon_0} - \gamma r~td=2γ⋅rmaxd−rmind+ε0rtd−rmind−γ
其中 r m i n d r_{min}^d rmind 和 r m a x d r_{max}^d rmaxd 是整个训练集上所有轨迹、所有时间步的极值。这使得不同时间步的残差在优化中具有均衡的权重,防止远期大误差主导训练。
3. 惯性参考扰动(Inertial Reference Perturbation, IRP)
为实现多模态规划(驾驶本身就是多模态任务),ResAD 不依赖固定的轨迹词表,而是对初始速度 v 0 v_0 v0 施加高斯扰动 δ v , k ∼ N ( 0 , Σ ) \delta_{v,k} \sim \mathcal{N}(0, \Sigma) δv,k∼N(0,Σ),生成 K K K 个不同的惯性参考,从而自然衍生出 K K K 条候选轨迹。
4. 扩散解码器与轨迹排序器
- DiffDecoder:以扰动后的惯性参考为条件,用扩散模型对归一化残差进行去噪(训练时 K t r a i n = 20 K_{train}=20 Ktrain=20,推理时 K i n f e r = 200 K_{infer}=200 Kinfer=200,仅 2 步 DDIM 去噪)。
- Trajectory Ranker:受 VADv2 和 Hydra-MDP 启发,用 Transformer 让候选轨迹与感知特征交互,预测 PDMS/EPDMS 各子指标分数,选出最优轨迹。
📊 实验结果
NAVSIM v1(NAVTEST)
| 方法 | 骨干 | PDMS |
|---|---|---|
| DiffusionDrive | ResNet-34 | 88.1 |
| WoTE | ResNet-34 | 88.3 |
| ResAD | ResNet-34 | 88.8 ✅ |
| GoalFlow | V2-99 | 89.6 |
| Hydra-MDP | V2-99 | 90.1 |
| ResAD | V2-99 | 90.6 ✅ |
NAVSIM v2(NAVTEST,更具挑战性)
ResAD 在 EPDMS 上达到 85.5,在几乎所有扩展子指标(DDC、TL、LK、EC 等)上均为最佳或次佳。尤其在 EP(Ego Progress,行驶进度) 和 DAC(可行驶区域合规性) 上显著优于 DiffusionDrive(EP 88.2 vs 87.5,DAC 97.2 vs 95.9)。
消融实验亮点
- 仅添加 Ranker 对基线提升有限;
- 引入残差建模(Residual)带来显著增益;
- 加入 PRNorm 后,训练损失收敛更快,PDMS 性能进一步提升;
- IRP 的扰动策略有效提升了多模态规划质量(Pm),避免了 DiffusionDrive 那种依赖固定词表导致生成无效轨迹的问题。
🔑 主要贡献总结
- 重新审视 E2EAD 的轨迹预测范式:指出原始轨迹数据的时空非均匀性导致虚假相关性和规划时间范围困境。
- 提出 ResAD 框架:通过惯性参考 + 归一化残差建模,将学习问题大幅简化;引入 PRNorm 平衡优化目标;通过 IRP 实现高效多模态探索。
- SOTA 性能:在 NAVSIM v1/v2 上取得最佳性能,且仅需 2 步去噪,效率极高。
🖼️ 直观理解
论文 Figure 1 非常形象地展示了这一思想:
- 原始轨迹(Raw Trajectory):分布有严重的均值漂移和方差递增;
- 轨迹残差(Trajectory Residual):将分布中心化,消除了均值漂移;
- 归一化残差(Normalized Residual):进一步稳定方差,使学习目标的分布更加均衡、简单。
正如作者所言,ResAD 让模型从"死记硬背复杂轨迹"转变为"理解为何需要偏离物理惯性",这是一种更贴近人类驾驶直觉的建模方式。
通俗解释
通俗地说,这篇论文讲了一个**“让自动驾驶学会像人类司机一样思考”**的新方法。
🚗 先理解问题:现在的自动驾驶在"硬背答案"
传统的端到端自动驾驶,就像让学生直接背下整张地图——输入摄像头和雷达数据,模型直接输出"未来5秒每个时刻车在哪个坐标"。
但这种方式有两个大毛病:
- 死记硬背:模型可能学会"看到前车刹车灯就刹车",但它没真正理解"是因为红灯亮了,前车才刹车"。这就好比背答案但没理解题意,遇到没见过的场景就懵。
- 远近不分:未来5秒的位置坐标,比未来1秒的数值大得多。训练时模型会拼命去拟合远处的大数字,反而忽略了眼前1米内的精细调整——就像开车时盯着百米外的路,却忘了看跟前有没有障碍物。
💡 ResAD 的聪明做法:先猜"什么都不做会怎样",再想"需要怎么改"
ResAD 的核心思想就一句话:别直接预测未来轨迹,先算"如果我现在什么都不操作,车会怎么滑",再预测"需要偏离这个默认路径多少"。
第一步:惯性参考(Inertial Reference)
想象你开车时突然双手离开方向盘、脚离开油门刹车——车会沿着当前速度和方向惯性滑行一段。这就是"惯性参考轨迹"。
这是纯物理规律,不需要学习,直接就能算出来。
第二步:残差(Residual)
真实的驾驶轨迹,肯定会偏离这个"惯性滑行"——你要转弯避障、减速等红灯、变道超车。这个偏离量就是"残差"。
ResAD 让模型只学这个**“偏离量”**,而不是从头学整条复杂轨迹。
好处是什么? 模型不用浪费精力去学"车会匀速前进"这种物理常识,而是把全部注意力放在**“为什么必须偏离”**——比如前方有行人、红灯亮了、车道线弯曲。这就好比考试不用从1+1开始推,直接聚焦在难题上。
⚖️ 归一化:让"眼前"和"远处"一样重要
刚才说的"远近不分"问题,ResAD 用了一个叫 PRNorm 的技巧。
简单来说:未来5秒的偏离量数值很大,未来0.5秒的偏离量数值很小。如果不处理,模型会觉得"大数字更重要",拼命去拟合远处,忽略眼前。
PRNorm 就像给每个时间点的偏离量**“统一打分标准”——不管远近,每个点的调整都按同样的权重参与学习。这样模型才会认真对待"眼前1米内要不要躲行人"**这种生死攸关的细节。
🎲 多模态:不只给一条路线,而是给多种可能性
真实驾驶从来不是单选题。到了路口,你可能:
- 直行
- 左转
- 右转
- 减速观察
ResAD 的做法是:给初始速度加一点随机扰动(比如假设你当前速度稍微快一点或慢一点),生成多条"惯性滑行"基线,再分别预测各自的偏离量。这样就能自然生成多种合理的驾驶方案,而不是死磕一条。
最后用个"评分器"(Trajectory Ranker)给这些方案打分,选最安全、最合理的一条执行。
🏆 效果有多强?
在业界权威的 NAVSIM 测试上:
- NAVSIM v1:得分 88.8,超越之前最好的方法
- NAVSIM v2:得分 85.5,同样拿下第一
- 而且只需要 2 步去噪(推理极快),不像其他扩散模型要迭代几十步
🎯 一句话总结
ResAD 就像教自动驾驶"先学会放空挡滑行的感觉,再专门练习什么时候该打方向、踩刹车"——把复杂问题拆成"物理常识 + 场景判断",既好学又安全。
三、架构
图1:ResAD的核心动机:解决不平衡轨迹数据挑战
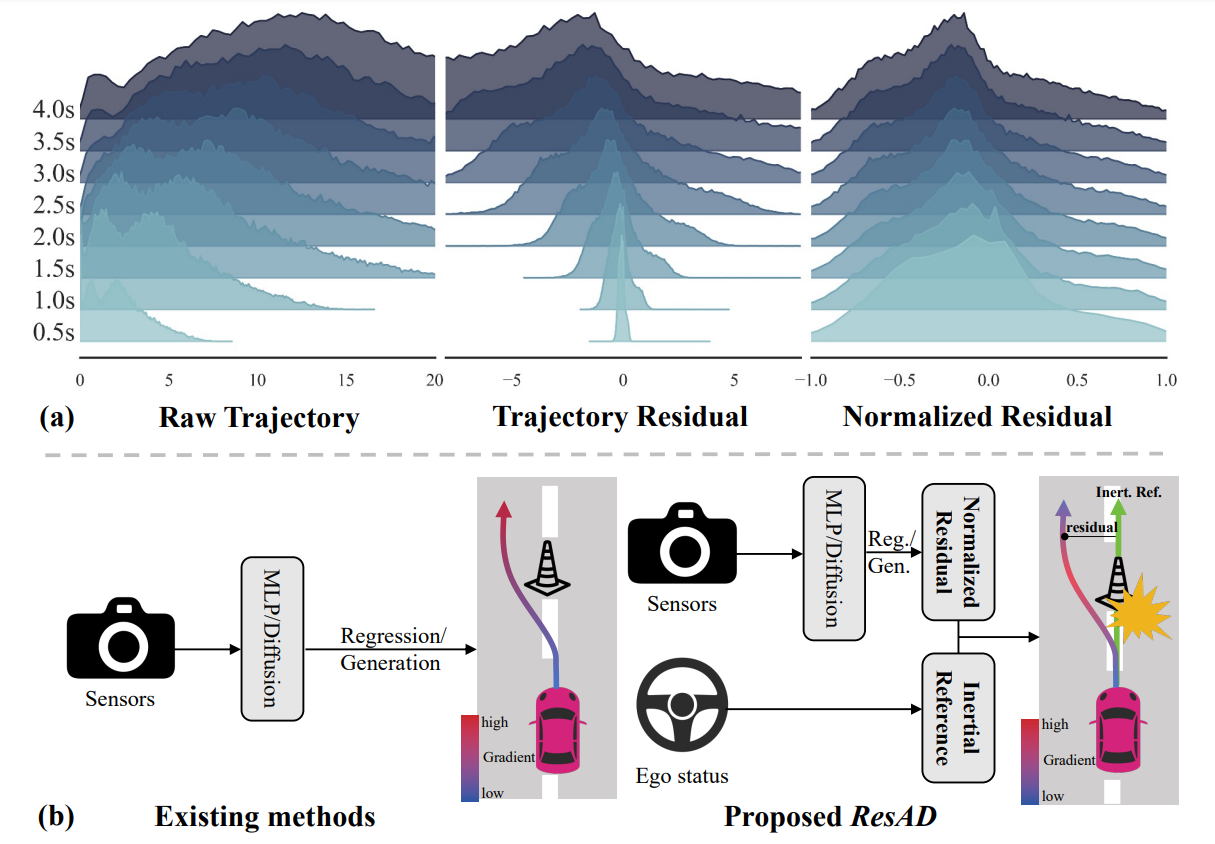
图1详细解释了ResAD论文的核心动机:解决自动驾驶中轨迹数据不平衡带来的挑战。它通过可视化数据分布和概念性比较,清晰地展示了现有方法的局限性以及ResAD如何通过其创新方法克服这些挑战。
总体目的:
图1旨在直观地展示端到端自动驾驶(E2EAD)系统中,直接预测未来轨迹所面临的固有挑战——即轨迹数据在时空上的不平衡性。接着,它对比了ResAD框架与现有方法在处理这些挑战上的根本区别,突出了ResAD如何通过引入“归一化残差轨迹建模”来简化学习任务并提高预测的鲁棒性。
图1(a):纵向数据分布的可视化
这部分通过在不同时间步(从0.5秒到4.0秒)上绘制数据集轨迹的纵向数据分布,展示了三种建模策略下的数据特性。
-
原始轨迹 (Raw Trajectory):
- 内容:左侧的图显示了直接从传感器数据预测的原始未来轨迹的分布。
- 问题:我们可以观察到,随着时间步的增加(即预测时间越长),轨迹分布的均值漂移(mean drift)显著增大,并且方差(variance)也急剧增加。这意味着:
- 均值漂移:远期预测的轨迹偏离预期路径越来越远。
- 方差增加:远期预测的不确定性非常高,模型在训练时很难准确捕捉。
- 挑战:这种“规划视野困境”(Planning Horizon Dilemma)使得模型难以有效学习,因为它需要同时处理近距离的精确性和远距离的高度不确定性。这还会导致模型学习到虚假关联,而非鲁棒的驾驶逻辑。
-
轨迹残差 (Trajectory Residual):
- 内容:中间的图展示了在引入“轨迹残差建模”(Trajectory Residual Modeling, TRM)后的数据分布。TRM的核心思想是,模型不再直接预测原始轨迹,而是预测轨迹相对于一个确定性惯性参考(Inertial Reference)的残差偏差。
- 改进:通过预测残差,数据分布被显著居中(centers the distribution),即均值接近零。这表明模型现在专注于学习从惯性参考路径的偏差,而不是从零开始学习整个复杂轨迹。这大大简化了学习任务,因为它将重点放在了“为什么轨迹必须改变”,而不是“未来轨迹是什么”。
-
归一化残差 (Normalized Residual):
- 内容:右侧的图展示了在引入“点式残差归一化”(Point-wise Residual Normalization, PRNorm)后的数据分布。PRNorm进一步对预测的残差进行归一化处理。
- 改进:通过归一化,分布的方差进一步稳定(stabilizes the variance),使其在整个规划视野内更加均匀。这意味着即使是远期预测,其不确定性也得到了有效控制。
- 挑战解决:这解决了残差本身内部仍然存在的“空间尺度变化”问题,防止了远端、不确定的大幅度误差主导学习信号,确保了对近距离、安全关键的微小调整也能被模型准确捕获。
图1(b):概念性比较
这部分通过流程图的形式,直观地比较了现有端到端自动驾驶方法与ResAD框架的工作原理。
-
现有方法 (Existing methods):
- 流程:传感器数据(
Sensors)直接输入到机器学习模型(MLP/Diffusion),该模型负责直接进行轨迹的“回归/生成”(Regression/Generation),最终输出车辆的原始轨迹。 - 问题:这种直接学习复杂原始轨迹的方法,容易导致模型依赖于虚假关联(spurious correlations),而非理解驾驶环境的深层逻辑。例如,模型可能学会将前车刹车灯与自己刹车关联,但未理解红灯才是停车的真正原因。这种方法需要模型从零开始学习所有时空动态。
- 梯度(Gradient):图中标示的梯度由“低”到“高”,暗示模型在直接预测复杂轨迹时,各个部分的梯度贡献可能不平衡,导致优化困难。
- 流程:传感器数据(
-
本文提出的ResAD (Proposed ResAD):
- 流程:
- 输入:同样从传感器数据(
Sensors)和自车状态(Ego status)开始。 - 惯性参考生成 (Inertial Reference):根据自车当前状态(如速度),生成一个确定性的物理基线——惯性参考。这代表了在没有主动控制时车辆会遵循的默认路径。
- 残差预测 (Residual Prediction):机器学习模型(
MLP/Diffusion)不再直接预测原始轨迹,而是预测相对于惯性参考的归一化残差(Normalized Residual)。 - 轨迹重构 (Trajectory Reconstruction):预测出的归一化残差通过逆归一化(
De-Normalization)后,与惯性参考相加,从而得到最终的预测轨迹。
- 输入:同样从传感器数据(
- 优势:
- 任务简化:通过将复杂的轨迹预测任务分解为“生成物理基线”和“预测与基线的偏差”,ResAD显著简化了学习任务。
- 聚焦关键信息:模型可以将其学习能力集中在识别和纠正与上下文相关的偏差(例如,交通规则、障碍物),而不是从零学习整个轨迹。
- 物理先验:惯性参考提供了一个强大的物理先验知识,迫使模型超越简单的模式匹配。
- 梯度(Gradient):图中标示的梯度在ResAD方法中统一为“高”,暗示了通过残差建模和归一化,模型在各个部分都能获得更稳定、更有效的学习信号,从而促进优化。
- 流程:
总结:
图1通过可视化和概念对比,清晰地阐述了ResAD如何通过将复杂轨迹预测任务重构为预测相对于物理基线的归一化残差,有效解决了现有端到端自动驾驶系统中轨迹数据不平衡带来的“虚假关联”和“规划视野困境”问题。这使得ResAD能够以更简单、平衡的学习目标,更高效地聚焦于上下文感知的修正,从而实现更鲁棒、更安全的自动驾驶规划。
图2:ResAD框架——归一化残差轨迹建模
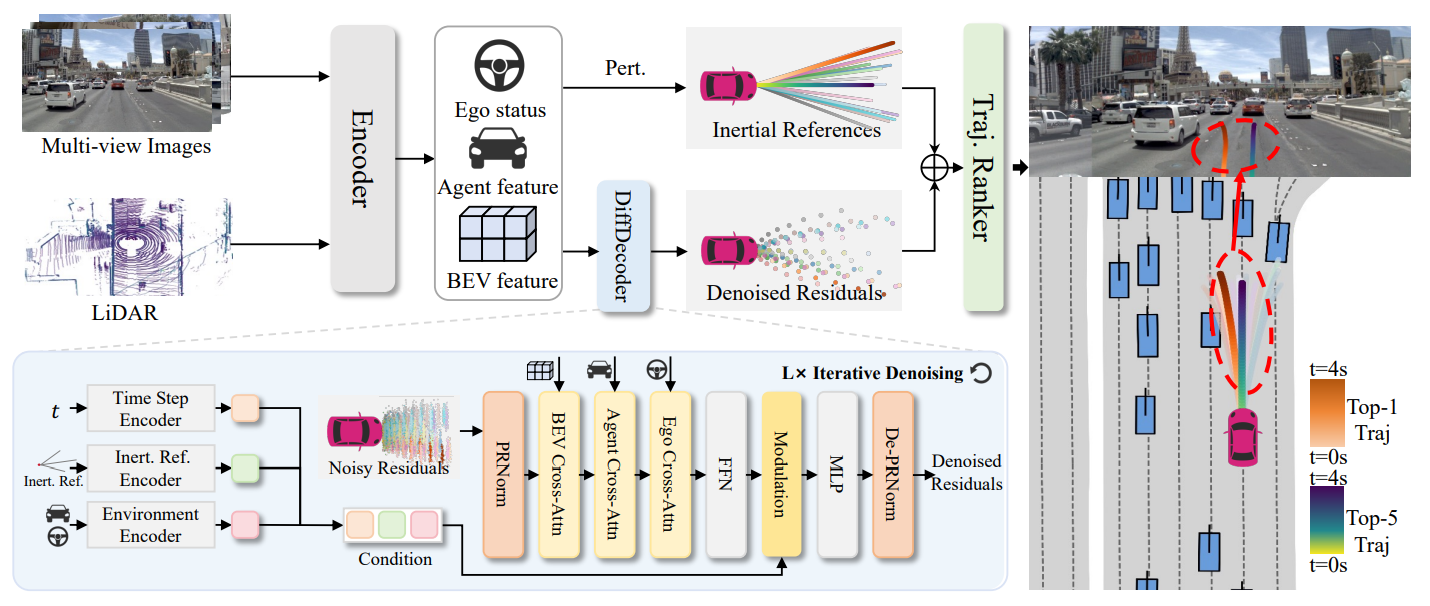
总体目的与核心思想
图2全面展示了ResAD (Normalized Residual Trajectory Modeling) 框架的整体架构。其核心思想是,不直接预测车辆的完整未来轨迹,而是将复杂的轨迹预测任务分解为两个更简单、更可解释的部分:
- 生成一个物理驱动的“惯性参考”基线轨迹。 这代表了车辆在没有主动控制时会自然遵循的默认路径。
- 学习预测相对于这个惯性参考的“归一化残差偏差”。 这些残差代表了车辆为了应对交通规则、障碍物等复杂环境而需要进行的主动修正。
通过这种方式,ResAD将学习目标从“未来轨迹是什么?”转变为“轨迹为什么必须改变?”,从而显著简化了学习任务,提高了模型的鲁棒性和可解释性。
二、框架的宏观流程(主图部分)
整个框架可以分为以下几个主要阶段:
-
感知输入与特征编码 (Perception Input & Feature Encoding)
- 输入:模型接收来自车辆传感器的原始数据,包括多视角图像 (Multi-view Images) 和 激光雷达点云 (LiDAR)。
- 编码器 (Encoder):这些原始传感器数据被送入一个编码器(如Transfuser风格的编码器),用于提取高维语义特征。
- 输出特征:编码器输出三类关键特征:
- 自车状态 (Ego status):描述自车当前的运动信息(如速度、位置、姿态)。
- Agent特征 (Agent feature):包含环境中其他动态物体(如其他车辆、行人)的信息。
- BEV特征 (BEV feature):鸟瞰图(Bird’s-Eye-View)特征,融合了多传感器信息,提供了环境的全局、几何表示。
-
惯性参考生成与扰动 (Inertial Reference Generation & Perturbation)
- 基础惯性参考:利用自车当前状态(主要是速度 v 0 v_0 v0 和位置 p 0 p_0 p0),通过一个简单的恒定速度模型 (Constant Velocity Model) 外推得到一个物理基线轨迹,即惯性参考 (Inertial References)。这代表了车辆在没有任何控制输入时的默认路径。
- 扰动 (Pert.):为了生成多模态的预测结果并增强模型对传感器噪声的鲁棒性,ResAD对初始速度
v
0
v_0
v0 引入了随机扰动
δ
v
k
\delta v_{k}
δvk。
- 机制:从一个零均值多变量高斯分布 N ( 0 , Σ ) \mathcal{N}(0, \Sigma) N(0,Σ) 中采样得到 K K K 个不同的扰动向量 δ v k \delta v_{k} δvk。
- 数学表示: perturbed initial velocity v 0 , k = v 0 + δ v k v_{0,k} = v_0 + \delta v_k v0,k=v0+δvk。
- 结果:这些扰动生成了多样化的惯性参考集合,代表了不同的初始意图假设。
-
残差预测 (Residual Prediction)
- DiffDecoder (Diffusion Decoder):这是一个扩散模型解码器,负责学习预测归一化残差 (Normalized Residuals)。
- 输入:它以编码后的传感器特征(BEV feature, Agent feature, Ego status)和扰动后的惯性参考作为条件信息 (Condition),并接收加噪残差 (Noisy Residuals) 作为输入。
- 输出:经过迭代去噪过程,DiffDecoder输出去噪残差 (Denoised Residuals)。
-
轨迹重构与排序 (Trajectory Reconstruction & Ranking)
- 轨迹重构:预测出的去噪残差与对应的惯性参考相加(图中的“ ⨁ \bigoplus ⨁”符号表示),即可重构出多条候选的未来轨迹。
- 轨迹排序器 (Traj. Ranker):由于扰动生成了多条可能的轨迹,轨迹排序器会根据场景上下文和安全性等指标,从这些候选轨迹中选择出最优的轨迹。
- 最终输出:图中右侧的场景可视化展示了排序器选出的Top-1 Trajectory (Top-1 Traj) 和 Top-5 Trajectories (Top-5 Traj)。红色虚线圈出部分是ResAD预测的轨迹,它们在弯道处能平滑地跟随道路,而不会像传统方法那样出现不切实际的直行。
三、DiffDecoder 的内部详细机制(下方蓝色虚线框内)
DiffDecoder是ResAD框架的核心学习模块,它是一个基于扩散模型的去噪网络,其内部结构进一步细化了残差预测过程:
-
输入编码 (Input Encoders)
- 时间步编码器 (Time Step Encoder):对当前的扩散时间步 t t t 进行编码,以告知模型当前处于去噪过程的哪个阶段。
- 惯性参考编码器 (Inert. Ref. Encoder):对输入的惯性参考 (Inert. Ref.) 进行编码,捕捉其路径信息。
- 环境编码器 (Environment Encoder):对来自主干编码器的BEV特征、Agent特征和Ego状态进行编码,生成综合的条件信息 (Condition)。这些条件信息对去噪过程至关重要,因为它指导模型根据环境上下文进行残差预测。
-
加噪残差与归一化 (Noisy Residuals & PRNorm)
- 加噪残差 (Noisy Residuals):这是扩散模型的输入,是真实残差被高斯噪声污染后的版本。
- PRNorm (Point-wise Residual Normalization):这是ResAD的一个关键创新。它对输入的加噪残差进行点式归一化。
- 设计原理:为了解决轨迹数据在不同时间步上的尺度差异(远期轨迹数值更大,易主导优化)以及残差本身存在的尺度问题,PRNorm对每个轨迹点上的残差分量进行min-max归一化。
- 数学表示:对于残差向量
r
t
r_t
rt 的每个分量
r
t
d
r_t^d
rtd,其归一化公式为:
r t ′ d = 2 ( r t d − r min d r max d − r min d + ϵ 0 ) − γ r_t'^d = 2 \left( \frac{r_t^d - r_{\min}^d}{r_{\max}^d - r_{\min}^d + \epsilon_0} \right) - \gamma rt′d=2(rmaxd−rmind+ϵ0rtd−rmind)−γ
其中, r min d r_{\min}^d rmind 和 r max d r_{\max}^d rmaxd 是训练数据集中所有轨迹点在维度 d d d 上的最小和最大残差值。 ϵ 0 \epsilon_0 ϵ0 是为数值稳定性添加的小常数。 γ \gamma γ 是一个超参数,用于定义对称输出区间 [ − γ , γ ] [-\gamma, \gamma] [−γ,γ] 的边界。 - 作用:稳定优化过程,防止远距离、不确定的大幅度误差主导学习信号,确保模型能精确学习近距离、安全关键的微小调整。
-
迭代去噪模块 (L × \times × Iterative Denoising)
DiffDecoder包含 L L L 个迭代去噪步骤,每个步骤都由一系列子模块组成:- BEV Cross-Attn:将归一化后的残差与BEV特征进行交叉注意力,使模型能够理解残差与全局环境几何结构之间的关系。
- Agent Cross-Attn:将残差与Agent特征进行交叉注意力,捕获残差与其他交通参与者的交互信息。
- Ego Cross-Attn:将残差与自车状态特征进行交叉注意力,关联残差与自车当前的运动情况。
- FFN (Feed-Forward Network):前馈网络,用于进一步处理特征。
- Modulation:调制模块,通常用于将条件信息(如时间步编码、惯性参考编码)注入到网络中,以指导特征的更新。
- MLP (Multi-Layer Perceptron):多层感知机,用于进一步特征变换。
- De-PRNorm (Inverse PRNorm):去归一化模块,将处理后的归一化残差反向映射回原始残差尺度。
- 输出:经过 L L L 次迭代去噪后,最终输出去噪残差 (Denoised Residuals)。
四、关键创新点与协同作用
- 轨迹残差建模 (Trajectory Residual Modeling, TRM):通过预测残差,将复杂的端到端轨迹预测任务简化,让模型专注于学习对惯性参考的“修正”,而非从零开始生成整个轨迹。这利用了物理先验知识,提高了学习效率和模型的可解释性。
- 点式残差归一化 (Point-wise Residual Normalization, PRNorm):解决了残差本身在不同时间步上的尺度不平衡问题,确保了优化过程的稳定性,并让模型能够更精确地捕捉到安全关键的近场调整。
- 惯性参考扰动 (Inertial Reference Perturbation, IRP):通过对惯性参考进行扰动,有效地生成了多样化的初始意图假设,实现了上下文感知的多模态预测,克服了传统方法中固定轨迹词汇表的局限性。
- DiffDecoder:作为核心预测模块,利用扩散模型的强大去噪能力,结合多模态交叉注意力机制,高效且鲁棒地从噪声中恢复出精确的归一化残差。
- 轨迹排序器 (Trajectory Ranker):在生成多条候选轨迹后,通过排序器选择出最优轨迹,确保最终输出的轨迹兼具安全性、可驾驶性和与环境的协调性。
通过这些模块的协同工作,ResAD框架能够在一个统一的端到端系统中,克服传统方法中轨迹数据不平衡、虚假关联和规划视野困境等挑战,从而提供更鲁棒、更安全、更高效的自动驾驶解决方案。
问题1:完整故事
这篇论文 ResAD(Normalized Residual Trajectory Modeling for End-to-End Autonomous Driving)讲了一个非常清晰的方法论故事。下面我从问题动机、核心思想、公式含义、架构设计逻辑、以及你特别关心的 PRNorm / Condition / Modulation 三个模块,完整拆解。
一、完整故事:从"预测轨迹"到"预测为什么要偏离"
1.1 现有方法的困境
端到端自动驾驶(E2EAD)试图让模型直接从传感器(多路相机 + LiDAR)映射到未来轨迹。但作者指出,原始轨迹数据存在严重的时空非均匀性(spatio-temporal non-uniformity),导致两个致命问题:
| 问题 | 具体含义 |
|---|---|
| 虚假相关性(Spurious Correlations) | 模型需要把高维传感器数据直接映射到复杂的绝对轨迹,负担太重,容易走"捷径"。例如:模型看到前车刹车灯亮了就跟着刹车,但没理解是红灯导致前车停下——于是当前车因其他原因刹车时,模型可能错误地跟着刹;当红绿灯变化时,又可能跟着前车闯红灯。 |
| 规划时域困境(Planning Horizon Dilemma) | 轨迹数据随时间推移越来越不确定。远处航点(如 4 秒后)与真值偏差天然很大,训练时产生巨大 Loss,迫使优化器优先关注这些大但不可预测的远场误差,反而忽视了眼前 0.5 秒内关乎碰撞安全的精细调整。 |
图 1(a) 非常直观地展示了这一点:
- Raw Trajectory:分布有明显均值漂移(mean drift),方差随时间急剧增大。
- Trajectory Residual:减去惯性参考后,分布被拉回到零附近,但远处尺度仍然大。
- Normalized Residual:进一步归一化后,方差被稳定,整个时域上的分布变得均衡。
1.2 ResAD 的核心思想
ResAD 把问题从 “What is the future trajectory?”(未来轨迹是什么?)转变为 “Why must the trajectory change?”(轨迹为什么要偏离默认路径?)。
具体做法:
- 先算一个强物理先验——惯性参考(Inertial Reference):假设自车从现在开始不施加任何控制,按当前速度匀速直线行驶,它会走什么路径?
- 再学一个残差(Residual):真值轨迹与惯性参考的差,就是人类驾驶员为了应对红绿灯、障碍物、转弯等"context"所做的必要修正。
- 对残差做逐点归一化(PRNorm):消除不同时域点的尺度差异,让近处和远处的修正都被平等优化。
- 对惯性参考做扰动(IRP):在初始速度上加微小噪声,生成一组多样化的惯性参考,从而自然产生多模态轨迹候选,无需固定词表。
- 用扩散模型去噪残差:DiffDecoder 在条件(Condition)引导下,从噪声中恢复归一化残差。
- 用 Trajectory Ranker 选最优:从 200 条候选中选出最佳轨迹。
二、关键公式详解
2.1 惯性参考(Inertial Reference)
p t i = p 0 + v 0 ⋅ t i p_{t_i} = p_0 + v_0 \cdot t_i pti=p0+v0⋅ti
- p 0 = ( x 0 , y 0 ) p_0 = (x_0, y_0) p0=(x0,y0):自车当前位置。
- v 0 = ( v x , 0 , v y , 0 ) v_0 = (v_{x,0}, v_{y,0}) v0=(vx,0,vy,0):自车当前速度。
- t i t_i ti:未来第 i i i 个时间步。
含义:这是高中物理的匀速直线运动模型。它代表"如果驾驶员现在双手离开方向盘、不踩油门刹车,车会怎么走"。这是一个零参数、确定性、物理可解释的强先验。
2.2 轨迹残差(Trajectory Residual)
r = τ g t − τ r e f r = \tau_{gt} - \tau_{ref} r=τgt−τref
- τ g t \tau_{gt} τgt:真值轨迹(人类驾驶轨迹)。
- τ r e f \tau_{ref} τref:惯性参考轨迹。
含义: r r r 不是"未来在哪里",而是"相比放任不管,人类做了哪些修正"。这个残差的量级天然比原始轨迹小,且物理意义明确——向左偏、减速、绕行等。
2.3 逐点残差归一化(PRNorm)
这是 ResAD 最核心的技巧之一。
先算全局极值(在训练集所有轨迹、所有时间步上预计算):
r min d = min j , t ( r j , t d ) , r max d = max j , t ( r j , t d ) r_{\min}^d = \min_{j,t}(r_{j,t}^d), \quad r_{\max}^d = \max_{j,t}(r_{j,t}^d) rmind=j,tmin(rj,td),rmaxd=j,tmax(rj,td)
其中 d ∈ { x , y } d \in \{x, y\} d∈{x,y}, j j j 是轨迹索引, t t t 是时间步。
再对每个分量做 Min-Max 缩放到对称区间 [ − γ , γ ] [-\gamma, \gamma] [−γ,γ]:
r ~ t d = 2 γ ⋅ r t d − r min d r max d − r min d + ε 0 − γ \tilde{r}_t^d = 2\gamma \cdot \frac{r_t^d - r_{\min}^d}{r_{\max}^d - r_{\min}^d + \varepsilon_0} - \gamma r~td=2γ⋅rmaxd−rmind+ε0rtd−rmind−γ
- γ > 0 \gamma > 0 γ>0:超参数,控制输出区间的半宽,论文中用于精细控制特征分布。
- ε 0 \varepsilon_0 ε0:防止除零的极小常数。
含义:
- 如果不做 PRNorm,远处航点的残差绝对值可能很大(比如 10 米),而近处只有 0.5 米。MSE/L1 Loss 会被 10 米的大误差绑架,模型拼命优化远处,但远处本来就是不确定的。
- PRNorm 把所有时间步的残差都压到 [ − γ , γ ] [-\gamma, \gamma] [−γ,γ] 区间,让每个时间步在优化时拥有同等话语权。这样模型才会认真对待"眼前 0.5 米处的微调"——这往往就是避免碰撞的关键。
2.4 惯性参考扰动(IRP)
δ v , k ∼ N ( 0 , Σ ) , Σ = diag ( σ v x 2 , σ v y 2 ) \delta_{v,k} \sim \mathcal{N}(0, \Sigma), \quad \Sigma = \text{diag}(\sigma_{vx}^2, \sigma_{vy}^2) δv,k∼N(0,Σ),Σ=diag(σvx2,σvy2)
v 0 , k ′ = v 0 + δ v , k v'_{0,k} = v_0 + \delta_{v,k} v0,k′=v0+δv,k
含义:对初始速度在纵向和横向上分别加高斯噪声,生成 K K K 个"假设的初始意图"。比如:假设自车初始速度稍微快一点、或稍微偏左一点,会产生怎样的惯性参考?这样不需要预定义轨迹词表,就能自然探索多模态行为(直行、左转、右转、变道等)。
2.5 扩散前向与去噪过程
训练时对归一化残差加噪:
z k ( i ) = α ˉ i r ~ k + 1 − α ˉ i ε , ε ∼ N ( 0 , I ) z_k^{(i)} = \sqrt{\bar{\alpha}_i} \tilde{r}_k + \sqrt{1 - \bar{\alpha}_i} \varepsilon, \quad \varepsilon \sim \mathcal{N}(0, I) zk(i)=αˉir~k+1−αˉiε,ε∼N(0,I)
- α ˉ i \bar{\alpha}_i αˉi:DDPM 的累积信噪比参数,控制第 i i i 时间步的噪声强度。
- 这是标准扩散前向过程,但扩散的对象不是原始轨迹,而是归一化后的残差。
去噪损失:
L diff = ∑ k = 1 K L rec ( r ^ k , r k ) L_{\text{diff}} = \sum_{k=1}^K L_{\text{rec}}(\hat{r}_k, r_k) Ldiff=k=1∑KLrec(r^k,rk)
- L rec L_{\text{rec}} Lrec 可以是 L1 或 MSE。
- 模型预测的是干净残差 r ^ k \hat{r}_k r^k,然后与真值残差 r k r_k rk 比较。
2.6 Trajectory Ranker 损失
V = PosEmb ( v k ) , V ′ = Transformer ( Q = V , K , V = E e n v ) + E V = \text{PosEmb}(v_k), \quad V' = \text{Transformer}(Q=V, K,V=E_{env}) + E V=PosEmb(vk),V′=Transformer(Q=V,K,V=Eenv)+E
L ranker = ∑ i = 1 k y i log ( S ^ i m ) + ∑ m , i BCE ( S i m , S ^ i m ) L_{\text{ranker}} = \sum_{i=1}^k y_i \log(\hat{S}_i^m) + \sum_{m,i} \text{BCE}(S_i^m, \hat{S}_i^m) Lranker=i=1∑kyilog(S^im)+m,i∑BCE(Sim,S^im)
y i = e − ( τ g t − τ ^ i ) 2 ∑ j = 1 k e − ( τ g t − τ ^ j ) 2 y_i = \frac{e^{-(\tau_{gt} - \hat{\tau}_i)^2}}{\sum_{j=1}^k e^{-(\tau_{gt} - \hat{\tau}_j)^2}} yi=∑j=1ke−(τgt−τ^j)2e−(τgt−τ^i)2
- v k v_k vk:第 k k k 条候选轨迹。
- E e n v E_{env} Eenv:环境感知特征(来自 Encoder)。
- E E E:自车状态嵌入。
- y i y_i yi:基于轨迹与真值的距离计算的软标签,距离越近权重越高。
- S ^ i m \hat{S}_i^m S^im:模型预测的第 i i i 条轨迹在第 m m m 个指标(如碰撞、舒适度、可行驶区域等)上的分数。
- Ranker 实际上是在蒸馏规则规划器(rule-based planner)和真值的知识,让模型学会按人类驾驶标准给轨迹打分。
三、DiffDecoder 架构为什么这样设计?
图 2 下半部分展示了 DiffDecoder 的详细结构。这个设计不是随意堆砌,而是有明确的信息层级和物理直觉:
3.1 信息融合的顺序:从宏观到微观
| 模块 | 作用 | 为什么在这个位置 |
|---|---|---|
| BEV Cross-Attn | 与鸟瞰图特征交互 | BEV 提供静态场景拓扑:道路边界、车道线、可行驶区域。这是决策的最底层约束——先知道"路在哪里"。 |
| Agent Cross-Attn | 与其他交通参与者交互 | 在知道路的基础上,再看动态障碍物:其他车辆、行人。这是交互层——“谁会影响我”。 |
| Ego Cross-Attn | 与自车状态交互 | 最后融入自车运动学约束:当前速度、加速度、航向。这是执行层——“我能做什么”。 |
| FFN | 特征变换与整合 | 把三层注意力提取的信息做非线性融合。 |
| Modulation | 条件调制 | 将时间步、惯性参考意图等条件"注入"特征,指导去噪方向。 |
| MLP | 输出预测 | 最终映射到残差空间。 |
设计哲学:去噪残差需要回答"在这个场景下,相比放任不管,我应该怎么修正"。这个决策天然是分层——先看路,再看人,再看自己。
3.2 为什么用 Cross-Attention 而不是 Concat?
Cross-Attention 让残差特征作为 Query,去主动查询它需要的场景信息。这比简单的特征拼接(Concat)更高效:
- 残差特征可以"选择性"地关注 BEV 中 relevant 的区域(如前方路口而非后方建筑)。
- 不同去噪阶段(不同时间步)需要关注的信息不同,Cross-Attention 提供了这种动态性。
四、你特别关心的三个模块
4.1 PRNorm(Point-wise Residual Normalization)
在架构中的位置:图中有两处 PRNorm——数据预处理层和 DiffDecoder 的输入端;以及对应的 De-PRNorm 在输出端。
双重含义:
- 数据预处理层面(论文 3.2 节):在训练前,用全局 Min-Max 把残差缩放到 [ − γ , γ ] [-\gamma, \gamma] [−γ,γ]。这是为了解决"规划时域困境"。
- 特征层面(架构图中):DiffDecoder 输入端对 Noisy Residuals 做归一化,输出端做反归一化(De-PRNorm),确保扩散模型在标准尺度的特征空间中去噪,避免数值不稳定。
为什么这样设计?
- 扩散模型对输入特征的尺度敏感。如果不同时间步的残差尺度差异巨大,去噪过程会不稳定。
- PRNorm 相当于给扩散模型提供了一个"标准坐标系",让它专注于学习残差的形状和方向,而不是被绝对数值干扰。
- De-PRNorm 在推理时把预测拉回真实物理尺度,再加回惯性参考。
4.2 Condition(条件)
从图 2 下半部分可以看到,Condition 由三个编码器输出拼接而成:
| 编码器 | 输入 | 编码内容 |
|---|---|---|
| Time Step Encoder | 扩散时间步 t t t | 告诉模型"我现在在去噪的哪个阶段"——早期需要大步去噪,后期需要精细调整。 |
| Inert. Ref. Encoder | 扰动后的惯性参考 τ r e f , k \tau_{ref,k} τref,k | 告诉模型"我当前假设的默认路径是什么"——不同扰动产生不同意图假设,编码器给每个假设一个独特身份标识。 |
| Environment Encoder | BEV feature + Agent feature + Ego status | 告诉模型"周围世界是什么样的"——这是残差修正的上下文依据。 |
为什么 Condition 要这样组成?
- 扩散模型的去噪不是盲目的,它需要知道"我要去哪"(惯性参考)和"我在哪里、周围有什么"(环境)。
- 特别地,惯性参考编码是多样性的来源:每个扰动后的惯性参考都有独特的位置编码,让模型能区分"这是假设 A 的残差"和"这是假设 B 的残差",从而生成 diverse 的多模态轨迹。
4.3 Modulation(调制)
Modulation 在图中位于 FFN 之后、MLP 之前,且接收 Condition 的输入。这是**条件注入(conditioning)**的关键机制。
它是什么?
虽然论文没有展开 Modulation 的具体数学形式,但从扩散模型的惯例和图示来看,这很可能是 AdaGN(Adaptive Group Normalization) 或类似的特征调制层:
- 输入:FFN 输出的特征 + Condition(时间步嵌入 + 惯性参考嵌入)。
- 操作:用 Condition 生成缩放因子
γ
\gamma
γ 和偏移量
β
\beta
β,对特征做归一化后的缩放与平移:
ModulatedFeature = γ ( Condition ) ⋅ Feature − μ σ + β ( Condition ) \text{ModulatedFeature} = \gamma(\text{Condition}) \cdot \frac{\text{Feature} - \mu}{\sigma} + \beta(\text{Condition}) ModulatedFeature=γ(Condition)⋅σFeature−μ+β(Condition)
为什么放在这里?
- FFN 已经整合了 BEV、Agent、Ego 三层信息,形成了"场景理解特征"。
- Modulation 在最高层语义特征上注入"时间步"和"意图假设"信息,直接调制去噪的方向和步幅。
- 放在 MLP 之前,是因为 MLP 负责最终映射到残差空间——Modulation 确保这个映射是在正确条件引导下的。
物理直觉:
- 如果当前时间步 t t t 很大(噪声很强),Modulation 会让特征更"平滑",允许大尺度修正。
- 如果 t t t 很小(接近干净数据),Modulation 会让特征更"敏感",只做精细调整。
- 如果惯性参考是"偏左扰动",Modulation 会引导去噪偏向"左偏残差"的流形。
五、总结:ResAD 的设计之美
| 设计 | 解决的问题 | 带来的好处 |
|---|---|---|
| 惯性参考 | 轨迹预测任务太复杂 | 提供强物理先验,模型只需学"修正量" |
| 残差建模 | 虚假相关性 | 迫使模型理解驾驶逻辑,而非表面模式匹配 |
| PRNorm | 时域尺度不平衡 | 远近航点同等优化,近场安全精度提升 |
| IRP 扰动 | 多模态需要固定词表 | 动态生成上下文相关的多样化假设 |
| DiffDecoder 分层注意力 | 场景信息如何融合 | 路→人→己的分层决策,符合人类驾驶直觉 |
| Modulation | 条件如何有效注入 | 时间步和意图直接调制特征,去噪更精准 |
ResAD 在 NAVSIM v1 达到 88.8 PDMS、v2 达到 85.5 EPDMS,且推理只需 2 步去噪,说明这个"先物理先验、再学修正"的范式确实显著简化了学习难度,让扩散模型把 capacity 用在了刀刃上。
问题2:PRNorm 公式和Trajectory Ranker 损失公式
这两个公式确实容易让人困惑,我拆开一步一步讲。
一、PRNorm 公式:把残差"压"到一个对称的小区间
r ~ t d = 2 γ ⋅ r t d − r min d r max d − r min d + ε 0 − γ \tilde{r}_t^d = 2\gamma \cdot \frac{r_t^d - r_{\min}^d}{r_{\max}^d - r_{\min}^d + \varepsilon_0} - \gamma r~td=2γ⋅rmaxd−rmind+ε0rtd−rmind−γ
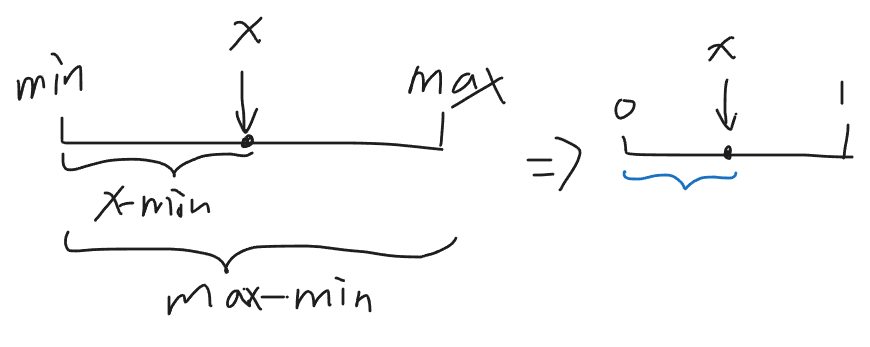
第一步:先看标准的 Min-Max 缩放(你高中可能学过)
假设你有一组数据,最小值是 0,最大值是 100。你想把它缩放到 [ 0 , 1 ] [0, 1] [0,1] 区间:
scaled = x − x min x max − x min \text{scaled} = \frac{x - x_{\min}}{x_{\max} - x_{\min}} scaled=xmax−xminx−xmin
- x − x min x - x_{\min} x−xmin:把最小值拉到 0 (“我比最小值多了多少”)
- 除以极差:把最大值拉到 1 (“整个范围有多宽”)
- 结果:一个 0 到 1 之间的数,表示你在这个范围里的"位置百分比"
例子:
x
=
30
x=30
x=30,
x
min
=
0
x_{\min}=0
xmin=0,
x
max
=
100
x_{\max}=100
xmax=100
30
−
0
100
−
0
=
0.3
\frac{30-0}{100-0} = 0.3
100−030−0=0.3
第二步:ResAD 在这个基础上做了两个改动
改动 1:把 [ 0 , 1 ] [0,1] [0,1] 映射改成 [ − γ , γ ] [-\gamma, \gamma] [−γ,γ]
标准 Min-Max 输出到 [ 0 , 1 ] [0,1] [0,1],但 ResAD 想要一个以 0 为中心的对称区间 [ − γ , γ ] [-\gamma, \gamma] [−γ,γ]。
怎么做到?先乘 2 γ 2\gamma 2γ 把区间扩到 [ 0 , 2 γ ] [0, 2\gamma] [0,2γ],再减 γ \gamma γ 把整体左移到 [ − γ , γ ] [-\gamma, \gamma] [−γ,γ]:
| 原始 Min-Max 值 | 乘 2 γ 2\gamma 2γ | 减 γ \gamma γ | 最终结果 |
|---|---|---|---|
| 0 | 0 | − γ -\gamma −γ | − γ -\gamma −γ |
| 0.5 | γ \gamma γ | 0 | 0 |
| 1 | 2 γ 2\gamma 2γ | γ \gamma γ | γ \gamma γ |
改动 2:加一个 ε 0 \varepsilon_0 ε0 防止除零
如果训练数据里所有残差都一模一样(极端情况), r max d − r min d = 0 r_{\max}^d - r_{\min}^d = 0 rmaxd−rmind=0,除法会爆炸。 ε 0 \varepsilon_0 ε0(比如 10 − 8 10^{-8} 10−8)就是保险丝。
第三步:一个完整数值例子
假设:
- 某时刻 t t t 的纵向(x方向)残差 r t x = 5 r_t^x = 5 rtx=5 米
- 训练集里所有纵向残差的最小值 r min x = − 20 r_{\min}^x = -20 rminx=−20 米
- 最大值 r max x = + 30 r_{\max}^x = +30 rmaxx=+30 米
- 超参数 γ = 1 \gamma = 1 γ=1
代入:
r ~ t x = 2 × 1 ⋅ 5 − ( − 20 ) 30 − ( − 20 ) + 10 − 8 − 1 \tilde{r}_t^x = 2 \times 1 \cdot \frac{5 - (-20)}{30 - (-20) + 10^{-8}} - 1 r~tx=2×1⋅30−(−20)+10−85−(−20)−1
= 2 ⋅ 25 50 − 1 = 2 ⋅ 0.5 − 1 = 0 = 2 \cdot \frac{25}{50} - 1 = 2 \cdot 0.5 - 1 = 0 =2⋅5025−1=2⋅0.5−1=0
含义:这个 5 米的残差,在归一化后变成了 0——它正好处于训练集残差分布的"中间位置"。
如果 r t x = − 20 r_t^x = -20 rtx=−20(训练集最小值),结果是 − 1 -1 −1;如果 r t x = 30 r_t^x = 30 rtx=30(最大值),结果是 + 1 +1 +1。
为什么要对称区间 [ − γ , γ ] [-\gamma, \gamma] [−γ,γ]?
因为残差可以是正的(向右/加速)也可以是负的(向左/减速)。以 0 为中心的对称分布,让扩散模型去噪时更容易学习——噪声也是零均值对称的。
二、Trajectory Ranker 损失公式
论文里的公式是:
L ranker = ∑ i = 1 k y i log ( S ^ i m ) + ∑ m , i BCE ( S i m , S ^ i m ) L_{\text{ranker}} = \sum_{i=1}^k y_i \log(\hat{S}_i^m) + \sum_{m,i} \text{BCE}(S_i^m, \hat{S}_i^m) Lranker=i=1∑kyilog(S^im)+m,i∑BCE(Sim,S^im)
这个公式看起来复杂,但其实是两个损失的拼接。我分开解释。
第一部分: ∑ i = 1 k y i log ( S ^ i m ) \sum_{i=1}^k y_i \log(\hat{S}_i^m) ∑i=1kyilog(S^im) —— 教 Ranker “哪条轨迹最好”
这是交叉熵(Cross-Entropy)的变体,但这里的标签 y i y_i yi 不是 0 或 1,而是一个软权重:
y i = e − ( τ g t − τ ^ i ) 2 ∑ j = 1 k e − ( τ g t − τ ^ j ) 2 y_i = \frac{e^{-(\tau_{gt} - \hat{\tau}_i)^2}}{\sum_{j=1}^k e^{-(\tau_{gt} - \hat{\tau}_j)^2}} yi=∑j=1ke−(τgt−τ^j)2e−(τgt−τ^i)2
这个 y i y_i yi 是什么意思?
这是Softmax 的"距离版"。分子是第 i i i 条轨迹与真值轨迹的负平方距离,分母是所有轨迹的负平方距离之和。
直观理解:
- 如果某条轨迹 τ ^ i \hat{\tau}_i τ^i 非常接近真值 τ g t \tau_{gt} τgt, ( τ g t − τ ^ i ) 2 (\tau_{gt} - \hat{\tau}_i)^2 (τgt−τ^i)2 很小, e − 小 ≈ 1 e^{-\text{小}} \approx 1 e−小≈1, y i y_i yi 就很大。
- 如果某条轨迹离真值很远, ( τ g t − τ ^ i ) 2 (\tau_{gt} - \hat{\tau}_i)^2 (τgt−τ^i)2 很大, e − 大 ≈ 0 e^{-\text{大}} \approx 0 e−大≈0, y i y_i yi 就很小。
例子:假设生成 3 条候选轨迹,与真值的距离分别是:
- 轨迹 A:距离 = 0.1 → e − 0.01 ≈ 0.99 e^{-0.01} \approx 0.99 e−0.01≈0.99
- 轨迹 B:距离 = 2.0 → e − 4 ≈ 0.018 e^{-4} \approx 0.018 e−4≈0.018
- 轨迹 C:距离 = 5.0 → e − 25 ≈ 0 e^{-25} \approx 0 e−25≈0
归一化后:
y
A
≈
0.98
,
y
B
≈
0.02
,
y
C
≈
0
y_A \approx 0.98, \quad y_B \approx 0.02, \quad y_C \approx 0
yA≈0.98,yB≈0.02,yC≈0
所以 y i y_i yi 就是"第 i i i 条轨迹有多好"的软标签。Ranker 预测一个概率分布 S ^ i m \hat{S}_i^m S^im(通常是 Softmax 后的分数),然后用交叉熵让它学会匹配这个软标签。
作用:让 Ranker 学会排序——哪条轨迹更接近人类驾驶的真值。
第二部分: ∑ m , i BCE ( S i m , S ^ i m ) \sum_{m,i} \text{BCE}(S_i^m, \hat{S}_i^m) ∑m,iBCE(Sim,S^im) —— 教 Ranker “每条轨迹在每个指标上具体得多少分”
BCE 是 Binary Cross Entropy:
BCE ( S , S ^ ) = − [ S ⋅ log ( S ^ ) + ( 1 − S ) ⋅ log ( 1 − S ^ ) ] \text{BCE}(S, \hat{S}) = -[S \cdot \log(\hat{S}) + (1-S) \cdot \log(1-\hat{S})] BCE(S,S^)=−[S⋅log(S^)+(1−S)⋅log(1−S^)]
这里:
- S i m S_i^m Sim:第 i i i 条轨迹在第 m m m 个指标上的真值分数(由规则规划器或仿真器给出,比如是否碰撞、是否舒适)。
- S ^ i m \hat{S}_i^m S^im:Ranker 预测的分数。
注意: S i m S_i^m Sim 不是 0/1 标签,而是连续值(比如 0 到 1 之间的分数)。BCE 在这里被扩展用于回归连续值(有时候也叫逻辑回归损失或 Focal Loss 的变体)。
作用:让 Ranker 不仅知道"哪条最好",还知道"好在哪"——具体在碰撞避免、舒适度、车道保持等每个子指标上的表现。
为什么要两个损失叠加?
| 损失 | 教 Ranker 什么 | 为什么需要 |
|---|---|---|
| 交叉熵(第一部分) | 相对排序:哪条轨迹最接近真值 | 确保选出的轨迹是人类会开的 |
| BCE(第二部分) | 绝对分数:每条轨迹在每个安全指标上的具体得分 | 让 Ranker 理解"为什么好/坏",而不是盲目模仿 |
打个比方:
- 第一部分像老师告诉学生"这道题选 A"——直接给答案。
- 第二部分像老师解释"A 为什么对,B 为什么错"——教理解。
两个加起来,Ranker 既能选出好轨迹,又知道好在哪里。
推理时怎么用?
训练完后,Ranker 给每条候选轨迹在每个指标 m m m 上打一个分 S ^ i m \hat{S}_i^m S^im。然后按权重组合(比如 PDMS 的公式)算总分,选最高的那条作为最终输出。
一句话总结
- PRNorm:把大小不一的残差"统一尺码"到 [ − γ , γ ] [-\gamma, \gamma] [−γ,γ],让远近航点平起平坐。
- Ranker Loss:第一部分教"哪条最好"(软标签交叉熵),第二部分教"好在哪"(指标分数 BCE),双管齐下选出最优轨迹。
问题3:BCE损失
BCE
(
S
,
S
^
)
=
−
[
S
⋅
log
(
S
^
)
+
(
1
−
S
)
⋅
log
(
1
−
S
^
)
]
\text{BCE}(S, \hat{S}) = -[S \cdot \log(\hat{S}) + (1-S) \cdot \log(1-\hat{S})]
BCE(S,S^)=−[S⋅log(S^)+(1−S)⋅log(1−S^)] 这什么意思?
这个公式是二元交叉熵(Binary Cross Entropy),它是用来衡量"你预测得有多准"的。
我把它拆成你一眼就能看懂的样子。
一、先别管公式,看一个猜硬币的游戏
我在心里想一个结果:正面(记为 1)或反面(记为 0)。
你来猜一个概率,比如你说"我觉得正面概率是 0.8"。
情况 A:结果真的是正面(真值 = 1)
你猜了 0.8,离 1 比较近,应该罚得轻。
如果公式只保留第一项:
−
1
⋅
log
(
0.8
)
=
−
log
(
0.8
)
≈
0.223
-1 \cdot \log(0.8) = -\log(0.8) \approx 0.223
−1⋅log(0.8)=−log(0.8)≈0.223
情况 B:结果真的是反面(真值 = 0)
你猜了 0.8,但真值是 0,应该罚得重。
公式只保留第二项:
−
(
1
−
0
)
⋅
log
(
1
−
0.8
)
=
−
log
(
0.2
)
≈
1.609
-(1-0) \cdot \log(1-0.8) = -\log(0.2) \approx 1.609
−(1−0)⋅log(1−0.8)=−log(0.2)≈1.609
对比:猜错了(1.609)比猜对了(0.223)罚得重得多,这就是 BCE 在做的事——预测越离谱,惩罚越大。
二、公式里的两个字母是什么意思
BCE ( S , S ^ ) = − [ S ⋅ log ( S ^ ) + ( 1 − S ) ⋅ log ( 1 − S ^ ) ] \text{BCE}(S, \hat{S}) = -[S \cdot \log(\hat{S}) + (1-S) \cdot \log(1-\hat{S})] BCE(S,S^)=−[S⋅log(S^)+(1−S)⋅log(1−S^)]
| 符号 | 名字 | 含义 |
|---|---|---|
| S S S | 真值(Ground Truth) | 这件事实际上是不是发生了。在标准二分类里, S S S 只能是 0 或 1。 |
| S ^ \hat{S} S^ | 预测值(Prediction) | 模型说"这件事发生的概率是多少"。必须是 0~1 之间的数。 |
| log \log log | 对数 | 数学上的"惩罚放大器"。越接近 0, log \log log 负得越厉害。 |
三、为什么公式是"两项相加"?因为它要覆盖两种情况
这个公式其实是一个开关:
当 S = 1 S = 1 S=1(真值是"发生了")
1 − S = 0 1-S = 0 1−S=0,第二项直接消失:
BCE = − [ 1 ⋅ log ( S ^ ) + 0 ] = − log ( S ^ ) \text{BCE} = -[1 \cdot \log(\hat{S}) + 0] = -\log(\hat{S}) BCE=−[1⋅log(S^)+0]=−log(S^)
- 你预测 S ^ = 0.99 \hat{S} = 0.99 S^=0.99(很有信心是正面): − log ( 0.99 ) ≈ 0.01 -\log(0.99) \approx 0.01 −log(0.99)≈0.01 → 罚得轻
- 你预测 S ^ = 0.01 \hat{S} = 0.01 S^=0.01(很有信心是反面): − log ( 0.01 ) ≈ 4.6 -\log(0.01) \approx 4.6 −log(0.01)≈4.6 → 罚得重
当 S = 0 S = 0 S=0(真值是"没发生")
S = 0 S = 0 S=0,第一项直接消失:
BCE = − [ 0 + 1 ⋅ log ( 1 − S ^ ) ] = − log ( 1 − S ^ ) \text{BCE} = -[0 + 1 \cdot \log(1-\hat{S})] = -\log(1-\hat{S}) BCE=−[0+1⋅log(1−S^)]=−log(1−S^)
- 你预测 S ^ = 0.01 \hat{S} = 0.01 S^=0.01(很有信心是反面): − log ( 0.99 ) ≈ 0.01 -\log(0.99) \approx 0.01 −log(0.99)≈0.01 → 罚得轻
- 你预测 S ^ = 0.99 \hat{S} = 0.99 S^=0.99(很有信心是正面): − log ( 0.01 ) ≈ 4.6 -\log(0.01) \approx 4.6 −log(0.01)≈4.6 → 罚得重
所以公式里的 ( 1 − S ) (1-S) (1−S) 就是一个开关:真值是 1 时听左边,真值是 0 时听右边。
四、在 ResAD 里, S S S 不是 0 或 1,而是 0~1 之间的分数
这是论文中一个特殊的地方。Trajectory Ranker 里的 S i m S_i^m Sim 不是"碰撞了没"这种 0/1 标签,而是规则规划器打出的连续分数,比如:
- 这条轨迹的舒适度得分:0.85
- 这条轨迹的可行驶区域合规度:0.92
这时候 S S S 是 0.85, S ^ \hat{S} S^ 是模型预测的 0.80。
两项都同时有贡献:
- 第一项: 0.85 ⋅ log ( 0.80 ) 0.85 \cdot \log(0.80) 0.85⋅log(0.80) → “你预测 0.8,但真值是 0.85,第一项觉得你偏低了”
- 第二项: 0.15 ⋅ log ( 0.20 ) 0.15 \cdot \log(0.20) 0.15⋅log(0.20) → “真值里还有 0.15 的’非 0.85’成分,第二项也在监督你”
直观理解:当 S S S 是 0.85 这种"软标签"时,BCE 同时从"正向"和"负向"两个角度拉你,让你的预测 S ^ \hat{S} S^ 向 0.85 靠拢。
五、一个数值例子
假设 Ranker 预测某条轨迹的"无碰撞"分数:
| 数值 | |
|---|---|
| 真值分数 S S S | 0.9(规则规划器说:这条轨迹 90% 是安全的) |
| 模型预测 S ^ \hat{S} S^ | 0.7(Ranker 说:我觉得 70% 安全) |
代入:
BCE = − [ 0.9 ⋅ log ( 0.7 ) + 0.1 ⋅ log ( 0.3 ) ] \text{BCE} = -[0.9 \cdot \log(0.7) + 0.1 \cdot \log(0.3)] BCE=−[0.9⋅log(0.7)+0.1⋅log(0.3)]
= − [ 0.9 ⋅ ( − 0.357 ) + 0.1 ⋅ ( − 1.204 ) ] = -[0.9 \cdot (-0.357) + 0.1 \cdot (-1.204)] =−[0.9⋅(−0.357)+0.1⋅(−1.204)]
= − [ − 0.321 − 0.120 ] = -[-0.321 - 0.120] =−[−0.321−0.120]
= − [ − 0.441 ] = 0.441 = -[-0.441] = 0.441 =−[−0.441]=0.441
如果模型预测得更准,比如 S ^ = 0.9 \hat{S} = 0.9 S^=0.9:
BCE = − [ 0.9 ⋅ log ( 0.9 ) + 0.1 ⋅ log ( 0.1 ) ] \text{BCE} = -[0.9 \cdot \log(0.9) + 0.1 \cdot \log(0.1)] BCE=−[0.9⋅log(0.9)+0.1⋅log(0.1)]
= − [ 0.9 ⋅ ( − 0.105 ) + 0.1 ⋅ ( − 2.303 ) ] = -[0.9 \cdot (-0.105) + 0.1 \cdot (-2.303)] =−[0.9⋅(−0.105)+0.1⋅(−2.303)]
= − [ − 0.095 − 0.230 ] = 0.325 = -[-0.095 - 0.230] = 0.325 =−[−0.095−0.230]=0.325
0.325 < 0.441,预测越准,Loss 越小。
六、一句话总结
BCE 就是一个打分器:模型预测的概率和真值越接近,Loss 越小;越离谱,Loss 越大(而且是指数级变大)。公式里的两项是"开关",确保无论真值是 0 还是 1,都能准确惩罚。
问题4:交叉熵损失
交叉熵损失本来是怎么样的,现在又是怎么改的?
好,这个问题问到了本质。ResAD 的 Ranker 损失第一部分确实是从标准交叉熵改过来的,但改了非常关键的一点。
一、标准交叉熵:分类问题的"非黑即白"
原始场景(图像分类)
假设一个模型要识别图片里的动物,有 3 个类别:猫、狗、鸟。
某张图片实际上是猫(真值)。在标准交叉熵里,这个真值被编码成 one-hot 向量:
y = [ 1 , 0 , 0 ] y = [1, 0, 0] y=[1,0,0]
- 猫:1(是)
- 狗:0(不是)
- 鸟:0(不是)
模型预测了一个概率分布(经过 softmax):
S ^ = [ 0.7 , 0.2 , 0.1 ] \hat{S} = [0.7, 0.2, 0.1] S^=[0.7,0.2,0.1]
标准交叉熵公式:
L = − ∑ i y i ⋅ log ( S ^ i ) L = -\sum_{i} y_i \cdot \log(\hat{S}_i) L=−i∑yi⋅log(S^i)
代入:
L = − [ 1 ⋅ log ( 0.7 ) + 0 ⋅ log ( 0.2 ) + 0 ⋅ log ( 0.1 ) ] = − log ( 0.7 ) ≈ 0.357 L = -[1 \cdot \log(0.7) + 0 \cdot \log(0.2) + 0 \cdot \log(0.1)] = -\log(0.7) \approx 0.357 L=−[1⋅log(0.7)+0⋅log(0.2)+0⋅log(0.1)]=−log(0.7)≈0.357
关键特征:
| 特征 | 说明 |
|---|---|
| 标签是 0 或 1 | 只有"是"或"不是",没有中间状态 |
| 只有一个 1 | 图片里只能有一种动物,答案唯一 |
| 目标 | 让模型把概率质量全部堆到那个为 1 的类别上 |
二、ResAD 的改造:轨迹没有唯一正确答案,只有"多接近"
核心矛盾
自动驾驶的轨迹生成不是单选题。
假设生成了 3 条候选轨迹:
- 轨迹 A:几乎和真值一模一样(人类就是这么开的)
- 轨迹 B:稍微偏左了一点,但也能安全通过
- 轨迹 C:直接往墙上撞
这三条轨迹不能简单用 [1, 0, 0] 来标记。因为:
- B 虽然不如 A 好,但绝不是和 C 一样糟
- 如果强行给 A 标 1、B 和 C 标 0,模型会把 B 和 C 同等对待,这很荒谬
ResAD 的修改:把 one-hot 改成 “软标签(Soft Label)”
ResAD 用与真值轨迹的距离来给每条候选轨迹打分:
y i = e − ( τ g t − τ ^ i ) 2 ∑ j = 1 k e − ( τ g t − τ ^ j ) 2 y_i = \frac{e^{-(\tau_{gt} - \hat{\tau}_i)^2}}{\sum_{j=1}^{k} e^{-(\tau_{gt} - \hat{\tau}_j)^2}} yi=∑j=1ke−(τgt−τ^j)2e−(τgt−τ^i)2
假设三条轨迹与真值的距离:
- A:距离 0.1 米 → e − 0.01 ≈ 0.99 e^{-0.01} \approx 0.99 e−0.01≈0.99
- B:距离 2.0 米 → e − 4 ≈ 0.018 e^{-4} \approx 0.018 e−4≈0.018
- C:距离 10.0 米 → e − 100 ≈ 0 e^{-100} \approx 0 e−100≈0
归一化后软标签:
y
=
[
0.98
,
0.02
,
0.00
]
y = [0.98, 0.02, 0.00]
y=[0.98,0.02,0.00]
看到了吗? 这不是 [1,0,0],而是连续分布。A 最好,B 凑合,C 滚蛋。
修改后的"交叉熵"
ResAD 的 Ranker 损失第一部分(本质):
L = − ∑ i = 1 k y i ⋅ log ( S ^ i ) L = -\sum_{i=1}^{k} y_i \cdot \log(\hat{S}_i) L=−i=1∑kyi⋅log(S^i)
- y i y_i yi:软标签(基于距离的权重,和为 1)
- S ^ i \hat{S}_i S^i:Ranker 预测的第 i i i 条轨迹的分数(softmax 后,和为 1)
它要求模型输出的概率分布,去匹配这个软标签分布。
三、直观对比:标准 vs ResAD 改造
| 标准交叉熵 | ResAD 改造版 | |
|---|---|---|
| 标签 y y y | one-hot:[1,0,0] | 软标签:[0.98, 0.02, 0.00] |
| 真值含义 | “第 2 类是正确答案” | “第 2 条最接近真值,第 3 条也还行,第 1 条不行” |
| 预测 S ^ \hat{S} S^ | 各类别概率 | 各轨迹的相对分数(softmax 后) |
| 优化目标 | 把概率全部压到唯一正确类 | 把概率按"接近真值的程度"分配 |
| 错误惩罚 | 错把 B 当 A,和错把 C 当 A,惩罚一样重 | 错把 B 当 A(惩罚轻),错把 C 当 A(惩罚重) |
为什么这个改造很重要?
因为轨迹是连续空间里的回归问题,不是离散类别。
- 标准交叉熵:B 和 C 都是"错",同等惩罚。
- ResAD 软标签:B 只是"不够好",C 是"灾难",惩罚有轻重。
这相当于告诉模型:你要学会排序,知道 A > B > C,而不是只认一个死答案。
四、一个具体例子
假设 Ranker 对 3 条轨迹打分(softmax 前是 logits,softmax 后):
情况 1:模型学得很好
预测分布
S
^
=
[
0.95
,
0.04
,
0.01
]
\hat{S} = [0.95, 0.04, 0.01]
S^=[0.95,0.04,0.01]
软标签
y
=
[
0.98
,
0.02
,
0.00
]
y = [0.98, 0.02, 0.00]
y=[0.98,0.02,0.00]
L = − [ 0.98 ⋅ log ( 0.95 ) + 0.02 ⋅ log ( 0.04 ) + 0 ⋅ log ( 0.01 ) ] ≈ 0.05 L = -[0.98 \cdot \log(0.95) + 0.02 \cdot \log(0.04) + 0 \cdot \log(0.01)] \approx 0.05 L=−[0.98⋅log(0.95)+0.02⋅log(0.04)+0⋅log(0.01)]≈0.05
情况 2:模型搞混了,觉得 B 最好
预测分布
S
^
=
[
0.10
,
0.80
,
0.10
]
\hat{S} = [0.10, 0.80, 0.10]
S^=[0.10,0.80,0.10]
L = − [ 0.98 ⋅ log ( 0.10 ) + 0.02 ⋅ log ( 0.80 ) + 0 ⋅ log ( 0.10 ) ] ≈ 2.27 L = -[0.98 \cdot \log(0.10) + 0.02 \cdot \log(0.80) + 0 \cdot \log(0.10)] \approx 2.27 L=−[0.98⋅log(0.10)+0.02⋅log(0.80)+0⋅log(0.10)]≈2.27
Loss 大了几十倍,因为模型把高概率给了"离真值 2 米"的 B,而没给"离真值 0.1 米"的 A。
五、一句话总结
标准交叉熵是"单选题,只有一个正确答案,其他都是零分";ResAD 的改造版是"排序题,每条轨迹有不同程度的正确性,模型要学会按接近真值的程度分配概率"。
这个改造让 Ranker 不仅能选出最好的轨迹,还能理解"为什么这条比那条好"——因为它被训练去拟合一个连续的优劣分布,而不是一个非黑即白的标签。
问题5:softmax公式
本来的softmax公式是什么样的,改了哪里
一、标准 Softmax:把"分数"变成"概率"
公式
softmax ( z i ) = e z i ∑ j = 1 k e z j \text{softmax}(z_i) = \frac{e^{z_i}}{\sum_{j=1}^{k} e^{z_j}} softmax(zi)=∑j=1kezjezi
用在哪?
神经网络输出层。模型对 k k k 个类别分别打出一个"原始分数"(logits) z i z_i zi,softmax 把它们压成概率分布(和为 1)。
例子
识别动物,模型输出 logits:
- 猫: z 1 = 2.0 z_1 = 2.0 z1=2.0
- 狗: z 2 = 1.0 z_2 = 1.0 z2=1.0
- 鸟: z 3 = 0.1 z_3 = 0.1 z3=0.1
softmax = [ e 2.0 e 2.0 + e 1.0 + e 0.1 , e 1.0 e 2.0 + e 1.0 + e 0.1 , e 0.1 e 2.0 + e 1.0 + e 0.1 ] ≈ [ 0.66 , 0.24 , 0.10 ] \text{softmax} = \left[\frac{e^{2.0}}{e^{2.0}+e^{1.0}+e^{0.1}}, \frac{e^{1.0}}{e^{2.0}+e^{1.0}+e^{0.1}}, \frac{e^{0.1}}{e^{2.0}+e^{1.0}+e^{0.1}}\right] \approx [0.66, 0.24, 0.10] softmax=[e2.0+e1.0+e0.1e2.0,e2.0+e1.0+e0.1e1.0,e2.0+e1.0+e0.1e0.1]≈[0.66,0.24,0.10]
核心作用:谁的分数高,谁就抢更多概率。 e e e 的指数会放大差距,让最高分更突出。
二、ResAD 的 y i y_i yi:看起来很像,但完全不是一回事
公式
y i = e − ( τ g t − τ ^ i ) 2 ∑ j = 1 k e − ( τ g t − τ ^ j ) 2 y_i = \frac{e^{-(\tau_{gt} - \hat{\tau}_i)^2}}{\sum_{j=1}^{k} e^{-(\tau_{gt} - \hat{\tau}_j)^2}} yi=∑j=1ke−(τgt−τ^j)2e−(τgt−τ^i)2
用在哪?
不是模型输出层,而是生成训练标签!
它是在说:“给定 k k k 条候选轨迹,根据它们与真值轨迹的距离,给每条分配一个’软权重’,作为 Ranker 的学习目标。”
对比:输入不同
| 标准 Softmax | ResAD 的 y i y_i yi | |
|---|---|---|
| 输入 | 模型输出的 logits z i z_i zi(可正可负,任意大小) | 轨迹与真值的负平方距离 − ( τ g t − τ ^ i ) 2 -(\tau_{gt} - \hat{\tau}_i)^2 −(τgt−τ^i)2 |
| 谁算的 | 神经网络 forward | 数据预处理/标签生成 |
| 目的 | 把模型分数变成概率 | 把几何距离变成软标签 |
| 训练时 | 是预测值 S ^ \hat{S} S^ | 是真值 y y y |
三、为什么形式像,但本质不同?
两者都用了 e x i ∑ e x j \frac{e^{x_i}}{\sum e^{x_j}} ∑exjexi 的形式,但:
标准 Softmax: e 分数 e^{\text{分数}} e分数
- 分数越高 → e 大 e^{\text{大}} e大 → 概率越大
- 是"竞争机制":模型认为谁强,就给谁更多概率
ResAD y i y_i yi: e − 距离 2 e^{-\text{距离}^2} e−距离2
- 距离越近 → 负平方越大(比如距离 0.1 → − 0.01 -0.01 −0.01;距离 5 → − 25 -25 −25)→ e x e^{x} ex 越大
- 是"相似度机制":离真值越近的轨迹,权重越高
注意:ResAD 的 y i y_i yi 公式里没有模型参数,它纯粹是用几何距离给轨迹"人工打分"。
四、一个具体例子看区别
假设有 3 条候选轨迹,与真值轨迹的 L2 距离:
| 轨迹 | 与真值距离 | 负平方距离 |
|---|---|---|
| A | 0.1 米 | − 0.01 -0.01 −0.01 |
| B | 1.0 米 | − 1.0 -1.0 −1.0 |
| C | 5.0 米 | − 25 -25 −25 |
计算 y i y_i yi:
- e − 0.01 ≈ 0.990 e^{-0.01} \approx 0.990 e−0.01≈0.990
- e − 1.0 ≈ 0.368 e^{-1.0} \approx 0.368 e−1.0≈0.368
- e − 25 ≈ 0.000 e^{-25} \approx 0.000 e−25≈0.000
归一化:
y A = 0.990 0.990 + 0.368 + 0.000 ≈ 0.73 y_A = \frac{0.990}{0.990+0.368+0.000} \approx 0.73 yA=0.990+0.368+0.0000.990≈0.73
y B = 0.368 1.358 ≈ 0.27 y_B = \frac{0.368}{1.358} \approx 0.27 yB=1.3580.368≈0.27
y C ≈ 0.00 y_C \approx 0.00 yC≈0.00
软标签: [ 0.73 , 0.27 , 0.00 ] [0.73, 0.27, 0.00] [0.73,0.27,0.00]
现在看 Ranker 的模型输出(标准 softmax 作用的地方):
Ranker 对这 3 条轨迹打 logits: [ 1.5 , 0.5 , − 1.0 ] [1.5, 0.5, -1.0] [1.5,0.5,−1.0]
经过 softmax:
S ^ = [ 0.62 , 0.23 , 0.15 ] \hat{S} = [0.62, 0.23, 0.15] S^=[0.62,0.23,0.15]
交叉熵损失:
L = − ∑ y i log ( S ^ i ) = − [ 0.73 ⋅ log ( 0.62 ) + 0.27 ⋅ log ( 0.23 ) + 0 ⋅ log ( 0.15 ) ] L = -\sum y_i \log(\hat{S}_i) = -[0.73 \cdot \log(0.62) + 0.27 \cdot \log(0.23) + 0 \cdot \log(0.15)] L=−∑yilog(S^i)=−[0.73⋅log(0.62)+0.27⋅log(0.23)+0⋅log(0.15)]
五、一句话总结改动
标准 Softmax 是"模型说谁厉害,概率就给谁";ResAD 的 y i y_i yi 是"谁离真值近,软标签就给谁高分"。
形式上都是 e x ∑ e x \frac{e^{x}}{\sum e^{x}} ∑exex,但:
- Softmax 的 x x x 是模型分数(预测值)
- ResAD y i y_i yi 的 x x x 是负平方距离(真值标签)
ResAD 把 softmax 的"竞争思想"借过来,用来生成训练目标,而不是归一化模型输出。
问题6:softmax函数的图
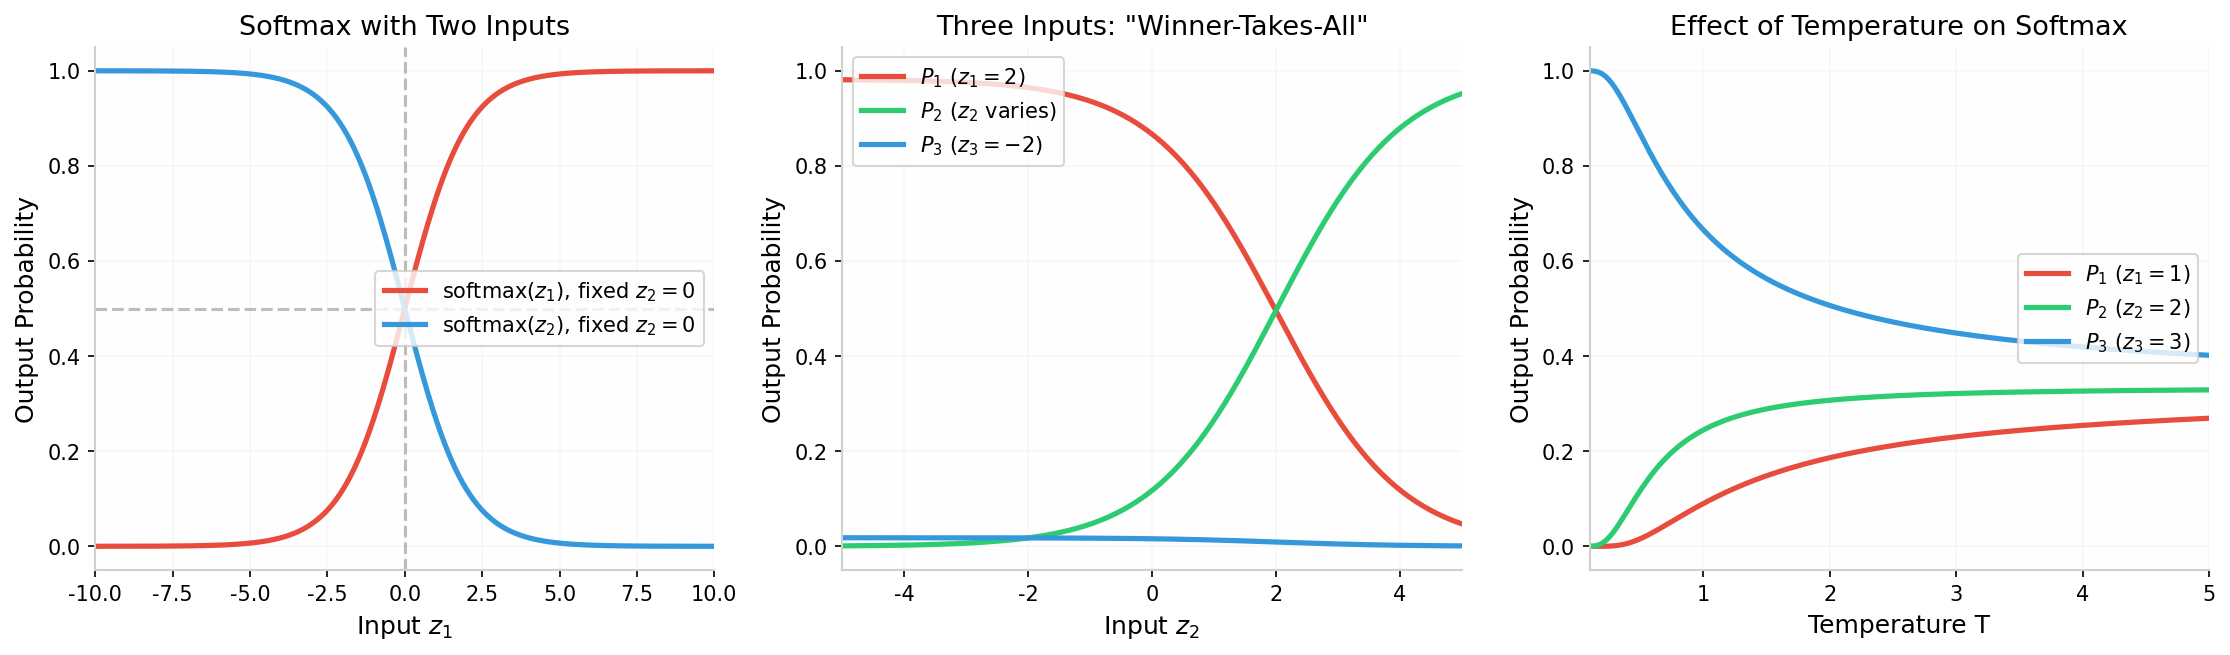
三张图分别说明什么
图 1:两个输入时的 Softmax(S 型曲线)
固定 z 2 = 0 z_2 = 0 z2=0,让 z 1 z_1 z1 从 -10 变到 +10。
- 红线: z 1 z_1 z1 获得概率。当 z 1 ≪ 0 z_1 \ll 0 z1≪0 时,概率 ≈ 0;当 z 1 ≫ 0 z_1 \gg 0 z1≫0 时,概率 ≈ 1。
- 蓝线: z 2 z_2 z2 获得概率。与红线镜像对称。
- 交叉点: z 1 = z 2 = 0 z_1 = z_2 = 0 z1=z2=0 时,各得 0.5。
关键观察:Softmax 在两端是平坦饱和的(概率压到 0 或 1),中间是急剧过渡的。这和 Sigmoid 函数形状几乎一样。
图 2:三个输入时的"赢家通吃"(Winner-Takes-All)
固定 z 1 = 2 z_1 = 2 z1=2, z 3 = − 2 z_3 = -2 z3=−2,让 z 2 z_2 z2 从 -5 变到 +5。
- 红线 P 1 P_1 P1:当 z 2 z_2 z2 很小时, P 1 P_1 P1 接近 1.0(它是最高分)。
- 绿线 P 2 P_2 P2:当 z 2 z_2 z2 逐渐增大并超过 z 1 = 2 z_1=2 z1=2 时, P 2 P_2 P2 迅速从 0 爬升到接近 1.0,同时 P 1 P_1 P1 迅速跌落。
- 蓝线 P 3 P_3 P3:因为 z 3 = − 2 z_3 = -2 z3=−2 始终是最低分,它的概率几乎全程被压在 0 附近。
关键观察:Softmax 不是"按分数比例分配概率",而是指数级放大差距。最高分抢走了绝大部分概率,低分几乎被清零。这就是"赢家通吃"。
图 3:温度参数 T 的作用
固定三个分数 [ 1 , 2 , 3 ] [1, 2, 3] [1,2,3],改变温度 T T T:
- T → 0 T \to 0 T→0(低温):概率极度尖锐。 z 3 = 3 z_3=3 z3=3 抢走了几乎全部概率(接近 1.0), z 1 = 1 z_1=1 z1=1 几乎为 0。差距被指数放大。
- T T T 增大:概率逐渐"摊平"。三条曲线越来越靠近。
- T → ∞ T \to \infty T→∞(高温):所有概率趋于相等(都接近 1 / 3 1/3 1/3)。
关键观察:温度是 Softmax 的"锐度调节器"。
- 低温 = 很肯定,只信最高分
- 高温 = 很犹豫,大家差不多
一句话总结 Softmax 的图像特征
它是一组S 型曲线,核心能力是指数放大输入之间的差距,让最高分获得不成比例的高概率,低分被压制到接近零。温度越低,这个"赢家通吃"效应越极端。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 8
 0
- 0


 已为社区贡献2条内容

所有评论(0)