无人机航拍巡检利器:墙体、道路、桥梁裂缝图像分割数据集10052期
·
无人机航拍巡检利器:墙体、道路、桥梁裂缝图像分割数据集10052期
裂缝是建筑物与基础设施的“第一危险信号”,传统人工巡检效率低、漏检率高。无人机+深度学习裂缝识别正成为刚需,而高质量数据集是模型落地的基石。本文深度解析一个专注裂缝实例分割的开源数据集,附PyTorch加载与训练实战代码,助力建筑、道路、桥梁、隧道智能检测落地。
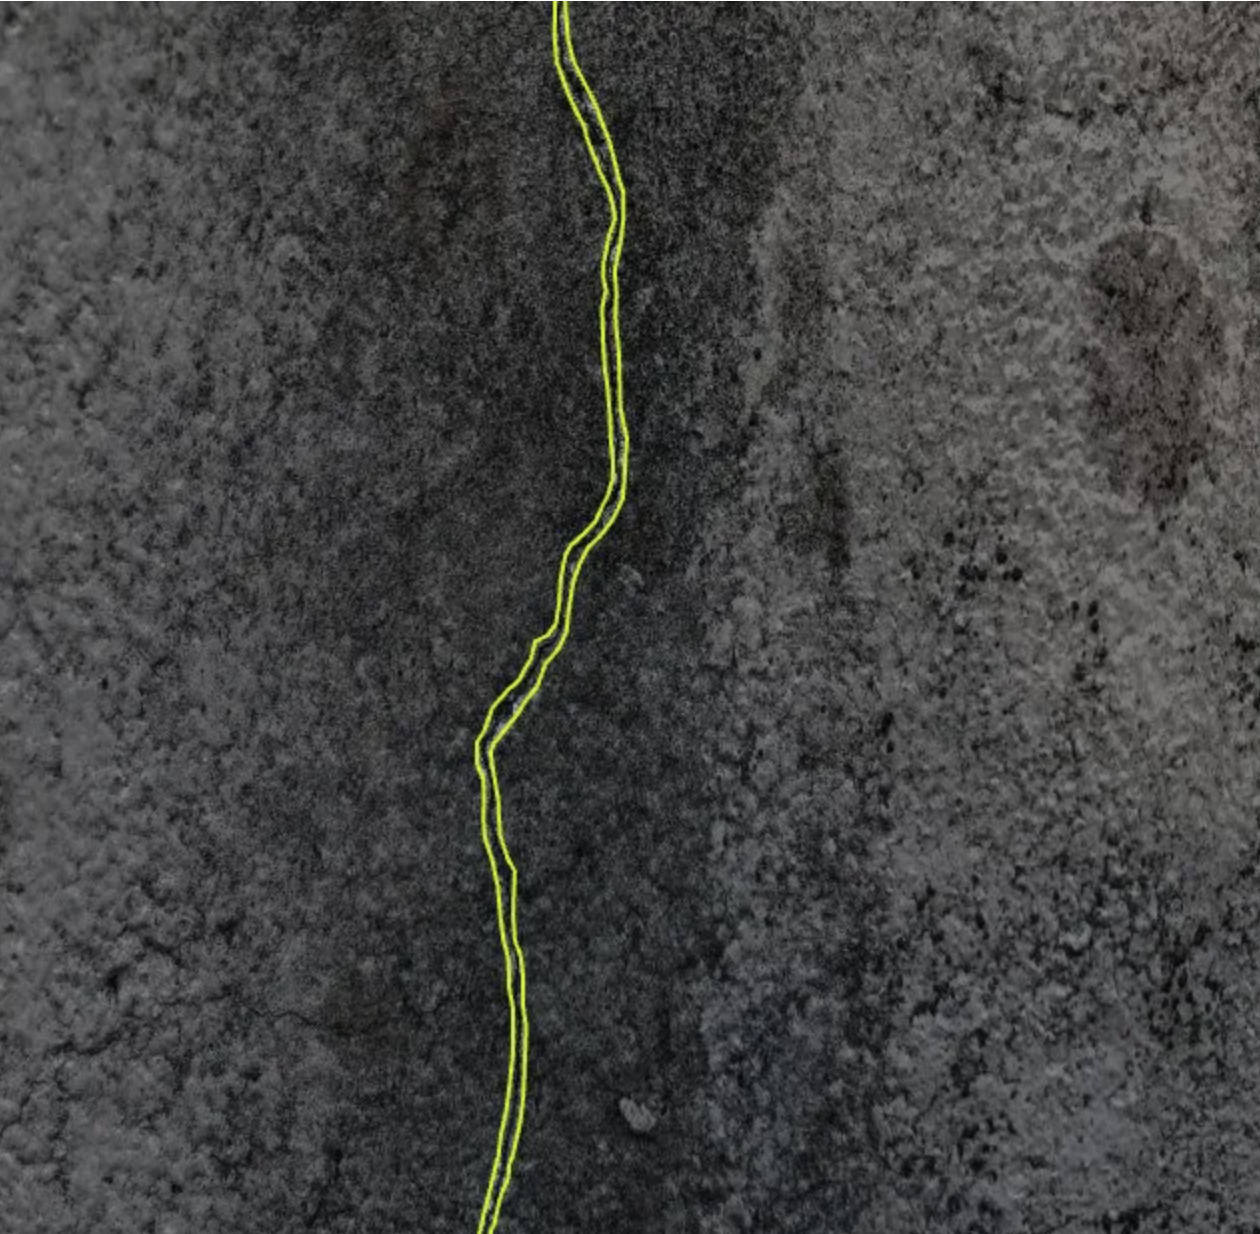
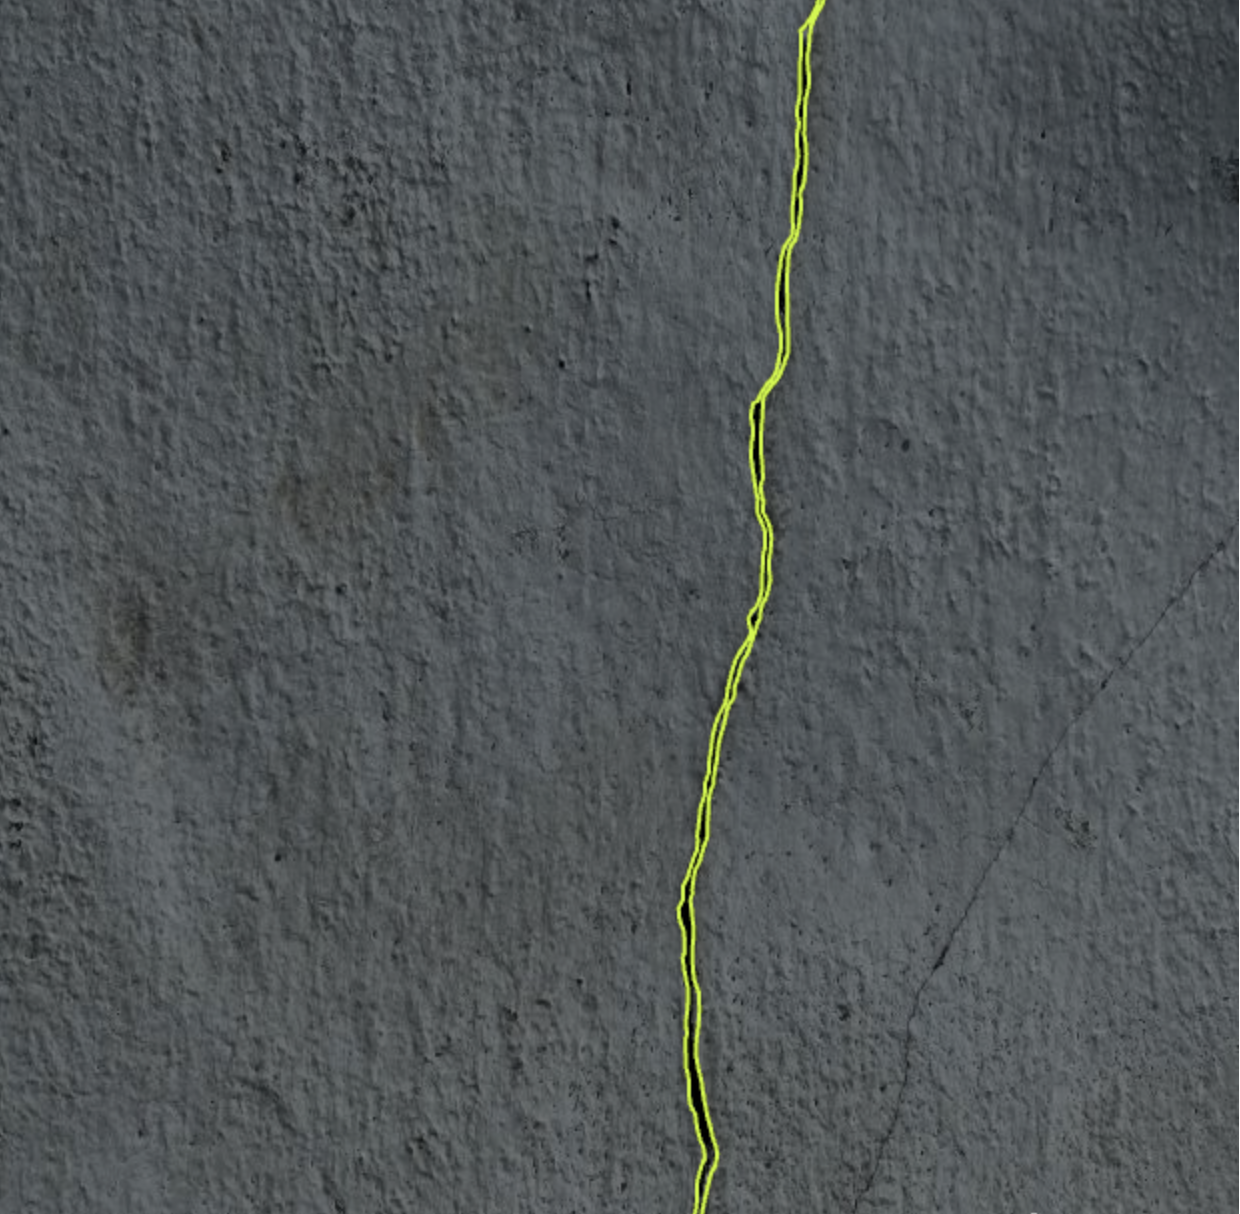
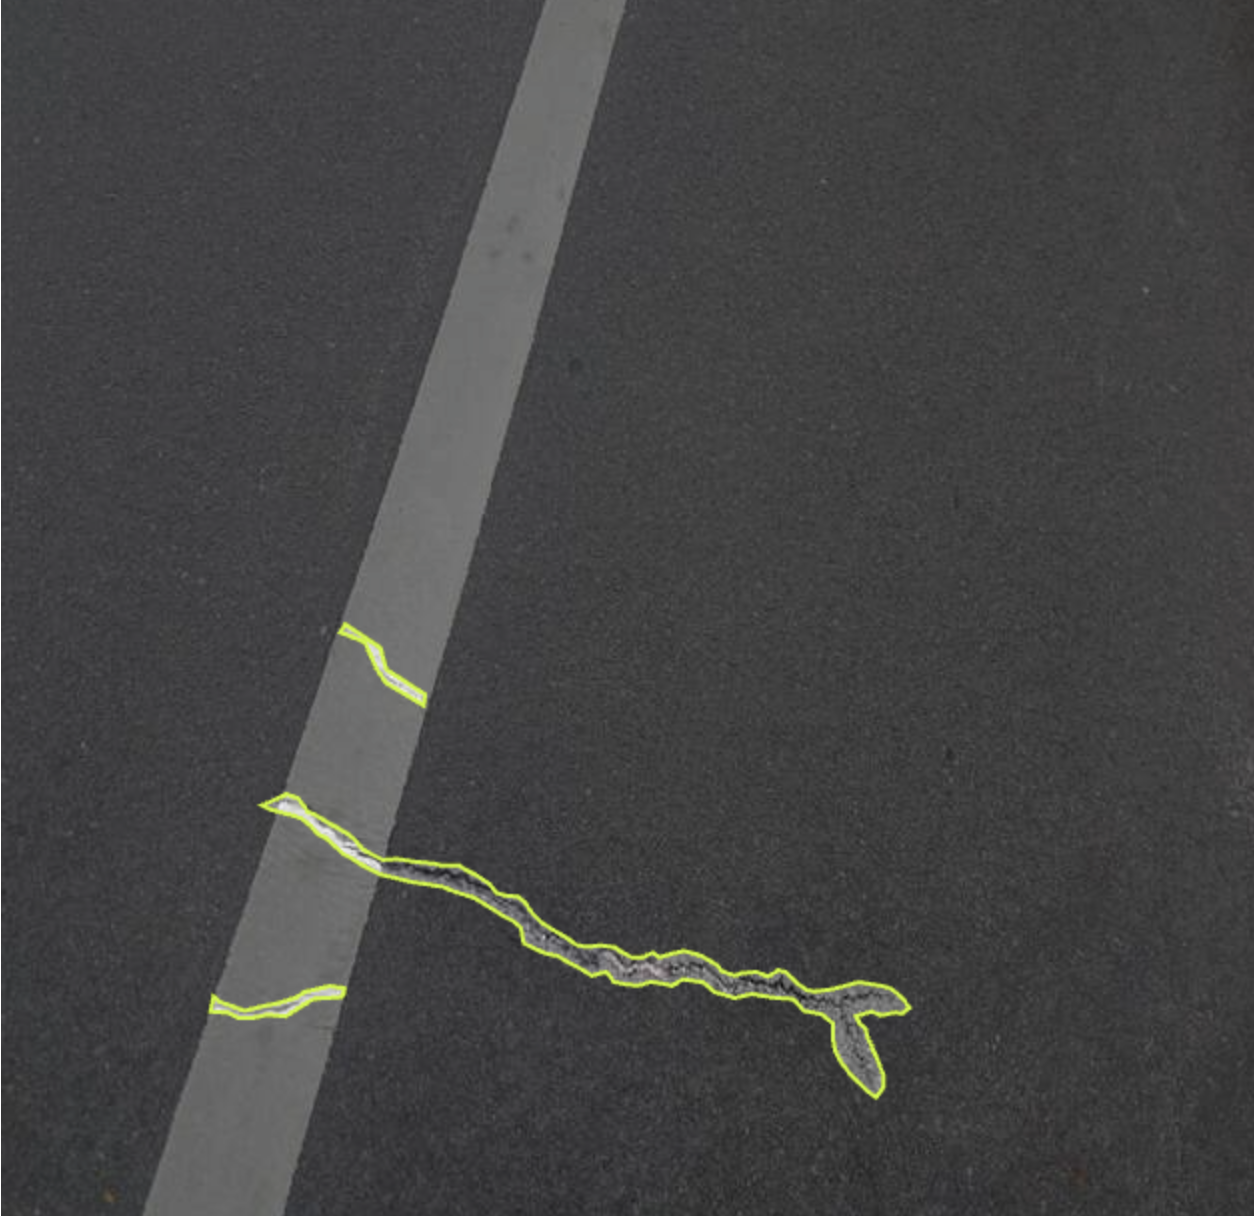
📊 数据集核心档案
| 属性 | 详情 |
|---|---|
| 数据集名称 | crack-seg (裂缝实例分割数据集) |
| 总图像量 | 1,272张 (约1.3K) |
| 标签类别 | 1类 —— crack (裂缝) |
| 任务类型 | 实例分割 (Instance Segmentation) |
| 潜在分辨率 | 预估为高清级 (如1024×768或更高) |
| 数据集划分 | 未明确划分 (建议自行按7:1.5:1.5分割) |
| 应用方向 | 墙体、道路、桥梁、隧道、工业设备裂缝检测 |
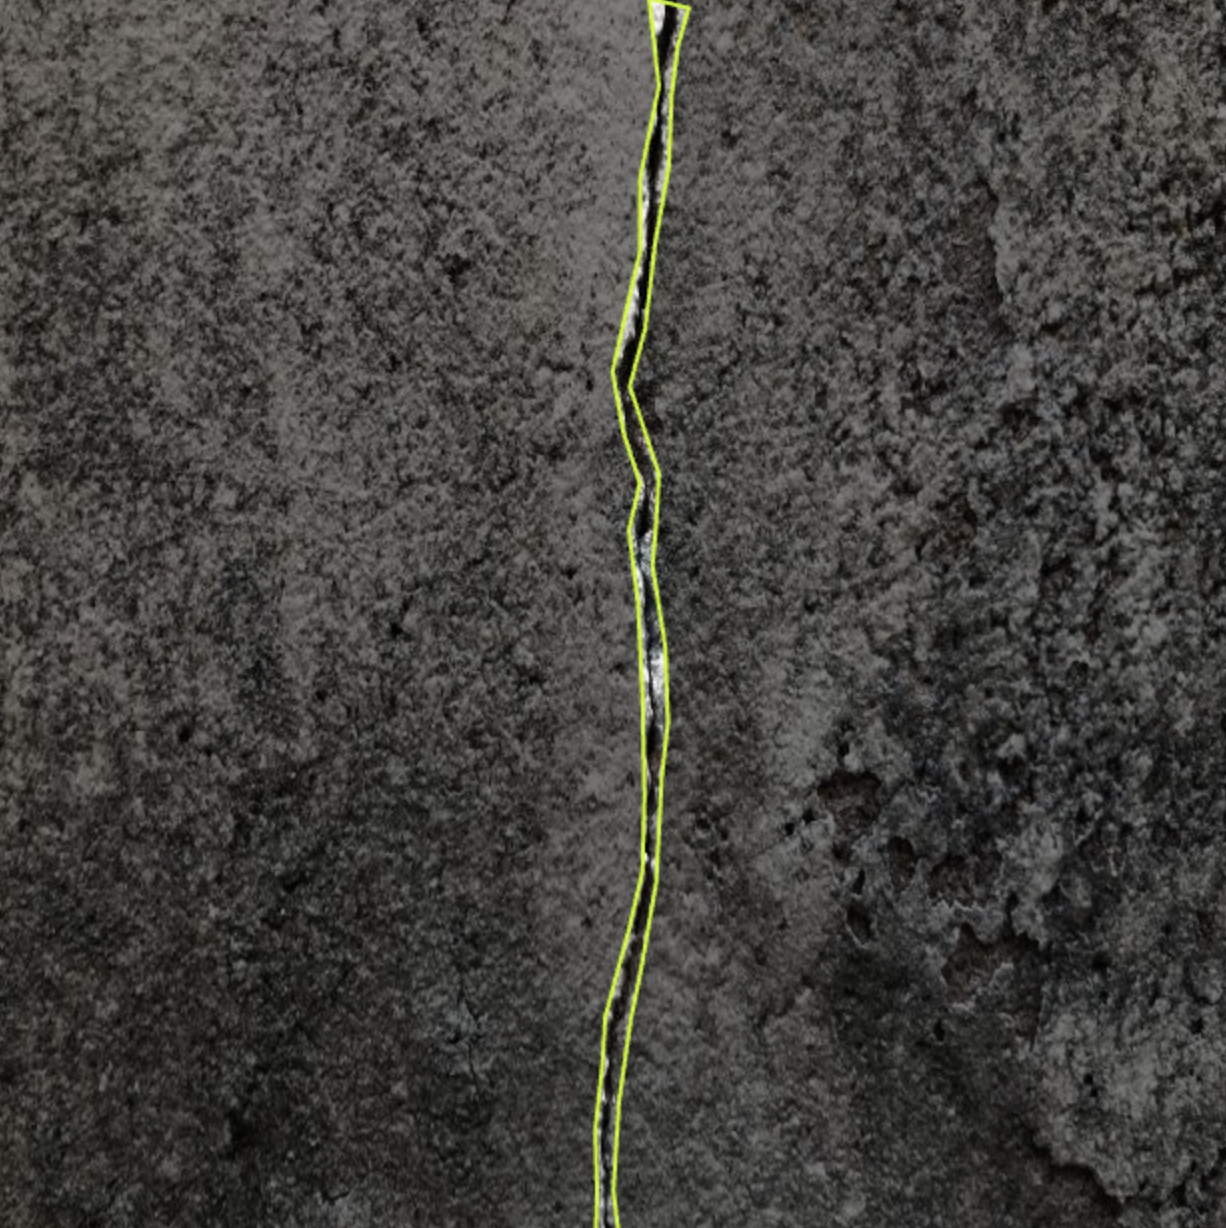
🔍 数据集深度剖析
🎯 专注单一类别,直击裂缝识别痛点
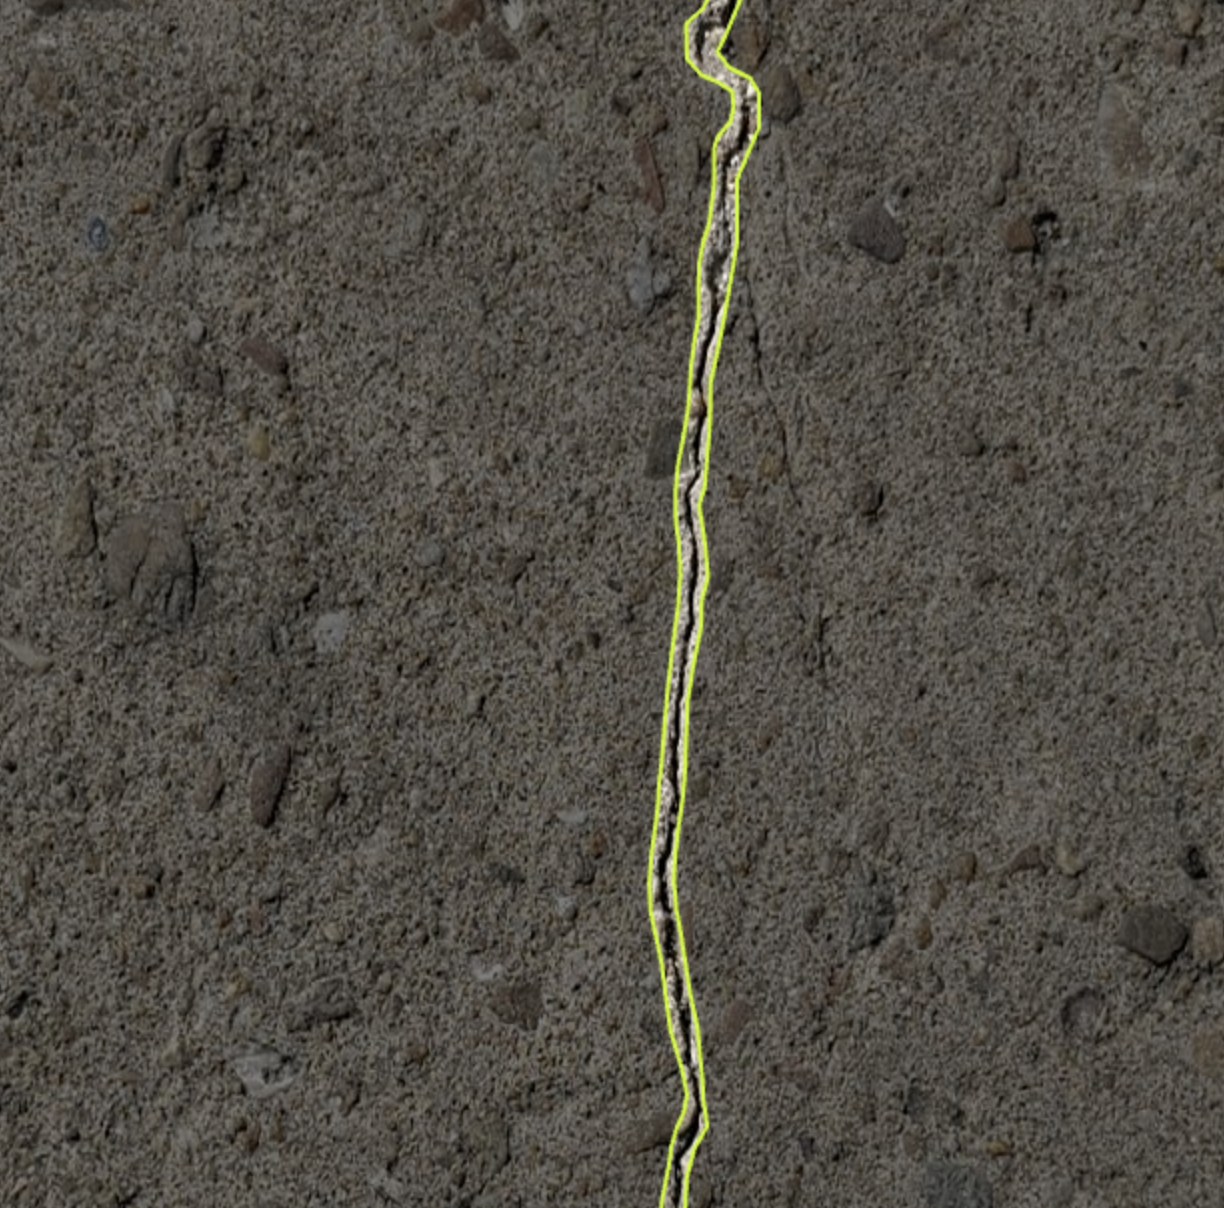
该数据集最大的特点在于极简的标签体系——仅包含“crack”一个类别。这种设计使模型能高度专注于裂缝的轮廓、纹理、边缘等细粒度特征,避免多类别干扰,特别适合裂缝形态复杂、背景多变(混凝土、沥青、金属表面等)的真实场景。
📈 数据规模与使用建议
1272张图像在深度学习分割任务中属于中小型数据集。直接训练深层网络(如Mask R-CNN、U-Net++)容易过拟合。建议策略:
- 数据增强:采用随机旋转、裁剪、亮度对比度调整、添加噪声等在线增强。
- 迁移学习:使用COCO或Cityscapes预训练权重微调。
- 自行划分:严格按场景或采集时间划分,确保测试集分布与训练集有差异,验证泛化性。
🧬 潜在应用场景扩展
除文章提到的建筑、道路、桥梁、隧道、工业设备外,该数据集还可用于:
- 自然灾害评估:地震后建筑物裂缝快速筛查。
- 古建筑保护:石刻、木结构细微裂缝监测。
- 水利设施:大坝、水渠表面裂缝检测。
🚀 实战代码:PyTorch加载与模型训练框架
以下提供完整的PyTorch数据加载与训练示例,采用U-Net架构(轻量级,适合小数据集),并加入迁移学习与数据增强策略。
# ============================================================
# 场景:无人机巡检裂缝实例分割 - 基于PyTorch的训练脚手架
# 功能:数据集加载、U-Net模型定义、训练循环、评估指标
# 依赖:torch, torchvision, PIL, opencv-python, numpy, albumentations
# ============================================================

import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader, Dataset, random_split
import torchvision.transforms as T
import cv2
import numpy as np
from PIL import Image
import os
from glob import glob
import albumentations as A  # 强大的数据增强库
from albumentations.pytorch import ToTensorV2

# -------------------- 1. 数据集类定义 --------------------
class CrackSegDataset(Dataset):
    """裂缝分割数据集类
    假设目录结构:
        data/
        ├── images/  # 原图 .jpg/.png
        └── masks/   # 分割掩码 .png (像素值0为背景,1为裂缝)
    """
    def __init__(self, image_dir, mask_dir, transform=None):
        self.image_paths = sorted(glob(os.path.join(image_dir, "*.*")))
        self.mask_paths = sorted(glob(os.path.join(mask_dir, "*.*")))
        self.transform = transform
        assert len(self.image_paths) == len(self.mask_paths), "图像与掩码数量不匹配!"

    def __len__(self):
        return len(self.image_paths)

    def __getitem__(self, idx):
        # 读取图像 (BGR转RGB)
        image = cv2.imread(self.image_paths[idx])
        image = cv2.cvtColor(image, cv2.COLOR_BGR2RGB)
        # 读取掩码 (灰度图)
        mask = cv2.imread(self.mask_paths[idx], cv2.IMREAD_GRAYSCALE)
        # 二值化:确保像素值为0或1 (假设裂缝区域为255或1)
        mask = (mask > 127).astype(np.uint8)  # 统一转为0/1

        # 应用数据增强
        if self.transform:
            augmented = self.transform(image=image, mask=mask)
            image = augmented['image']
            mask = augmented['mask']  # 保持HxW

        # 转换为Tensor (归一化由transform处理)
        return image, mask.unsqueeze(0).float()  # 添加通道维度 -> [1, H, W]

# -------------------- 2. 数据增强与预处理 --------------------
# 训练集增强策略:随机翻转、旋转、缩放、色彩抖动
train_transform = A.Compose([
    A.Resize(height=256, width=256),  # 统一尺寸
    A.RandomRotate90(p=0.5),
    A.Rotate(limit=30, p=0.5),
    A.HorizontalFlip(p=0.5),
    A.VerticalFlip(p=0.3),
    A.RandomBrightnessContrast(brightness_limit=0.2, contrast_limit=0.2, p=0.5),
    A.GaussNoise(var_limit=(10.0, 50.0), p=0.3),
    A.Normalize(mean=(0.485, 0.456, 0.406), std=(0.229, 0.224, 0.225)),  # ImageNet标准化
    ToTensorV2(),  # 转为Tensor并归一化到[0,1]
])

# 验证/测试集:仅进行尺寸调整和标准化
val_transform = A.Compose([
    A.Resize(height=256, width=256),
    A.Normalize(mean=(0.485, 0.456, 0.406), std=(0.229, 0.224, 0.225)),
    ToTensorV2(),
])

# -------------------- 3. U-Net模型 (简化版) --------------------
class DoubleConv(nn.Module):
    """双卷积块: Conv -> BN -> ReLU * 2"""
    def __init__(self, in_ch, out_ch):
        super().__init__()
        self.conv = nn.Sequential(
            nn.Conv2d(in_ch, out_ch, kernel_size=3, padding=1),
            nn.BatchNorm2d(out_ch),
            nn.ReLU(inplace=True),
            nn.Conv2d(out_ch, out_ch, kernel_size=3, padding=1),
            nn.BatchNorm2d(out_ch),
            nn.ReLU(inplace=True)
        )

    def forward(self, x):
        return self.conv(x)

class UNet(nn.Module):
    """U-Net架构,输入3通道RGB,输出1通道二值掩码"""
    def __init__(self, in_channels=3, out_channels=1, features=[64, 128, 256, 512]):
        super().__init__()
        self.encoder = nn.ModuleList()
        self.pool = nn.MaxPool2d(kernel_size=2, stride=2)
        # 编码器 (下采样)
        for feature in features:
            self.encoder.append(DoubleConv(in_channels, feature))
            in_channels = feature
        # 桥接层
        self.bottleneck = DoubleConv(features[-1], features[-1]*2)
        # 解码器 (上采样)
        self.upconvs = nn.ModuleList()
        self.decoders = nn.ModuleList()
        for feature in reversed(features):
            self.upconvs.append(nn.ConvTranspose2d(feature*2, feature, kernel_size=2, stride=2))
            self.decoders.append(DoubleConv(feature*2, feature))
        # 输出层
        self.final_conv = nn.Conv2d(features[0], out_channels, kernel_size=1)

    def forward(self, x):
        skip_connections = []
        # 编码路径
        for encoder in self.encoder:
            x = encoder(x)
            skip_connections.append(x)
            x = self.pool(x)
        x = self.bottleneck(x)
        # 解码路径
        skip_connections = skip_connections[::-1]  # 反转
        for idx in range(len(self.upconvs)):
            x = self.upconvs[idx](x)
            skip = skip_connections[idx]
            # 处理尺寸不匹配 (若因下采样造成)
            if x.shape != skip.shape:
                x = nn.functional.interpolate(x, size=skip.shape[2:], mode='bilinear', align_corners=True)
            x = torch.cat([skip, x], dim=1)  # 拼接
            x = self.decoders[idx](x)
        return torch.sigmoid(self.final_conv(x))  # 输出概率图

# -------------------- 4. 训练配置 --------------------
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model = UNet().to(device)
# 使用预训练编码器权重 (示例: 使用ResNet34作为编码器可提升性能,此处为简化)
# 损失函数: 结合BCE和Dice Loss (处理类别不平衡)
class DiceBCELoss(nn.Module):
    def __init__(self, weight=0.5):
        super().__init__()
        self.weight = weight

    def forward(self, pred, target):
        bce = nn.functional.binary_cross_entropy(pred, target, reduction='mean')
        smooth = 1e-6
        pred_flat = pred.view(pred.size(0), -1)
        target_flat = target.view(target.size(0), -1)
        intersection = (pred_flat * target_flat).sum(dim=1)
        dice = (2. * intersection + smooth) / (pred_flat.sum(dim=1) + target_flat.sum(dim=1) + smooth)
        dice_loss = 1 - dice.mean()
        return self.weight * bce + (1 - self.weight) * dice_loss

criterion = DiceBCELoss(weight=0.7)
optimizer = optim.Adam(model.parameters(), lr=1e-4)
scheduler = optim.lr_scheduler.ReduceLROnPlateau(optimizer, mode='min', patience=5, factor=0.5)

# -------------------- 5. 数据加载与划分 --------------------
# 假设路径 (请替换为实际路径)
image_dir = "./data/images"
mask_dir = "./data/masks"

full_dataset = CrackSegDataset(image_dir, mask_dir, transform=train_transform)
train_size = int(0.7 * len(full_dataset))
val_size = int(0.15 * len(full_dataset))
test_size = len(full_dataset) - train_size - val_size
train_dataset, val_dataset, test_dataset = random_split(full_dataset, [train_size, val_size, test_size])

# 验证集和测试集使用不同的transform (不包含随机增强)
val_dataset.transform = val_transform
test_dataset.transform = val_transform

train_loader = DataLoader(train_dataset, batch_size=8, shuffle=True, num_workers=4)
val_loader = DataLoader(val_dataset, batch_size=8, shuffle=False, num_workers=4)
test_loader = DataLoader(test_dataset, batch_size=8, shuffle=False, num_workers=4)

# -------------------- 6. 训练循环 (示例) --------------------
num_epochs = 100
best_val_loss = float('inf')

for epoch in range(num_epochs):
    model.train()
    train_loss = 0.0
    for images, masks in train_loader:
        images, masks = images.to(device), masks.to(device)
        optimizer.zero_grad()
        outputs = model(images)
        loss = criterion(outputs, masks)
        loss.backward()
        optimizer.step()
        train_loss += loss.item() * images.size(0)
    train_loss /= len(train_loader.dataset)

    # 验证阶段
    model.eval()
    val_loss = 0.0
    with torch.no_grad():
        for images, masks in val_loader:
            images, masks = images.to(device), masks.to(device)
            outputs = model(images)
            loss = criterion(outputs, masks)
            val_loss += loss.item() * images.size(0)
    val_loss /= len(val_loader.dataset)
    scheduler.step(val_loss)

    print(f"Epoch {epoch+1}/{num_epochs}, Train Loss: {train_loss:.4f}, Val Loss: {val_loss:.4f}")

    # 保存最佳模型
    if val_loss < best_val_loss:
        best_val_loss = val_loss
        torch.save(model.state_dict(), "best_unet_crack.pth")
        print("模型已保存!")

print("训练完成!")
# ==================== 结束 ====================
📝 关键注释与优化建议
- 类别不平衡处理:裂缝像素通常只占图像的极小部分,使用
DiceBCELoss(Dice系数与交叉熵结合)能有效缓解正负样本不平衡问题。 - 迁移学习加速:建议将U-Net的编码器替换为ResNet34/50(使用ImageNet预训练权重),可显著提升小数据集下的特征提取能力。
- 后处理:预测后,对输出概率图应用阈值分割(如0.5)得到二值掩码,再通过连通域分析去除小噪点区域,提升实例级精度。
- 评估指标:除损失外,重点关注IoU (Intersection over Union)、F1-score和召回率,更直观反映裂缝检测的完整性。
🏷️ 拓展思考与行业趋势
- 数据量瓶颈突破:结合生成对抗网络(GAN) 或扩散模型合成高保真裂缝图像,进行数据增广。
- 实时检测挑战:针对无人机/巡检车边缘计算场景,可尝试轻量级模型(如MobileNetV3+DeepLabV3)或模型剪枝量化。
- 三维重构:结合多视角裂缝分割结果,可进行裂缝深度、宽度三维测量,为结构安全评级提供量化依据。
🔖 文章标签
#无人机巡检 #裂缝识别 #图像分割 #深度学习 #PyTorch #U-Net #数据集 #建筑安全 #道路养护 #桥梁监测

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 7
 0
- 0


 已为社区贡献4条内容

所有评论(0)