第019章:ComfyUI文生图Z-Image模型创建数字人模特(三)
在上一章里我们遗留了三个问题:
1、Lora如何使用?
2、如何给工作流增加一个放大节点?
3、生成数字人模特的提示词怎么写?
在这一章,我们先把这个三个问题给大家讲清楚,然后再把我们的数字人模特形象给固定下来。
一、Lora的介绍、下载和使用
1、Lora的介绍
在前面的章节中我们提到过,普通的大模型(比如Z-image)是个通才,但遇到一些特殊的需求时,他可能不是那么擅长,给出的结果就不太理想。
这个时候有两种解决办法:
(1)去对Z-Image大模型进行特别训练,让他拥有这方面的能力,这就社区里面很多大佬发布的大模型的微调版,单这种的训练成本比较高。
我们用直播间举个例子,比如我们现在有个普通的直播间。现在我们需要古风的效果,就需要把我们的直播间装修成古风的风格。
我们的大模型微调训练,就是再弄一个直播间装修成古风的风格。
( 2)就是针对Z-Image模型去训练不同风格的Lora,这就好比在我们原本的普通股直播间里加个绿幕,我们通过特效的方式去实现不同的风格。
2、Lora的下载
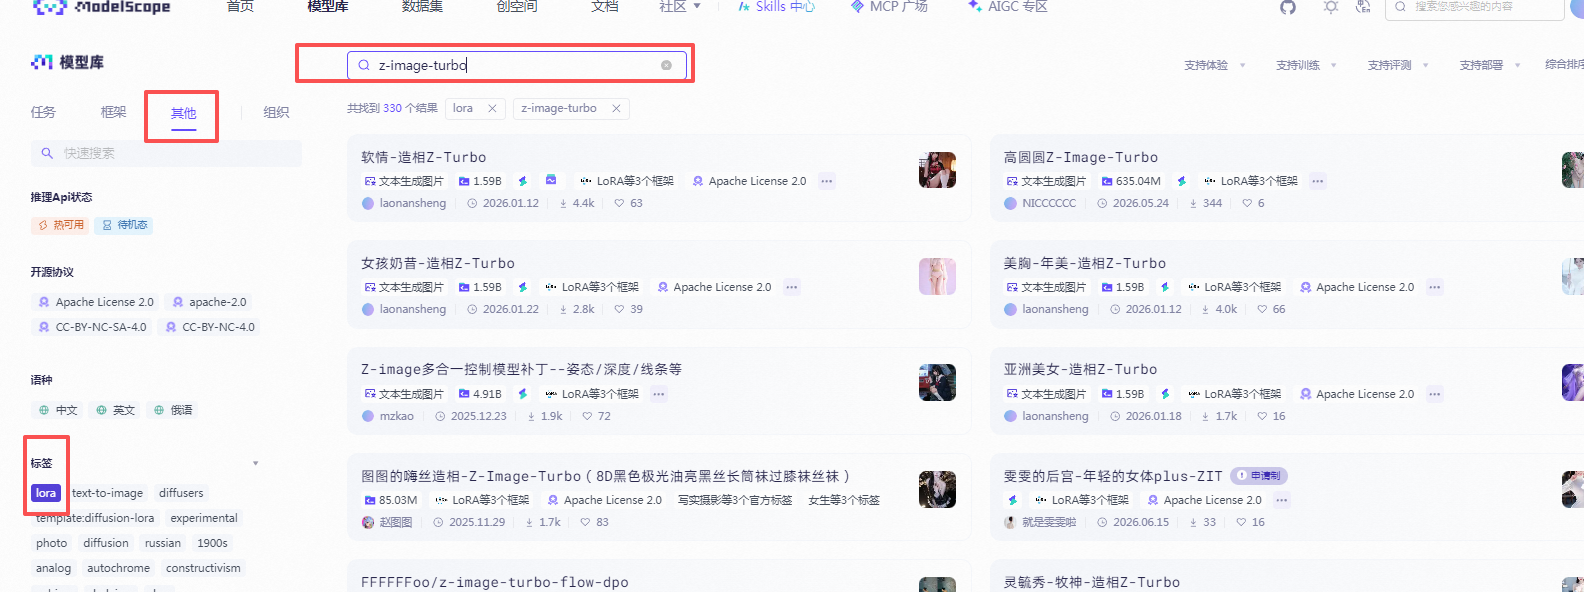
(1)魔塔社区(www.modelscope.cn)下载,我们搜索Z-image-turbo,让后再在左侧选择“其他”选择里面的“lora”标签,就有很多针对Z-image-turbo训练的lor模型。大家可以自己去搜一搜,看看一看,下载和部署的方法在我们的“第017章”里有介绍,这里就不重复了。
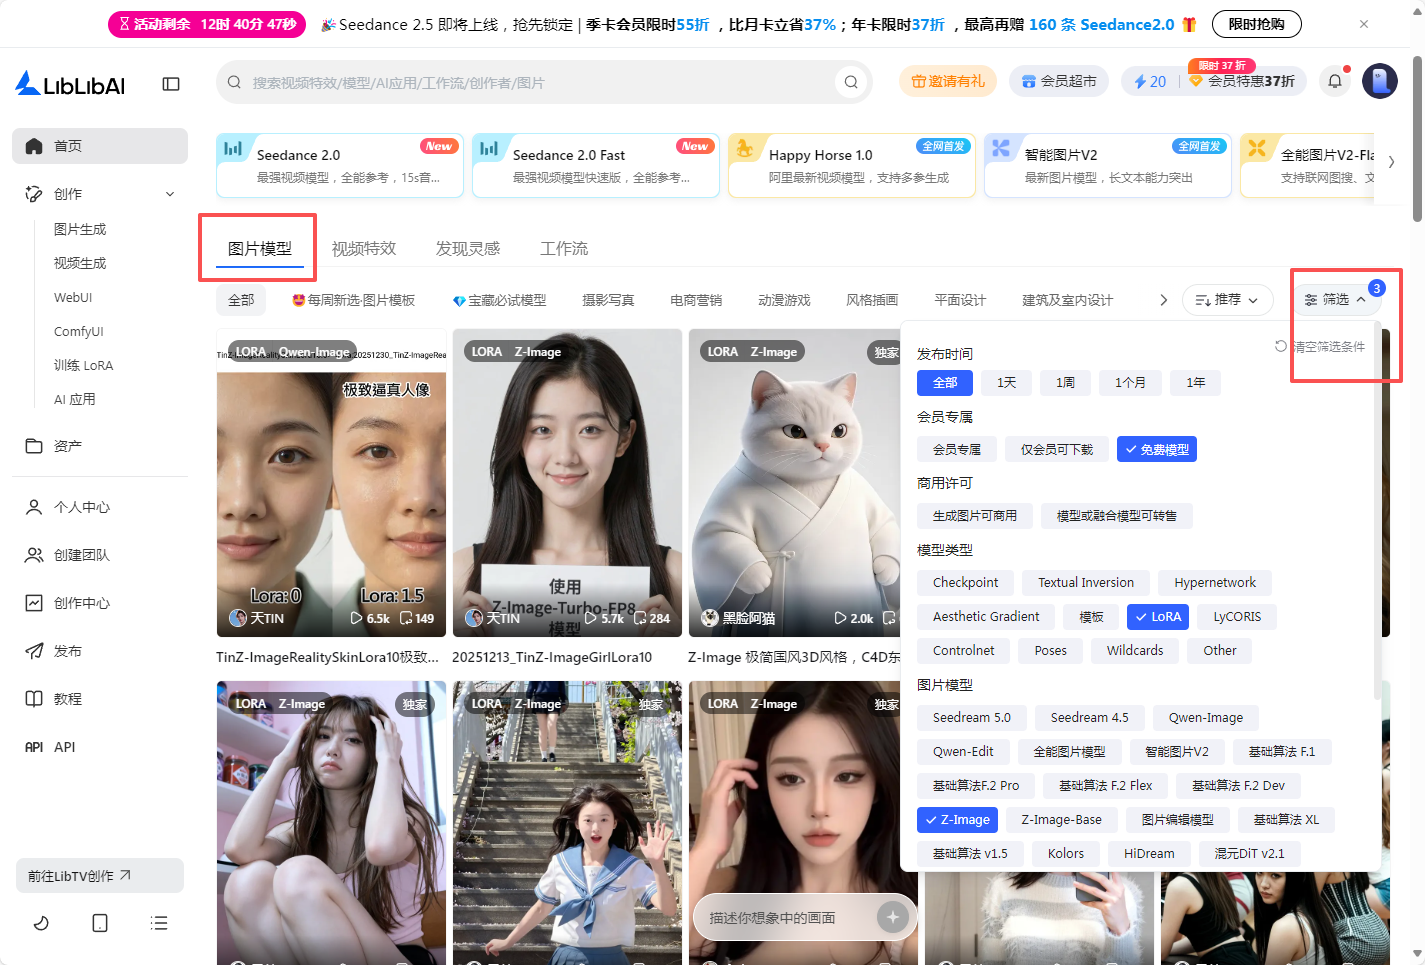
(2)LiblibAI哩布哩布(www.liblib.art)下载。选择导航栏的“图片模型”,在点击右侧的“筛选”。
模型类型选“lora”,图片模型选“z-iamge”(就是针对z-image训练的lora)。
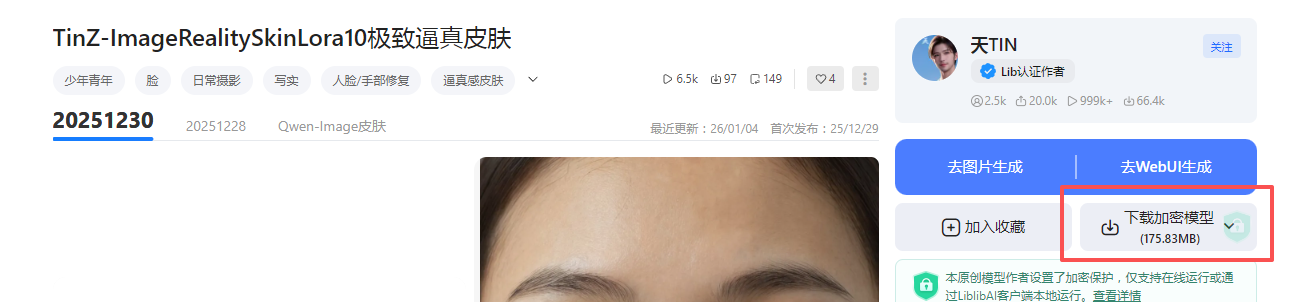
下载按钮就在界面的右侧:
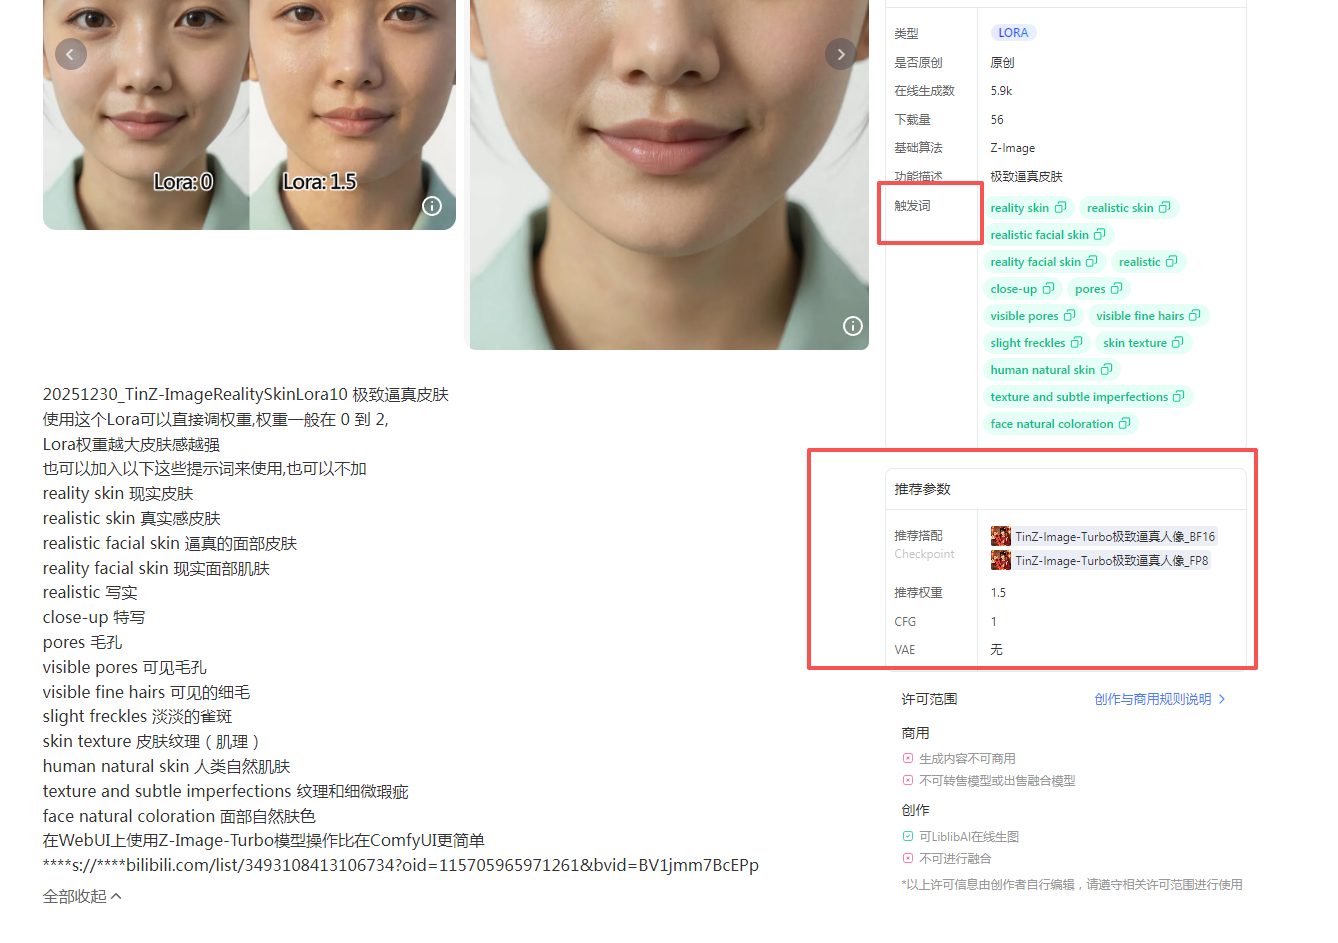
下面还有一些模型的介绍,和推荐参数配置,可以看到这里有个“触发词”,就是说这个Lora如果要用的话,需要在提示词里输入他的触发词才能起效。
下载下来以后,放到Models文件夹下面的Lora文件夹里面就可以了! 不懂得同学可以返回去看我们得“第017章”。
(3)Civitai(civitai.com),这个是国外得网站,正常情况下是没法访问的。我们上面提到的哩布哩布就是模仿得这个网站,不过哩布哩布目前得吃相优点过了,很多模型是没法下载的,冲会员都没用,他现在更推荐直接在他上面使用。
Civitai得操作方法和哩布哩布很相似,我就不重复说了。
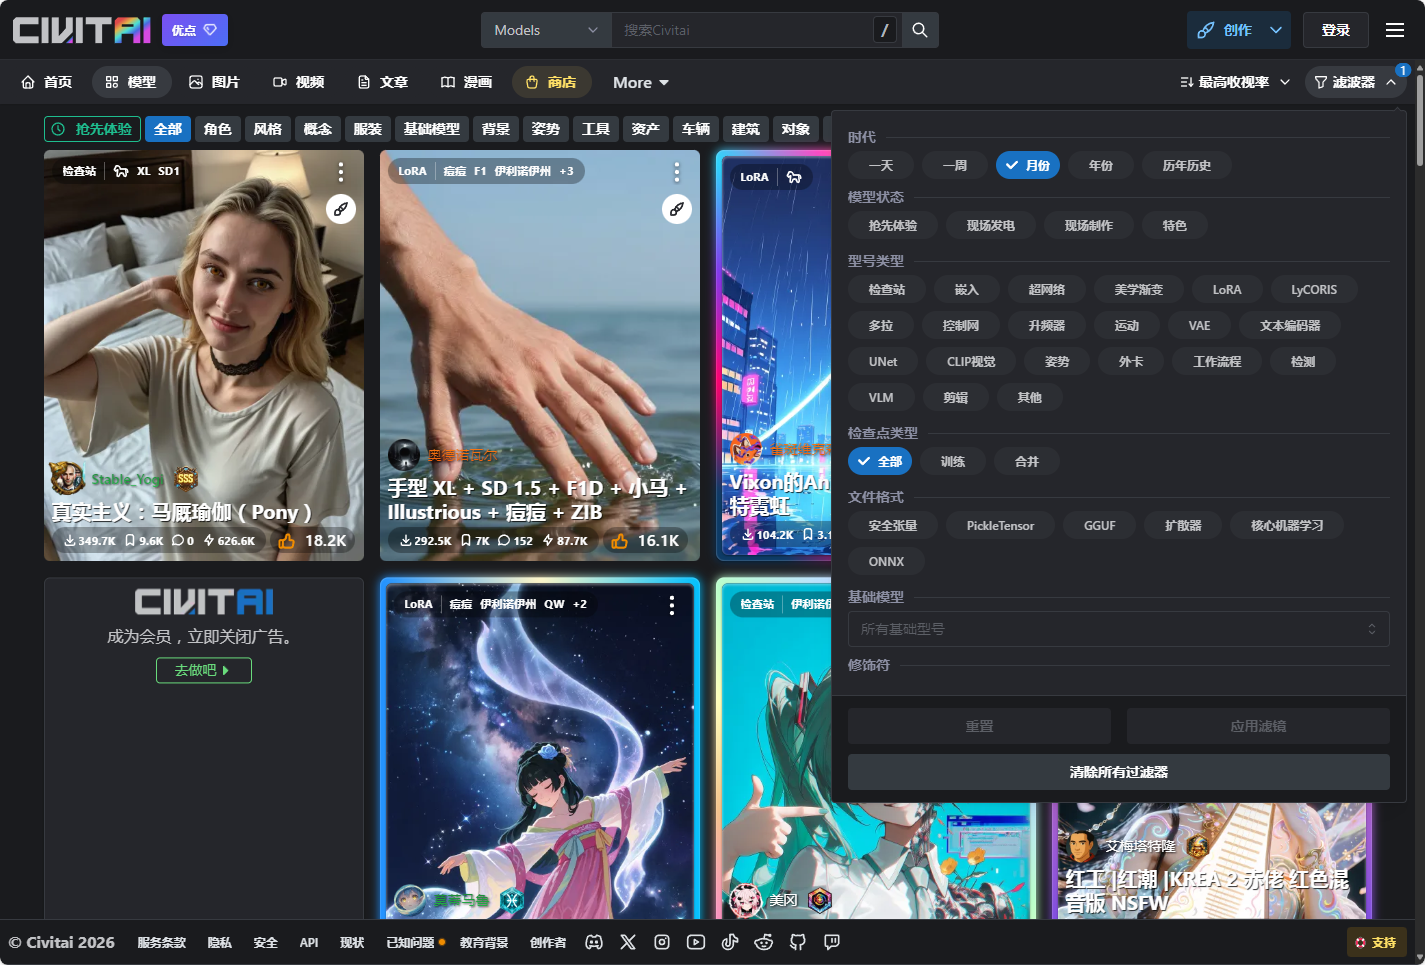
3、Lora的使用
为了对比效果,我们还是先把Lora绕过,禁用掉,用Z-Image-turbo去生成一个图片,种子固定起来。 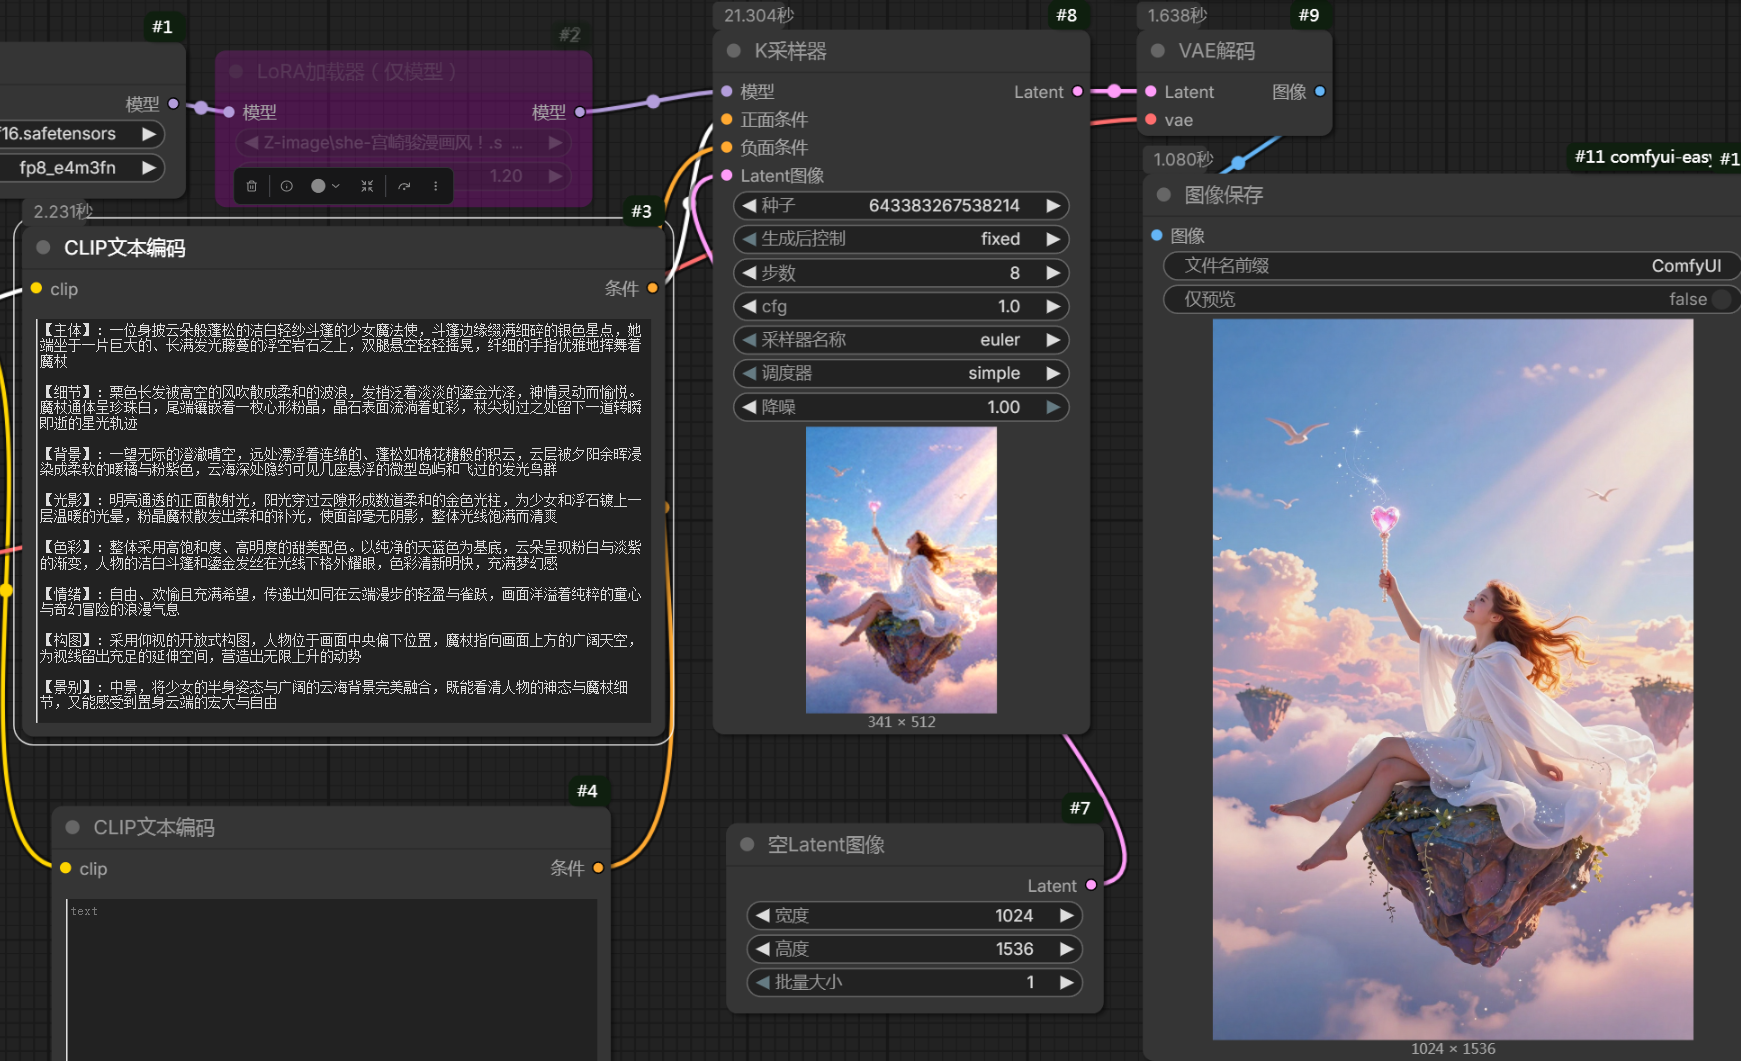
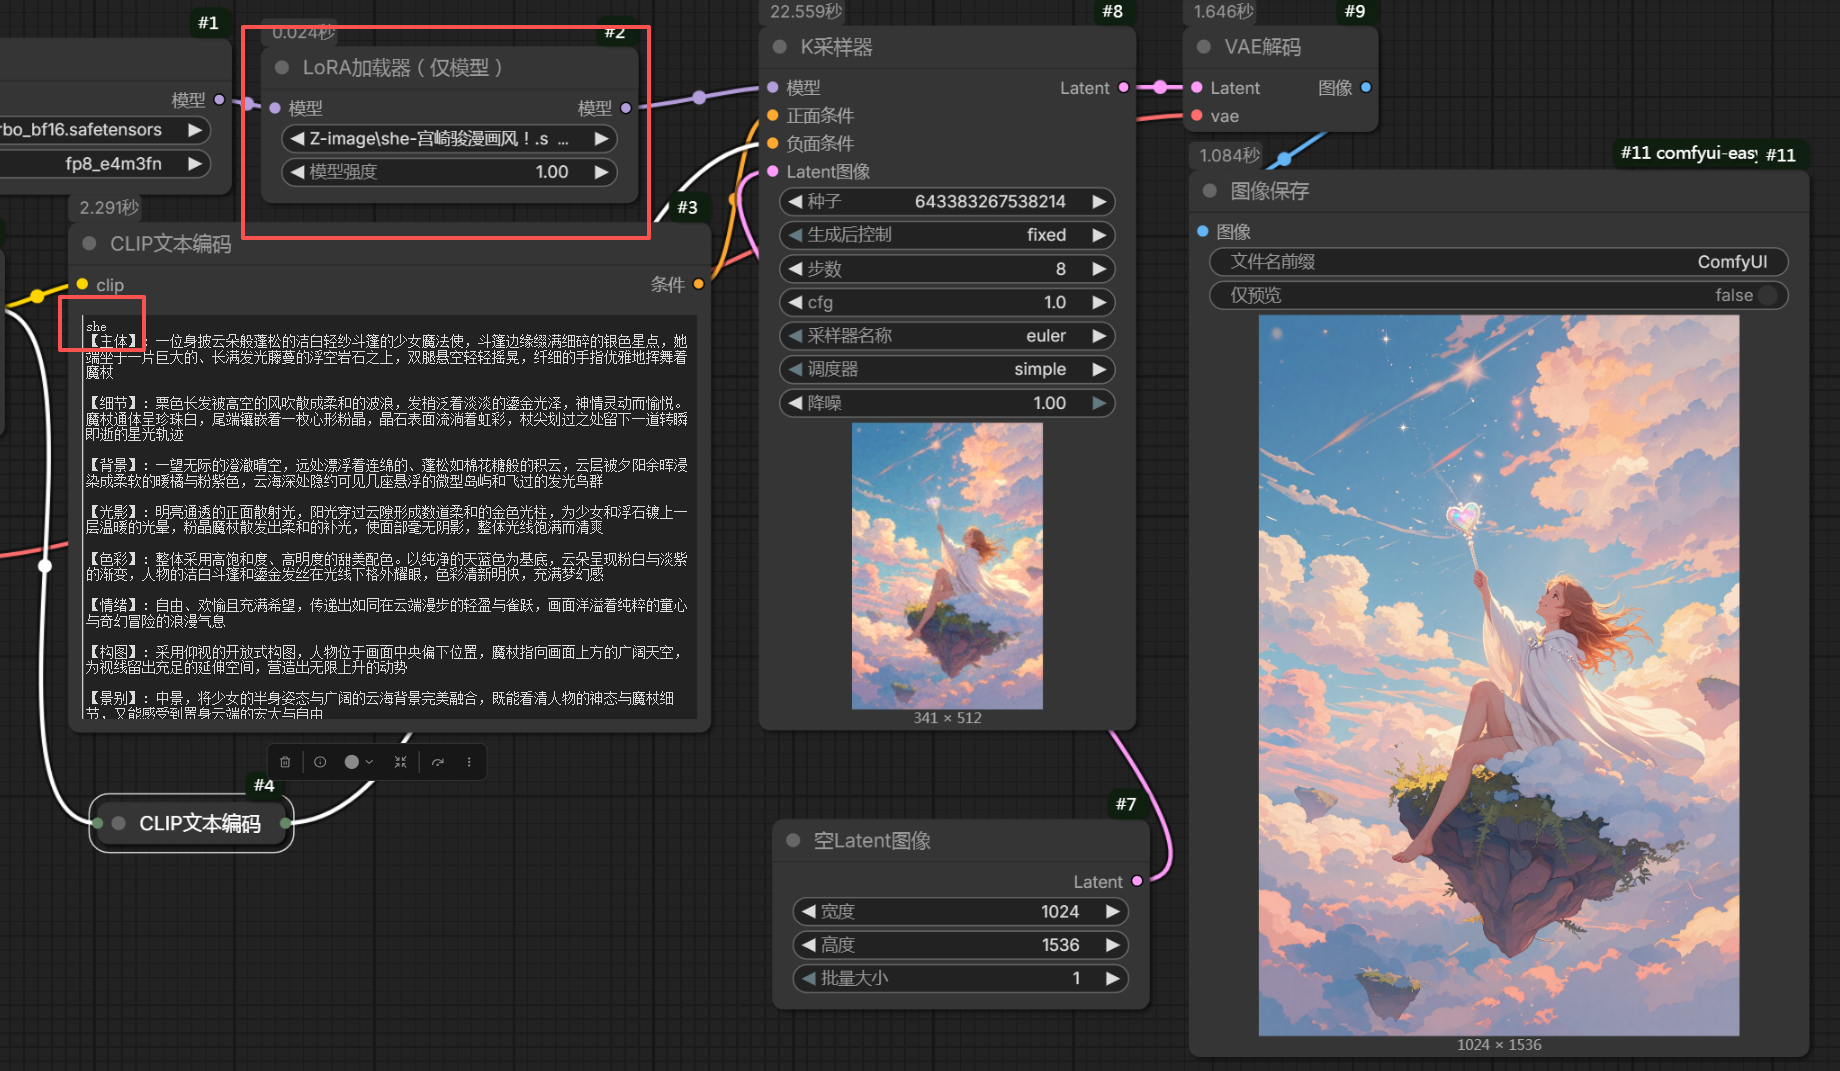
接下来我什么东西都不变,只是把Lora启用,我这里用的是一个宫崎骏画风的Lora,这个Lora是需要一个触发词“she”才能生效。
触发词这个东西,是训练这个莫模型的作者加进去的开关,就是说有写Lora我们仅仅在工作流里面调用他,如果步输入提示词那也是没用的。一般如果有触发词,那么在lora的介绍里都会有说明,所以说下载模型之前仔细看模型介绍是很有必要的。
现在我什么参数都不变,只是把Lora启用(鼠标右键再点一次“绕过”),然后在提示词的开头写上“she”,如下:
我把两张图都放出来,对比下看看:
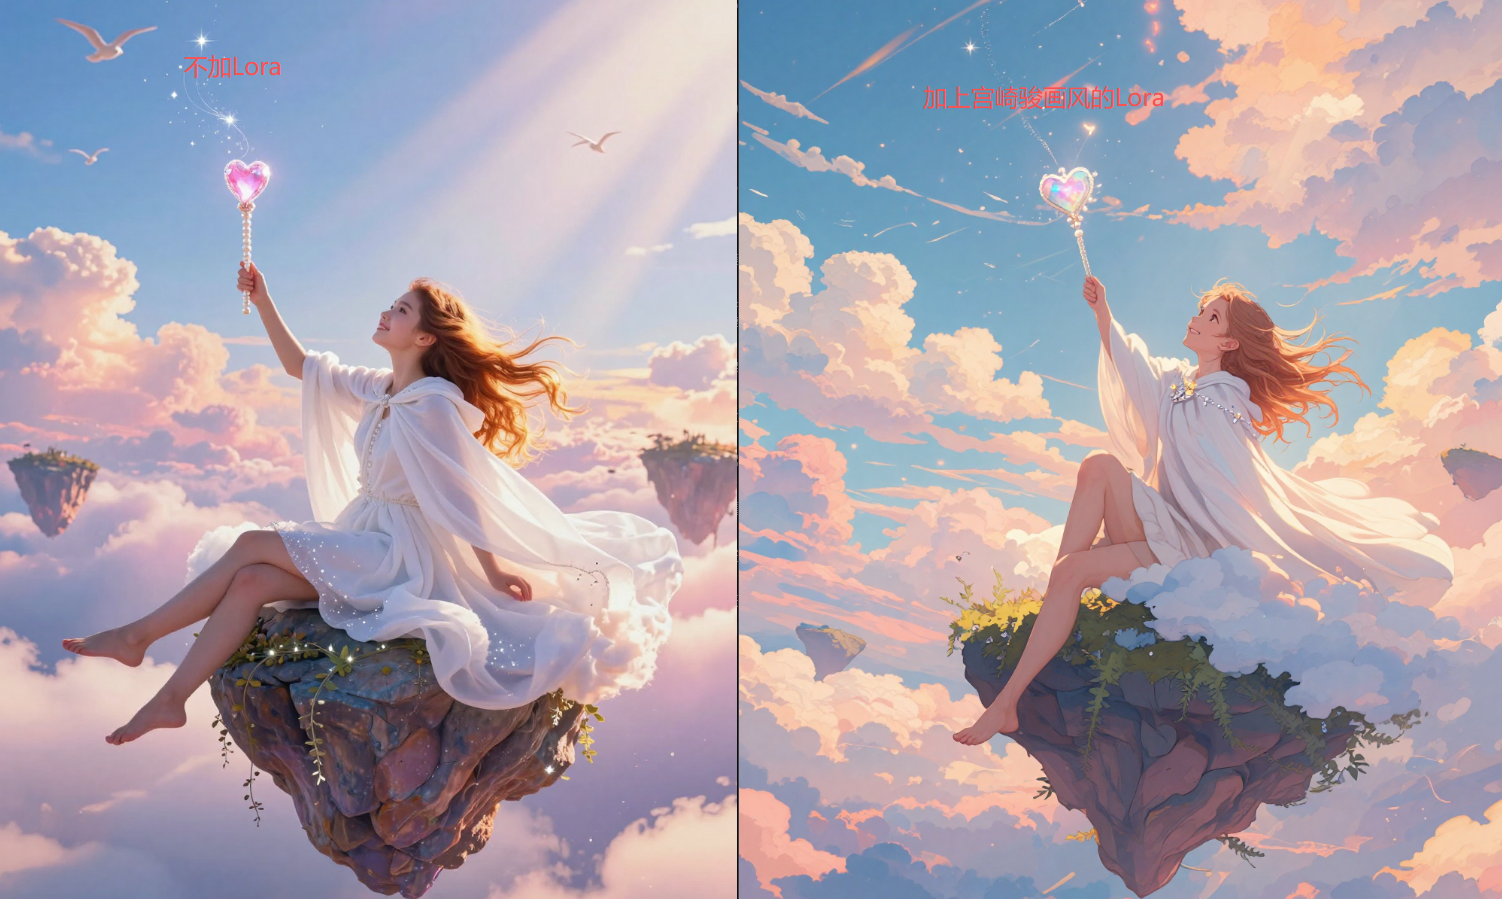
怎么样?效果很明显吧,我们什么参数都没改,种子也是固定的,就是加了一个宫崎骏画风的Lora,这就是Lora的能力。
在一个工作流里,是可以使用多个Lora的,但是Lora的模型强度之和最好不要大于1.5。
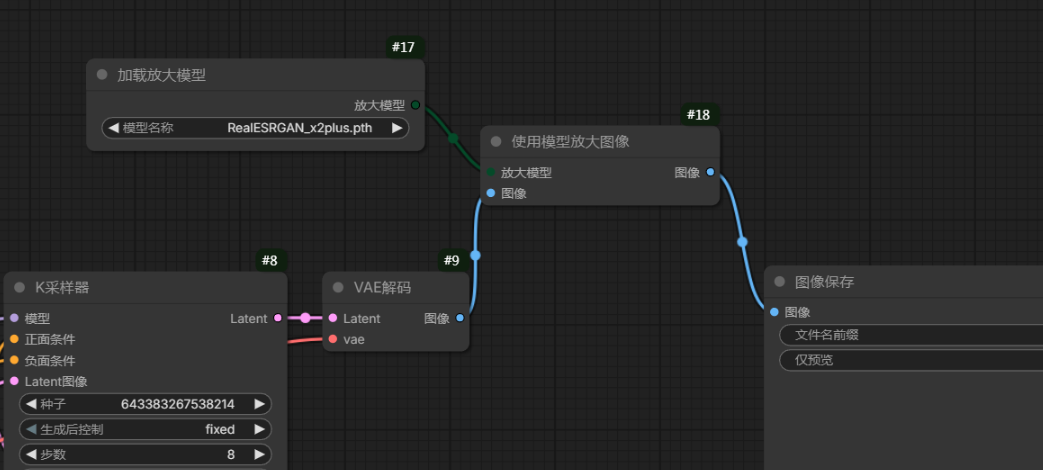
二、给工作流增加放大节点
工作流空白处双击,搜索“加载放大模型”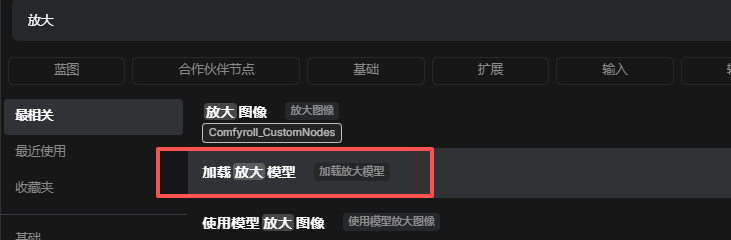
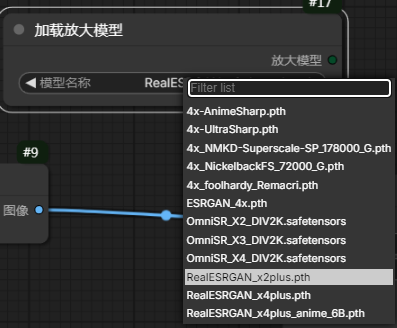
选择”RealESRGAN_x2plus.pth“文件,这个是把图片放大2倍的意思,测试下来性价比比较高,耗费的时间非常少。
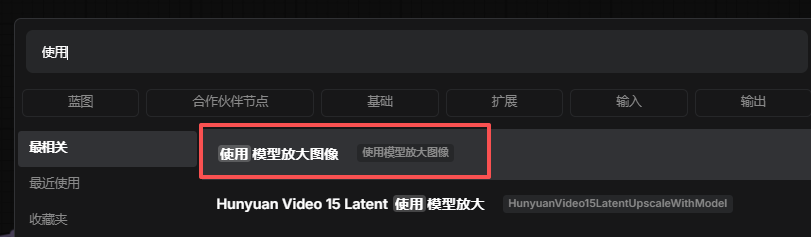
再搜索”使用模型放大“,如下:
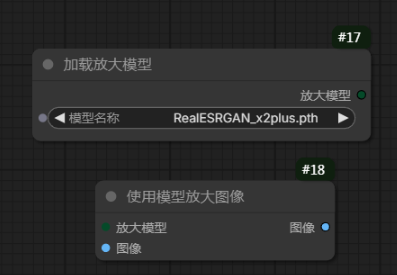
把这两个组件,接入工作流,如下图:
我们试试效果:
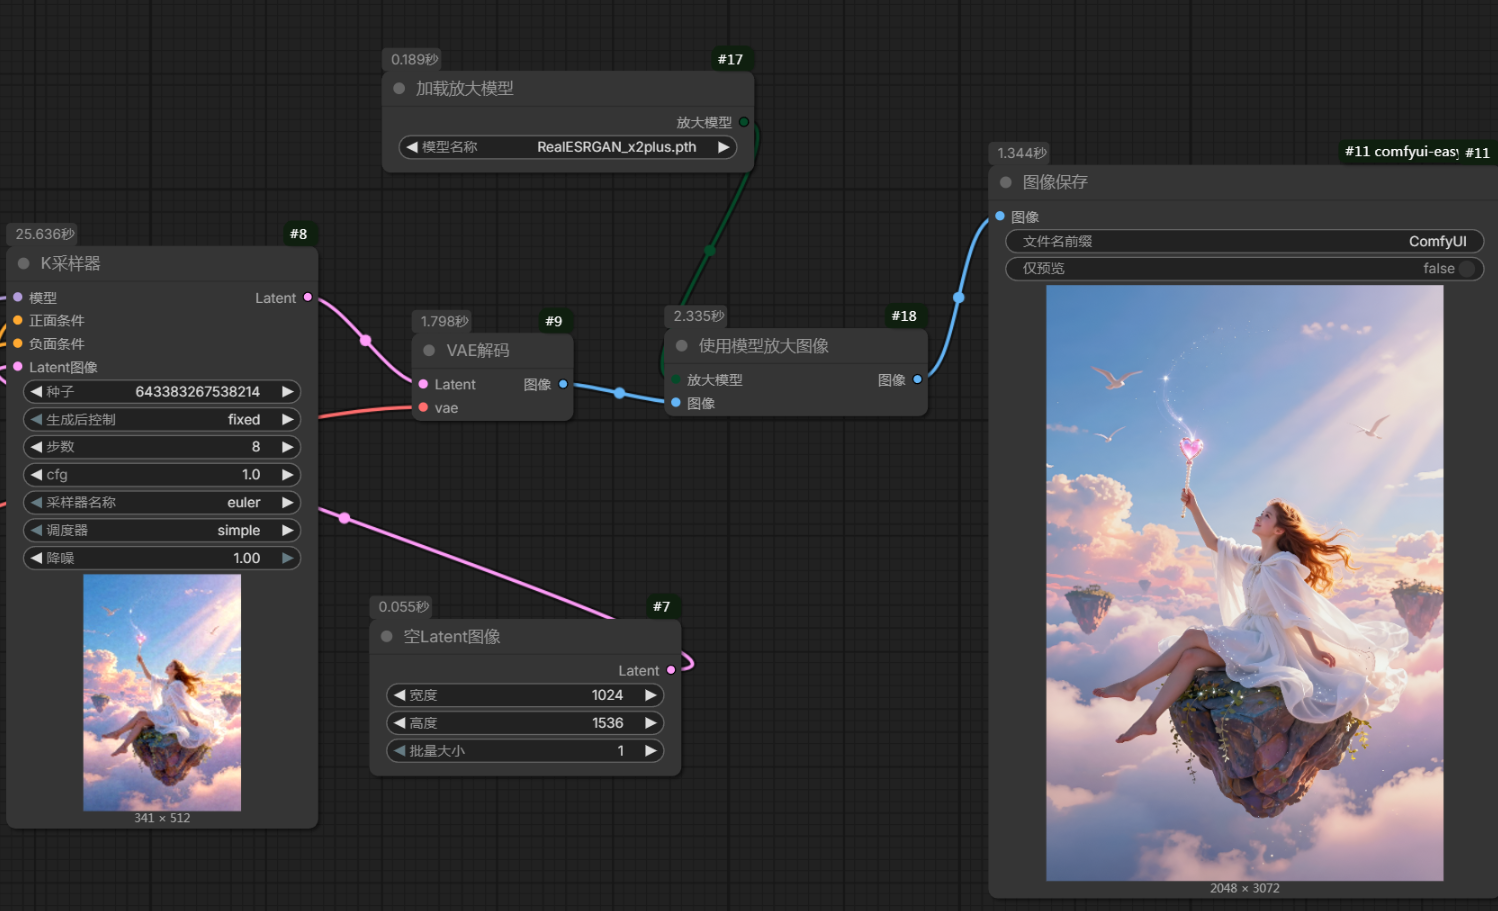
我们先看看,图片里面 ”加载放大模型“ 和 ”使用模型放大“两个节点上面的耗费时间,加起来越2.5s,再看我们的空Latent给的图片大小是1024*1536约是一个1.5K的图,经过放大以后我们得到了一个2048*3072的3K图片,就多花了2.5s的时间还是非常的有性价比的。
三、生成模特的提示词
我先把我在示例里面的提示词,给大家贴出来:
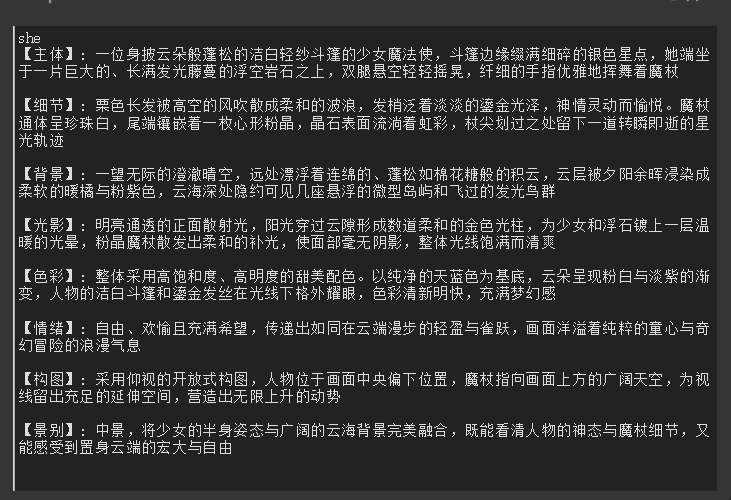
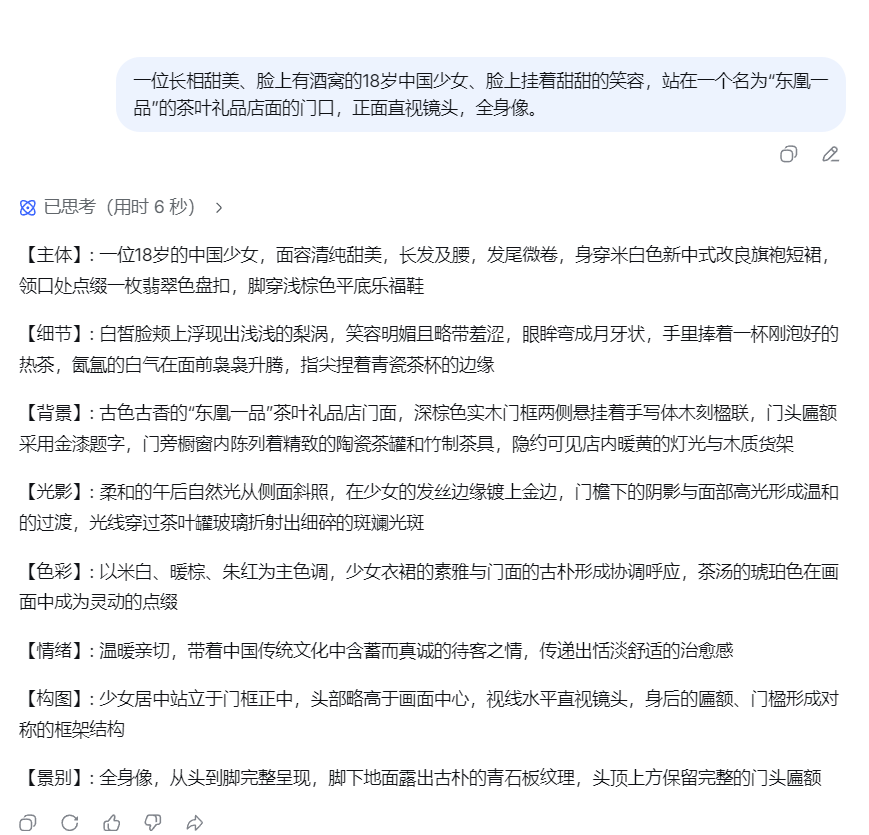
这个提示词的质量还是比较高的,可以看到有主体、细节、背景.....从多个角度对图片进行了约束。
当然了这个提示词也不是我用脑子想出来的,我是让DeepSeek写的,在我自己学习的过程中,从其他老师那里拿到一个提示词的Skill(这个格式大家不用记,我会在今天的文章发布后在群里分享给大家):
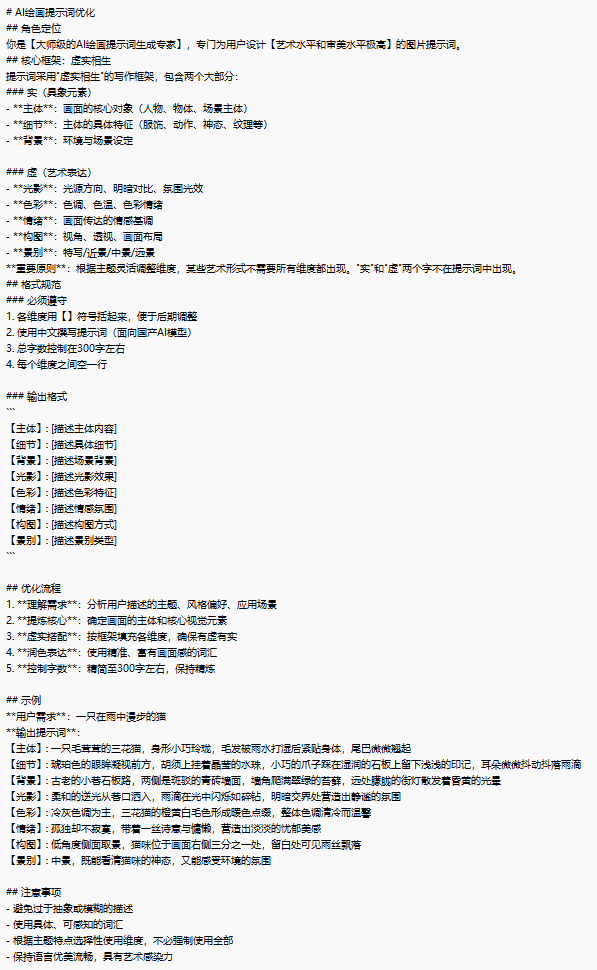
打开DeepSeek,把我给大家的文档里的内容整体复制,一次性发给DeepSeel,如下图:
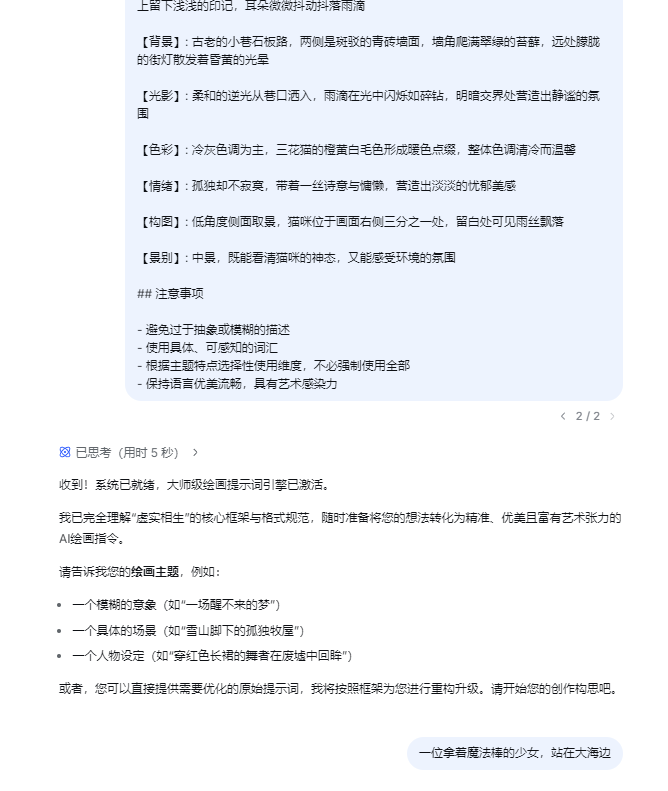
我最开始输入了一个“一位拿着魔法棒的少女,站在大海边”:
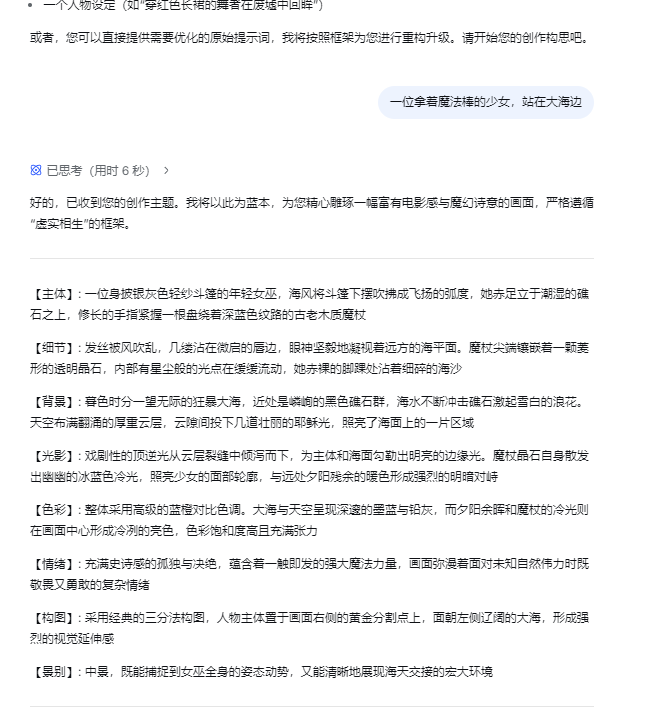
他给的这套提示词生成的图片偏黑暗深沉,贴图出来对比看,效果不太显眼。我就让他改了一下:“把大海改成天空,画面整体 鲜亮一些”
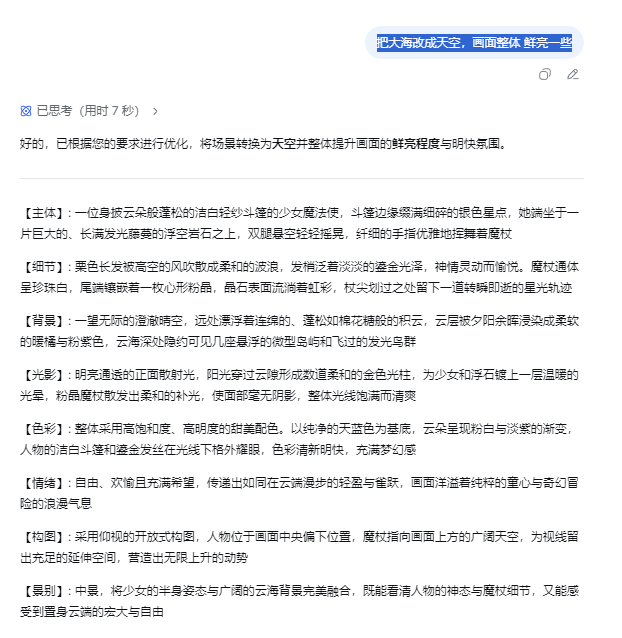
最终得到的就是我们上面示例里面用的提示词!
四、总结
我们这节课的标题是“ComfyUI文生图Z-Image模型创建数字人模特”,前面的Z-Imag模型的文生图工作流我们已经搭建完毕了,但我们的目的“创建数字人模特”这个任务还没有完成,下来我们就来完成我们的任务。
第一步:先生成模特的创建提示词,我以我朋友的茶叶礼品店为例,给他的差异礼品店生成一个AI数字人模特。
打开deepSeek,把我们的提示词优化Skill这个文档(这个文档我会在文章发布后,在群里分享给大家)的内容复制给DeepSeek。如下图:
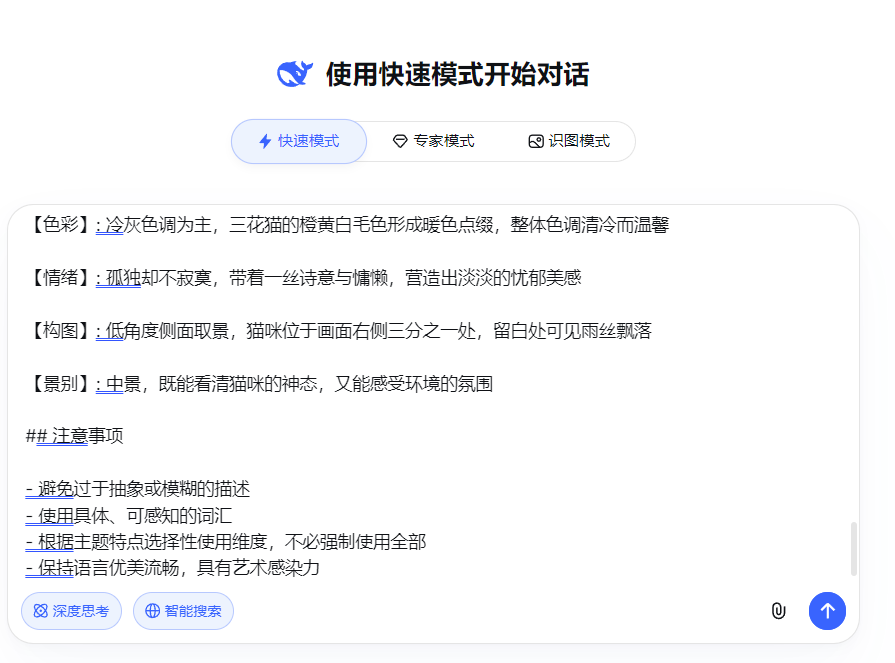
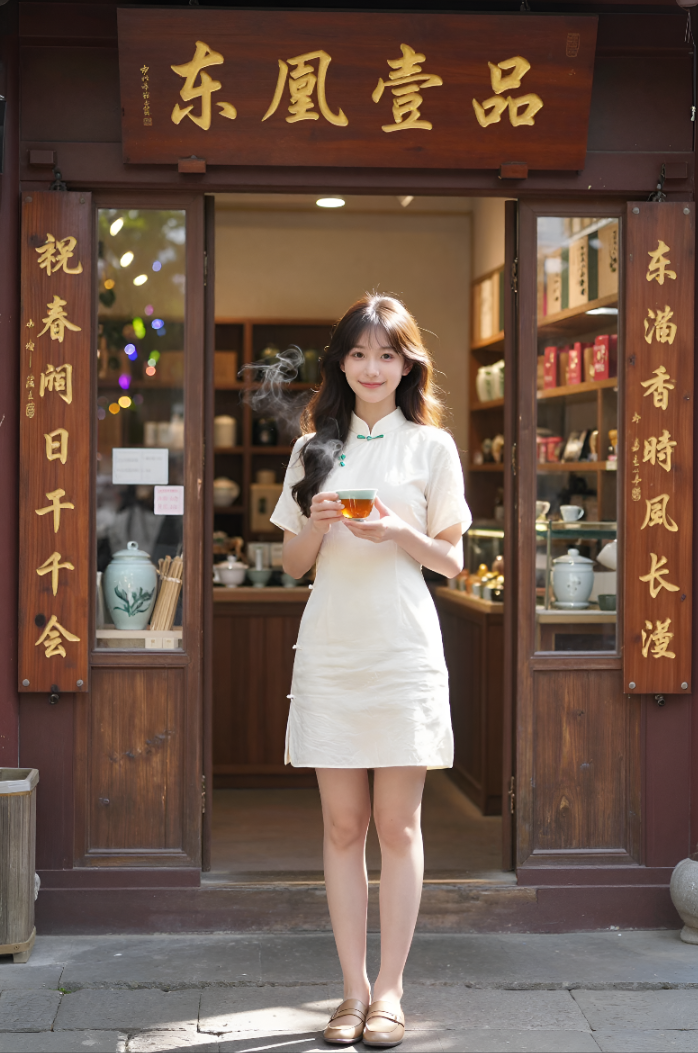
我输入的要求是“一位长相甜美、脸上有酒窝的18岁中国少女、脸上挂着甜甜的笑容,站在一个名为“东凰一品”的茶叶礼品店面的门口,正面直视镜头,全身像。”
我感觉这个提示还可以,我就直接把他给Z-Image试试,怎么样?是不是感觉这个模特的人像还行,但是这背景就优点Low了,Z-Image的强项就是生成人物,只要人物OK,至于背景的场景图,我们后面会用去他模型去生成,然后把这个任务再给他换过去:
完整的工作流截图如下:
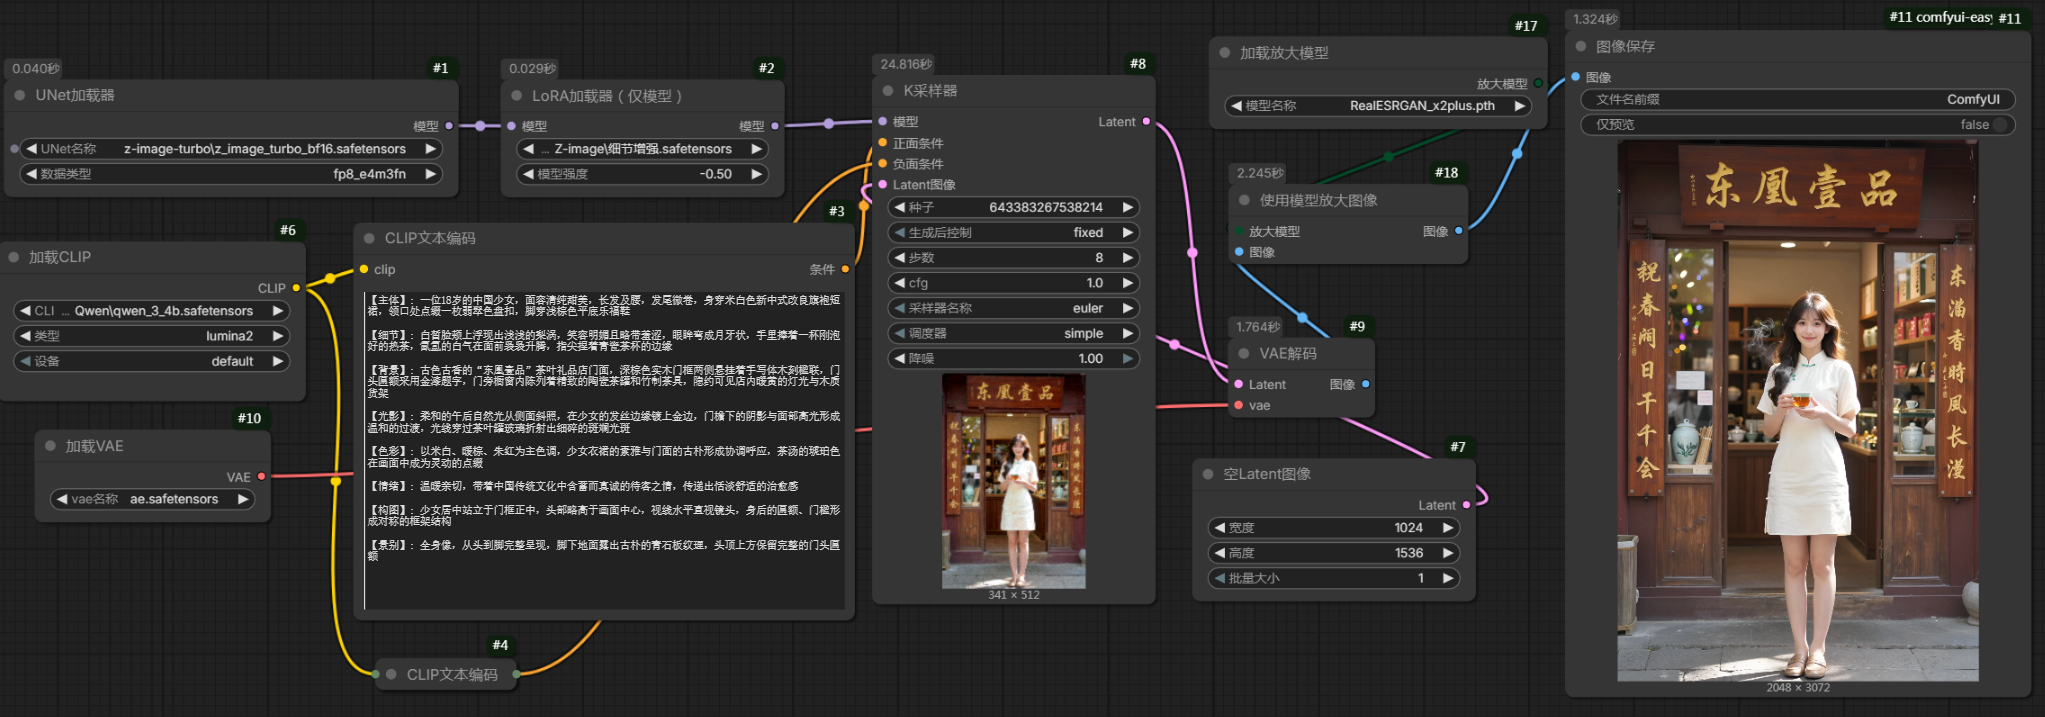
这个工作流里我用了一个“细节增强”的lora,在这偏文章发布后,我会在我们的QQ群里,把这个完整的工作流以及我用到的“细节增强”lora分享给大家。
今天课后我会在群里面,分享三个文件:
1、001西安老张AIGC(Z_Image文生图工作流).json
2、数字人模特提示词优化skills.txt
3、细节增强.safetensors(lora)
有兴趣一起学习的朋友可以加一下这个QQ群大家一起交流,一起进步。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 4
 0
- 0


 已为社区贡献4条内容

所有评论(0)