【π₀】:基于流匹配的通用机器人视觉-语言-动作基础模型深度解析
π₀:基于流匹配的通用机器人视觉-语言-动作基础模型深度解析
论文信息
标题:π₀: A Vision-Language-Action Flow Model for General Robot Control
会议:arXiv:2410.24164v1 [cs.RO]
单位:Physical Intelligence
代码:https://physicalintelligence.company/blog/pi0
论文:https://arxiv.org/pdf/2410.24164.pdf
一、引言:机器人“全能选手”的进阶之路
长期以来,机器人学习一直困在“一个任务训一个模型”的怪圈里,就像每个岗位单独招一个专科生,换个活就得重新招人重新培训。而自然语言和计算机视觉领域的经验告诉我们:通用基础模型+下游微调的路线,效果和效率都远超专用小模型。
机器人领域能不能复制这个成功?答案是肯定的,但要跨过三座大山:
- 数据关:通用模型需要海量多样的数据,机器人数据采集成本高、格式乱,凑齐足够的多样性极其困难。
- 架构关:既要继承互联网预训练的语义知识,又要输出高精度、高频率的连续动作,普通自回归离散VLA模型在灵巧操作上非常吃力。
- 训练关:怎么平衡“通用泛化”和“专精高效”,让模型既能应对意外情况,又能把指定任务做漂亮。
本文提出的 π₀ 就是针对这三大问题交出的答卷。它以PaliGemma预训练VLM为语义主干,搭配独立的动作专家模块,用流匹配生成连续动作序列;在超过10000小时、7种机器人形态、68个任务的跨体数据集上预训练,再通过高质量后训练精修下游任务。最终它不仅在开箱即用场景全面碾压现有VLA模型,还能搞定叠衣服、拼纸箱、收拾餐桌这类长达十几分钟的复杂灵巧任务,刷新了端到端机器人学习的复杂度上限。
下图是π₀的整体框架与能力概览:
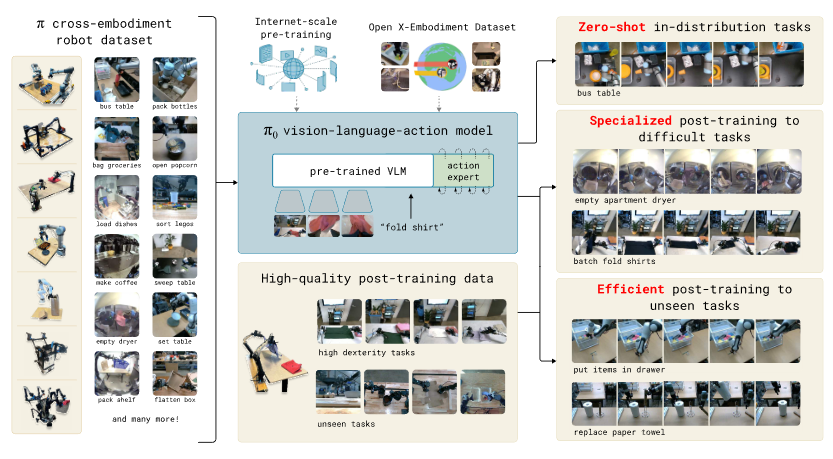
图1:π₀整体框架示意。基于预训练VLM主干,搭配跨体多任务数据集,通过独立动作专家以流匹配方式生成连续动作,既支持直接指令驱动,也支持高质量微调适配复杂长时序任务。
出处:原文Figure 1
通俗解释:
π₀就像一个全能学徒。先靠VLM主干在互联网上学了海量图文知识,能看懂物体、听懂人话;再看一万小时各种机器人干活的视频,打下通用操作底子;最后针对具体岗位练几天精品教程,就能上手从叠衣服到拼纸箱的各种活。既见过世面能随机应变,又能把专业活干得漂亮。
二、模型架构:语义大脑+动作专家的双专家设计
π₀没有走“单一大模型一统到底”的路线,而是采用了混合专家(MoE)式的解耦架构:语义相关的输入走VLM主干,机器人专属的状态、动作走独立的动作专家,两者只通过注意力层交互。这种设计既继承了互联网预训练的语义能力,又保证了动作生成的精度和效率。
整体架构如下图所示:
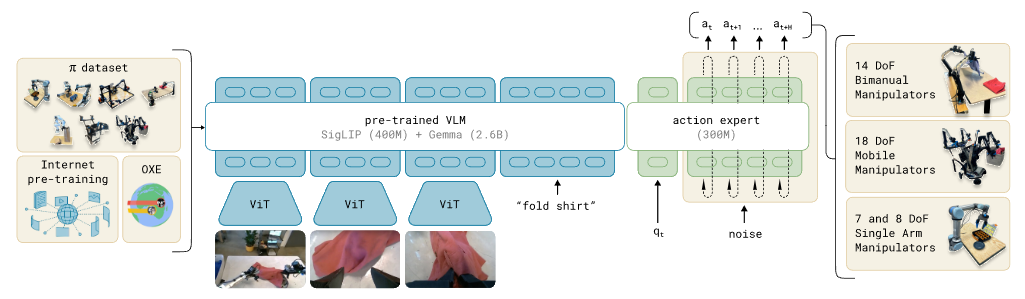
图3:π₀模型架构总览。左侧为预训练数据混合,中间为SigLIP视觉编码器+Gemma语言模型组成的VLM主干,右侧为300M参数的动作专家,以流匹配方式输出18自由度连续动作。
出处:原文Figure 3
2.1 输入与输出定义
模型建模的是条件动作分布 p(At∣ot)p(A_t | o_t)p(At∣ot),即给定当前观测时,未来动作序列的概率分布。
- 观测 oto_tot:包含2~3张RGB图像、语言指令序列、机器人本体关节状态,即 ot=[It1,...,Itn,ℓt,qt]o_t=[I_t^1,...,I_t^n, \ell_t, q_t]ot=[It1,...,Itn,ℓt,qt]。
- 动作序列 AtA_tAt:长度为 H=50H=50H=50 的未来动作chunk,包含位置、姿态、夹爪、底盘等维度,最大支持18自由度(双臂+移动底盘+升降躯干)。
通俗解释:
一次预测未来50步动作,就是“一次想好接下来半秒怎么动”,比走一步想一步的单步预测动作更连贯,不会出现抖动手腕的情况,特别适合拧瓶盖、叠衣服这类精细活。
2.2 双路混合专家结构
模型基于单Transformer实现,但分成两套独立权重:
- VLM主干(约30亿参数):处理图像token和语言token,权重从PaliGemma初始化,继承互联网预训练的语义知识。
- 动作专家(约3亿参数):处理本体状态token和动作token,从零初始化,专门负责机器人控制相关的计算。
两套权重只在自注意力层交互:所有token都能互相关注,但各自的前馈网络用独立权重。这种设计的好处是:
- VLM主干的预训练知识不会被机器人数据冲散,分布偏移小;
- 动作专家可以针对性优化控制任务,不用迁就语言模型的结构;
- 推理时可以缓存观测部分的KV值,每步流匹配只重新计算动作token,速度大幅提升。
2.3 分块因果注意力掩码
注意力掩码采用三段式分块因果设计,三个块分别是「图像+语言」「本体状态」「动作序列」:
- 块内部:全双向注意力,信息充分交互;
- 块之间:因果掩码,前面的块看不到后面的块。
这么设计有三个工程考量:
- 图像语言块看不到后续的状态和动作,尽量保持和VLM预训练一致的分布,避免预训练知识退化;
- 状态块看不到动作块,推理时可以一次性缓存状态的KV值,不用每步流匹配都重算;
- 动作块能看到所有前面的输入,保证动作完全基于当前观测和状态生成。
通俗解释:
这就像公司部门分工:语义部门负责看资料、读需求,不用管执行部门怎么干活;执行部门能拿到所有需求和状态信息,专心出执行方案。既保证了各部门专业性,又避免了信息倒流导致的混乱。
三、核心数学原理:条件流匹配动作生成
动作生成是π₀的核心技术壁垒。它没有沿用RT-2、OpenVLA的“动作离散化+自回归”路线,而是选择了条件流匹配,本质上是扩散模型的一种改进变体,天生适合连续高维动作序列建模。
3.1 训练损失函数
流匹配的核心思想是:学习一个连续向量场,把噪声样本“流动”到真实数据分布。训练时给真实动作加不同程度的噪声,让网络预测去噪的向量方向。
训练损失公式如下:
Lτ(θ)=Ep(At∣ot),q(Atτ∣At)∥vθ(Atτ,ot)−u(Atτ∣At)∥2
L^{\tau}(\theta)=\mathbb{E}_{p\left(A_{t} | o_{t}\right), q\left(A_{t}^{\tau} | A_{t}\right)}\left\| v_{\theta}\left(A_{t}^{\tau}, o_{t}\right)-u\left(A_{t}^{\tau} | A_{t}\right)\right\| ^{2}
Lτ(θ)=Ep(At∣ot),q(Atτ∣At)∥vθ(Atτ,ot)−u(Atτ∣At)∥2
符号逐一解释:
- Lτ(θ)L^{\tau}(\theta)Lτ(θ):第τ\tauτ步的训练损失,θ\thetaθ为模型可训练参数,最终对所有时间步和所有样本取平均
- E[⋅]\mathbb{E}[\cdot]E[⋅]:数学期望算子,对真实动作分布和加噪过程取平均
- p(At∣ot)p(A_t | o_t)p(At∣ot):给定观测oto_tot时,真实动作序列AtA_tAt的概率分布,即人类演示数据的分布
- q(Atτ∣At)q(A_t^\tau | A_t)q(Atτ∣At):从真实动作AtA_tAt生成带噪动作AtτA_t^\tauAtτ的条件概率分布,也叫概率路径
- vθ(Atτ,ot)v_\theta(A_t^\tau, o_t)vθ(Atτ,ot):动作专家网络,输入带噪动作和观测,输出预测的向量场
- AtτA_t^\tauAtτ:第τ\tauτ步的带噪动作序列
- u(Atτ∣At)u(A_t^\tau | A_t)u(Atτ∣At):真实的条件向量场,是训练的“标准答案”
- ∥⋅∥2\|\cdot\|^2∥⋅∥2:均方误差,衡量预测向量场和真实向量场的差异
3.2 线性高斯概率路径
论文采用最简单的线性高斯路径,带噪动作由真实动作和噪声线性插值得到:
Atτ=τAt+(1−τ)ϵ
A_{t}^{\tau}=\tau A_{t}+(1-\tau) \epsilon
Atτ=τAt+(1−τ)ϵ
符号逐一解释:
- τ\tauτ:流匹配时间变量,取值范围 [0,1][0,1][0,1];τ=0\tau=0τ=0 对应纯噪声,τ=1\tau=1τ=1 对应无噪声真实动作
- AtA_tAt:无噪声的真实动作序列(人类演示)
- ϵ\epsilonϵ:标准高斯噪声,服从 N(0,I)\mathcal{N}(0, I)N(0,I)
- AtτA_t^\tauAtτ:插值后的带噪动作
对应的真实向量场表达式极其简洁:
u(Atτ∣At)=At−ϵ
u(A_{t}^{\tau} | A_{t})=A_{t}-\epsilon
u(Atτ∣At)=At−ϵ
也就是说,网络只需要学习预测“真实动作减去噪声”这个恒定向量场,训练目标非常稳定。
3.3 推理采样过程
推理时从纯高斯噪声出发,沿着学到的向量场一步步积分,最终得到合理的动作序列。采用前向欧拉积分法:
Atτ+δ=Atτ+δ⋅vθ(Atτ,ot)
A_{t}^{\tau+\delta}=A_{t}^{\tau}+\delta \cdot v_{\theta}\left(A_{t}^{\tau}, o_{t}\right)
Atτ+δ=Atτ+δ⋅vθ(Atτ,ot)
符号逐一解释:
- Atτ+δA_t^{\tau+\delta}Atτ+δ:积分一步后的动作状态
- δ\deltaδ:积分步长,实验中采用10步积分,对应 δ=0.1\delta=0.1δ=0.1
- vθ(Atτ,ot)v_\theta(A_t^\tau, o_t)vθ(Atτ,ot):当前位置的预测向量场,即动作的“流动方向”
完整推理流程:
- 初始化 At0∼N(0,I)A_t^0 \sim \mathcal{N}(0, I)At0∼N(0,I),即纯高斯噪声;
- 从 τ=0\tau=0τ=0 到 τ=1\tau=1τ=1,按步长 δ\deltaδ 逐步积分更新动作;
- 最终得到的 At1A_t^1At1 就是预测的动作序列。
工程优化:观测部分(图像、语言、状态)的注意力KV值只计算一次并缓存,每步积分只重新计算动作token的部分,推理速度提升数倍。
通俗解释:
流匹配就像修一条从山顶到山谷的滑道。训练的时候,在滑道任意位置给你看坡度,让你预测滑道延伸方向;练得多了,随便从山顶哪个位置出发,都能顺着滑道稳稳滑到山谷底的正确动作。10步积分就是分10段滑下来,段数越多越精准,但也越费时间。
3.4 专属时间步采样策略
和图像生成领域不同,机器人动作预测有自己的特点:预测动作的整体走向本身就是难题,而不是细节微调最难。因此论文没有用均匀采样,而是设计了偏移Beta分布,侧重采样低τ\tauτ(高噪声)的样本:
p(τ)=Beta(s−τs;1.5,1)
p(\tau)=\text{Beta}\left(\frac{s-\tau}{s} ; 1.5, 1\right)
p(τ)=Beta(ss−τ;1.5,1)
其中 s=0.999s=0.999s=0.999 是截断阈值,高于这个阈值的时间步完全不采样。
分布特点:越靠近τ=0\tau=0τ=0(噪声越大)采样概率越高,让模型把更多训练精力放在“定大方向”上。实验证明这个设计比均匀采样、对数正态采样更适合机器人控制任务。
四、训练配方:预训练打底+后训练精修
和大语言模型的“预训练+对齐”两阶段路线一致,π₀也采用了大规模预训练+高质量后训练的两阶段配方,这是它兼顾泛化性和专精性的核心秘诀。
4.1 预训练阶段:广撒网练基础
预训练的目标是让模型学会通用的物理交互能力,见过足够多的物体、场景、机器人形态,打下泛化底子。
数据组成
预训练数据混合由两部分构成:
- 自研灵巧数据集(90.9%):9.03亿时间步,覆盖7种机器人配置、68个任务,包含单臂、双臂、移动操作机器人,主打高复杂度灵巧操作。
- 开源数据集(9.1%):包含OXE、Bridge v2、DROID等公开数据集,覆盖更多场景和物体,补充多样性。
数据分布与权重如下图所示:
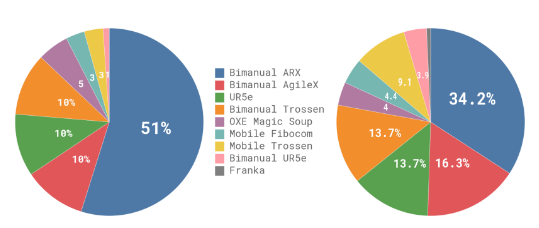
图4:预训练数据组成。左图为各数据集的步数占比,右图为训练权重占比。通过加权下调数据量大的任务权重,保证模型不偏科。
出处:原文Figure 4
跨体统一方案
不同机器人的动作空间维度不一样,怎么放进同一个模型?论文采用了最简单有效的方案:
- 所有状态和动作向量统一补零到18维(适配最大的全移动双臂机器人);
- 缺失的摄像头输入用掩码屏蔽,不参与计算。
配合加权采样,模型能自动学会不同机器人的运动学特性,实现跨形态共享知识。
语言标注策略
同时使用任务级粗标签和2秒级细粒度片段标签,让模型既能听懂“收拾桌子”这种总指令,也能听懂“把盘子放进筐里”这种分步指令,为后续高层策略拆分任务打下基础。
4.2 后训练阶段:针对性打磨专精
预训练模型泛化强但动作不够精准流畅,后训练就是用高质量、高一致性的演示数据做微调,让模型把特定任务做精、做稳。
数据量按需分配:简单任务5小时数据就够,叠衣服、拼纸箱这类复杂任务需要100小时以上。
为什么两阶段结合才最优?
- 只靠高质量后训练:动作标准但很“脆”,一旦出点小意外就彻底卡住,不会自己纠正恢复;
- 只靠杂数据预训练:什么都能做一点,但动作毛躁、效率低,精细活干不好;
- 两阶段结合:平时按最优流程高效执行,出了错也能像预训练数据里那样自己纠正回来,鲁棒性拉满。
4.3 高层语义策略辅助
对于需要语义推理的长时序复杂任务(比如收拾满桌杂物),直接给一句总指令模型很难自己规划步骤。论文采用了“高层VLM拆任务+π₀执行”的分层方案:
- 高层VLM观察场景,把大任务拆成一系列子指令,比如“拿起餐巾→扔进垃圾桶→拿起盘子→放进餐具筐”;
- 逐条把子指令喂给π₀执行,完成一条再给下一条。
这种模式类似SayCan的思路,把语义推理和动作执行解耦,既能搞定几十分钟的长流程任务,又不用重新训大模型。
有趣案例:
这就像项目经理和操作工的配合。项目经理(高层VLM)负责看现场、排工序、一步步发指令;操作工(π₀)专心把每一步动作做标准。不用让操作工自己想全局规划,也不用项目经理亲手干活,各司其职效率最高。
五、实验评测:全方位碾压现有基线
论文从四个维度做了全面实验,验证模型的开箱即用能力、语言跟随能力、小样本微调能力和复杂任务攻坚能力。
5.1 开箱即用:零样本直接打
在5个代表性任务上直接测试预训练模型,不做任何任务专属微调,对比现有主流模型。
测试任务:叠T恤、简单收桌、困难收桌、装购物袋、烤面包机取吐司。
对比基线:
- OpenVLA(7B):当前最强开源VLA,自回归离散动作架构
- Octo(93M):开源扩散式通用策略,无VLM主干
- π₀-parity:仅训练160k步,和基线算力对齐
- π₀-small:4.7亿参数,无VLM预训练的消融版本
结果如下图所示:
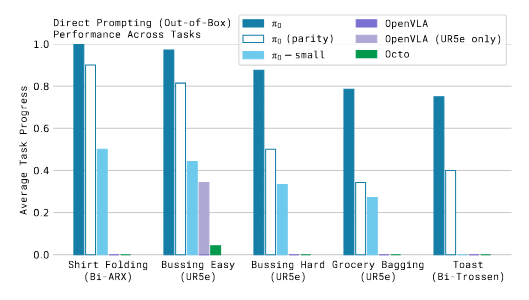
图7:开箱即用任务成功率对比。所有任务中,完整训练的π₀均大幅领先所有基线,哪怕算力对齐的短训版本也能打赢对手。
出处:原文Figure 7
结果分析:
- 全面碾压:π₀在所有任务上都是第一,简单任务接近满分,困难任务优势更明显。
- 架构优势显著:哪怕只训160k步的π₀-parity,也能打赢训满的OpenVLA和Octo,说明流匹配+动作chunk的架构天生更适合灵巧操作。
- VLM预训练有用:π₀-small(无VLM)都比OpenVLA强,但和完整π₀差距很大,验证了VLM预训练带来的语义和泛化增益。
- 自回归离散动作的瓶颈:OpenVLA表现拉胯的核心原因是不支持动作分块,高频精细操作跟不上,一到灵巧任务就露怯。
5.2 语言跟随:听懂指令才是真智能
测试模型对语言指令的理解能力,对比总指令、人类分步指令、高层VLM分步指令三种模式。
测试任务:收桌、摆餐具、装购物袋。
测试模式:
- -flat:只给总任务指令,全靠模型自己规划
- -human:人类专家给分步指令
- -HL:高层VLM自动给分步指令,完全自主
结果如下图所示:
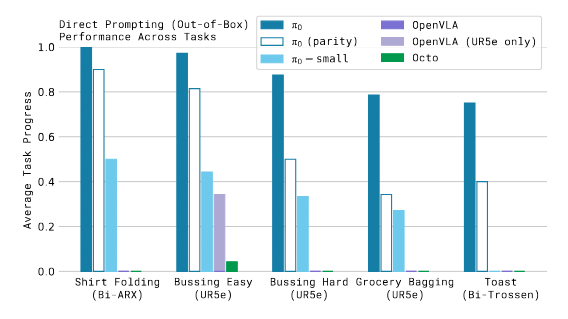
图9:语言指令跟随能力对比。π₀能显著从分步指令中获益,而无VLM预训练的小模型几乎吃不到语言指令的红利。
出处:原文Figure 9
结果分析:
- VLM预训练是语言能力的基础:π₀的语言跟随能力远强于π₀-small,给分步指令后性能暴涨;而小模型就算给了分步提示也提升有限,因为它根本听不懂复杂表述。
- 自主分层方案可行:高层VLM自动分步的效果虽然不如人类专家,但也能带来明显提升,完全不需要人干预就能搞定复杂长任务。
5.3 新任务微调:小数据快速上手
测试模型迁移到全新任务的能力,用不同体量的微调数据训练,对比专用方法和其他VLA方法。
测试任务(按和预训练相似度从高到低):
- 简单:叠碗、叠毛巾
- 中等:微波炉放保鲜盒
- 困难:换卷纸、抽屉放物品
对比基线:ACT、Diffusion Policy(从零单任务训练)、OpenVLA、Octo(预训练+微调)
结果如下图所示:
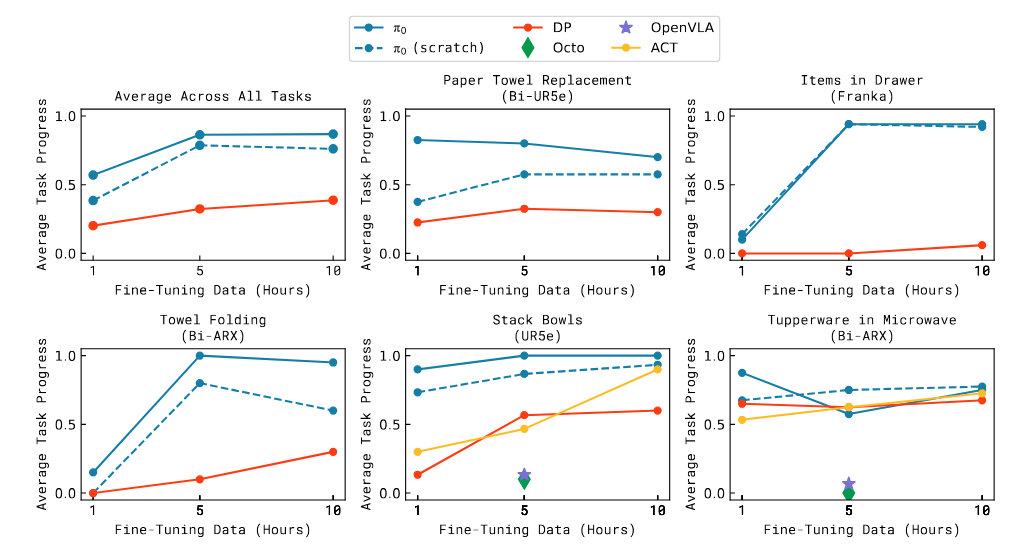
图11:不同微调数据量下的任务进度对比。π₀在小数据场景优势巨大,1小时数据就能达到其他方法10小时的效果。
出处:原文Figure 11
结果分析:
- 小样本优势巨大:1小时微调数据下,π₀的表现远超所有基线,预训练的迁移价值体现得淋漓尽致。
- 越难的任务增益越大:和预训练越不相似的困难任务,预训练带来的提升越明显;简单任务大家差距不大。
- 打破预训练无效魔咒:之前很多VLA模型预训练+微调反而打不过从零训练的专用方法,π₀真正实现了预训练正向迁移,基础模型的价值终于落地。
5.4 复杂长时序任务:刷新灵巧操作上限
这是论文最硬核的部分:测试7个5~20分钟的超复杂多阶段任务,验证模型处理长时序、高复杂度任务的能力。
测试任务:
- 预训练内:静态叠衣服、移动叠衣服、烘干机取衣服
- 预训练外:收拾餐桌、拼纸箱、打包便当、装鸡蛋
对比三种配置:开箱即用、从零训练、预训练+微调。
任务场景如下图所示:
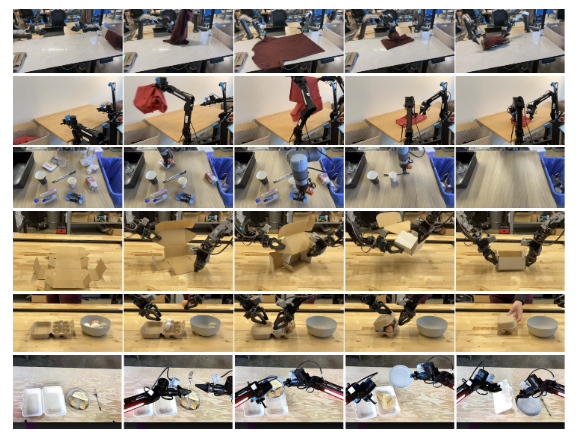
图12:复杂多阶段任务示例。涵盖衣物折叠、餐桌清理、纸箱组装、食品打包等场景,均为长时序高复杂度任务。
出处:原文Figure 12
定量结果如下图所示:
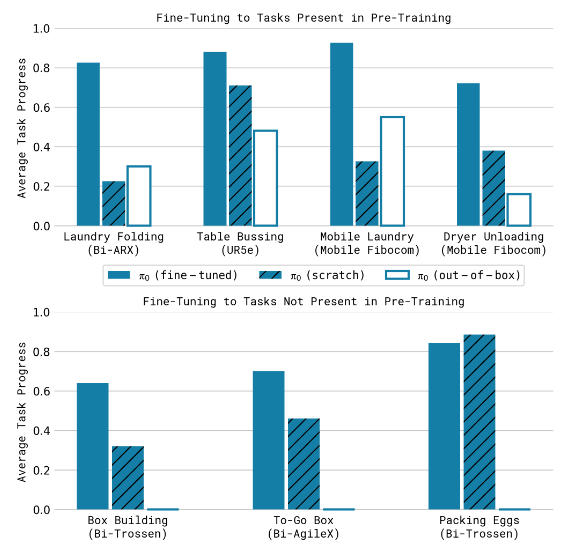
图13:复杂任务平均得分对比。左为预训练内任务,右为预训练外任务。全流程预训练+微调在所有任务上均最优,难度越高优势越大。
出处:原文Figure 13
结果分析:
- 全流程方案最优:所有任务都是“预训练+微调”效果最好,开箱即用次之,从零训练最差。
- 难度越高增益越大:拼纸箱、装鸡蛋这种完全没见过的难任务,从零训练几乎做不成,预训练+微调就能拿到不错的分数。
- 鲁棒性差异明显:从零训练的模型动作标准但一碰就崩;预训练过的模型哪怕出点错也能自己救回来,这就是海量数据带来的隐性优势。
- 行业新标杆:这是目前端到端机器人学习文献中,时长最长、复杂度最高的灵巧任务演示,把通用机器人的能力边界往前推了一大步。
5.5 推理性能:消费级显卡实时跑
在RTX 4090消费级显卡上测试推理速度,3摄像头输入下各模块耗时如下:
| 模块 | 推理耗时 |
|---|---|
| 图像编码器 | 14 ms |
| 观测前向传播 | 32 ms |
| 10步流匹配推理 | 27 ms |
| 板载总耗时 | 73 ms |
| 离板推理(含网络延迟) | 86 ms |
表1:RTX 4090上单轮推理耗时
出处:原文Table I
工程落地策略:
- 20Hz机器人(UR5e、Franka):每0.8秒推理一次,执行前16步动作;
- 50Hz机器人(双臂、移动平台):每0.5秒推理一次,执行前25步动作。
一次生成50步动作,不用每步都推理,既保证了动作平滑,又把算力开销压到了可接受范围。哪怕是离板远程推理,也只多13ms延迟,完全不影响控制。
通俗解释:
相当于机器人每眨一下眼(约100ms)就算好了接下来半秒的动作,反应速度比人还快,干活的时候完全不会卡顿。普通消费级显卡就能带动,不用买昂贵的工业计算单元。
六、核心代码实现
以下是π₀核心逻辑的PyTorch简化实现,包含条件流匹配损失、动作专家结构和推理流程,便于理解核心原理。
import torch
import torch.nn as nn
import torch.nn.functional as F
import math

# --------------------------
# 1. 条件流匹配损失函数
# --------------------------
class ConditionalFlowMatchingLoss(nn.Module):
    def __init__(self, sigma=0.0, s_cutoff=0.999):
        super().__init__()
        self.s_cutoff = s_cutoff

    def sample_timestep(self, batch_size, device):
        """采样偏移Beta分布的时间步,侧重低tau(高噪声)"""
        # Beta(1.5, 1) 采样后映射到 [0, s_cutoff]
        u = torch.rand(batch_size, 1, 1, device=device)
        tau = self.s_cutoff * (1 - u ** (2/3))  # Beta(1.5,1)的逆CDF
        return tau

    def forward(self, action_expert, gt_action, obs_feat):
        """
        Args:
            action_expert: 动作专家网络 v_theta
            gt_action: [B, H, action_dim] 真实动作序列
            obs_feat: [B, obs_dim] 观测融合特征
        """
        B, H, D = gt_action.shape

        # 采样时间步 tau
        tau = self.sample_timestep(B, gt_action.device)

        # 采样高斯噪声
        noise = torch.randn_like(gt_action)

        # 线性插值得到带噪动作
        noisy_action = tau * gt_action + (1 - tau) * noise

        # 真实向量场 u = gt_action - noise
        target_vector = gt_action - noise

        # 模型预测向量场
        pred_vector = action_expert(noisy_action, tau.squeeze(-1).squeeze(-1), obs_feat)

        # MSE损失
        loss = F.mse_loss(pred_vector, target_vector)
        return loss

# --------------------------
# 2. 简化版动作专家 (Transformer + 交叉注意力)
# --------------------------
class ActionExpert(nn.Module):
    def __init__(self, action_dim=18, hidden_dim=1024, cond_dim=2048, num_layers=4, num_heads=8):
        super().__init__()
        self.action_proj = nn.Linear(action_dim, hidden_dim)
        self.time_mlp = nn.Sequential(
            nn.Linear(1, hidden_dim),
            nn.SiLU(),
            nn.Linear(hidden_dim, hidden_dim)
        )
        self.cond_proj = nn.Linear(cond_dim, hidden_dim)

        # 交叉注意力+自注意力交替层
        self.layers = nn.ModuleList()
        for _ in range(num_layers):
            self.layers.append(nn.ModuleDict({
                'cross_attn': nn.MultiheadAttention(hidden_dim, num_heads, batch_first=True),
                'self_attn': nn.MultiheadAttention(hidden_dim, num_heads, batch_first=True),
                'norm1': nn.LayerNorm(hidden_dim),
                'norm2': nn.LayerNorm(hidden_dim),
                'norm3': nn.LayerNorm(hidden_dim),
                'mlp': nn.Sequential(
                    nn.Linear(hidden_dim, hidden_dim * 4),
                    nn.SiLU(),
                    nn.Linear(hidden_dim * 4, hidden_dim)
                )
            }))

        self.out_proj = nn.Linear(hidden_dim, action_dim)

    def forward(self, noisy_action, tau, obs_feat):
        """
        Args:
            noisy_action: [B, H, action_dim] 带噪动作序列
            tau: [B] 时间步
            obs_feat: [B, cond_dim] 观测条件特征
        """
        # 动作投影 + 时间步嵌入
        x = self.action_proj(noisy_action)
        t_emb = self.time_mlp(tau.unsqueeze(-1)).unsqueeze(1)
        x = x + t_emb

        # 条件特征
        cond = self.cond_proj(obs_feat).unsqueeze(1)

        # 交替注意力层
        for layer in self.layers:
            # 交叉注意力:动作token关注观测特征
            residual = x
            x = layer['norm1'](x)
            x, _ = layer['cross_attn'](x, cond, cond)
            x = x + residual

            # 自注意力:动作token之间交互
            residual = x
            x = layer['norm2'](x)
            x, _ = layer['self_attn'](x, x, x)
            x = x + residual

            # MLP
            residual = x
            x = layer['norm3'](x)
            x = layer['mlp'](x)
            x = x + residual

        # 输出向量场
        return self.out_proj(x)

# --------------------------
# 3. 推理:欧拉积分生成动作
# --------------------------
@torch.no_grad()
def infer_action(action_expert, obs_feat, num_steps=10, action_dim=18, horizon=50):
    """
    从纯噪声出发,欧拉积分生成动作序列
    """
    B = obs_feat.shape[0]
    device = obs_feat.device

    # 初始化:纯高斯噪声
    x = torch.randn(B, horizon, action_dim, device=device)
    dt = 1.0 / num_steps

    for i in range(num_steps):
        tau = i / num_steps
        tau_tensor = torch.full((B,), tau, device=device)

        # 预测向量场
        v = action_expert(x, tau_tensor, obs_feat)

        # 欧拉步更新
        x = x + dt * v

    return x

# --------------------------
# 使用示例
# --------------------------
if __name__ == "__main__":
    # 初始化
    action_dim = 18
    hidden_dim = 1024
    cond_dim = 2048

    action_expert = ActionExpert(action_dim, hidden_dim, cond_dim)
    criterion = ConditionalFlowMatchingLoss()

    # 模拟训练前向
    batch_obs = torch.randn(8, cond_dim)
    batch_actions = torch.randn(8, 50, action_dim)
    loss = criterion(action_expert, batch_actions, batch_obs)
    print(f"流匹配训练损失: {loss.item():.4f}")

    # 模拟推理
    pred_actions = infer_action(action_expert, batch_obs, num_steps=10)
    print(f"生成动作序列形状: {pred_actions.shape}")
代码说明:
- 实现了论文采用的线性高斯流匹配与偏移Beta时间步采样;
- 动作专家采用交叉注意力+自注意力交替结构,对应论文的混合专家设计;
- 推理使用10步欧拉积分,符合论文的实时控制配置;
- 完整的VLM主干、多图像编码、跨体数据处理等工程细节可参考官方开源实现。
七、总结与展望
核心结论
- 架构路线成立:VLM语义主干+独立动作专家+流匹配动作生成的组合,是通用机器人基础模型的高效可行路线,既继承了互联网预训练的语义能力,又保证了灵巧操作的精度和频率。
- 预训练价值落地:万小时级的跨体多任务预训练,能带来实打实的迁移增益,小数据微调就能快速适配新任务,真正实现了“基础模型+下游微调”的机器人版本。
- 两阶段训练是关键:预训练打泛化底子、后训练磨专精性能的配方,和大语言模型的发展规律高度一致,是兼顾鲁棒性和效率的最优解。
- 灵巧操作上新台阶:成功搞定十几分钟的叠衣服、拼纸箱等复杂任务,把端到端学习的机器人能力边界推到了新高度。
未来方向
- 数据配方优化:目前是有什么数据用什么数据,未来需要搞清楚加什么数据、加多少、怎么加权收益最高。
- 跨领域迁移验证:现在主要是操作任务,未来可以探索向导航、腿足机器人等完全不同的领域迁移,验证通用机器人模型的边界。
- 强化学习对齐:目前还是纯模仿学习,未来结合在线强化学习进一步提升成功率和鲁棒性,像大语言模型RLHF那样做机器人的动作对齐。
总的来说,π₀不是一个单点算法创新,而是一套从架构、数据到训练流程的完整通用机器人基础模型方案。它证明了机器人领域也能复制大模型“预训练+微调”的成功范式,为后续通用机器人的发展踩平了很多关键的坑。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 10
 0
- 0


 已为社区贡献3条内容

所有评论(0)