Scrapling 保姆级教程来了,零基础入门!狂揽 29.9 万 Star 的爬虫神器
大家好,今天给大家带来一款近期在 GitHub 上爆火的 Python 爬虫库——Scrapling。
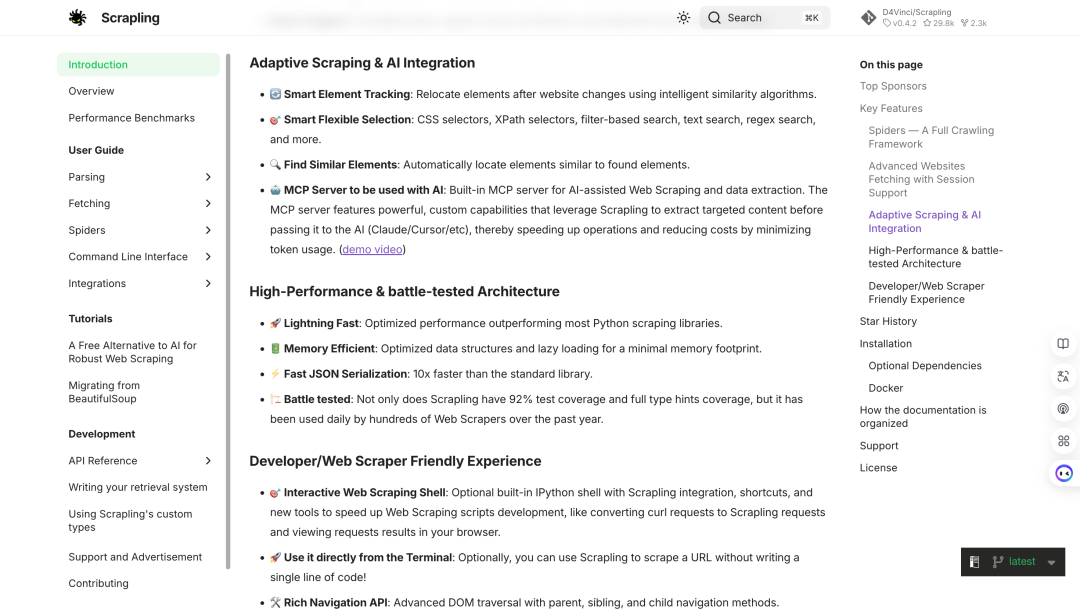
如果你做过爬虫,肯定遇到过这些痛点:网站反爬太严、HTML 解析麻烦、动态加载搞不定、IP 被封到怀疑人生。Scrapling 的出现,就是为了解决这些问题。
这篇文章会从 Scrapling 是什么、核心功能、实战案例、使用技巧等多个维度,带大家全面了解这个爬虫界的新星。希望能帮你节省一些调研时间。
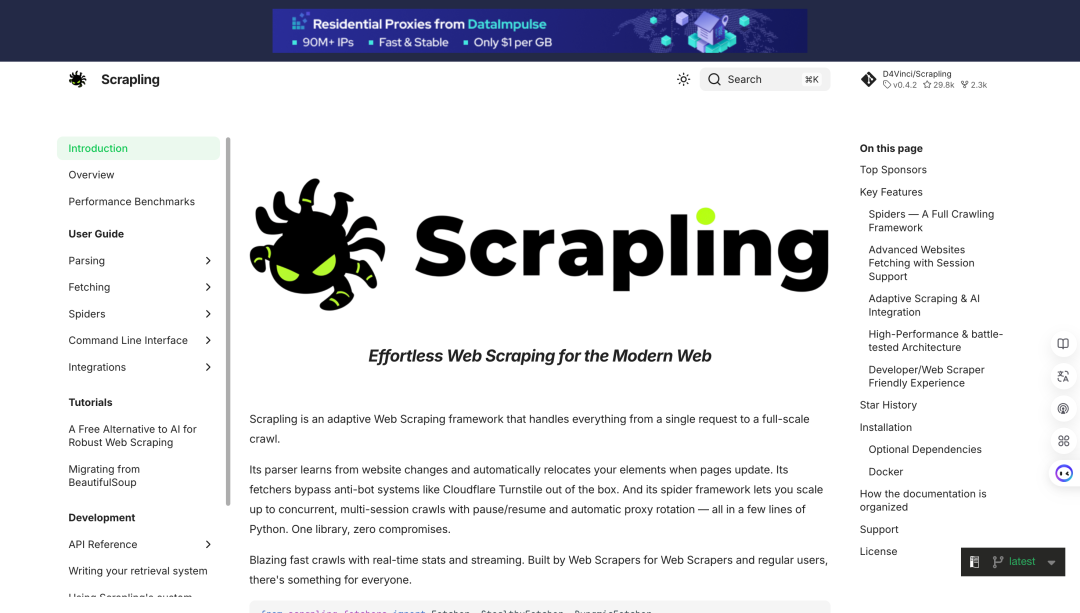
一、Scrapling 到底是什么?
Scrapling 是一个现代化的 Python 网页爬虫库,2025 年在 GitHub 上横空出世,短短几个月就狂揽 2.3 万 Star,成为爬虫圈的现象级项目。
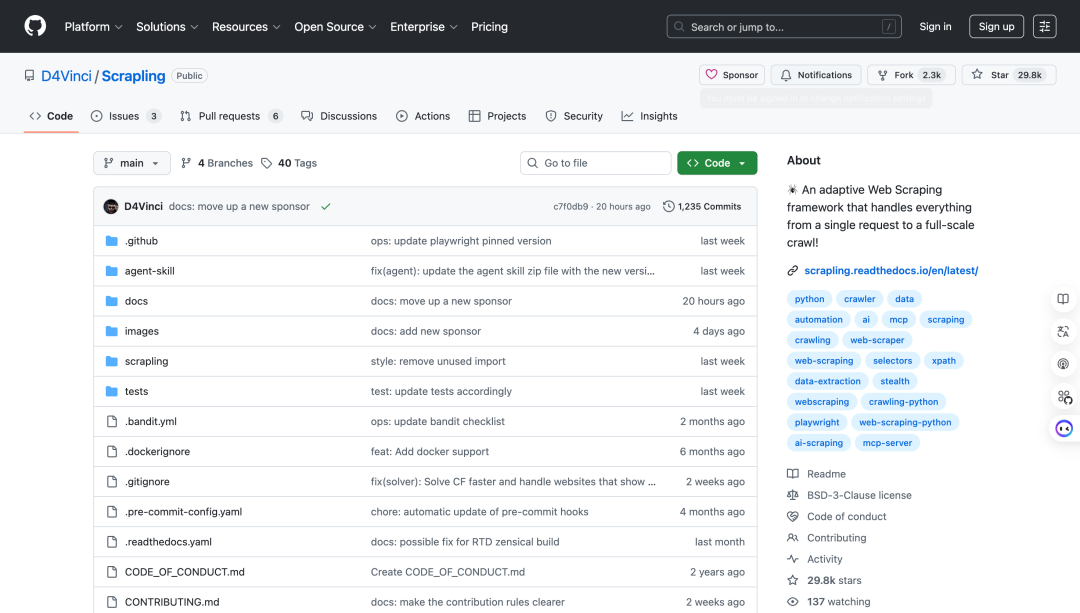
项目地址:https://github.com/D4Vinci/Scrapling
官方定位:一个智能、快速、易用的网页抓取框架,专为现代网站设计。
从定位来看,Scrapling 主要是为了帮助开发者快速实现网页数据抓取,减少重复造轮子的时间。对于需要采集数据但被反爬机制困扰的场景,这个库非常实用。
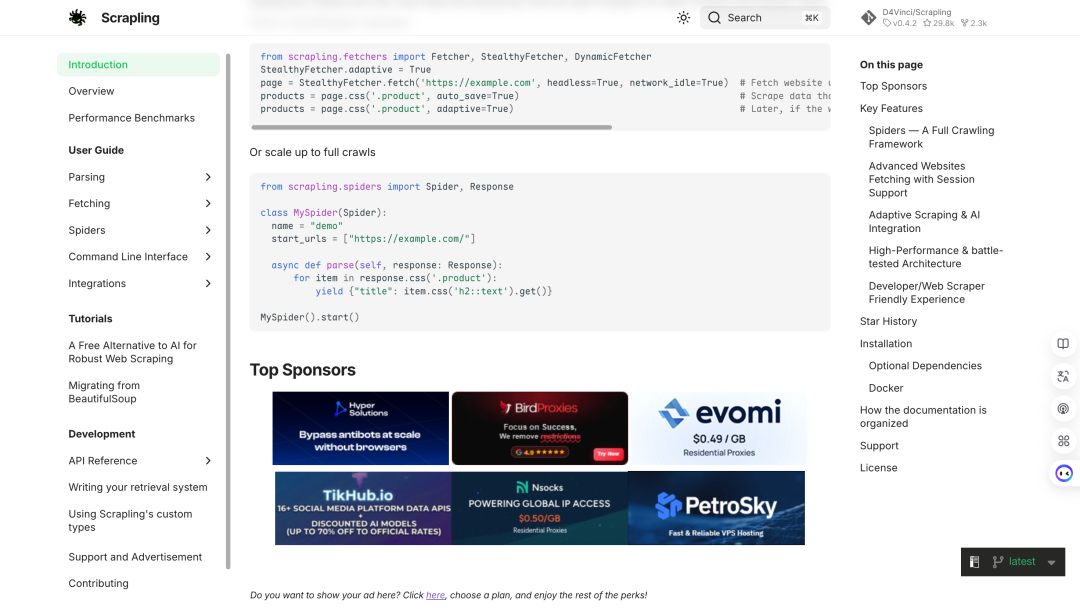
二、Scrapling 能做什么?
Scrapling 的核心能力可以总结为以下几点:
1. 智能反爬绕过
内置多种反爬对抗策略,自动处理常见的反爬机制,如 User-Agent 检测、请求频率限制、指纹识别等。
2. 动态页面支持
完美支持 JavaScript 渲染的页面,无需额外配置 Selenium 或 Playwright,直接抓取动态加载的内容。
3. 智能选择器
提供类似 CSS 选择器和 XPath 的语法,但更智能、更容错,即使网页结构变化也能稳定抓取。
4. 自动重试机制
内置智能重试系统,遇到网络错误或反爬拦截时自动切换策略重试,提高成功率。
5. 会话管理
支持持久化会话,自动管理 Cookie 和请求头,模拟真实浏览器行为。

三、Scrapling 核心功能玩法
1. 基础抓取
from scrapling import Fetcher

fetcher = Fetcher()
response = fetcher.get('https://example.com')

# 提取标题
title = response.css('h1::text').get()
print(title)

# 提取所有链接
links = response.css('a::attr(href)').getall()
print(links)
2. 动态页面抓取
from scrapling import Fetcher

fetcher = Fetcher(headless=True)
response = fetcher.get('https://example-dynamic.com')

# 等待页面加载完成
response.wait_for_selector('.content')

# 提取动态加载的内容
items = response.css('.item::text').getall()
print(items)
3. 智能选择器
# 模糊匹配,即使 class 名变化也能抓取
product = response.css('[class*="product"] .name::text').get()

# 链式调用,更优雅
prices = (response
    .css('.product-list')
    .css('.item')
    .css('.price::text')
    .getall())
4. 批量抓取
urls = [
    'https://example.com/page1',
    'https://example.com/page2',
    'https://example.com/page3',
]

results = fetcher.get_many(urls, concurrency=3)

for url, response in results:
    title = response.css('h1::text').get()
    print(f'{url}: {title}')
四、Scrapling 使用技巧及注意事项
1. 合理设置请求间隔
虽然 Scrapling 有自动限流,但建议手动设置延迟,避免对目标网站造成过大压力。
fetcher = Fetcher(delay_range=(1, 3)) # 1-3 秒随机延迟
2. 使用代理池
对于大规模抓取,建议配合代理池使用:
fetcher = Fetcher(proxies=['http://proxy1:port', 'http://proxy2:port'])
3. 自定义请求头
根据需要自定义请求头,模拟特定浏览器:
headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64)...',
    'Accept-Language': 'zh-CN,zh;q=0.9',
}
fetcher = Fetcher(headers=headers)
4. 异常处理
始终做好异常处理,避免程序崩溃:
try:
    response = fetcher.get(url)
    data = response.css('.content::text').get()
except Exception as e:
    print(f'抓取失败:{e}')
五、Scrapling 应用案例
🎯 案例 1:电商商品价格监控
背景:需要监控某电商平台商品价格变化,每天定时抓取。
问题:网站有反爬机制,频繁请求会被封 IP。
解决方案:
from scrapling import Fetcher
import json

fetcher = Fetcher(delay_range=(2, 5), auto_retry=True)

def get_product_price(url):
    response = fetcher.get(url)
    price = response.css('.price-current::text').get()
    title = response.css('.product-title::text').get()
    return {'title': title, 'price': price}

# 抓取多个商品
urls = ['url1', 'url2', 'url3']
results = [get_product_price(url) for url in urls]

# 保存到文件
with open('prices.json', 'w', encoding='utf-8') as f:
    json.dump(results, f, ensure_ascii=False, indent=2)
结果:成功实现每日价格监控,未被封禁。
踩坑记录:
-
一开始没设置延迟,被抓取网站识别为机器人
-
后来加上 2-5 秒随机延迟,问题解决
-
建议配合代理池使用,更安全
🎯 案例 2:新闻网站内容聚合
背景:需要聚合多个新闻网站的头条新闻。
问题:各网站结构不同,需要统一解析。
解决方案:使用 Scrapling 的智能选择器,对各网站分别编写解析规则,然后统一输出格式。
结果:成功聚合 10+ 个新闻源,每天自动生成汇总报告。
六、常见问题解答
Q1:Scrapling 和 BeautifulSoup、Scrapy 有什么区别?
Scrapling 是更现代的选择。BeautifulSoup 只负责解析,不负责抓取;Scrapy 功能强大但学习曲线陡峭。Scrapling 介于两者之间,既易用又功能全面,特别适合中小型爬虫项目。
Q2:Scrapling 能抓取需要登录的网站吗?
可以。Scrapling 支持会话管理,可以先登录获取 Cookie,然后在后续请求中自动携带。
Q3:动态加载的页面能抓取吗?
完全支持。Scrapling 内置了无头浏览器功能,可以等待 JavaScript 执行完成后再抓取。
Q4:会被网站封 IP 吗?
任何爬虫都有可能被封。Scrapling 提供了多种反反爬策略,但建议配合代理池和合理的请求间隔使用。
Q5:Scrapling 支持 Python 哪个版本?
支持 Python 3.8+,建议使用 Python 3.10 或更高版本以获得最佳性能。
七、注意事项
-
⚠️ 遵守目标网站的 robots.txt 协议,不要抓取禁止爬取的内容
-
⚠️ 合理控制请求频率,避免对目标网站造成过大压力
-
⚠️ 仅供学习和研究使用,不要用于非法用途
-
⚠️ 大规模抓取建议使用代理池,避免 IP 被封
-
⚠️ 注意数据隐私,不要抓取和存储敏感个人信息
-
⚠️ 商业使用前请确认目标网站的使用条款
写在最后
Scrapling 的出现,确实让爬虫开发变得更简单了。它智能、快速、易用,是 Python 爬虫工具箱里值得添加的新武器。
当然,工具再强大也要合法合规使用。爬虫技术本身是中性的,关键在于使用它的人。
如果今天的分享对你有帮助,可以收藏一下。后续还会持续分享更多实用技术。
项目地址:https://github.com/D4Vinci/Scrapling

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 6
 0
- 0


 已为社区贡献6条内容

所有评论(0)