【Agentic RL / 强化学习框架】Uni-Agent 深度技术分析
概要
本系列目的是通过解析两个强化学习框架(Uni-Agent,Miles)来梳理Agentic RL。
Uni-Agent 是 verl 社区推出的一个面向 Agent RL 的训练/推理一体框架,以同一套交互栈同时支撑大规模 Agent 推理和 RL 训练。它在 verl(字节跳动开源的 LLM RL 训练框架)之上构建 Agent 抽象层(Model/Tool/Env 三层),将 sandbox 执行委托给 SWE-ReX。
项目的核心主张可以概括为 "推理 = 训练,同一入口"——把"Agent 如何与环境交互并产出 token-level 训练数据"封装成一套可复用、可扩展、可训练的工程系统。无论你是跑 1000 个并行的 SWE-Bench 推理任务,还是进行 GRPO/GSPO 强化学习训练,底层走的是同一套 AgentInteraction 交互循环。这种设计使得从"模型推理验证"到"大规模 RL 训练"的切换成本趋近于零——只需换一个 YAML 配置,不需要重写任何交互逻辑。
注,因为:
-
可能本文参考的verl版本不够新,且 verl 社区本身就在突飞猛进,因此可能某些对verl的认知不够准确
-
本文为“从代码反推设计理念” & 时间仓促
所以本文肯定存在很多错误,还请读者不吝指出存在的问题,谢谢。
0x01 基本功能
1.1 竞品对比与定位
在正式进入架构分析之前,我们先回答一个关键问题:Uni-Agent 在现有的 Agent 框架生态中处于什么位置?
1.1.1 三者定位
Agent 抽象层次
    高 ▲
      │  ┌──────────────┐
      │  │  OpenHands   │ 完整 Agent 应用
      │  └──────────────┘
      │
      │
      │  ┌──────────────┐   ┌──────────────────────────────┐
      │  │  SWE-Agent   │   │        Uni-Agent             │
      │  │  (学术 Agent) │   │  推理+训练一体化框架            │
      │  └──────────────┘   │  统一交互栈,大规模并发,        │
      │                     │  RL 训练原生支持               │
      │                     └──────────────┬───────────────┘
      │                                    │
      │                     ┌──────────────▼──────────────┐
      │                     │       verl (训练引擎)        │
      │                     │  AgentLoopBase/Manager      │
      │                     │  FullyAsyncRollouter        │
      │                     └─────────────────────────────┘
      └──────────────────────────────────────────────────────► 训练能力
从上图可以看出,OpenHands 定位在"完整产品"层,关注的是开箱即用的 Agent 体验;SWE-Agent 定位在"学术研究"层,侧重单任务的推理表现。而 Uni-Agent 选择了第三条路:向下集成 verl 的训练能力,向上提供可编程的 Agent 抽象。这一定位使得它成为目前唯一将 Agent 交互栈与 RL 训练引擎深度集成的开源框架。这一点也在其 README 中可以看到。
# Uni-Agent: Build, Run, and Train Agents at Scale

Uni-Agent is a unified framework for general agents at scale.

- **All-in-one stack:** one framework for building, running, and training agents.
- **Unified agent interface:** unified abstractions for diverse and complex real-world agent scenarios.

The long-term vision is to build the backend infrastructure for next-generation agents across both inference and training, enabling them to perceive, act, and explore complex real-world tasks.
1.1.2 七维度对比表
| 维度 | Uni-Agent | OpenHands | SWE-Agent |
|---|---|---|---|
| 核心定位 | Agent 推理+训练一体化 | 全栈 AI 软件工程师产品 | 学术研究 Agent |
| 训练能力 | 原生 GRPO/GSPO RL,Fully Async + Partial Rollout | 无 | 无 |
| 交互模式 | ReAct Loop + Tool-as-Bash + 双 parser | Agent-Controller 事件驱动 | ReAct Loop + 自定义 DSL |
| 工具机制 | 6 种内置 tool,脚本上传到容器 | 丰富 tool 生态 | 3 种 tool |
| 环境管理 | 4 种部署 discriminated union + SWE-ReX | Docker 为主 | Docker 容器 |
| 并发规模 | 1000+ 并行,Ray + asyncio | 单实例为主 | 单实例 |
| 社区生态 | 新生项目(2026),tool 生态早期 | 成熟社区 | 学术社区 |
| 底层依赖 | verl(训练) + SWE-ReX(sandbox) | 自研 | Docker |
1.2 Uni-Agent 架构全景
因为 Uni-Agent 深度依赖 verl,下文的一些架构图会连带着 verl 一起展示,以完整呈现二者的协作关系。
1.2.1 全景图
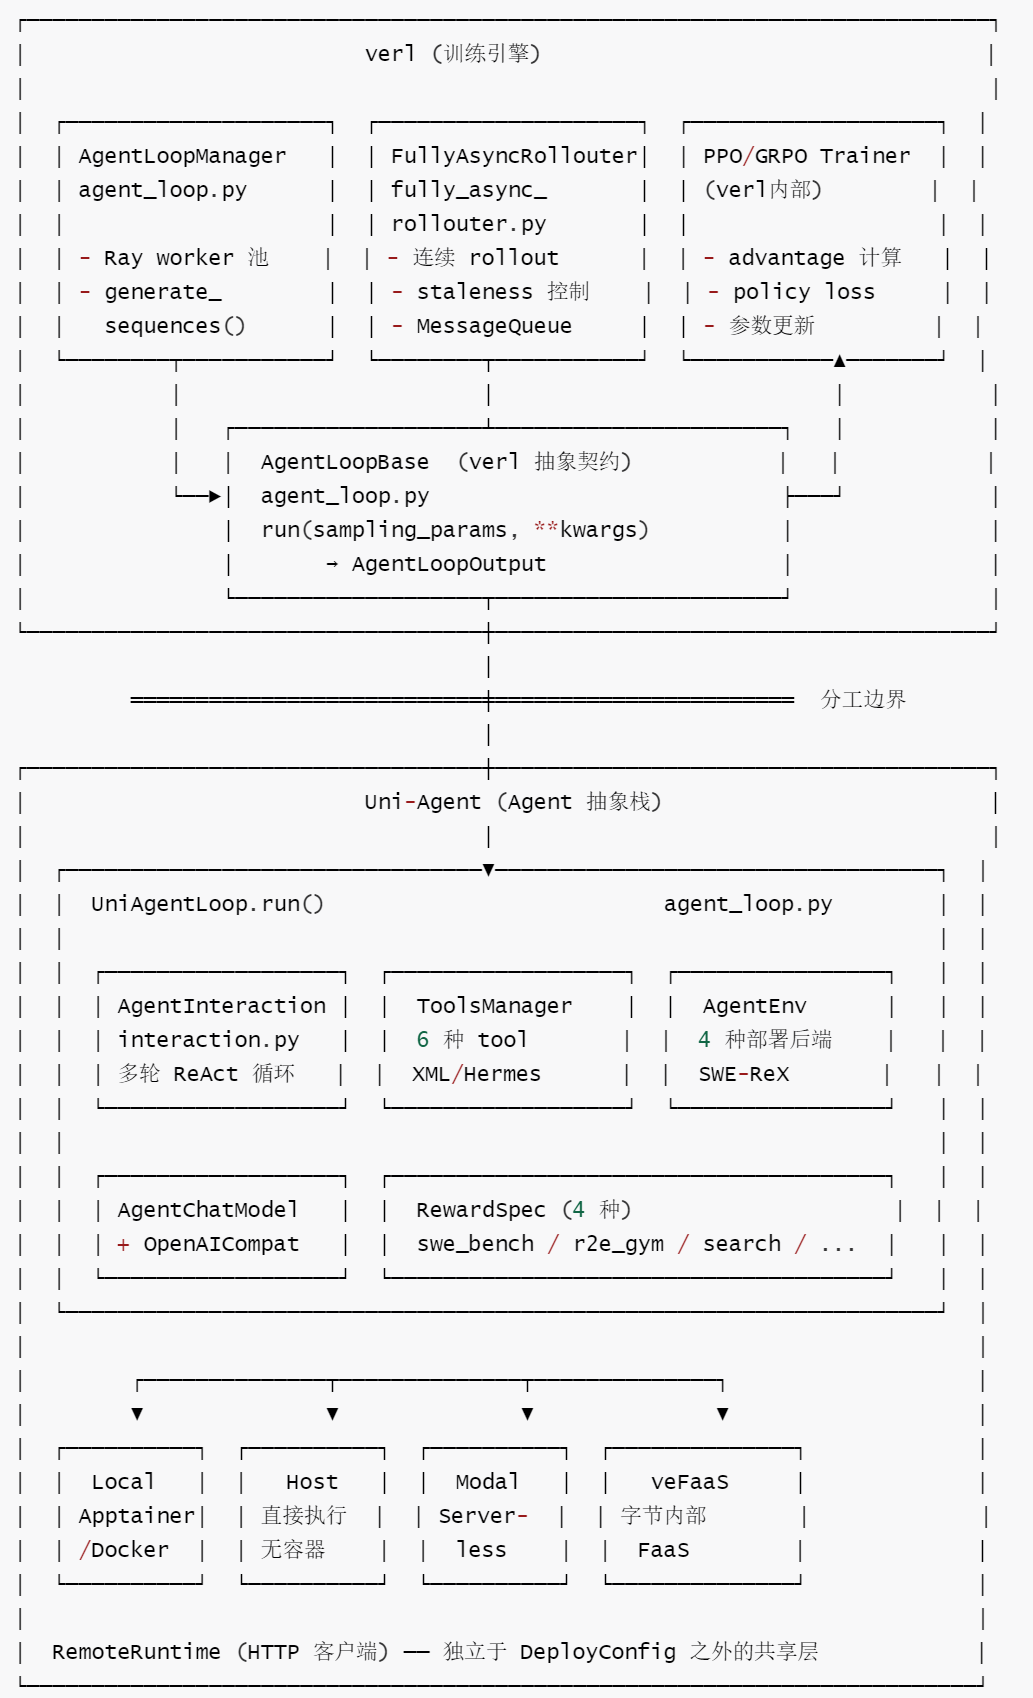
从全景图中可以清晰地看到 verl 和 Uni-Agent 的分工:
- verl 负责"怎么训练"(调度、算法、参数同步)。
- Uni-Agent 负责"训练什么"(交互逻辑、环境管理、奖励计算)。
二者的分界线是 AgentLoopBase.run() 这一个方法签名——verl 通过 hydra.utils.instantiate 创建 UniAgentLoop 实例,调用 run() 获取 AgentLoopOutput,然后将其喂入 PPO/GRPO 训练管线。
1.2.2 代码组织
           Uni-Agent                               VeRL
─────────────────────────────────   ───────────────────────────────────────
uni_agent/                          verl/verl-main/verl/
├── agent_loop.py                   ├── experimental/agent_loop/
│   └─ UniAgentLoop(AgentLoopBase)  │   ├── agent_loop.py
├── interaction/                    │   │   ├── AgentLoopBase (ABC)
│   ├── interaction.py              │   │   ├── AgentLoopOutput (BaseModel)
│   │   └─ AgentInteraction         │   │   ├── AgentLoopWorker
│   ├── model.py                    │   │   ├── AgentLoopManager
│   │   ├─ AgentChatModel           │   │   └── _agent_loop_registry
│   │   └─ OpenAICompatibleChatModel│   │   ├── tool_agent_loop.py
│   ├── env.py                      │   │   │   └─ ToolAgentLoop (verl内置)
│   │   └─ AgentEnv                 │   │   ├── tool_parser.py
│   ├── tools_manager.py            │   │   │   └─ ToolParser, FunctionCall
│   │   └─ ToolsManager             │   │   └── utils.py
│   └── tool_parser.py              │   ├── fully_async_policy/
│       ├─ XMLToolParser            │   │   ├── fully_async_main.py
│       └─ HermesToolParser         │   │   ├── fully_async_rollouter.py
├── deployment/                     │   │   └── fully_async_trainer.py
│   ├── config.py                   │   ├── tools/
│   │   └─ DeployConfig (union)     │   │   ├── schemas.py
│   ├── local/, host/, modal/,      │   │   │   ├── OpenAIFunctionToolCall
│   │   vefaas/                     │   │   │   ├── ToolResponse
│   └── remote_runtime.py           │   │   │   └── ...
├── tools/                          │   │   └── tool_registry.py
│   ├── base.py                     │   └── utils/
│   │   └─ AbstractTool             │       ├── chat_template.py
│   ├── registry.py                 │       │   ├── apply_chat_template()
│   ├── execute_bash/               │       │   └── initialize_system_prompt()
│   ├── str_replace_editor/         │       ├── tokenizer.py
│   ├── finish/, submit/            │       │   └── normalize_token_ids()
│   ├── search/, search_arxiv/      │       └── profiler.py
└── reward/                         │           └── simple_timer()
    ├── base.py                     └── workers/
    │   └─ AbstractRewardSpec           └── rollout/
    ├── registry.py                         └── replica.py
    ├── swe_bench.py                            └── TokenOutput
    ├── swe_rebench.py
    ├── r2e_gym.py
    └── search.py
1.2.3 DeployConfig 四后端
deployment/config.py 使用 Pydantic v2 discriminated union 实现编译时类型安全 + 运行时自动反序列化:
| 后端 | 类型标记 | 底层 Runtime | 适用场景 |
|---|---|---|---|
| Local | type: "local" | Apptainer/Docker/Podman 容器 | 本地开发、单机训练 |
| Host | type: "host" | 主机直接执行(无容器) | 搜索等轻量任务 |
| Modal | type: "modal" | Modal serverless sandbox | 云端弹性扩缩容 |
| veFaaS | type: "vefaas" | 字节跳动内部 FaaS | 字节内部大规模部署 |
值得注意的是,RemoteRuntime(deployment/remote_runtime.py)是独立于四种后端之外的 HTTP 客户端层,所有后端都通过它与 SWE-ReX server 通信。它不在 DeployConfig 的 discriminated union 内,而是各后端的共享基础设施——这种设计意味着添加新后端时,只需新增一个 Config 类和一个 Deployment 类,无需修改 RemoteRuntime。
0x02 Agentic RL 的难点
在深入 Uni-Agent 的设计之前,我们需要先理解它要解决什么问题。Agentic RL 与传统 RLHF 的差异不是量变,而是质变。
2.1 Agentic RL vs 传统 RLHF
传统 RLHF 训练的是一问一答的对话模型:给定一个 prompt,模型生成一段 response,奖励模型打分。这是一个"单轮、短文本、无环境交互"的场景。
π_θ(y | x)  →  reward_model(x, y)  →  PPO update
单轮文本生成         单标量奖励         一次参数更新
Agentic RL 则完全不同:它训练的是一个"与环境持续交互"的 Agent 模型。模型在真实环境中(代码仓库、终端、浏览器)通过多步交互完成复杂任务,训练目标是让模型学会更好的决策策略——不仅包括"说什么",更包括"何时采取什么行动"。
π_θ(a_t | h_t)  →  env.step(a_t)  →  o_{t+1}  →  ...  →  terminal reward
   多轮决策            多步环境交互                           稀疏、延迟奖励
两者的本质区别在于:Agentic RL 的 trajectory 是多轮交互序列,包含交替的 model 输出和 environment observation token;奖励信号是稀疏且延迟的(任务完成才给分),而非每步都有即时 reward;token 序列需要精确区分 model 生成段(参与 loss)和 tool 响应段(不参与 loss)。
2.2 Agentic RL 六大核心需求
从上述差异出发,可以归纳出 Agentic RL 框架必须满足的六项核心需求:
| # | 需求 | 说明 | Uni-Agent 实现 |
|---|---|---|---|
| 1 | 多轮交互 | Agent 与环境进行多步 ReAct 循环;模型需要多次推理,每次根据环境反馈调整行动 | AgentInteraction.run() |
| 2 | Token 级对齐/归因 | prompt/response/tool observation 的 token mask 精确对齐;RL 训练需要知道每个 token 的 log probability 的梯度归属 | rollout_cache["response_mask"] |
| 3 | 异步大规模并发 | 训练需要大量轨迹数据;上千个 agent 同时与环境交互 | asyncio.Semaphore + Ray worker pool |
| 4 | 环境多样性 | 支持不同 sandbox 后端;每个 Agent 需要独立的 sandbox,执行命令并获取结果 | 4 种 DeployConfig discriminated union |
| 5 | 异构奖励信号 | 不同 benchmark 的评估逻辑;不同任务有不同的评估方式 | 4 种 AbstractRewardSpec 实现 |
| 6 | 训练-推理统一 | 同一套代码跑推理和训练,避免训练/推理 gap | AgentChatModel + OpenAICompatibleChatModel 共享 AgentInteraction |
2.3 Agentic RL 十大难点
这六项需求背后是一系列工程和算法层面的难题。我们将它们归纳为十个主要难点,逐一分析 Uni-Agent 的应对策略。
难点 1: Token 对齐
┌─────────────────────────────────────────────────────────────────────────────────────┐
│ prompt [MASK=0] │ response₁ [MASK=1] │ obs₁ [MASK=0] │ response₂ [MASK=1] │ ...     |
└─────────────────────────────────────────────────────────────────────────────────────┘
核心问题:每次追加 tool response 时,应该重新 tokenize 整个对话历史,还是增量 tokenize?如果增量 tokenize,如何保证 token 序列格式与 model 训练时的格式完全一致?
Uni-Agent 的方案是增量 tokenize + message_boundary_tokens 探测,采用的差分对比法来发现 tokenizer 在消息边界插入的特殊 token。
难点 2: Token 流的混合属性
Agent 的 response 不再是纯模型输出,而是模型输出与环境反馈的交织:
Token 序列: [模型思考][模型动作][环境观察][模型思考][模型动作][环境观察]...
梯度归属:   [需要]    [需要]   [不需要]   [需要]   [需要]    [不需要]
这要求框架精确标记哪些 token 参与 RL 梯度计算(模型的选择),哪些只是上下文(环境反馈)。Uni-Agent 通过 response_mask(1=参与/0=不参与)来实现这一区分。
难点 3: 交互时间极长且方差巨大
传统 RLHF 中一个 rollout 约 2 秒(生成 200 tokens),但在 Agentic RL 中,一个 rollout 可能耗时 30 秒到 60 分钟(100 步交互 + 环境执行)。Batch 内样本的执行时间差异可能超过 10 倍,训练被最慢的 Agent 阻塞(长尾效应),GPU 在等待环境执行时处于空闲状态。
难点 4: 训练-推理 Gap
推理时你可能用 OpenAI API 调用模型,但训练时 verl 需要 token IDs + log probs 来计算 PPO loss。如何保证同一套交互代码在两种不同的数据格式下都能工作?
Uni-Agent 的方案是双 Model 后端共享 AgentInteraction。
难点 5: 环境资源的管理与隔离
每个 Agent 需要独立的执行环境。1000 个 Agent = 1000 个容器(内存、CPU、磁盘)。环境可能崩溃、超时、资源耗尽。不同任务可能需要不同的 Docker 镜像。容器的生命周期需要与 rollout 同步管理。Uni-Agent 通过分层错误处理 + mask_abnormal_exit_traj + timeout_budget + 探活机制来应对。
难点 6: 大规模并发稳定性
上千个 sandbox 同时运行会引发资源争抢和端口耗尽。Uni-Agent 的方案是 Semaphore 限流 + Ray worker pool + per-worker 隔离。
难点 7: Off-policy 与 Staleness(参数过期)
为了提高 GPU 利用率,推理和训练需要异步执行(Fully Async 模式下 rollout worker 和 training worker 异步运行)。但这导致 Agent 使用的模型参数可能已过期,Importance sampling ratio 的估计变得不准确,训练稳定性下降。Uni-Agent 借助 verl 的 staleness_threshold 三层防御来应对。
难点 8: Partial Rollout
慢 trajectory 不应阻塞整个 batch。verl 的 partial_rollout=True 允许部分完成的 rollout 先参与训练,Uni-Agent 对此完全透明——FullyAsyncLLMServerClient 在底层处理断点续传。
难点 9: Reward 的计算复杂性
传统 RLHF 的 reward 计算是毫秒级的(调用一次 reward model),但 Agentic RL 的 reward 计算需要在环境中跑测试套件、执行代码、对比结果,耗时为分钟级。Reward 计算本身需要环境支持,且必须在 Agent 交互完成后、环境关闭前完成。不同 benchmark 的评估逻辑完全不同。
难点 10: Credit Assignment 困难
一个 Agent 执行了 100 步,最终 reward 是 0(没解决 bug)。哪一步是关键错误?传统 RL 只有 trajectory-level 的标量 reward,无法精确归因到具体的 step 或 action。Token-level 的梯度无法区分"好的思考"和"差的行动"。这是当前整个 Agentic RL 领域尚未解决的开放问题。
0x03 verl 的能力与系统性不足
理解了 Agentic RL 要解决的难点之后,我们需要审视 Uni-Agent 的底层依赖——verl——能提供什么,不能提供什么。这决定了 Uni-Agent 必须自己构建哪些能力。
3.1 设计范式差异
verl 的定位是通用 RL 训练框架:它擅长分布式训练、GRPO/GSPO、模型并行、异步调度与推理引擎集成,但并不内建 Agent 与环境交互本身。Uni-Agent 则把注意力放在多轮交互、工具调用、环境生命周期、奖励评估时序和 token-level 轨迹构建上。两者的关系可以概括为:verl 提供骨架,Uni-Agent 负责把骨架变成可运行、可训练、可扩展的 Agent 系统。
3.1.1 本质矛盾
verl 的核心假设源自 RLHF 场景,为"单轮对话 RLHF"而生:
| 维度 | RLHF | Agentic RL |
|---|---|---|
| 交互轮数 | 1 轮 | 10-500 轮 |
| Response 时间 | 秒级 | 分钟到小时级 |
| Response 长度 | 几百 tokens | 万~十万 tokens |
| 环境依赖 | 无 | 容器 / 沙箱 / 云 |
| 失败模式 | 只有生成问题 | 环境崩溃、超时、格式错误、资源耗尽 |
| Reward 计算 | 调 reward model | 在环境中执行验证 |
| 数据组成 | 纯模型输出 | 模型输出 + 环境反馈混合 |
可以看到,verl 的设计假设在 Agent 场景下被系统性打破——几乎每一个维度都发生了质变。这不是 verl 的缺陷,而是"单轮场景"和"多轮场景"之间的根本差异。
3.1.2 分工边界
因此,Uni-Agent 与 verl 的分工非常清晰:
- verl = 训练引擎("怎么训练"):分布式调度、GPU 管理、PPO/GRPO 算法、Fully Async 策略
- Uni-Agent = Agent 抽象栈("训练什么"):多轮交互逻辑、Tool 执行、Sandbox 管理、Reward 计算
分界线是 AgentLoopBase.run() + AgentLoopOutput——一个方法签名,一个输出结构。verl 提供 RL 训练引擎,Uni-Agent 提供 Agent 行为层(环境 + 交互 + 工具 + 奖励 + 胶水),两者通过 AgentLoopOutput 协议连接。
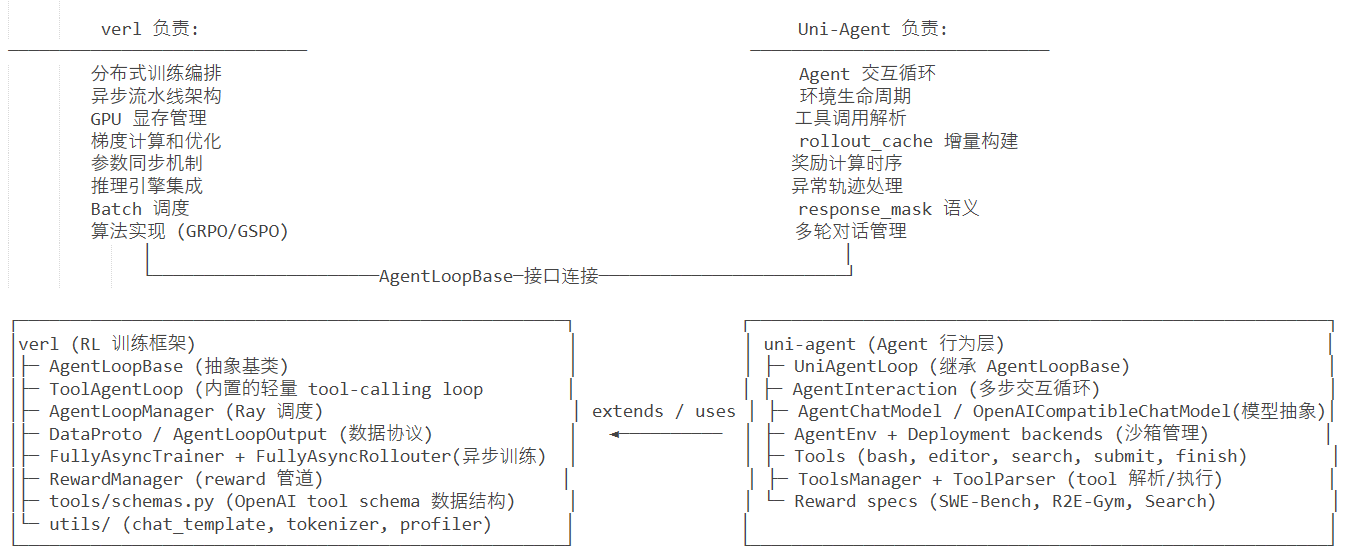
3.1.3 详细分工表
| 关注点 | verl 负责 | Uni-Agent 负责 | 边界机制 |
|---|---|---|---|
| Agent 实例创建 | hydra.utils.instantiate | YAML 中 _target_ | _agent_loop_registry |
| LLM 推理 | LLMServerClient.generate() → TokenOutput | 封装为 model.query() | self.server_manager |
| Tokenizer | AutoTokenizer 加载 + 注入 | tokenize/decode/boundary探测 | self.tokenizer |
| RL 算法 | PPO/GRPO/GSPO loss + optimizer | 不感知 | AgentLoopOutput |
| Fully Async | FullyAsyncRollouter 全模块 | 不感知(训练脚本配置) | verl 内部 |
| Partial Rollout | FullyAsyncLLMServerClient resume | 透传 max_global_steps | TokenOutput.extra_fields |
| 多轮交互逻辑 | 不提供 (ToolAgentLoop 是另一实现) | AgentInteraction.run() | run() 内部 |
| Tool Schema | verl.tools.schemas 数据类 | 6 种 tool + bash 脚本 | 使用 verl 数据类 |
| Tool 执行(沙箱) | 不提供 | ToolsManager + AgentEnv | 纯 Uni |
| Sandbox 管理 | 不提供 | 4 种 DeployConfig | 纯 Uni |
| Token 对齐 | AgentLoopOutput.response_mask | rollout_cache 增量 + boundary | AgentLoopOutput |
| Reward 计算 | reward_score 字段消费 | AbstractRewardSpec 4 种 | reward_score 字段 |
| Worker 调度 | AgentLoopManager Ray pool | 不感知 | verl 内部 |
| 数据批次 | DataProto 协议 | 填充 raw_prompt + tools_kwargs | kwargs 透传 |
| Padding | _agent_loop_postprocess() | 不感知 | verl 内部 |
| 异常分类 | 不提供 | 9 种 exit_reason + 5 层错误 | 纯 Uni |
| Dashboard | wandb/tensorboard | dashboard/ Web UI | 各自独立 |
| Tool Parse | verl 内置 ToolParser | XMLToolParser+HermesToolParser | Uni 使用自己的 parser |
3.2 verl 为 Agentic RL 做了什么
尽管 verl 的设计范式源自 RLHF,但它确实为 Agentic RL 提供了关键的专用能力。这些能力可以分为四个维度:

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 6
 0
- 0


 已为社区贡献1条内容

所有评论(0)