【HCIA-AI笔记(微认证1)】2.3 智算的算力底座
-
智算概念:
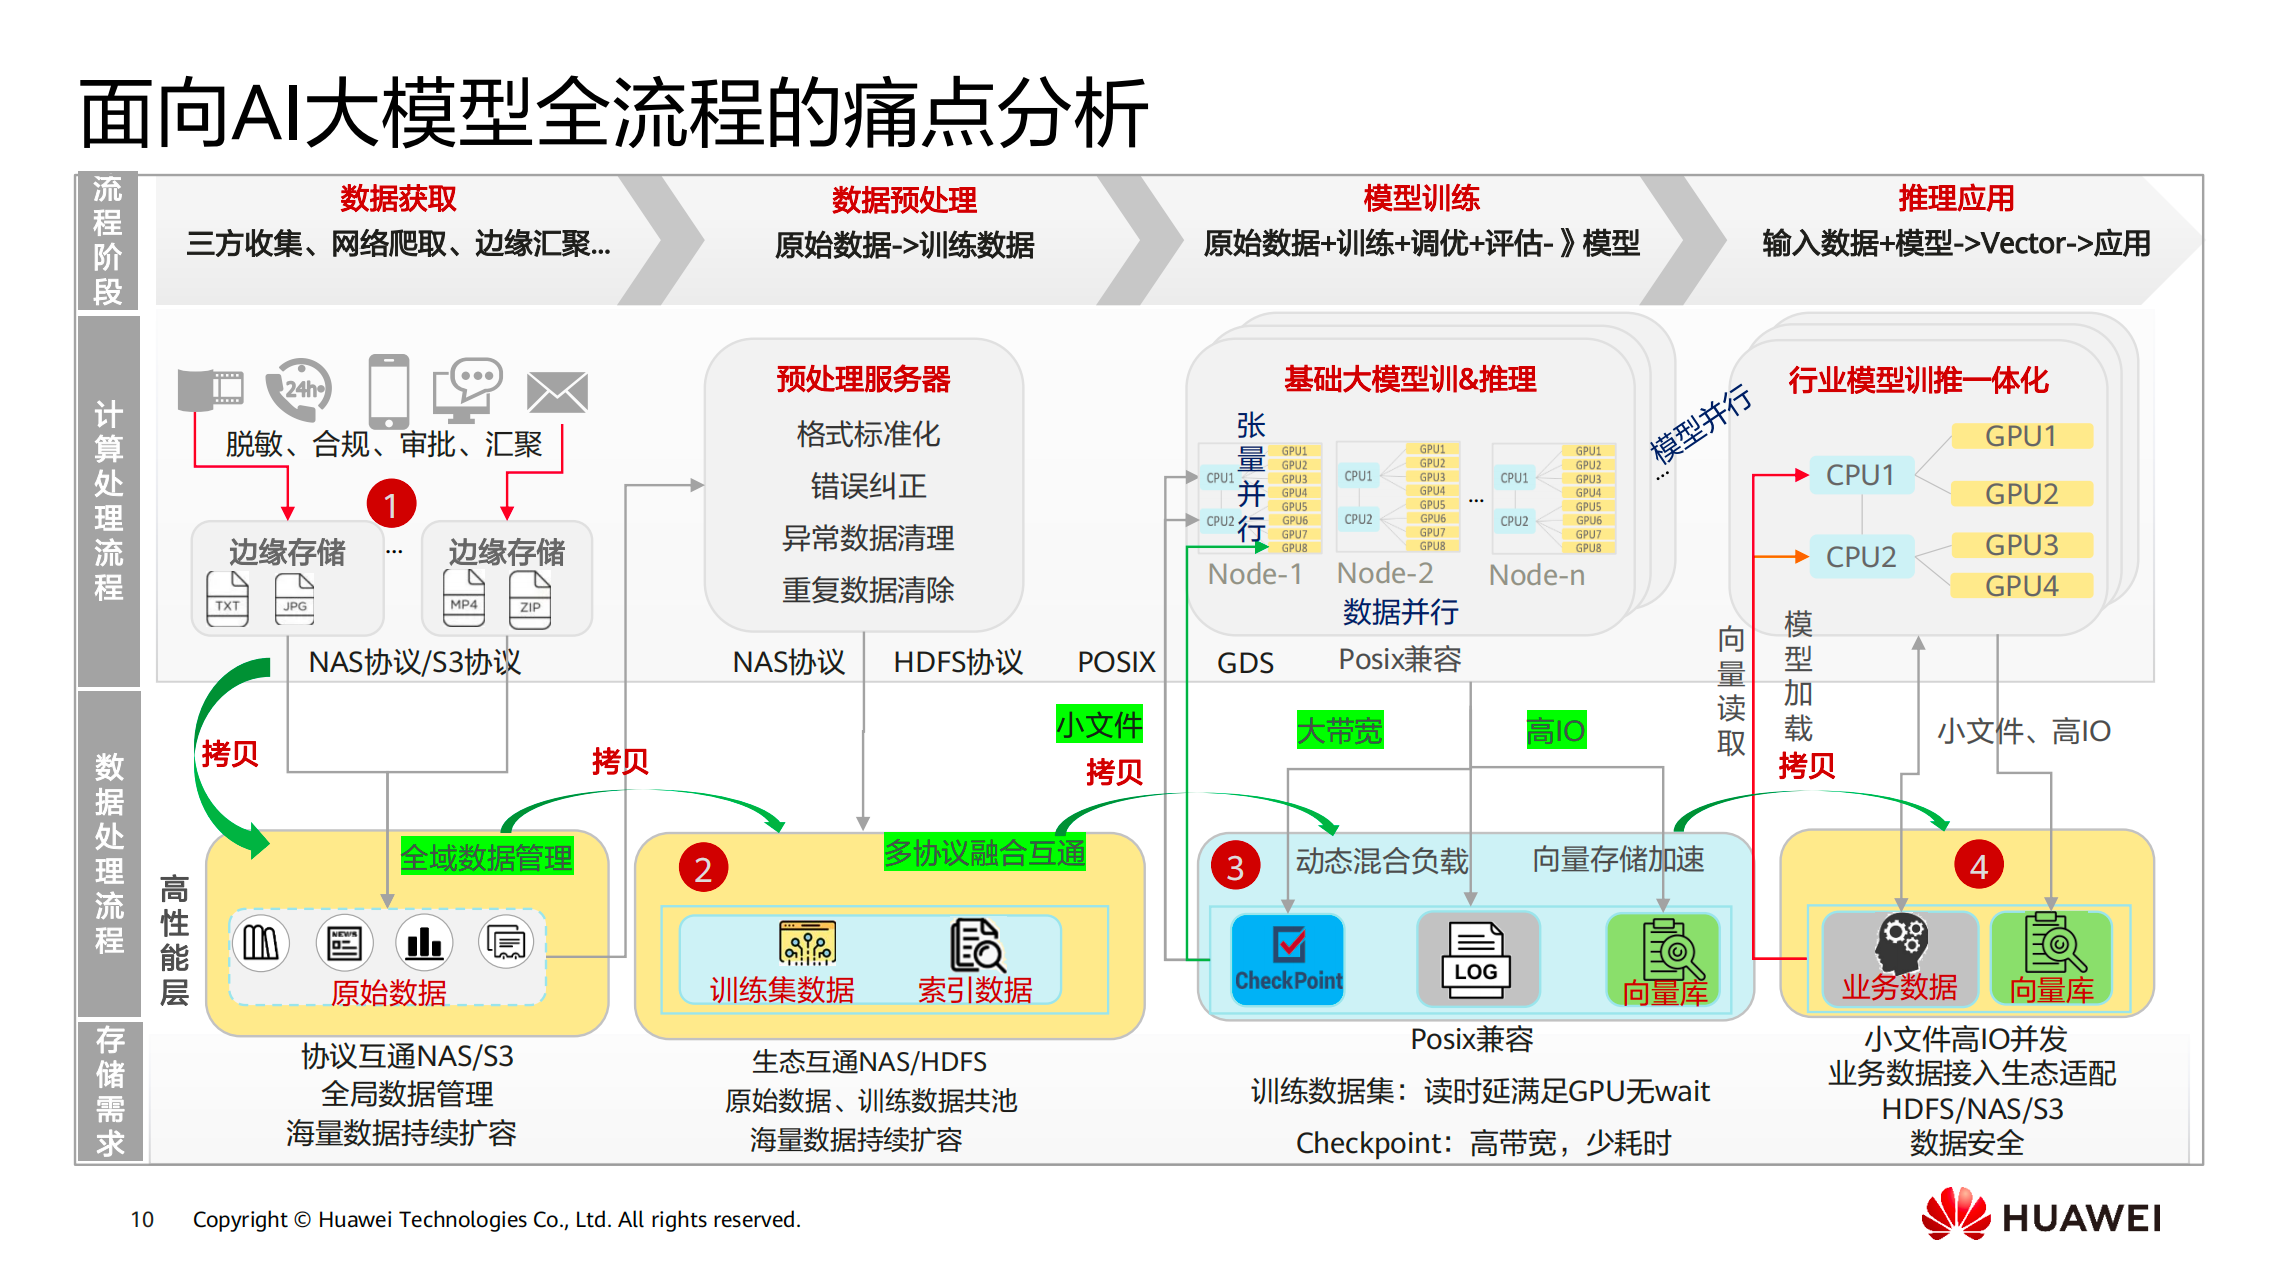
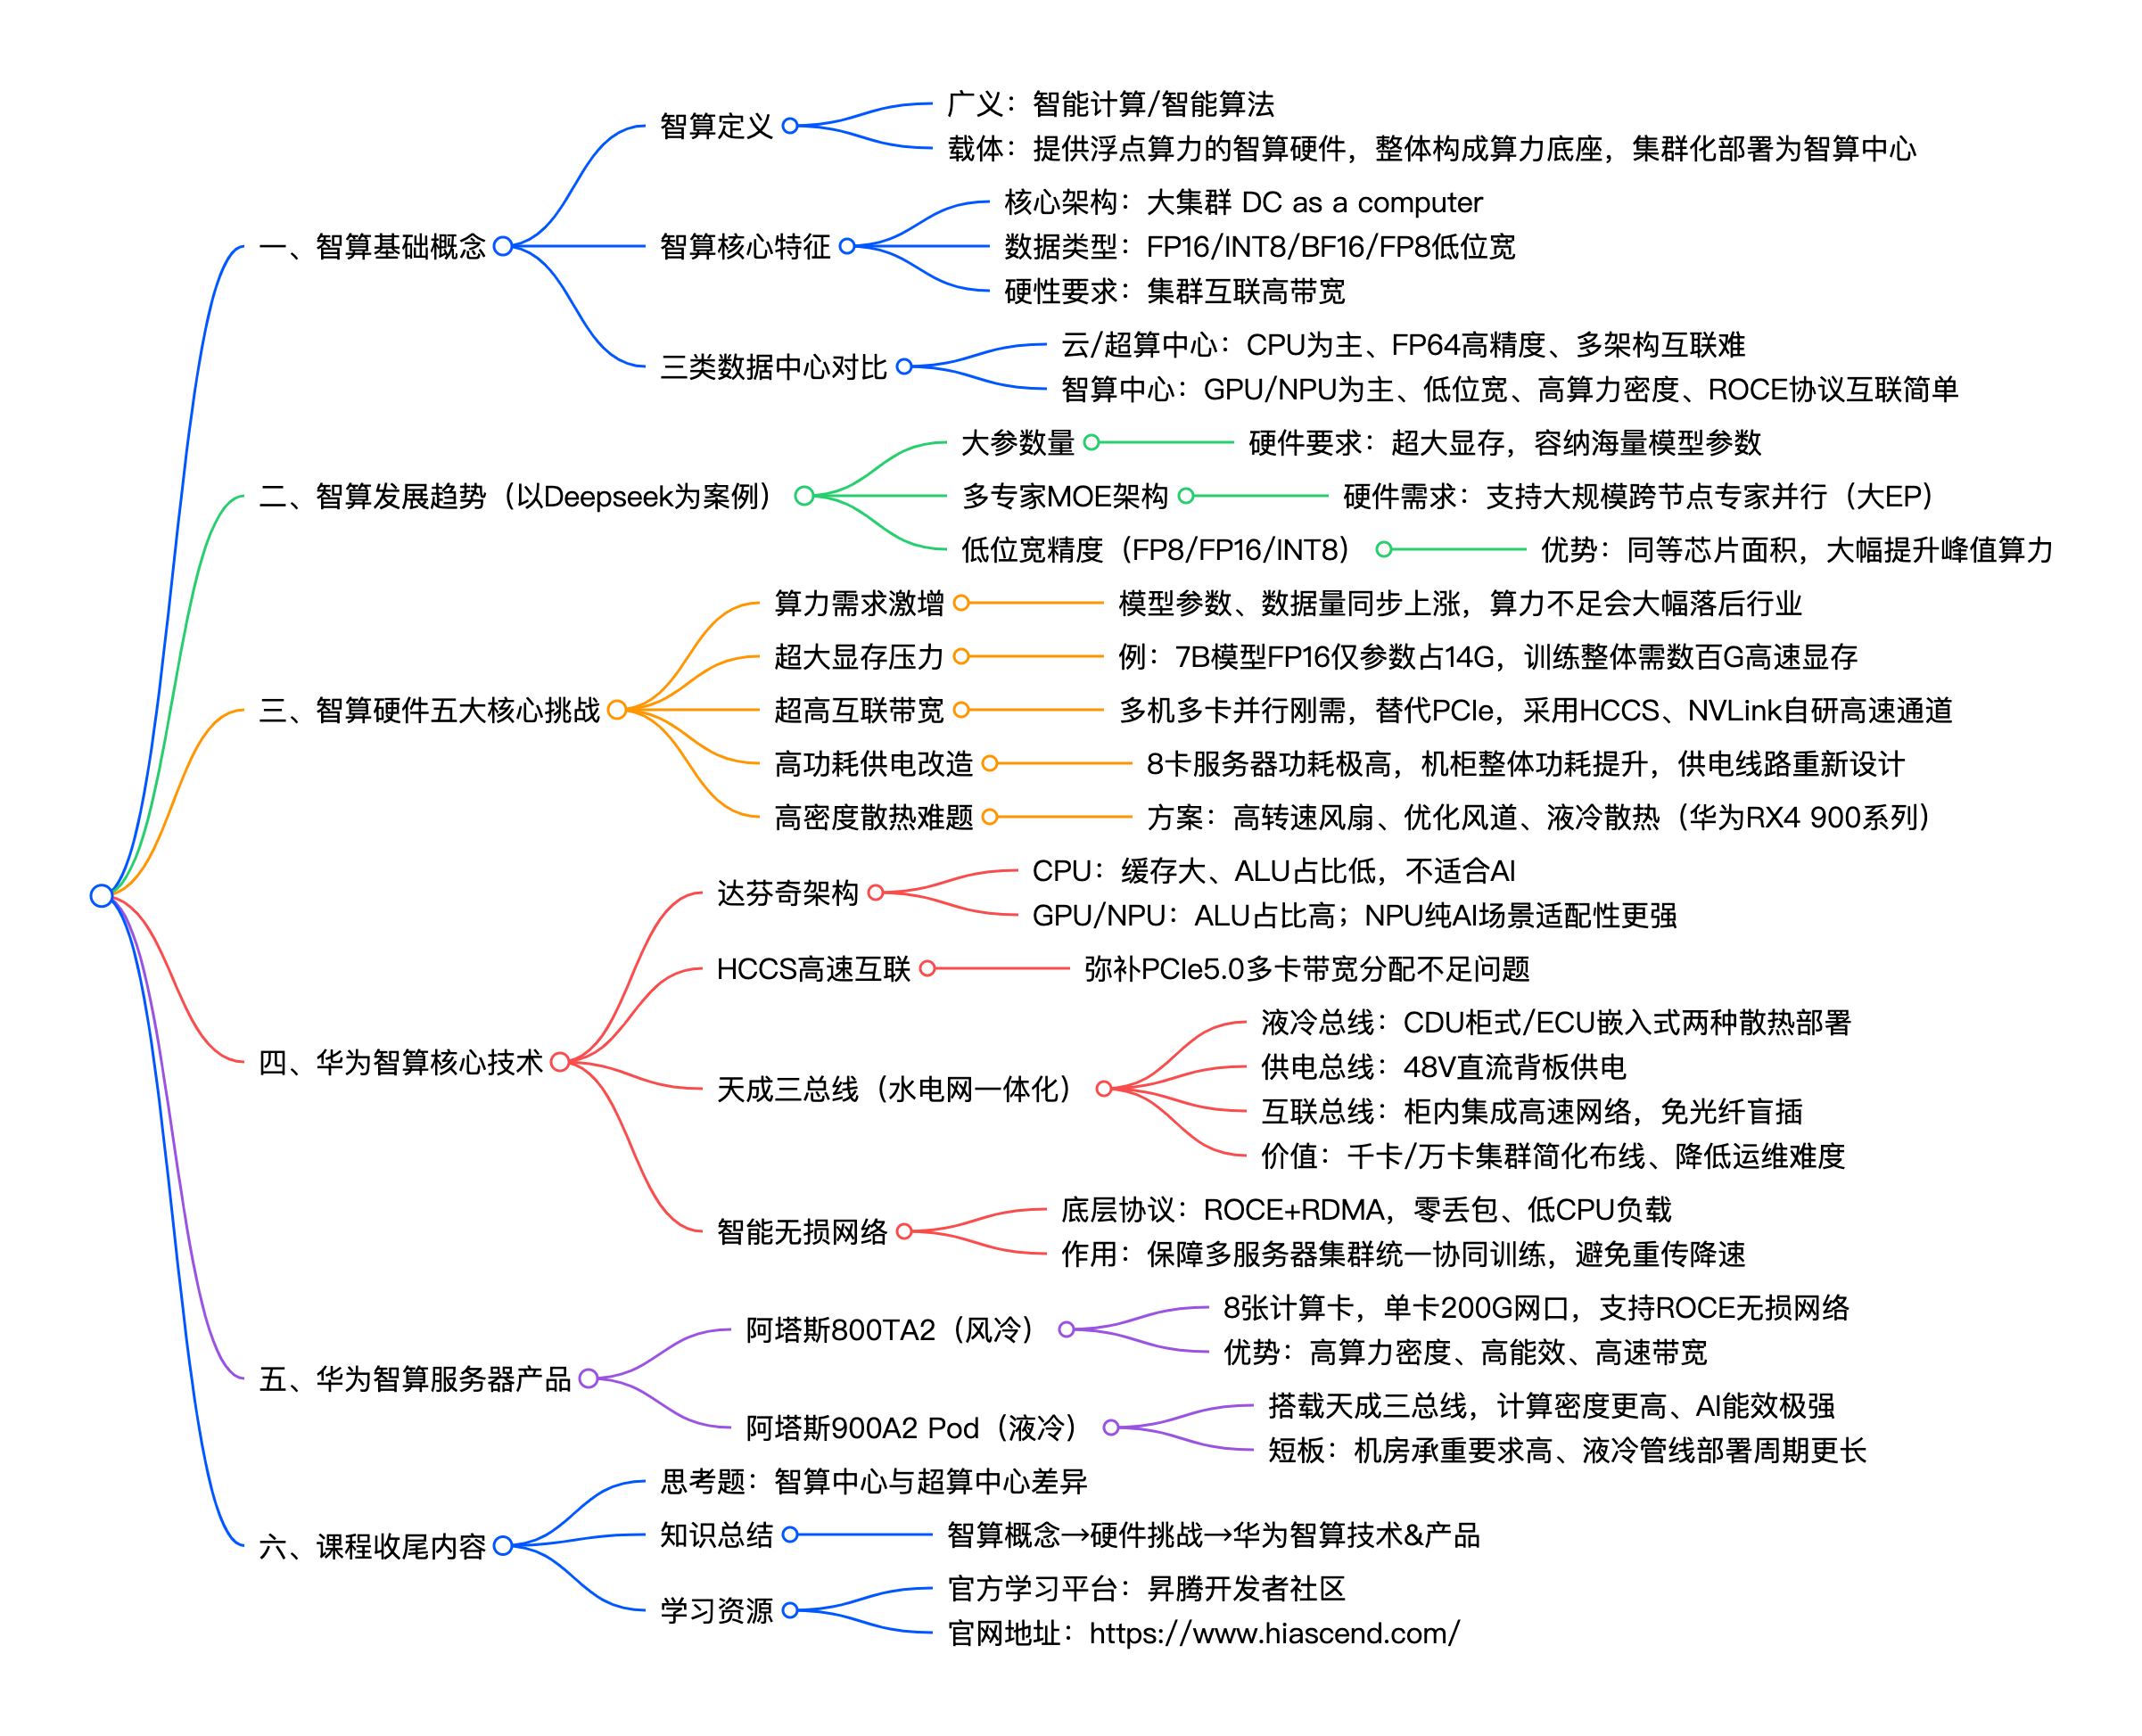
- 定义:是宽泛概念,某些场景指智能计算,另一些指智能算法,所需设备是能提供大量浮点算力的智算设备,这些高性能硬件构成智算的算力底座,基于其打造的数据中心即智算中心。
- 核心及要求:核心是大集群(DC as a computer),需要低位宽数据类型,如FP16、INT8、BF16等,对集群之间的互联带宽要求极高。
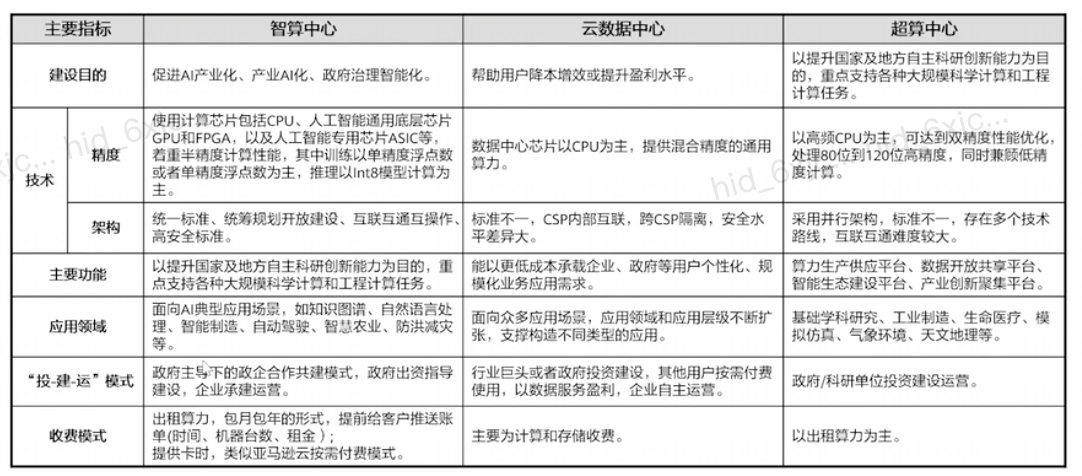
- 与其他中心区别:云数据中心和超算中心以CPU为主,对计算精度要求高,需FP64等高精度数据类型,且CPU存在多品牌、多架构、多技术路线,互联互通难度高;智算中心使用FP16甚至INT8等低精度数据类型,采用GPU、NPU等,互联协议少,互联难度低,目前广泛使用开源的ROS协议,对峰值算力要求高,属于精度要求相对低但计算密度高的数据中心。
-
智算发展趋势:
- 模型发展方向:大模型朝着大参数量、多专家、低位宽精度方向发展,如Deepseek R1和Deepseek V3采用FP8精度训练。
- 对硬件影响:大参数量要求智算硬件内存或显存容量大;多专家促使更多公司尝试用更多专家个数构建模型,需更好支持大规模跨节点专家并行;低位宽精度可提升芯片峰值算力,智算硬件朝着此方向发展。
-
智算硬件挑战:
-
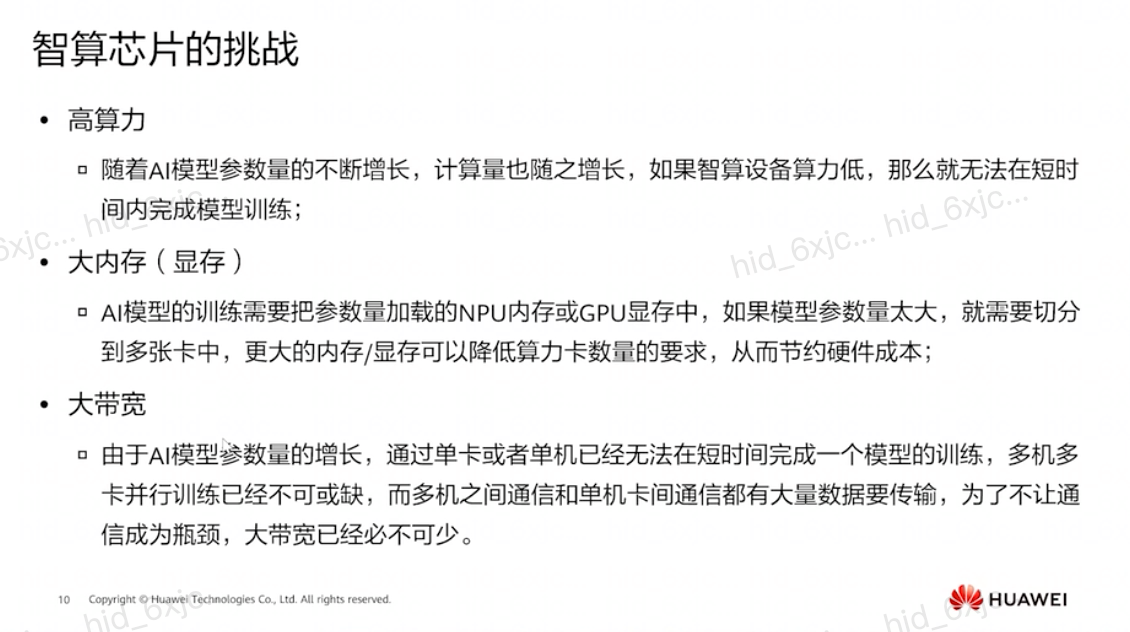
算力需求高:AI模型参数量和计算量增长,根据AI的scaling law模型,参数量增长时所需数据量同步增长,对算力要求越来越高,算力低无法短时间完成训练。
-
大内存需求:模型训练需将大规模参数加载到内存或显存,如7B模型采用FP16精度仅加载参数需14G内存,考虑中间变量和优化器参数等至少需几百G高速内存,大内存可降低对算力卡数量要求,节约硬件成本。
-
大带宽需求:AI模型参数增长使多机多卡并行训练不可或缺,多机和单机通信有大量数据传输,智算设备多采用自研技术,如华为的HCCS、英伟达的Nvlink,避免通信成为瓶颈。
-
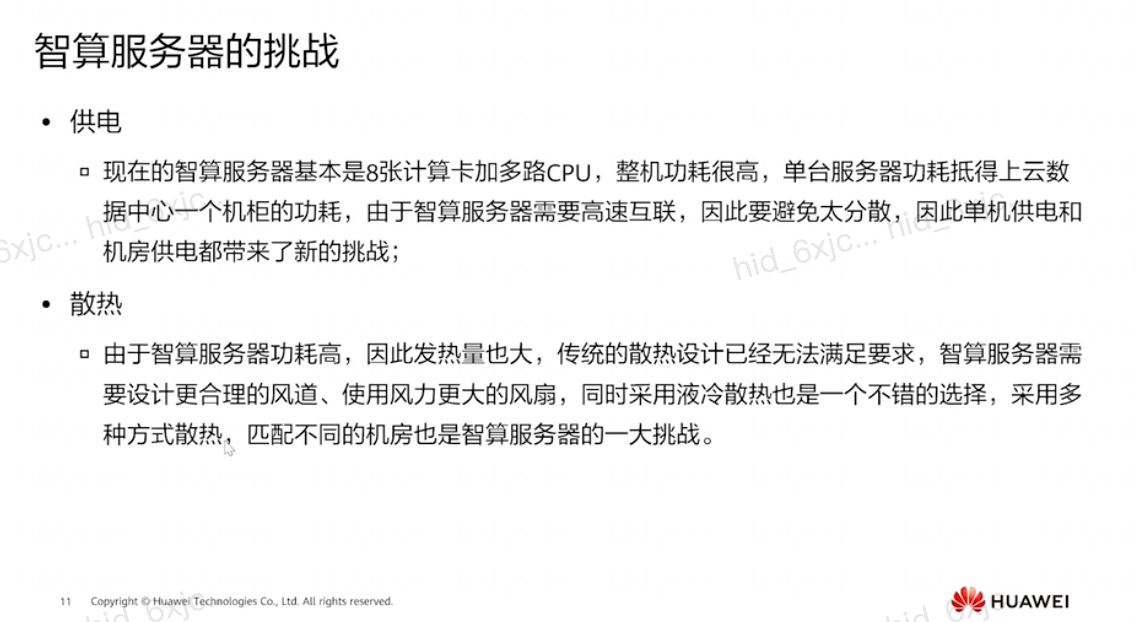
供电问题:智算服务器功耗高,单台抵得上云数据中心一个机柜的功耗,机柜整体功耗提高,供电线路需重新设计改造。
-
散热问题:智算服务器发热量巨大,传统散热设计无法满足要求,通常配备高转速风扇、合理风道,采用液冷散热,如华为RX4 900系列服务器。
-
-
华为智算产品及技术:
-
昇腾产品全家图:基于昇腾NPU推出不同形态产品,覆盖端边缘,用于数据中心的训练硬件是本章重点,模组、开发者套件、标卡等用于端侧应用开发不做重点介绍。
-
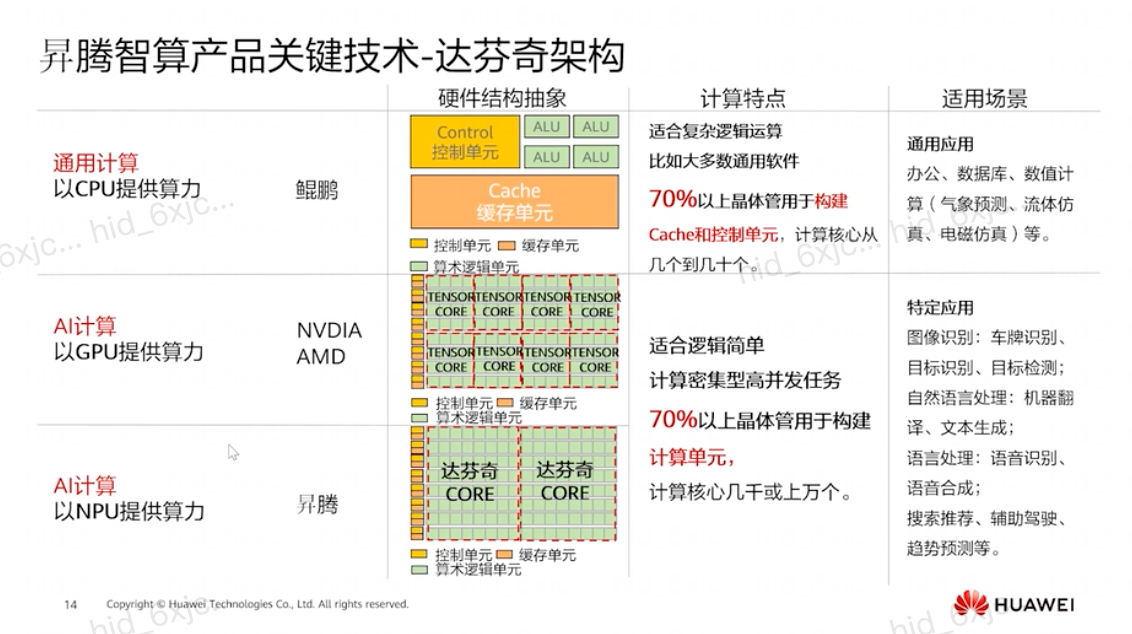
达芬奇架构:华为智算产品采用昇腾服务器,底层使用达芬奇架构,CPU缓存单元大,逻辑计算单元(ALU)所占比例小,不适合AI运算;GPU和NPU的ALU部分面积大,适合AI运算,NPU更专注于AI场景,更适合AI计算。
-
HCCS技术:模型参数量增大,分布式计算需卡与卡大量通信,智算服务器通常用8张计算卡,最新Pcie5.0使用X16通道虽有双向速度,但8张卡会使每张卡分到的通道数量减少,对智算不友好。
-
天成三总线:大规模集群设备连线繁琐,天成三总线通过创新的水电网三总线实现节点全盲插,液冷总线支持柜式CDU和嵌入式ECU,供电总线通过工业连接器或压线连接机房供电侧输出48伏直流给各节点供电,互联总线实现柜内集成高速交换网络,交换机下行到计算节点,免光纤连接,柜内远光模块上行跨柜光互联。
-
智能无损网络:智算场景把多台服务器当成一台来用,需保证服务器之间通信效率,采用无损协议互联保证零丢包高效训练,ROCE协议是业界开源的无损网络协议,使用RDMA技术可提升数据通信效率、减少CPU负载,华为基于ROCE协议打造智能无损网络,实现零丢包,助力AI模型训练与推理。
-
-
智算服务器介绍:
- 阿塔斯800TA2:具有更高的算力密度、极致的能效比和高速网络带宽等特点,服务器最下面有8个网口,对应里面8张计算卡,每张网口速率200G,支持ROCE无损网络。
- 阿塔斯900A2 Pod:采用液冷散热,应用天成三总线技术,水电网三总线融合,具有极致的算力密度、极高的AI能效、极简的交付部署等特点,但对机房地板承重要求高,交付周期相对久,计算密度比风冷服务器高。
-
课程总结:
- 思考题:回顾智算与超算的不同
| 对比维度 | 智算中心 | 超算中心 |
|---|---|---|
| 核心计算架构 | 以GPU、NPU集群为核心,芯片ALU计算单元占比极高,专为AI并行计算设计;集群互联协议少,主流采用开源ROCE协议,跨卡/跨机互联难度更低 | 以CPU为主,搭配少量加速卡;CPU缓存占比大、计算单元ALU面积小,适合高精度数值运算;CPU生态多品牌、多架构、多技术路线并存,集群互联互通难度高 |
| 运算精度与算力侧重点 | 对精度要求偏低,广泛使用FP16、BF16、INT8、FP8低位宽格式;核心追求超高峰值算力、高计算密度,牺牲部分精度换取算力吞吐量 | 追求超高计算精度,标配FP64双精度浮点;对峰值算力要求不高,核心保证数值计算零误差 |
| 集群设计理念 | 核心理念 DC as a computer,把成千上万台服务器虚拟成一台巨型计算机,依靠无损高速网络实现统一并行;适配海量参数、MOE多专家模型的大规模并行需求 | 传统分布式计算,单台服务器独立调度,侧重单机高精度数值求解,无统一集群虚拟化设计 |
| 网络通信要求 | 大参数量模型、多专家并行带来海量跨卡/跨节点数据交互,对带宽要求极高;淘汰普通PCIe通道,采用HCCS、NVLink、天成三总线高速互联,配套ROCE智能无损网络,杜绝丢包重传 | 通信数据量相对可控,对互联带宽要求中等,无强制无损网络要求 |
| 内存/显存需求 | 需要超大高速显存,7B模型FP16精度仅加载参数就需14G显存,叠加中间变量、优化器参数,单任务需数百GB专用高速显存 | 依赖CPU内存,需求规模适中,无超大规模专用显存要求 |
| 供电与散热压力 | 8卡整机功耗极高,单台功耗等同于传统云数据中心整柜;机柜高密度部署,供电线路需重新改造;传统风冷不足以散热,普遍采用高转速风扇、优化风道,高端机型标配液冷 | 单机功耗、机柜密度更低,常规供电线路、风冷散热方案即可满足需求 |
| 核心应用场景 | 大语言模型训练/推理、计算机视觉、自动驾驶、AIGC生成类任务等AI场景,适配海量非结构化数据、深度学习MOE架构模型 | 气象模拟、航空航天仿真、核物理、油气勘探、基础科学数值模拟等,依赖精准数值求解的科学计算场景 |
| 技术演进方向 | 持续往更大参数量、更多专家模块、更低位宽(FP8) 发展,硬件持续提升显存容量、多机互联带宽、大规模跨节点专家并行支撑能力 | 持续强化FP64高精度通用计算能力,优化单机高精度运算效率 |

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 18
 0
- 0


 已为社区贡献6条内容

所有评论(0)