数字人 SDK 如何接入?基于 ZEGO 数字人 API 实现实时互动数字人
数字人 SDK 如何接入?基于 ZEGO 数字人 API 实现实时互动数字人
笔者简介
长期关注实时互动与 AI 数字人领域的技术发展,参与过实时音视频能力接入、互动场景设计及相关产品能力研究。
在实际项目中,持续关注包括腾讯云、即构 ZEGO、声网 Agora 等厂商在数字人、实时互动及 AI 场景方向的产品实践,重点关注数字人生成、实时驱动、音视频流输出及业务场景落地。
本系列文章将围绕 AI 数字人、实时互动及相关能力实现,持续输出接入实践与技术分析。
随着生成式 AI 技术的发展,数字人正逐渐从简单的视频播报工具演变为具备实时互动能力的数字化角色,广泛应用于 AI 陪伴、智能客服、在线教育、企业培训、直播电商、数字员工等场景。相比传统真人出镜或视频制作方式,数字人能够实现更低成本、更高效率的内容生产与互动服务,为企业提供更加灵活的业务解决方案。
对于开发者而言,自研数字人系统通常涉及数字人形象生成、语音驱动、动作驱动、音视频处理及实时流输出等多个技术模块,开发和维护成本较高。通过集成成熟厂商提供的数字人能力,可以快速完成数字人形象创建与实时驱动,大幅降低技术门槛与项目周期。
本文将以 ZEGO 数字人为例,介绍数字人能力的基础接入流程,包括数字人形象定制、数字人管理、实时驱动及音视频流输出等核心能力。开发者可以基于图片数字人或真人数字人快速构建数字人应用,实现实时互动、智能播报、数字人直播等业务场景。
说明:本文基于最新版本的 ZEGO 数字人 API 接入文档整理,对部分接口能力和接入流程进行了更新。
简单总结了即构数字人产品的功能列表,整体接入流程也是非常简单的。
实现数字人 AI 互动对话
前提条件
在开始实现数字人实时播报前,请确保:
-
在 ZEGO 控制台 创建项目,并申请有效的 AppID,详情请参考 控制台 - 项目管理 - 项目信息。
-
已联系 ZEGO 技术支持开通数字人 API 服务和相关接口的权限。
-
已通过 ASR、LLM、TTS 等功能实现音频互动对话业务。
-
客户端已集成 ZEGO Express SDK,详情请参考各端(Web 、Android 、iOS)集成 SDK 文档 。
示例代码
数字人 AI 互动对话示例代码
包含服务端及客户端示例代码。
请参考 跑通示例源码 或者示例代码 README 运行示例代码。
核心架构
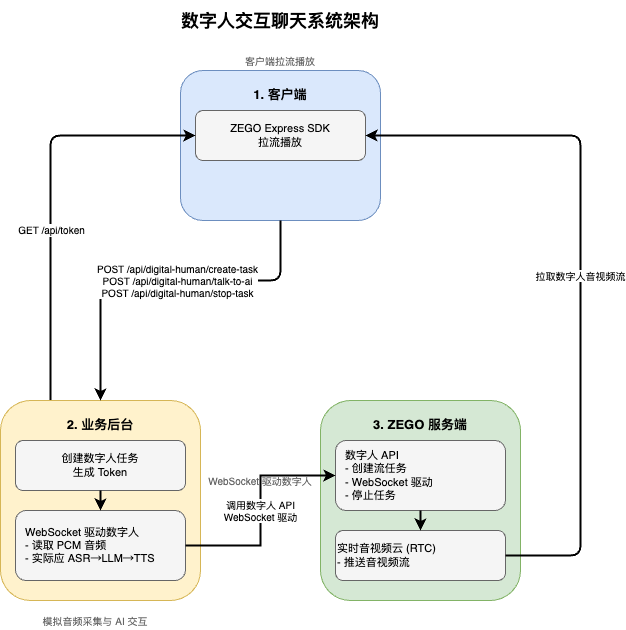
数字人 AI 互动对话系统通常由三个核心角色组成:
客户端(用户终端)
-
功能:使用 ZEGO Express SDK 拉取并播放数字人音视频流,同时采集用户音频发送至业务后台
-
平台:Web / Android / iOS,均使用 Express SDK 拉流播放
业务后台
-
核心职责:接收客户端请求,调用 ZEGO 数字人 API 创建/停止数字人任务
-
AI 交互处理:接收用户音频,经 ASR(语音识别)→ LLM(大语言模型)→ TTS(语音合成)处理后,通过 WebSocket 将 PCM 音频流发送给数字人服务驱动数字人
ZEGO 服务端
-
数字人 API:创建数字人视频流任务、获取 WebSocket 驱动信息、停止数字人视频流任务
-
实时音视频云:数字人音视频流通过 ZEGO 实时音视频云推送,客户端通过 ZEGO Express SDK 拉取
业务流程
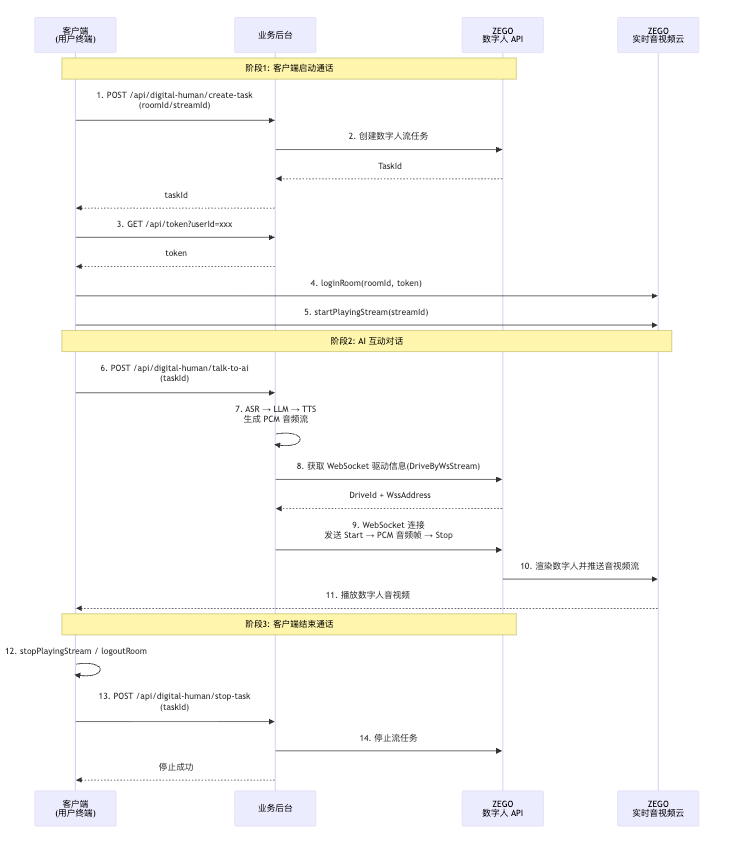
-
客户端启动通话:
-
客户端生成 roomId 和 streamId,向业务后台发起创建数字人任务请求。
-
业务后台调用 ZEGO 数字人 API 创建任务,返回 taskId。
-
客户端获取 Token,登录 RTC 房间并拉取数字人音视频流。
-
-
AI 互动对话:
-
客户端采集用户说话音频,发送至业务后台。
-
业务后台进行 ASR → LLM → TTS 处理,生成 PCM 音频流。
-
业务后台调用数字人 API 获取 WebSocket 驱动信息,建立 WebSocket 连接,将 PCM 音频流转发给数字人服务驱动数字人。
-
-
客户端结束通话:
-
客户端停止拉流、退出房间,并请求业务后台停止数字人任务。
-
业务后台调用数字人 API 停止任务。
-
实现逻辑
实现业务后台
业务后台提供以下接口供客户端调用:
请根据实际业务需求设计业务后台接口,并按照数字人 API 调用方式说明实现必要的业务后台接口。以下是调用数字人 API 的示例代码:
// 创建数字人视频流任务
// Create digital human video stream task
export const createStreamTask = async (params) => {
  const data = await post("CreateDigitalHumanStreamTask", {
    DigitalHumanConfig: { DigitalHumanId: params.digitalHumanId },
    RTCConfig: { RoomId: params.roomId, StreamId: params.streamId },
  });
  return data.TaskId;
};

// 停止数字人视频流任务
// Stop digital human video stream task
export const stopStreamTask = async (params) => {
  await post("StopDigitalHumanStreamTask", { TaskId: params.taskId });
};

// 获取 WebSocket 驱动信息
// Get WebSocket drive info
export const getDriveByWsStreamInfo = async (params) => {
  const data = await post("DriveByWsStream", { TaskId: params.taskId });
  return {
    driveId: data.DriveId,
    wssAddress: data.WssAddress,
  };
};

// 发送 POST 请求到 ZEGO 数字人 API
// Send POST request to ZEGO Digital Human API
const post = async (action, body) => {
  const params = buildCommonParams(action);
  const url = `https://aigc-digitalhuman-api.zegotech.cn/?${params.toString()}`;
  const response = await fetch(url, {
    method: "POST",
    headers: { "Content-Type": "application/json" },
    body: JSON.stringify(body),
  });
  const data = await response.json();
  if (data.Code !== 0) {
    throw new Error(`Digital Human API failed: ${data.Code} ${data.Message}`);
  }
  return data.Data;
};

// 构建通用 API 请求参数(包含签名)
// Build common API request parameters (including signature)
const buildCommonParams = (action) => {
  const appId = process.env.APP_ID;
  const serverSecret = process.env.SERVER_SECRET || "";
  const signatureNonce = crypto.randomBytes(8).toString("hex");
  const timestamp = Math.floor(Date.now() / 1000);
  // 计算 MD5 签名
  // Calculate MD5 signature
  const signature = crypto
    .createHash("md5")
    .update(`${appId}${signatureNonce}${serverSecret}${timestamp}`)
    .digest("hex");

  return new URLSearchParams({
    Action: action,
    AppId: appId.toString(),
    SignatureNonce: signatureNonce,
    Timestamp: timestamp.toString(),
    Signature: signature,
    SignatureVersion: "2.0",
  });
};
通过 WebSocket 音频流驱动数字人
AI 互动对话的核心在于将 TTS 合成的 PCM 音频流通过 WebSocket 发送给数字人服务,驱动数字人说话。流程如下:
-
调用
DriveByWsStream获取 WebSocket 驱动信息(DriveId 和 WssAddress) -
建立 WebSocket 连接
-
发送
Start指令(指定 DriveId 和采样率) -
将 TTS 产生的 PCM 音频数据逐帧发送
-
发送
Stop指令 -
断开 WebSocket 连接
import WebSocket from "ws";

// 通过 WebSocket 驱动数字人
// Drive digital human via WebSocket
export const callTTSAndDriveDigitalHumanByWebSocket = async (taskId) => {
  // 步骤 1: 获取 WebSocket 驱动信息
  const { driveId, wssAddress } = await getDriveByWsStreamInfo({ taskId });

  // 步骤 2: 建立 WebSocket 连接
  const ws = new WebSocket(wssAddress, { rejectUnauthorized: false });
  await new Promise((resolve, reject) => {
    ws.on("open", resolve);
    ws.on("error", reject);
  });

  // 步骤 3: 发送 Start 指令(通常在 TTS 开启前启动)
  ws.send(JSON.stringify({
    Action: "Start",
    Payload: {
      DriveId: driveId,
      SampleRate: 24000, // 采样率需与你实际的音频数据相同
    },
  }));

  // 步骤 4: 将 TTS 产生的 PCM 音频数据逐帧发送
  // 实际业务中,这里应接收 TTS 服务返回的流式 PCM 音频数据并转发:
  // ttsWs.onMessage = (msg) => {
  //   if (msg.type === 'MsgTypeAudioOnlyServer') {
  //     ws.send(msg.payload);  // 将 PCM 音频帧直接转发给数字人
  //   }
  // };

  // 步骤 5: 发送 Stop 指令(通常在 TTS 结束后发送)
  ws.send(JSON.stringify({
    Action: "Stop",
    Payload: { DriveId: driveId },
  }));

  // 步骤 6: 断开连接
  ws.close();
};
实现客户端
客户端使用 ZEGO Express SDK 拉流播放数字人音视频,详情请参考各端(Web 、Android 、iOS)实现视频通话文档。
以下是各端的核心示例代码。详细实现可参考示例代码(Web 、Android 、iOS):
// 步骤1: 初始化 Express SDK
const zg = new ZegoExpressEngine(appId, server);

// 步骤2: 生成唯一标识
const userId = `user_${Date.now()}`;
const roomId = `room_${Date.now()}`;
const streamId = `stream_${Date.now()}`;

// 步骤3: 调用业务后台创建数字人任务
const createRes = await fetch('https://your_server_address/api/digital-human/create-task', {
  method: 'POST',
  headers: { 'Content-Type': 'application/json' },
  body: JSON.stringify({ roomId, streamId }),
});
const { taskId } = await createRes.json();

// 步骤4: 获取 Token
const tokenRes = await fetch(`https://your_server_address/api/token?userId=${userId}`);
const { token } = await tokenRes.json();

// 步骤5: 登录 RTC 房间
await zg.loginRoom(roomId, token, { userID: userId, userName: userId });

// 步骤6: 拉取数字人音视频流
const remoteStream = await zg.startPlayingStream(streamId);
const remoteView = zg.createRemoteStreamView(remoteStream);
remoteView.play('remote-video'); // 渲染到 DOM 元素

// 步骤7: 模拟 AI 互动(实际场景中应采集麦克风音频发送至业务后台)
await fetch('https://your_server_address/api/digital-human/talk-to-ai', {
  method: 'POST',
  headers: { 'Content-Type': 'application/json' },
  body: JSON.stringify({ taskId }),
});

// 步骤8: 结束通话
await zg.stopPlayingStream(streamId);
await zg.logoutRoom();
await fetch('https://your_server_address/api/digital-human/stop-task', {
  method: 'POST',
  headers: { 'Content-Type': 'application/json' },
  body: JSON.stringify({ taskId }),
});
结语
至此,我们已经完成了 ZEGO 数字人 API 的基础接入。通过集成数字人能力,开发者可以在无需自研数字人生成、驱动与渲染系统的情况下,快速完成数字人形象创建、任务驱动及实时音视频流输出等核心功能搭建。
这一实现路径覆盖了数字人应用的基础能力,可满足智能客服、AI 教师、情感陪伴、数字员工、直播互动等典型场景需求。在此基础上,你还可以进一步结合大语言模型(LLM)、语音识别(ASR)、语音合成(TTS)等 AI 能力,构建具备实时互动、内容播报和智能问答能力的数字人应用。
围绕数字人与实时互动技术,我们还将持续整理更多细分场景与实现方案,包括但不限于:
-
图片数字人与真人数字人的训练流程与最佳实践
-
数字人 AI 互动对话方案实现
-
数字人直播与内容播报场景搭建
-
RTC + 数字人实时互动方案实践
-
数字人常见问题与性能优化指南
本系列将围绕「AI 数字人接入与实时互动能力实现」持续更新,帮助开发者快速完成数字人应用落地。
常见问题
实现 AI 数字人互动对话需要哪些核心组件?
一个完整的 AI 数字人互动对话系统通常由客户端、业务后台和数字人服务三部分组成。客户端负责播放数字人音视频流和采集用户语音;业务后台负责完成 ASR(语音识别)、LLM(大语言模型)和 TTS(语音合成)处理;数字人服务则负责接收音频驱动并生成对应的数字人音视频流。
数字人为什么需要结合 ASR、LLM 和 TTS?
数字人本身主要负责形象驱动和音视频输出,并不直接具备语音理解和内容生成能力。实际应用中通常需要通过 ASR 将用户语音转换为文本,由 LLM 生成回复内容,再通过 TTS 合成为语音,最后驱动数字人完成实时互动。
数字人支持哪些驱动方式?
ZEGO 数字人支持文本、音频以及实时音视频流等多种驱动方式。在 AI 对话场景中,最常见的是通过 WebSocket 持续发送 TTS 生成的 PCM 音频流,实现数字人实时说话和表情驱动。
数字人实时互动场景的整体流程是什么?
典型流程包括:客户端发起数字人任务创建请求 → 业务后台调用数字人 API 创建任务 → 客户端登录 RTC 房间并拉流播放 → 用户语音经过 ASR、LLM、TTS 处理 → TTS 音频通过 WebSocket 驱动数字人 → 客户端实时观看数字人互动效果。
数字人实时音视频流是如何播放到客户端的?
数字人生成的音视频流会通过 ZEGO 实时音视频云进行分发。客户端只需要集成 ZEGO Express SDK,登录对应 RTC 房间后即可拉取并播放数字人音视频流,无需自行处理复杂的音视频传输链路。
数字人适合哪些业务场景?
数字人适用于 AI 教师、智能客服、情感陪伴、数字员工、在线咨询、直播互动等场景。相比传统文字或语音助手,数字人能够通过形象、表情和动作增强互动体验,为用户提供更具沉浸感的 AI 交互方式。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 5
 0
- 0


 已为社区贡献1条内容

所有评论(0)