知识图谱(实体消歧实现)【第十四章】
·
一、实体消歧思路
如何将每个样本中待消歧实体类型标记出来:
遍历每个句子:需要消歧的句有多个,需要对每个句进处理,所以需要遍历:遍历句子中的每一个实体:在一个句中,可能存在多个需要消歧的实体,需要进遍历:
遍历一个句子中出现多次的实体:一个句子中,同一个需要消歧的实体可能出现多次,需要进行遍历:1)获取该实体在句子中的位置
2)获取该实体的上下文,用于生成的TF-IDF的向量
3)基于上下文生成的TF-IDF的向量与样本库中的向量计算余弦相似度,获取该实体的类型
4)进行结果字符串拼接
①对该实体的上下文进行分词
②将分词结果送到模型中生成TF-IDF的向量
③计算基于上下文生成的TF-IDF向量和样本库中向量的余弦相似度④获取余弦相似度最大的实体类型作为实体的类型
这里使用华盛顿实体为例
先找到华盛顿实体的位置,然后把实体的最相关上下文使用tf-idf转化为向量(这里不转换整个句子,是因为一个实体可能会出现多次)(最相关上下文这个项目里面的原理是:如果这个实体的索引小于10,取前20个字符作为最相关上下文;如果索引大于len-9,那么取最后20个字符作为最相关上下文)。得到上下文序列以后先使用jieba分词对序列进行分词,然后使用tf-idf对序列进行向量化,最后和标准库中的实体类型进行相似度计算;
然后使用转换好的向量和样本库中的向量计算余弦相似度,获得该实体的类型;

然后把最后的结果进行一个字符串的拼接;
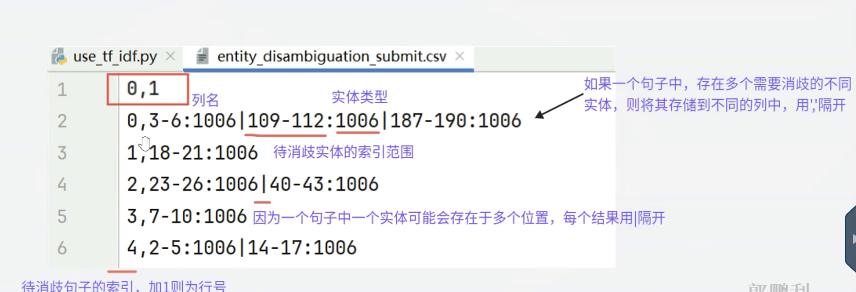
拼接结果如图所示:
第一列是待审查序列索引、后面是实体位置索引+实体类型(一个序列中可能存在多个实体)
P05_DF/entity_disambiguation/use_tf_idf.py
from collections import Counter
import numpy as np
import pandas as pd
import jieba
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.metrics.pairwise import cosine_similarity

# 1.读取数据:首先读取包含实体列表的entity_list.csv和包含待处理句子的valid_data.csv。
# 样本库中的数据
entity_data = pd.read_csv('data/entity_list.csv', encoding='utf-8')
print(f'entity_data-->{entity_data.head()}')
# 待消歧数据
valid_data = pd.read_csv('data/valid_data.csv', encoding='gbk')
print(f'valid_data-->{valid_data.head()}')

# 2.处理实体名称:将entity_list.csv中的实体名称添加到分词词典中,确保可以在后续分词和匹配过程中识别这些实体。
# 2.1 获取所有的实体名称
total_entity = ''
for entity in entity_data['entity_name']:
    total_entity += entity + '|'
# print(f'total_entity-->{total_entity}')
# 2.2 将实体名称添加到分词词典中,防止这些实体在分词时被分开
for word in total_entity[:-1].split('|'):
    jieba.add_word(word)
# 2.3 需要统计每个实体出现的次数,对于出现次数大于1次的实体就是需要消歧的实体,我们把它存到一个列表中
keyword_list = []  # 用来存储待消歧的实体
# print(Counter(total_entity[:-1].split('|')).items())
for k, v in Counter(total_entity[:-1].split('|')).items():
    if v > 1:
        keyword_list.append(k)
print(f'keyword_list-->{keyword_list}')

# 3.计算TF-IDF特征矩阵:将每个实体的描述通过分词处理后生成TF-IDF特征矩阵,用于后续的相似度计算。
# 3.1 将每个实体的描述通过分词处理,将分词结果保存到一个列表中,后续将这个列表作为TF-IDF模型训练的输入数据
train_sentences = []
for desc in entity_data['desc']:
    # 需要将分词后的结果用空格连接起来,原因就是在 TF-IDF对象中,默认使用的空格进行分词
    train_sentences.append(' '.join(jieba.lcut(desc)))
# print(f'train_sentences-->{train_sentences}')
# 3.2 创建TF-IDF模型,并训练模型
tfidf = TfidfVectorizer()
x = tfidf.fit_transform(train_sentences)  # 将数据送入模型进行训练,并且获取TF-IDF特征矩阵
# print(f'x-->{x}')  # 稀疏矩阵
print(f'x.shape-->{x.shape}')

def get_entityid(neighbor_sentence):
    id_start = 1001  # 假设实体ID从1001开始
    # ①对该实体的上下文进行分词
    cut_result = [' '.join(jieba.lcut(neighbor_sentence))]
    # print(f'cut_result-->{cut_result}')
    # ②将分词结果送到模型中生成TF-IDF的向量
    vec = tfidf.transform(cut_result)
    # print(f'vec-->{vec}')
    # ③计算基于上下文生成的TF-IDF向量和样本库中向量的余弦相似度
    sim = cosine_similarity(vec, x)[0]
    # print(f'sim-->{sim}')
    # ④获取余弦相似度最大的实体类型作为实体的类型
    # 使用argsort()方法,获取相似度最大的索引
    # print(f'np.argsort()-->{np.argsort(sim)}')
    top_index = np.argsort(sim)[-1]

    return id_start + top_index

# 4.匹配句子中的实体:在valid_data.csv中的句子中找到关键词,并通过TF-IDF相似度计算找到与关键词匹配的实体ID。
# 第一次循环:需要消歧的句子有多个,需要对每个句子进行处理,所以需要遍历
final_result = []
for index, row in enumerate(valid_data['sentence']):
    # print(f'row-->{row}')
    # 第二次循环: 在一个句子中,可能存在多个需要消歧的实体,需要进行遍历
    row_result = [index]  # 默认有一个index,用于存储句子的索引
    for keyword in keyword_list:
        keyword_len = len(keyword)  # 待消歧实体的长度
        if keyword not in row:
            continue
        # 第三次循环:一个句子中,同一个需要消歧的实体可能出现多次,需要进行遍历
        keyword_range_type = ''
        for i in range(len(row) - keyword_len + 1):
            if keyword == row[i:i + keyword_len]:  # 通过字符串匹配的方式,找到待消歧实体的位置
                # print(f'keyword-->{keyword}')
                # print(f'i-->{i}')
                # 1)获取该实体在句子中的位置
                entity_range = str(i) + '-' + str(i + keyword_len) + ':'
                # 2)获取该实体的上下文,用于生成的TF-IDF的向量
                neighbor_sentence = ''
                if i > 10 and i + keyword_len < len(row) - 9:
                    neighbor_sentence = row[i - 10:i + keyword_len + 9]
                elif i < 10:
                    neighbor_sentence = row[:20]
                elif i + keyword_len > len(row) - 9:
                    neighbor_sentence = row[-20:]
                # 3)基于上下文生成的TF-IDF的向量与样本库中的向量计算余弦相似度,获取该实体的类型
                entity_type = get_entityid(neighbor_sentence)
                entity_range += str(entity_type)
                # print(f'entity_range-->{entity_range}')
                # 4)进行结果字符串拼接
                keyword_range_type += entity_range + '|'
                # break
        # print(f'keyword_range_type-->{keyword_range_type}')
        row_result.append(keyword_range_type[:-1])
    # print(f'row_result-->{row_result}')
    final_result.append(row_result)
    # break
# print(f'final_result-->{final_result}')

# 5.输出结果:将句子中匹配到的实体及其位置与对应的实体ID存储为新的CSV文件。
pd.DataFrame(final_result).to_csv('data/result.csv', index=False, header=True)

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 11
 0
- 0


 已为社区贡献6条内容

所有评论(0)