RAG系列:主流向量数据库选型与对比
如何从众多的数据库中选型,是构建云效智能问题分析知识库的关键一步。本文将深入对比目前主流的几款产品,为架构决策提供依据。
1. 为什么不能直接用传统数据库?
很多开发者会问:我用 MySQL 或者 Redis 不能存向量吗?把它当成一个 JSON 或者数组不就行了?
可以存,但没法“搜”!
传统关系型数据库(如 MySQL)主要用于精确匹配(如 WHERE id = 1)或范围查找(如 price > 10),它们的底层索引结构是 B+ 树或 Hash。 而向量数据库的核心挑战是相似性搜索(Similarity Search)。给定一个有 1536 维度的“问题向量”,要在百万级的“知识向量库”里找出最相近的 Top 5,这不是判断相等,而是计算空间距离(如余弦相似度)。
如果在传统数据库里强行算距离,只能做全表扫描(KNN),计算量是灾难性的:1536 次乘法 × 一百万条记录。
真正的向量数据库内置了 ANN(近似最近邻)算法(如 HNSW, IVFFlat)。通过构建复杂的图结构或聚类索引,能将检索时间从几分钟缩短到几毫秒(并且通常牺牲了极少量的精确度换取极高的速度)。
2. 向量数据库的主流阵营划分
目前的向量数据库主要分为两大类:原生向量数据库 和 扩展型向量数据库。
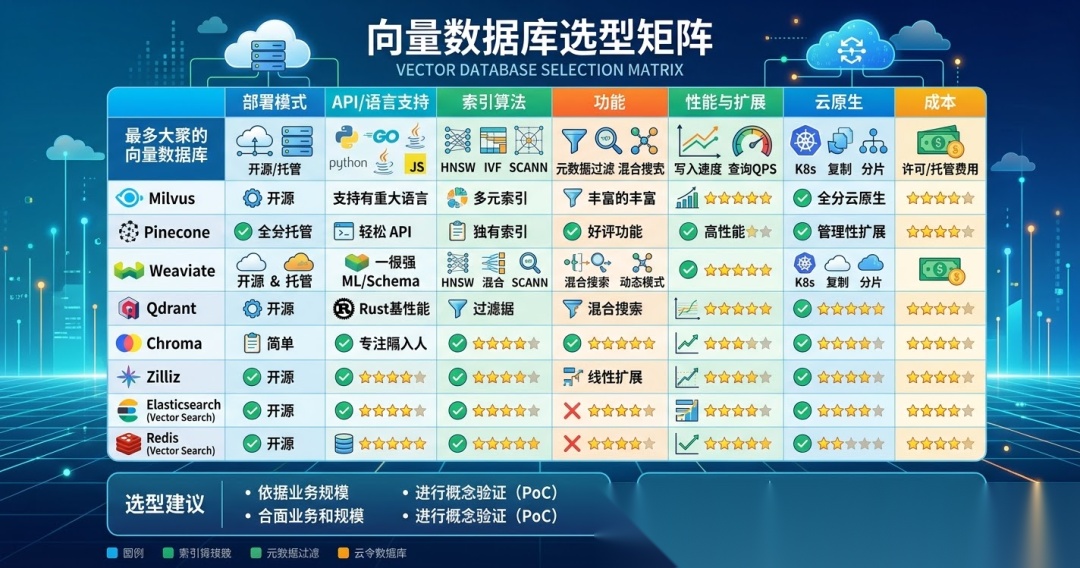
2.1 原生专用型(Purpose-Built Vector DB)
为高并发、大规模向量检索而生,底层架构专门为 ANN 算法优化。 代表产品:
- Milvus:开源领域的标杆,云原生架构。支持极大规模(十亿级向量)的存储和检索。
- Qdrant:基于 Rust 编写,资源消耗低,性能极高。API 友好,支持复杂的 Payload(元数据)过滤。
- Chroma:为 AI 应用(特别是 LangChain / LlamaIndex 生态)量身定制的轻量级数据库。非常适合本地开发和小型系统。
- Weaviate:功能丰富,内置很多预处理模块。
2.2 扩展插件型(Extended Vector DB)
在成熟的传统数据库或搜索引擎上,以插件形式扩展向量检索能力。 代表产品:
- **pgvector (PostgreSQL)**:在 PG 中增加
vector类型和对应的 HNSW / IVFFlat 索引。 - **Elasticsearch (Dense Vector)**:在 ES 中支持稠密向量字段检索。适合原本就在使用 ES 做全文搜索的团队,原生支持混合检索。
- **Redis (RediSearch)**:在内存数据库中进行高速向量运算。
3. 核心选型对比
下面以我们云效智能问题分析 Agent 的场景为准绳,对几款热门库进行对比:
| 维度 | Milvus | Qdrant | Chroma | pgvector (PostgreSQL) | Elasticsearch |
|---|---|---|---|---|---|
| 开发语言 | Go, C++ | Rust | Python, TypeScript | C, SQL | Java |
| 部署架构 | 复杂微服务 (也可本地 Standalone) | 轻量,单节点或集群 | 极轻量,嵌入式/单节点 | 关系型数据库插件 | 重型搜索集群 |
| 数据量级支持 | 百亿级(非常适合大型企业) | 亿级 | 百万级(单机为主) | 千万级 | 亿级 |
| 混合检索支持 | 支持 | 支持 | 较弱 | 可结合 PG 全文检索 | 极强 (BM25 + 向量) |
| 元数据过滤 | 强 | 极强 (灵活的 JSON payload) | 基础 | 强 (SQL 关系查询) | 极强 |
| 学习部署成本 | 高 (依赖 etcd, minio 等) | 中 (单 Docker 即可) | 极低 (直接 pip install) | 中 (需熟悉 PG 生态) | 高 (需运维 ES 集群) |
- 针对我们场景(云效问题分析)的选型建议
我们的需求特征:
- 数据规模:每天几十到几百个工单,全量大概百万级。规模不算极大。
- 元数据过滤需求高:需要根据工单创建者、项目 ID、工单状态(已解决/待处理)进行前置/后置过滤。
- 混合检索需求:除了语义向量外,很多问题排查极度依赖关键字(如特定的错误码、流水线名字),单纯的向量检索有时会遗漏。
结论与推荐
- **如果团队已有 PostgreSQL / Elasticsearch 基础设施:**强烈推荐直接使用 pgvector 或 Elasticsearch Dense Vector。无需引入新的运维组件,且能通过成熟的 SQL/ES DSL 完美处理复杂的元数据过滤,并且 ES 在混合检索上有着无可比拟的优势。
- **如果希望搭建独立的、高性能轻量级 RAG 系统:**推荐使用 Qdrant。它的资源占用远小于 Milvus,通过单个 Docker 镜像即可跑满性能,并且对 Payload 过滤的支持非常灵活,与 LangChain 等框架的集成极其丝滑。
- **如果是刚开始做本地原型开发验证(PoC):**闭眼选 Chroma 或者使用 FAISS(本地库)。它们无需额外部署服务端,通过纯代码(in-memory 或本地 SQLite)就能打通端到端的流程,之后可以零成本切换到 Qdrant 等生产级数据库。
在接下来的 RAG系列(三):从零搭建企业级RAG系统实战 中,我们将会选用轻量且强大的 Qdrant(或本地 Chroma),带大家实战搭建整个流程。
学AI大模型的正确顺序,千万不要搞错了
🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!
有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!
就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋
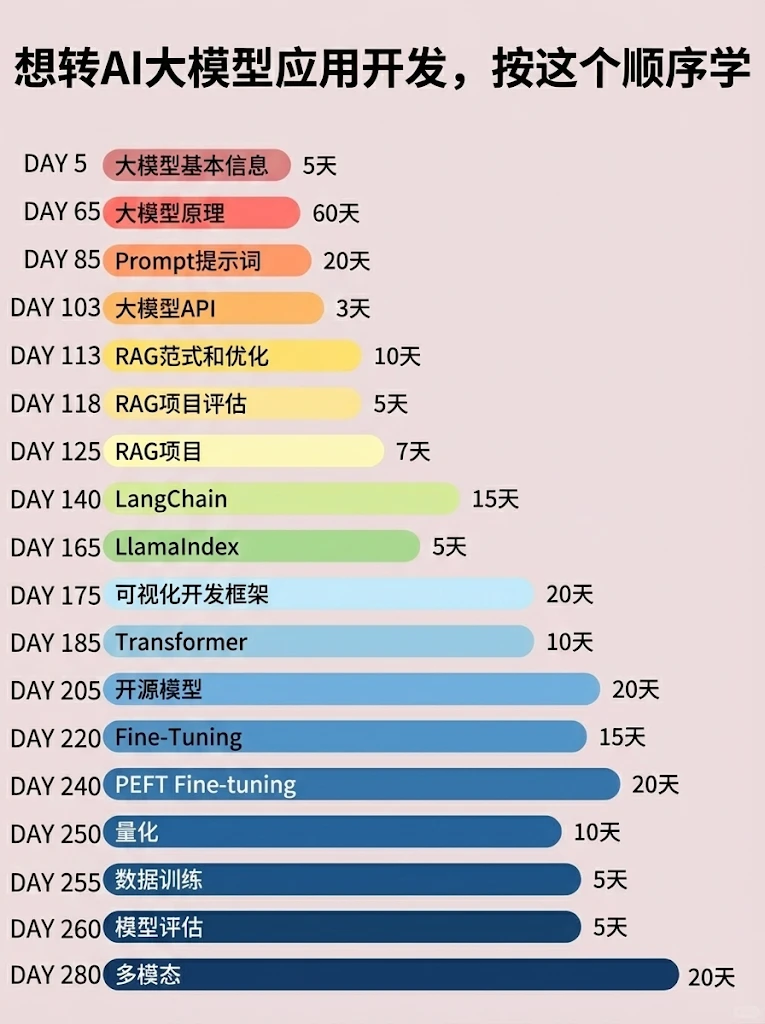
📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇
学习路线:
✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经
以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!
我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】


北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 11
 0
- 0


 已为社区贡献47条内容

所有评论(0)