与毫秒级响应实时数字人对话是种什么体验
我们的Pioneerx Human实时数字人系统整体响应最低可到0.5-0.7毫秒,以上参数使用2080ti显卡做为参考。只要稍微再提升一点硬件算力,这个值可轻松突破0.5秒以内。
之所以有如此之快的响应速度,不仅得益于我们开发团队长期的优化底层算法和长期技术积累,在实时数字人领域不断攻克一个个技术难关。
和其它实时数字人有很大不一样的地方是,我们的数字人系统全流程采用本地化模块,包括llm大模型,asr语音识别模型,Nlp自然语义引擎、向量模型和tts声音克隆,口型引擎等等,为数字人运行节省大量token费用提供条件。
这些关键服务部署在本地化的好处非常明显,就是可以就数字人对话开始的那一刻进行逐步逐行代码优化,最大程度降低数字人各个协同流程的响应延迟。
就为了检测那300毫秒200毫秒甚至100毫秒我们都要不断尝试探索挖掘提升程序改进算法的最大潜力。为了提升速度,我们不断更换算法,不断提升cpu和gpu的工作效率,大大降低程序的阻塞运行时间,最大程度地压榨硬件算力,降低了实时数字人对硬件算力的门槛。
现在的实时数字人系统也不需要昂贵的硬件才能跑起来大约需要13Gb显存。cpu和gpu,内存这些整套硬件大约5000元就足够了。一般8核cpu (amd 3700x或intel 10代cpu)和2080ti,4060这些入门配置就可以跑的很流畅了,支持内网和外网部署,集成知识库系统。
为了不断降低数字人的运行门槛和提高数字人的聪明程度,我们也集成通义千问系列大模型,kimi,deepseek这些常见的语言大模型。这样,可以降低数字人至少5-6GB显存,把用户的显卡门槛降低一大截,使得数字人可以服务更多玩家和企业用户。
很多消费级显卡包括1080ti,3060这些显卡将同样胜任。数字人的tts和asr和口型引擎对gpu要求都不高,能达到1080ti这以上的显卡就基本很流畅了。
整个数字人不仅在响应速度领先同类产品,在使用门槛上大大降低,其对话稳定性连续性也非常出色。我们的实时数字人和其它数字人产品不一样的地方是,不仅可以快速部署到大屏幕,移动端,网页端,微信端等。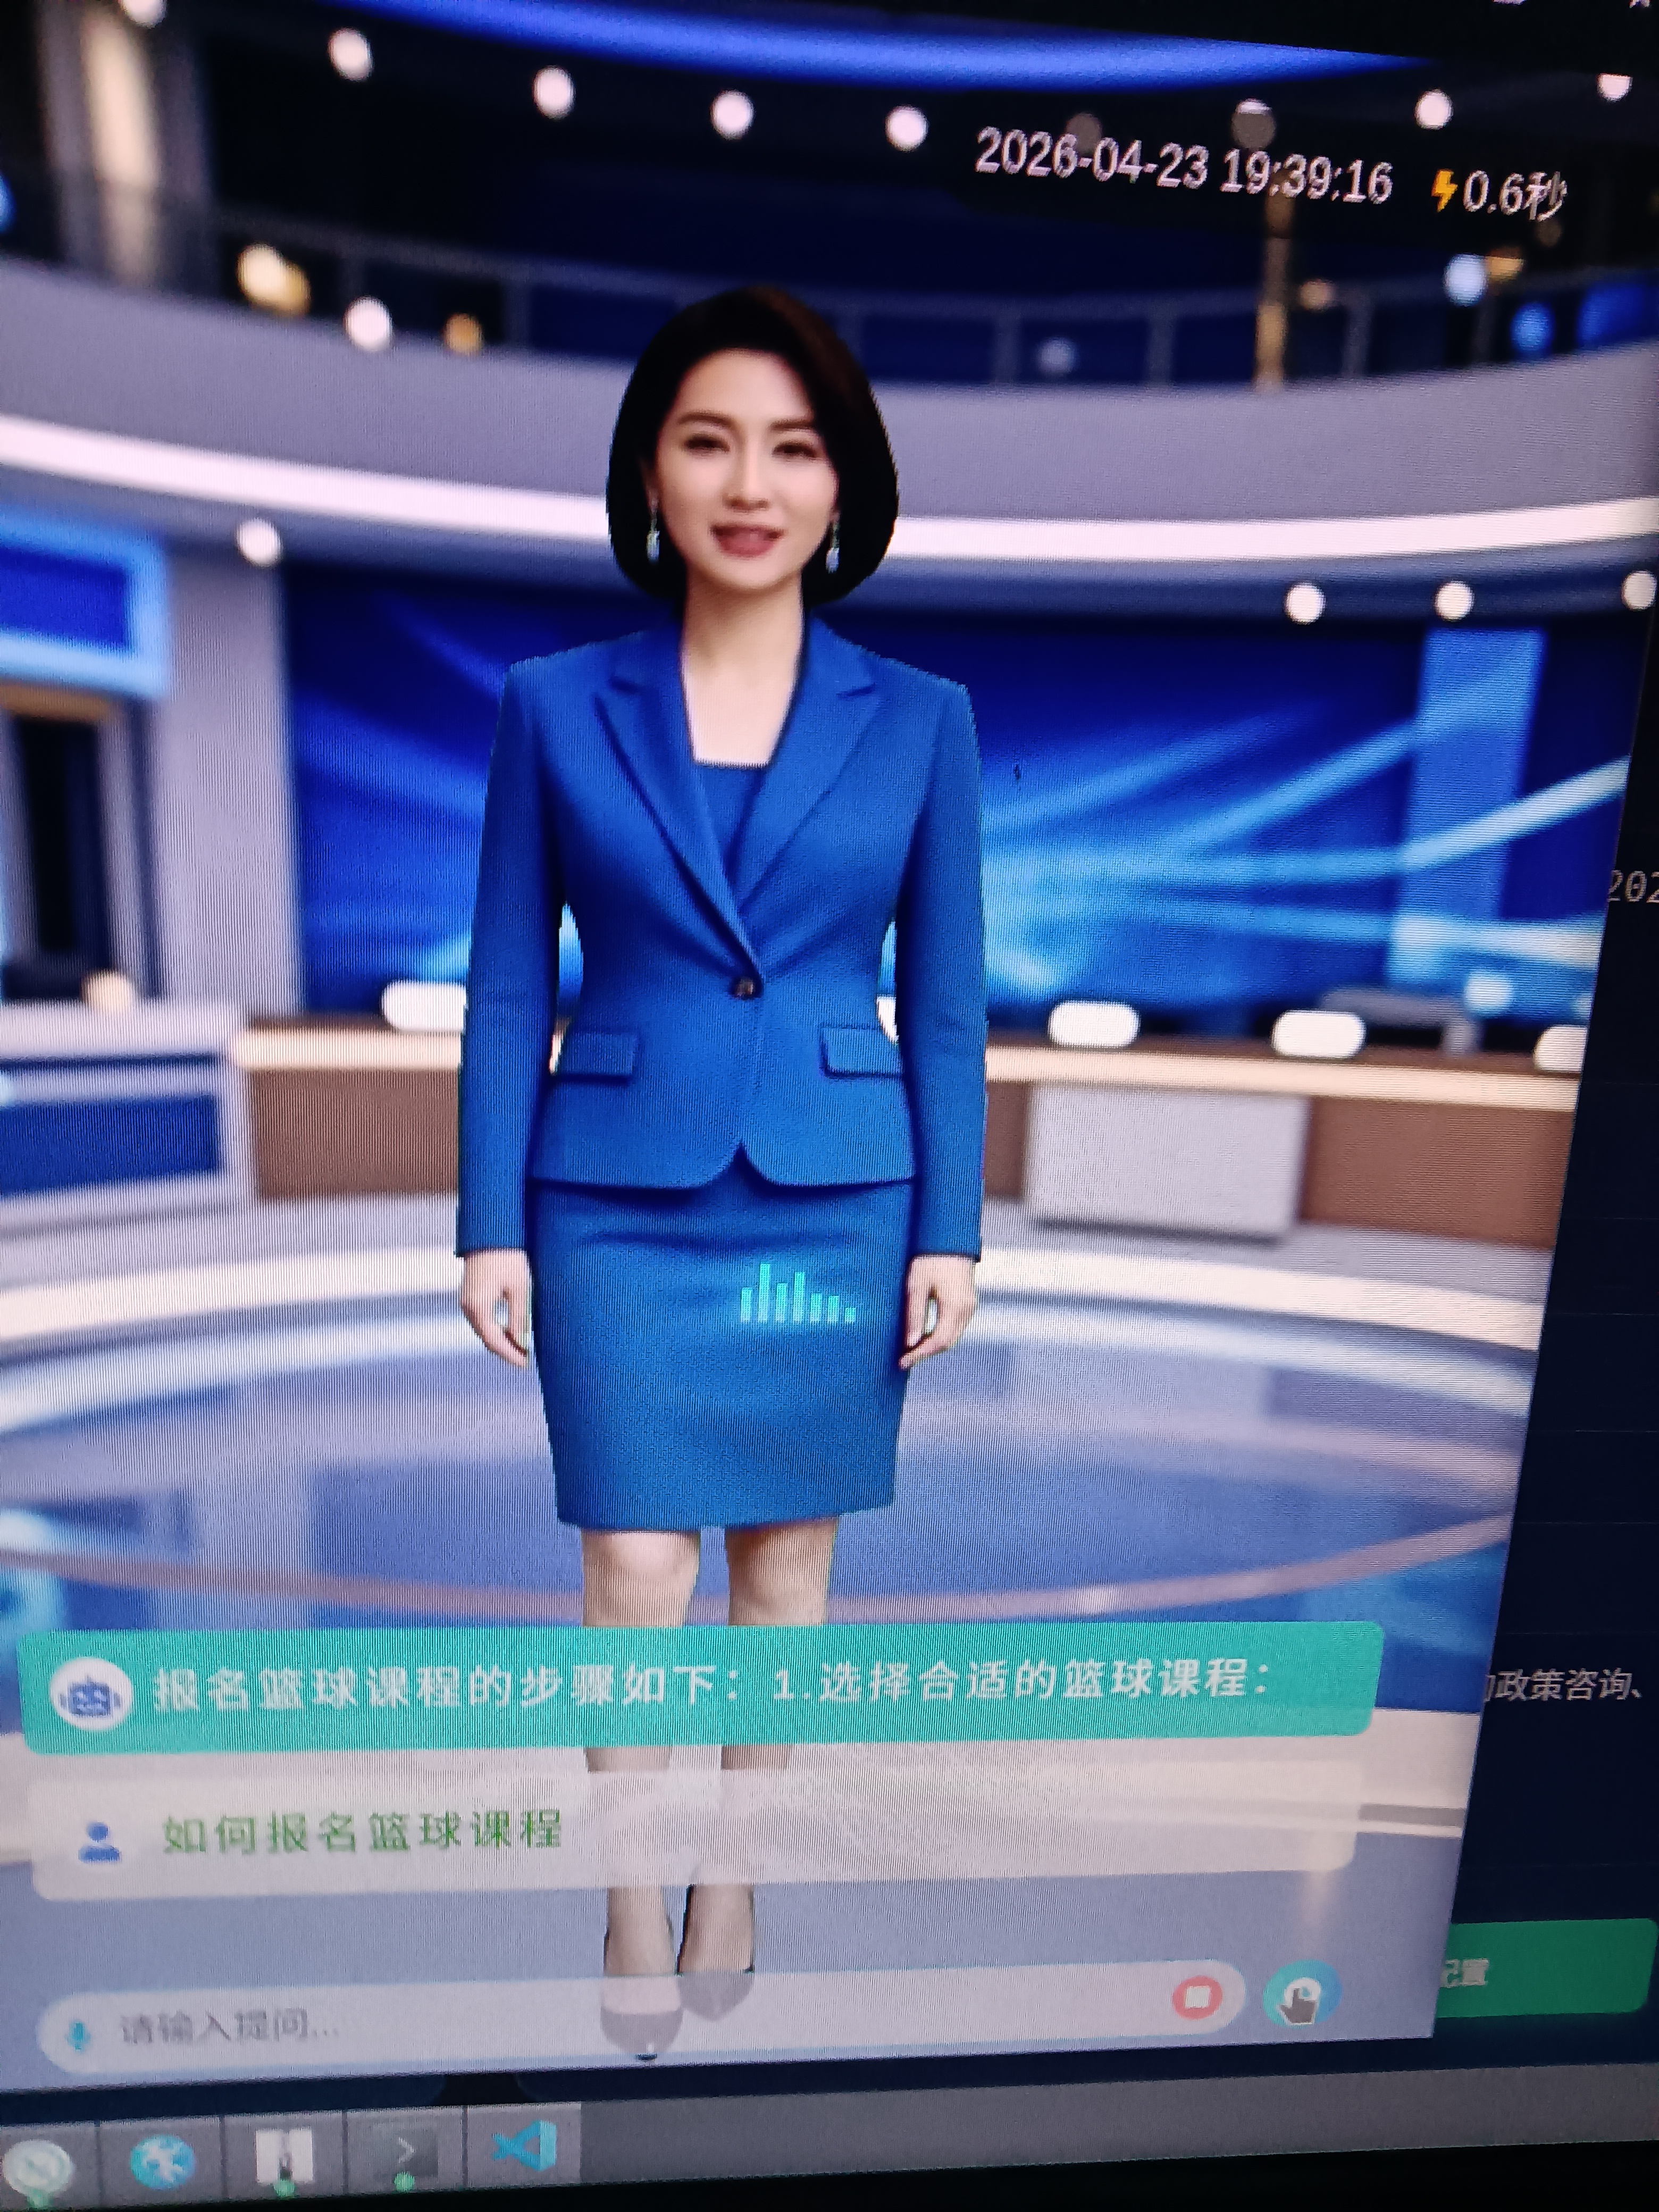

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献8条内容

所有评论(0)