知识图谱 05:从构建框架到实现路径
在知识图谱构建中,首先要解决的往往不是“选哪种数据库”或“使用哪种查询语言”,而是一个更基础的问题:图谱应当从哪里开始构建。围绕这一问题,知识图谱形成了两条经典路径:自顶向下构建与自底向上构建。在真实系统中,这两条路径又常常结合为混合构建。
从本质上看,构建路径所回答的是:知识图谱应当先从知识结构出发,还是先从原始数据出发;是先设计语义框架,再填充事实,还是先从数据中抽取事实,再逐步整理结构。
一、知识图谱的一般构建框架
从整体流程看,知识图谱构建通常包括四个彼此衔接的阶段:信息抽取、知识融合、知识加工、维护与更新。它们共同构成了知识图谱的一般构建框架。
下面给出知识图谱的一般构建框架图示:
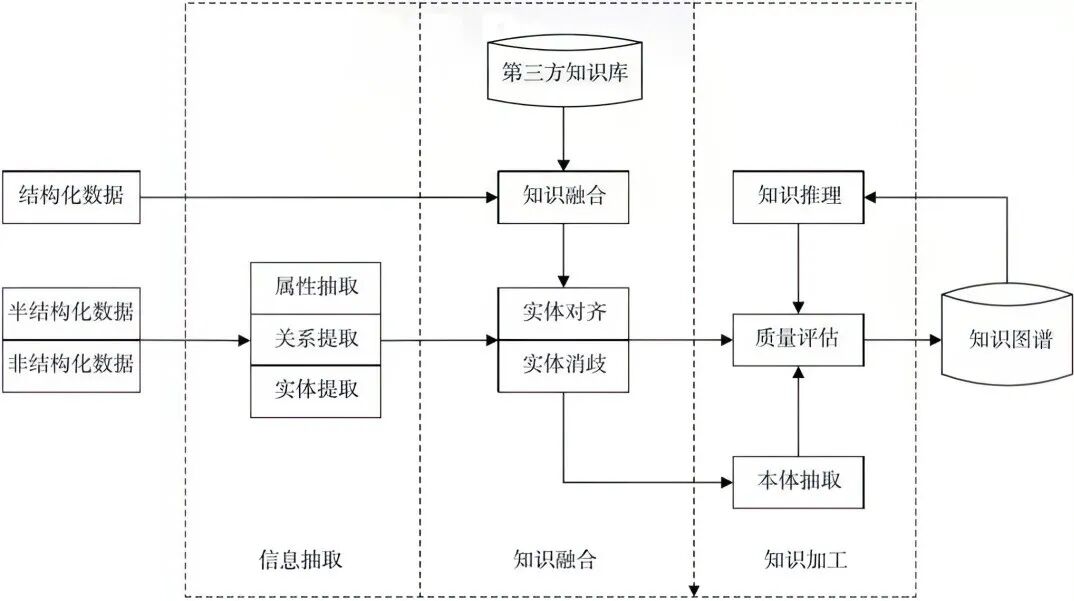
这一框架既说明了知识图谱“从哪里获得知识”,也说明了这些知识“怎样被整理、加工并持续维护”。
从图示可以看出,知识来源通常包括三类:
• 结构化数据
• 半结构化数据
• 非结构化数据
其中,半结构化数据和非结构化数据通常需要先经过信息抽取,才能转化为可处理的知识单元。
1、信息抽取:从原始数据中获得知识单元
信息抽取的典型任务包括:
• 实体抽取
• 关系抽取
• 属性抽取
它的作用,是把原始数据中的对象、联系和属性识别出来,转化为图谱可以接收的结构化表达。
但抽取得到的结果往往还存在重复、冲突或歧义,因此还需要进入知识融合阶段。
延伸阅读:
2、知识融合:把多源描述整理为统一知识对象
知识融合的主要任务包括:
• 实体对齐
• 实体消歧
• 多源知识整合
在这一过程中,第三方知识库也常常参与进来,为已有知识提供补充、参照或校验。
知识融合的目标,不是简单把数据放在一起,而是把关于同一实体或概念的多源描述统一起来,形成较一致、较完整的知识对象。
延伸阅读:
3、知识加工:把事实表达提升为可用知识体系
在知识融合之后,系统还需要进一步进行知识加工,主要包括:
• 本体构建
• 质量评估
• 知识推理
其中,本体构建有助于形成较稳定的概念结构与关系模式;质量评估用于检查图谱的一致性、完整性与准确性;知识推理则用于在已有知识基础上发现新的隐含知识。
延伸阅读:
4、维护与更新:让知识图谱持续演化
知识图谱并不是一次性构建完成后就不再变化的静态系统。随着新数据持续进入、旧知识不断修正、应用需求逐步扩大,图谱还需要长期维护与更新。
这一阶段既包括实体、关系和属性的更新,也包括数据质量管理、本体演化以及跨源一致性维护。
延伸阅读:
因此,知识图谱构建并不是一条简单的单向流水线,而是一个包含抽取、融合、加工、更新、评估和反馈的持续过程。
二、自顶向下构建:先有本体与模式
自顶向下构建(Top-Down Construction),是指先从领域分析和概念建模入手,设计知识图谱的本体和模式,再在既定结构下逐步补充实例与事实。
这一路径的核心是:
(1)明确领域范围;
(2)确定类、属性、关系及其层级结构;
(3)建立概念之间的语义约束;
(4)在既定模式下填充实例与事实。
它的关键在于本体构建。本体构建不是简单列出若干概念名称,而是系统地规定一个领域中的概念、属性、关系及其组织方式。
这种方式的优势在于:
• 结构清楚
• 概念边界明确
• 语义一致性较强
• 便于后续进行规则约束和知识复用
但它也有局限:
• 前期建模成本较高
• 对领域知识要求较高
• 扩展性可能受限
• 对开放领域和海量异构数据的适应性相对较弱
因此,自顶向下构建更适合领域边界清楚、概念体系较稳定、知识质量要求较高的场景。
三、自底向上构建:先从数据中抽取事实
自底向上构建(Bottom-Up Construction),是指从已有数据资源出发,利用知识抽取、实体识别、关系抽取、融合与清洗等技术,从数据中逐步获得实体、关系、属性和事件,并将这些事实组织为知识图谱。
这一路径的核心是:
(1)获取原始数据;
(2)从多类数据中抽取知识要素;
(3)对抽取结果进行筛选、消歧、对齐与融合;
(4)在此基础上逐步形成图谱。
其中,信息抽取是自底向上路径的核心。它不是简单收集数据,而是把原始数据转化为可表示、可关联、可计算的结构化事实。
这种方式的优势在于:
• 更适合海量数据环境
• 更容易快速扩充知识规模
• 更贴近真实数据生态
• 更适合持续迭代和动态更新
但它也有局限:
• 抽取结果可能含有噪声
• 同名异义、异名同义问题更突出
• 结构一致性通常不如自顶向下稳定
• 后续融合和质量治理成本较高
因此,自底向上构建更适合数据来源丰富、知识覆盖要求较大、需要持续扩展和动态更新的场景。
四、为什么真实系统往往采用混合构建
在真实系统中,很少只坚持自顶向下或自底向上中的一种。原因在于:
(1)只依赖自顶向下,结构虽然清楚,但数据扩展速度往往有限;
(2)只依赖自底向上,规模虽然容易扩大,但结构一致性和语义质量又不容易稳定控制。
因此,很多知识图谱系统会采用混合构建(Hybrid Construction)的思路:先建立一个基本的本体或模式框架,再从多源数据中持续抽取事实,并把抽取结果映射回既定结构之中。这样,图谱既有相对稳定的语义骨架,又具备持续吸纳新知识的能力。
如果用一句话概括三者之间的区别:
• 自顶向下强调先搭建骨架
• 自底向上强调先补充内容
• 混合构建强调骨架与内容的同步演化
从工程实践看,混合构建通常最接近真实做法。
五、怎样理解“构建框架”与“实现路径”的关系
在知识图谱中,“构建框架”和“实现路径”并不是同一个问题。
(1)构建框架回答的是:知识图谱一般要经历哪些阶段;
(2)实现路径回答的是:这些阶段应当从哪里起步、以什么方式组织。
也就是说,信息抽取、知识融合、知识加工、维护与更新,构成的是知识图谱构建的一般框架;而自顶向下、自底向上与混合构建,描述的是进入这一框架的不同方式。
从这个角度看,构建框架更像“全流程视图”,实现路径更像“起步策略与组织方式”。二者结合起来,才能较完整地理解知识图谱是怎样建成的。
六、三类构建路径的适用场景
三类路径各有适用范围,并不存在绝对优劣。
1、自顶向下
更适合以下场景:
• 领域边界清楚
• 本体要求明确
• 一致性要求较高
• 需要较强语义约束和推理能力
2、自底向上
更适合以下场景:
• 数据来源丰富
• 知识覆盖范围要求较大
• 需要快速扩展事实规模
• 面向开放领域或互联网数据环境
3、混合构建
更适合以下场景:
• 既希望结构稳定,又希望规模增长
• 既重视模式设计,又依赖持续抽取
• 需要长期维护和持续演化
• 面向真实业务系统与复杂应用环境
📘 小结
知识图谱构建既包括信息抽取、知识融合、知识加工和维护更新等一般框架,也包括自顶向下、自底向上与混合构建等实现路径。实际选择取决于领域稳定性、数据来源、质量要求和系统目标。
“点赞有美意,赞赏是鼓励”

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 11
 0
- 0


 已为社区贡献10条内容

所有评论(0)