告别短视频!SoulX-LiveAct 问世:小时级实时数字人,仅需 2 张显卡
在生成式AI 狂飙突进的今天,视频生成已不再是新鲜事。但当我们把目光投向“长时数、高实时、低延迟”的数字人驱动时,行业依然面临着巨大的挑战:
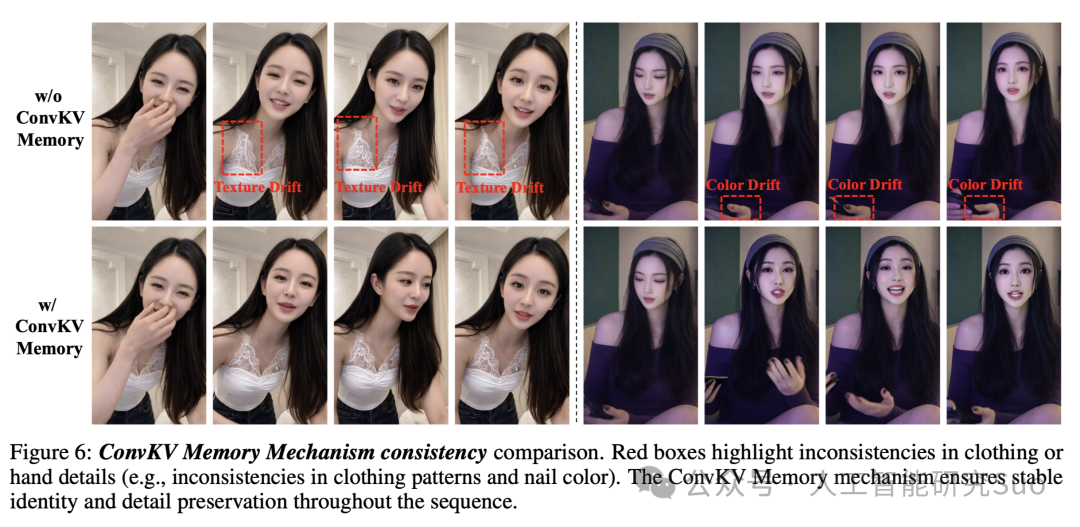
“长”不持久:传统的视频模型在生成长视频时,往往会出现身份漂移(Identity Drift),播着播着,主角的脸就“变”了。
“跑”不动:小时级的视频生成通常意味着天文数字般的计算量,动辄需要 A100 集群。
“对”不上:音画同步(Lip-sync)在长序列中极易产生累积误差,导致口型越播越乱。
近日,Soul AI Lab联手香港科技大学(广州)等机构,重磅发布了全新研究成果:SoulX-LiveAct。它不仅打破了视频生成的“时长魔咒”,更在效率上实现了质的飞跃。
核心黑科技一:Neighbor Forcing
让扩散模型告别“时差”
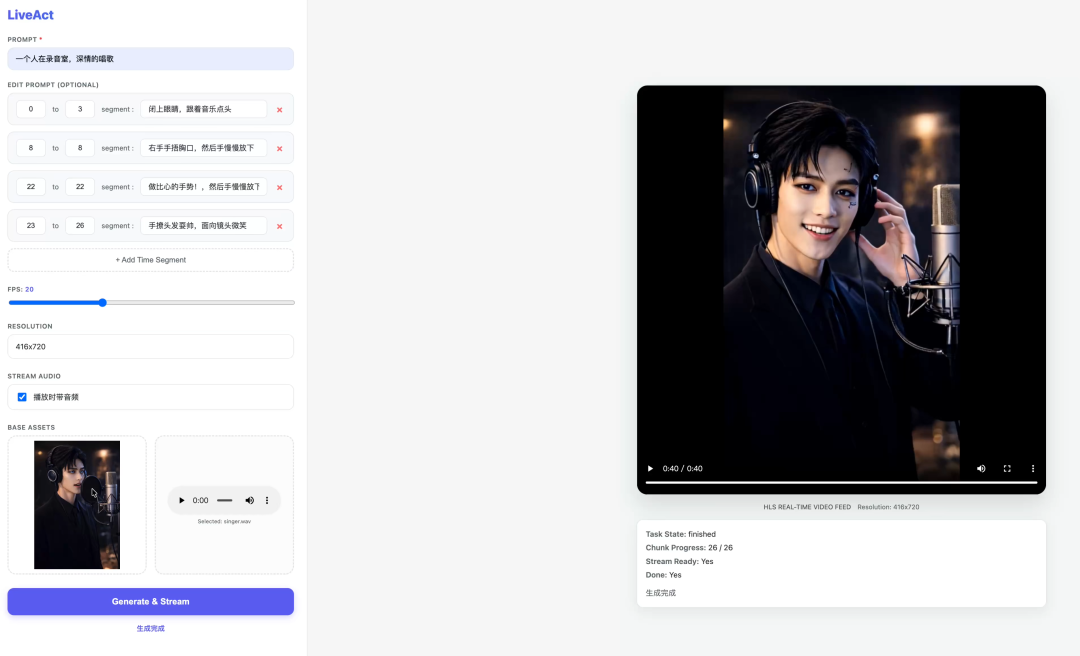
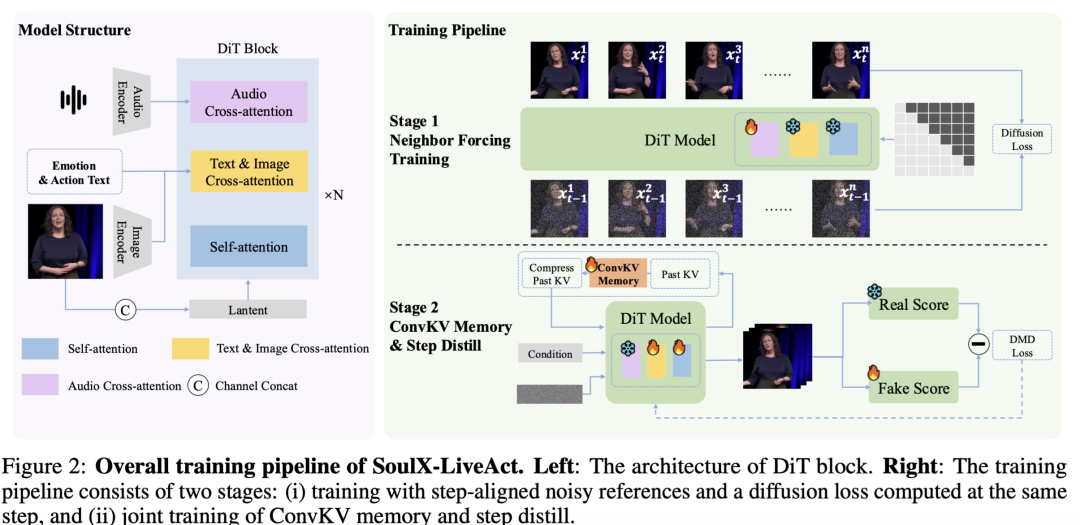
传统的自回归(AR)扩散模型在训练时,往往面临采样状态不匹配的问题,导致学习信号不稳定。SoulX-LiveAct 创新性地提出了 Neighbor Forcing策略 。
它的精妙之处在于:在每一个去噪步骤中,目标帧和所有参考帧都处于相同的噪声状态下。这种“步调一致”的设计,为模型提供了更加稳定、对齐的分布信号,不仅加速了训练收敛,更让生成的视频在时序上异常稳健 。
核心黑科技二:ConvKV Memory
像人类一样拥有“压缩记忆”
长视频生成的另一个痛点是显存爆炸。KV Cache(键值缓存)会随着时长线性增长,导致系统崩溃。
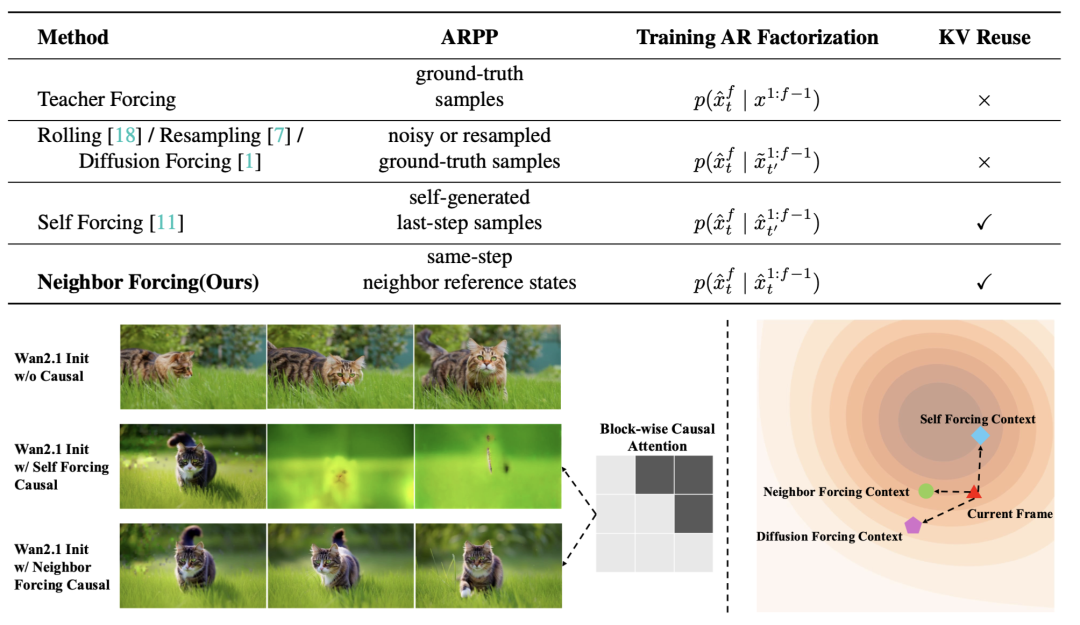
SoulX-LiveAct 引入了ConvKV Memory机制:
1. 短期记忆:保留最近的原始状态,确保细节精准 。
2.长期记忆:通过轻量级的1D 卷积,将旧的 KV 缓存压缩为固定长度的表示。
这种设计让模型拥有了“恒定内存”的推理能力,即便生成一整天、甚至无限时长的视频,显存占用也始终保持平稳。
性能炸裂:20 FPS 实时推流
在性能实测中,SoulX-LiveAct 的表现令人惊艳:
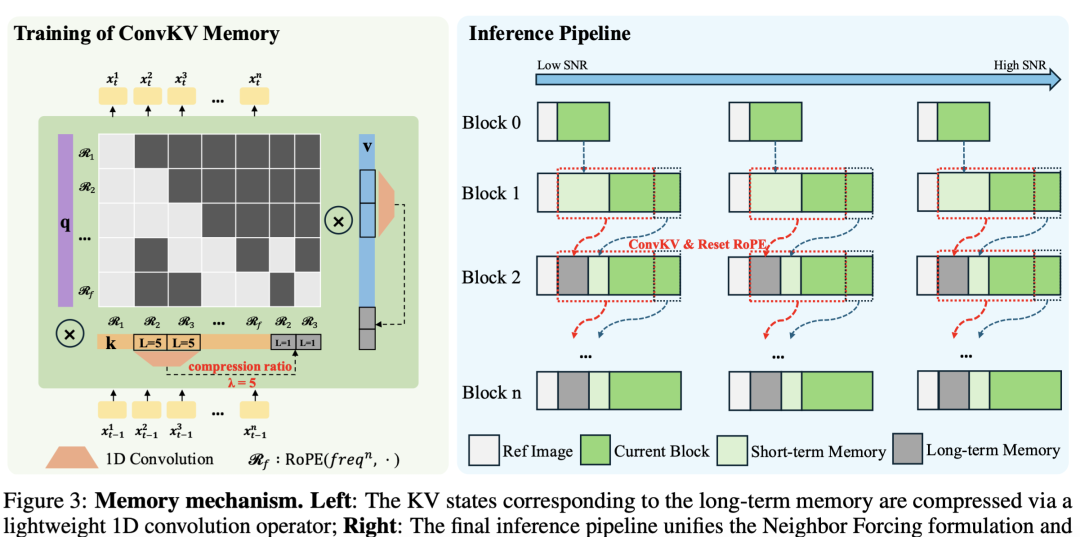
硬件极其友好:仅需 2 张 NVIDIA H100 或 H200 GPU,即可实现 20 FPS 的实时流式推理。
计算成本极低:每帧仅需 27.2 TFLOPs,远低于 Live-Avatar 等竞品(39.1 TFLOPs)
全方位 SOTA:在口型准确度(Lip-sync)、人体动画质量、情感表达力等指标上均达到业界顶尖水平 。
情感与动作:随心控制
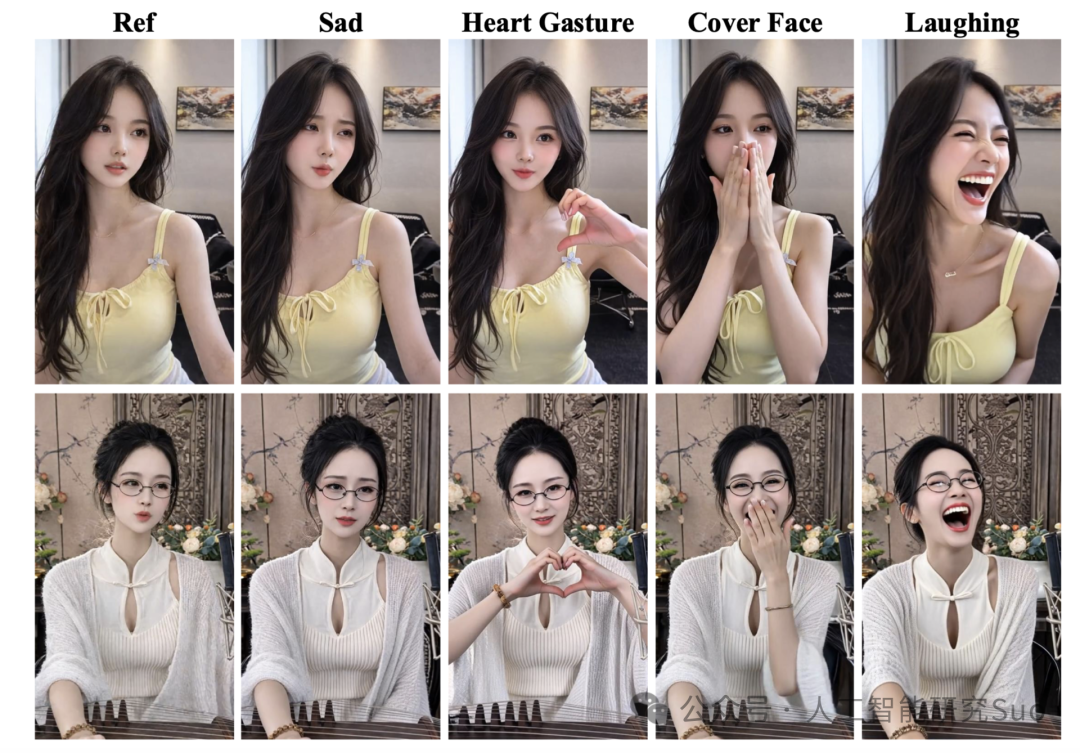
除了卓越的稳定性,SoulX-LiveAct 还内置了情感与动作编辑模块。只需输入简单的指令,数字人就能展现出悲伤、大笑,甚至是捂脸、比心等复杂的肢体动作,同时保持完美的身份一致性和音画同步。
结语:重塑实时互动新范式
SoulX-LiveAct 的开源,预示着实时互动直播、超长短剧生成、沉浸式虚拟助理等场景将迎来质变。
目前,该项目的论文、代码及项目主页已全部公开,技术社区的开发者们可以第一时间上手体验这款“小时级实时数字人”引擎。
更多transformer,VIT,swin tranformer
参考头条号:人工智能研究所
v号:人工智能研究Suo, 启示AI科技
动画详解transformer 在线视频教程


北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 10
 0
- 0


 已为社区贡献6条内容

所有评论(0)