英伟达:长程智能体后训练框架PivotRL
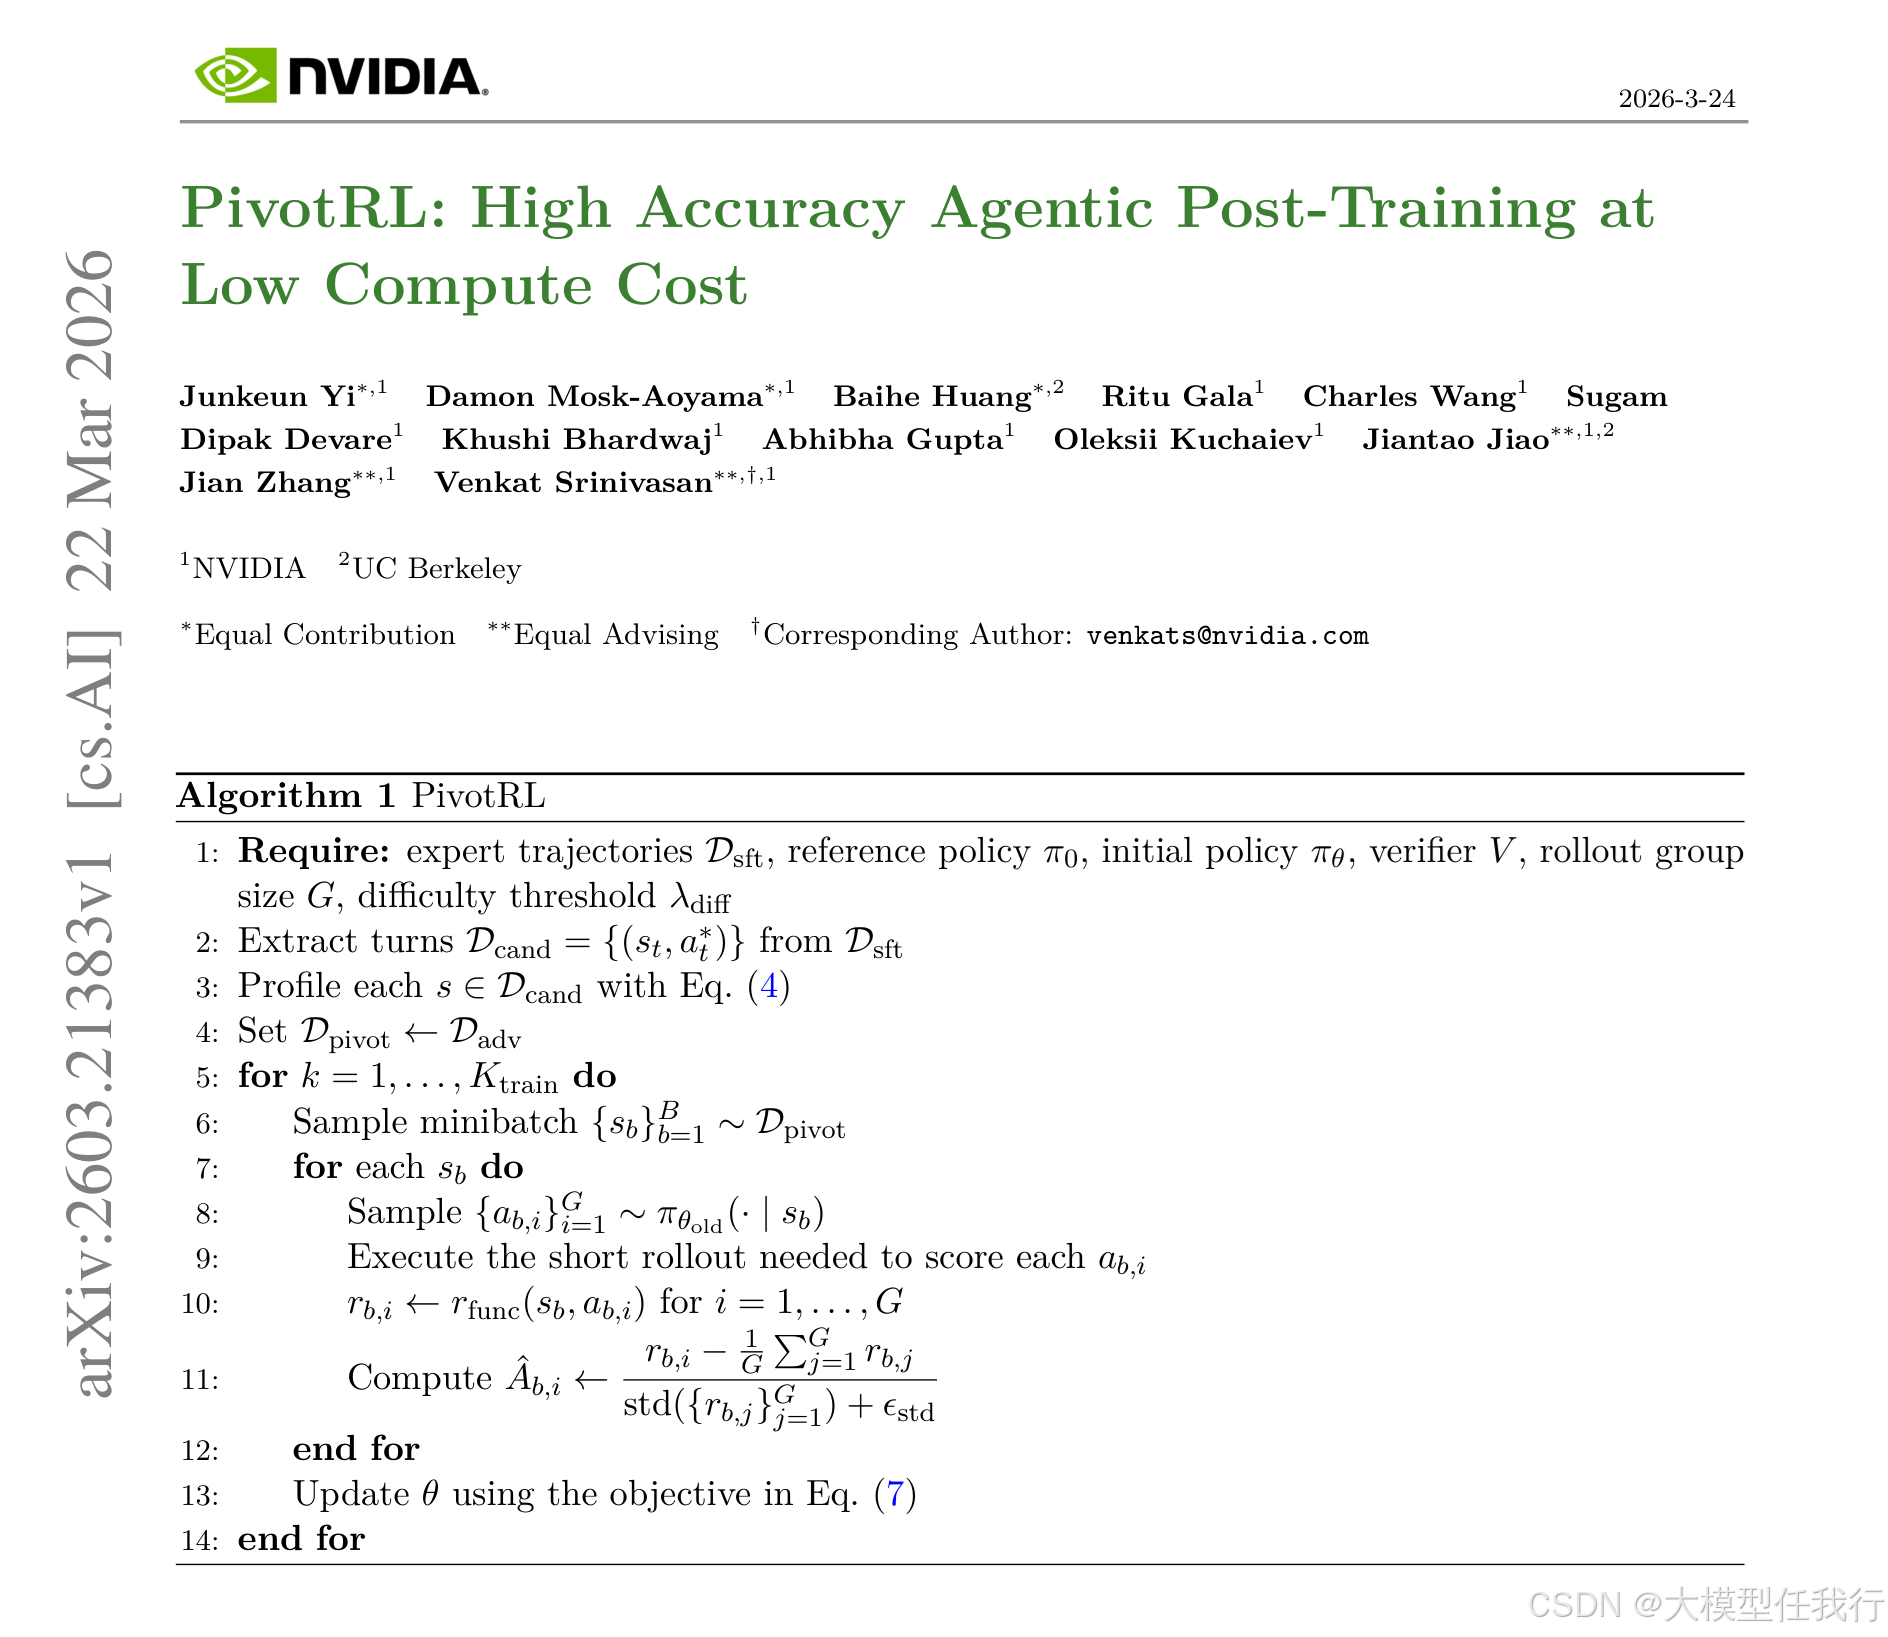
📖标题:PivotRL: High Accuracy Agentic Post-Training at Low Compute Cost
🌐来源:arXiv, 2603.21383v1
🌟摘要
长时间代理任务的后训练在计算效率和泛化之间存在紧张关系。虽然监督微调(SFT)是计算效率高的,但它经常遭受域外(OOD)退化。相反,端到端强化学习(E2 E RL)保留了OOD功能,但由于多次启用策略推出而导致计算成本高。我们引入了E2 E RL,一种新的框架,它在现有的SFT轨迹上运行,以将SFT的计算效率与E2 E RL的OOD准确性结合起来,联合收割机。E2 E RL依赖于两个关键机制:首先,它执行本地的、基于策略的展开和对枢轴的过滤:信息性的中间回合,其中采样的动作在结果中表现出高方差;第二,它利用对功能等价动作的奖励,而不是要求严格的字符串匹配与SFT数据演示。我们从理论上证明,这些机制激励具有高自然梯度范数的强学习信号,同时最大限度地保留与训练任务无关的动作的策略概率排序。与相同数据上的标准SFT相比,我们证明,在四个代理域上,EARRRL平均实现了+4.17%的域内准确率,在非代理任务中,OOD准确率提高了+10.04%。值得注意的是,在代理编码任务中,NVIDIA的Nemotron-3-Super-120 B-A12 B采用了E2 E RL,作为生产规模代理人岗位培训的主力军。
🛎️文章简介
🔸研究问题:如何在长程智能体任务的后训练中,既保留端到端强化学习的域外泛化能力,又避免其高昂的计算成本,同时克服监督微调导致的性能退化?
🔸主要贡献:论文提出了 PivotRL 框架,通过筛选高方差中间状态和利用功能等价奖励,以极低计算成本实现了优于 SFT 的域内精度和卓越的域外保持能力。
📝重点思路
🔸提出“支点(Pivot)”筛选机制,离线分析专家轨迹,仅保留那些模型采样动作结果存在高低差异(即高方差)的中间轮次进行训练,避免在过于简单或完全失败的步骤上浪费计算资源。
🔸设计基于验证器的功能等价奖励函数,不再强制要求生成动作与演示数据严格字符串匹配,而是只要动作在功能上正确(如工具调用有效)即给予正反馈,适应生成式动作空间的多样性。
🔸结合局部在线 rollout 与组相对策略优化(GRPO),仅在筛选出的支点状态进行短序列采样更新,理论上证明了该机制能最大化自然梯度范数并保留无关动作的概率排序。
🔎分析总结
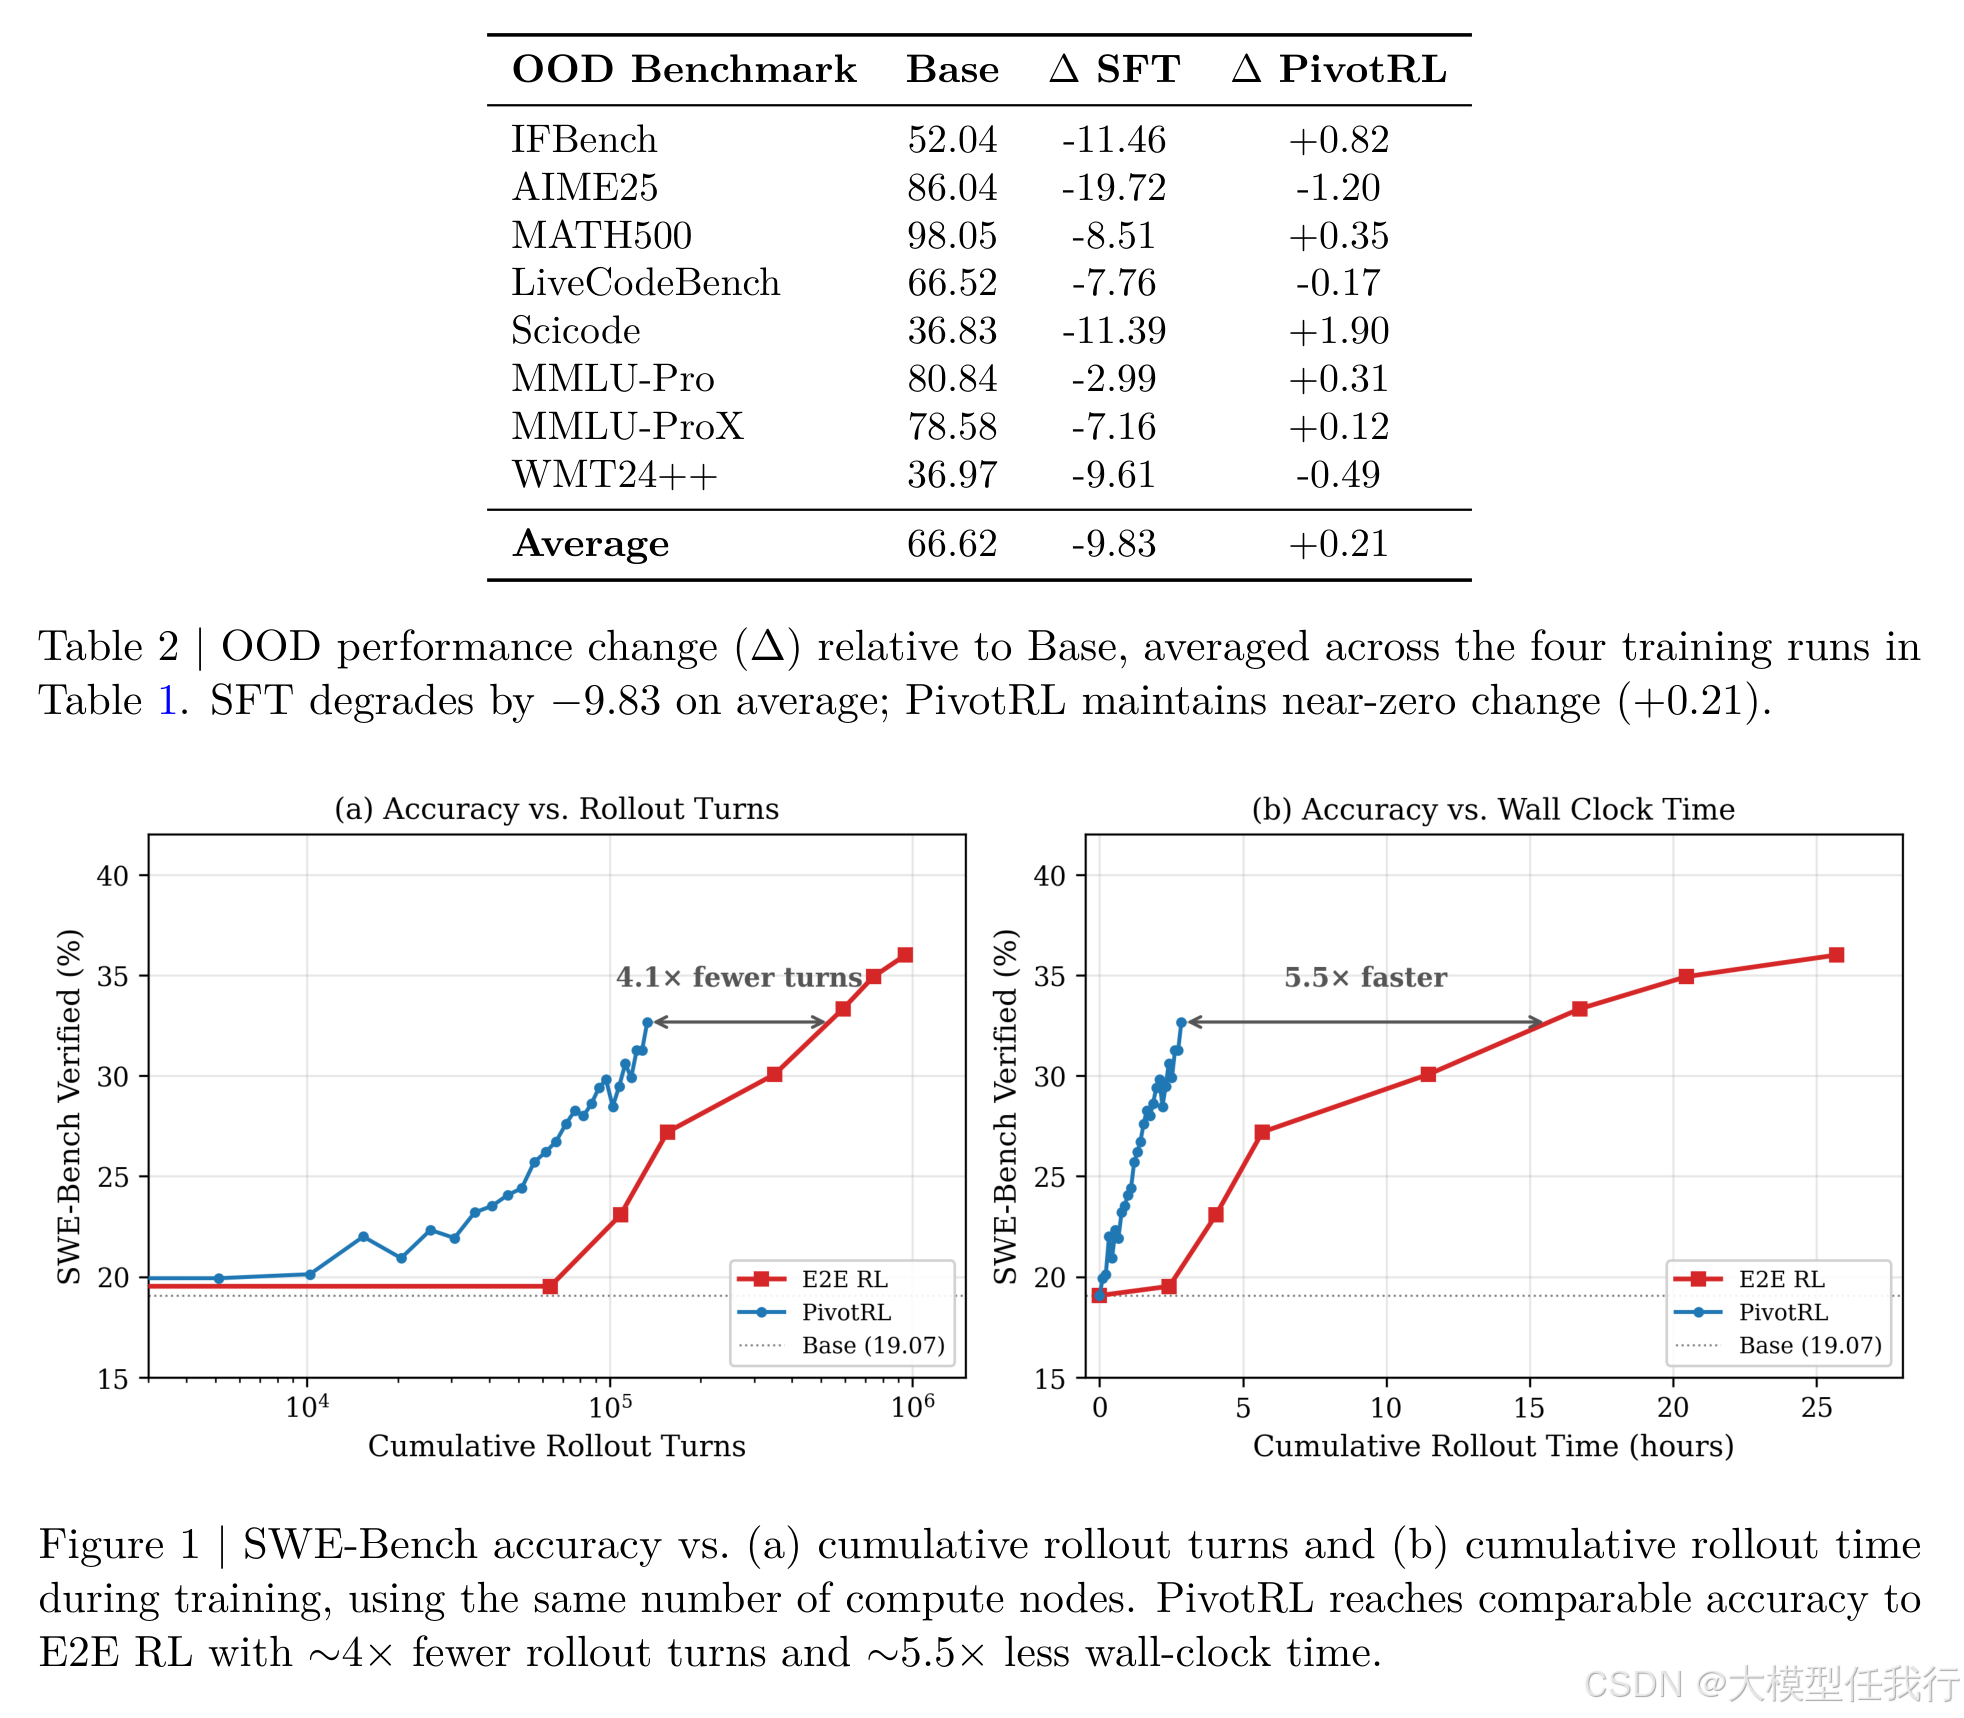
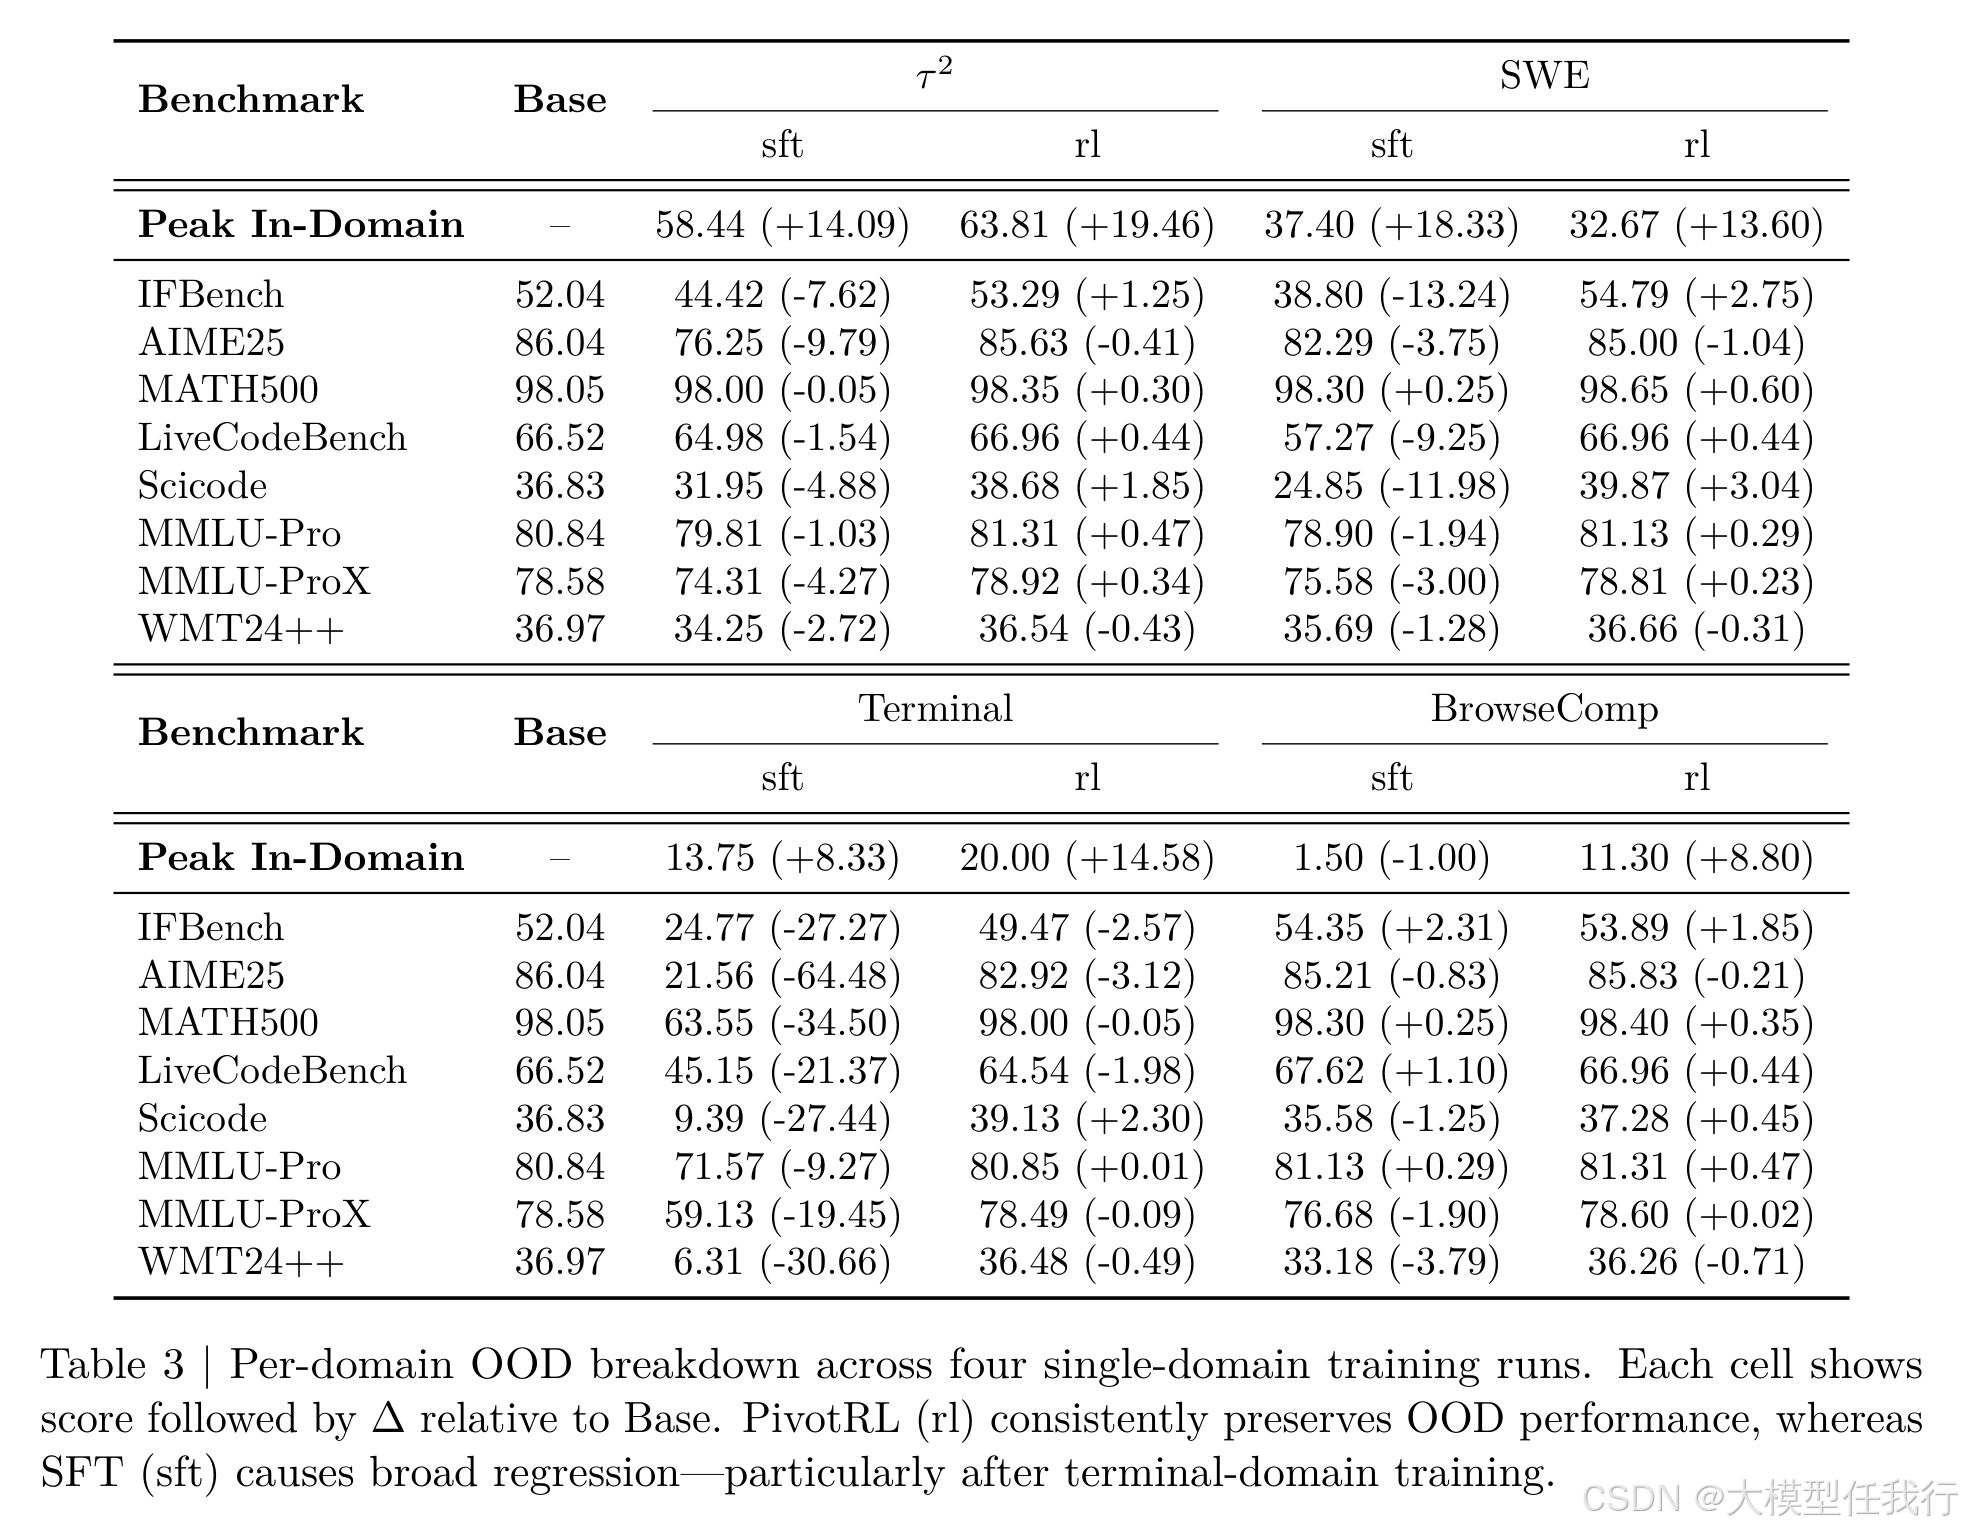
🔸在四个智能体领域实验中,PivotRL 相比同等数据的 SFT,域内准确率平均提升 4.17%,且在非智能体任务的域外准确率上高出 10.04%,有效避免了 SFT 常见的灾难性遗忘。
🔸在 SWE-Bench 代码任务基准上,PivotRL 达到了与端到端强化学习相当的准确率,但所需的 rollout 轮次减少了 4 倍,训练墙壁时间减少了 5.5 倍,显著降低了计算开销。
🔸消融实验证实,若移除支点筛选或使用严格的字符串匹配奖励,模型性能均会大幅下降,证明这两个核心组件对于获取强学习信号和维持泛化能力缺一不可。
💡个人观点
论文通过“支点筛选”精准定位具有学习价值的中间轮次,并利用“功能奖励”解决了传统模仿学习中对形式过度敏感的问题。
🧩附录

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 5
 0
- 0


 已为社区贡献20条内容

所有评论(0)