机器人操作的两条路线之争!全面对比,WAMs是否比VLAs的泛化能力更强?
这篇发表于 2026 年 3 月的论文由华为与多伦多大学联合完成,是机器人具身操作领域首次在统一基准、统一扰动、统一评估协议下,对 视觉‑语言‑动作模型(VLA)与世界动作模型(WAM) 两大技术路线开展的全面对比。文章不预设立场、不偏向任何范式,以实验数据回答行业最关心的问题:世界模型带来的 “物理预测能力”,是否真的让机器人在真实干扰环境中更稳、更通用,并清晰揭示两类模型的能力边界、内在机理与工程落地代价。
原文链接:https://arxiv.org/abs/2603.22078
本文也正式收录在具身智能之心开源知识库内,更多具身最新技术、投融资、产品政策、上下游信息,欢迎加入!
研究缘起:机器人操作的两条路线之争
在真实场景中,机器人执行抓取、装配、整理等任务,面临光照变化、相机抖动、背景杂乱、物体位置偏移等大量不可控干扰。能否在扰动下稳定完成任务,直接决定技术能否落地。
当前主流解决方案分为两条路径:
视觉‑语言‑动作模型(VLA)
以图文多模态大模型为基础,将视觉观测、语言指令直接映射为机器人动作。它是目前最成熟、部署最广泛的方案,优势是推理速度快、工程链完善;但依赖大量机器人演示数据,对未见过的环境扰动鲁棒性不足。
世界动作模型(WAM)
以视频生成式世界模型为基础,先学习海量互联网视频中的时空演化规律,能够 “预测未来状态”,再基于预测生成动作。这类模型被认为具备更强的物理理解与泛化能力,但推理开销大、实际鲁棒性缺乏系统性验证。
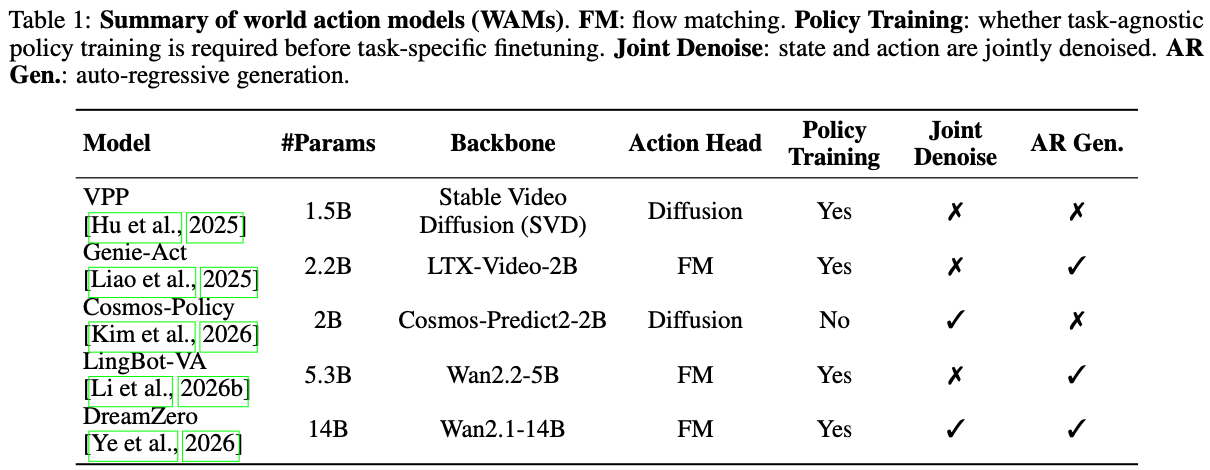
在此背景下,本文围绕四个核心问题展开研究:
- WAM 在各类环境扰动下是否真的更鲁棒?
- 这种鲁棒优势是否在所有干扰类型中都成立?
- 两类模型性能差异的根本来源是什么?
- 落地时的推理速度与计算代价差距有多大?
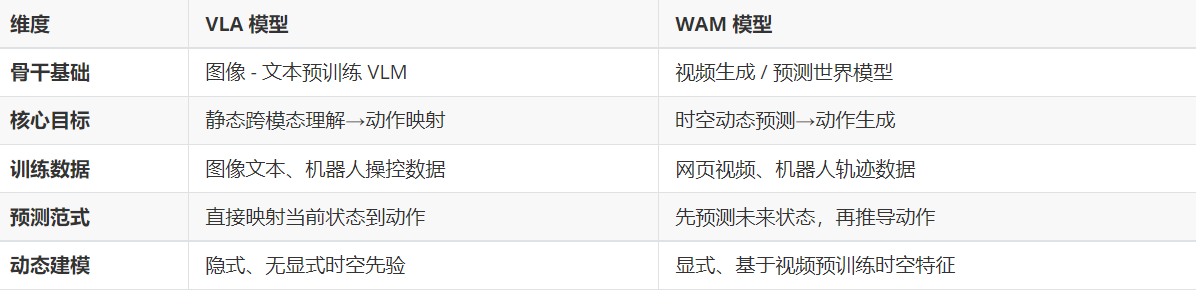
核心差异:VLA 与 WAM 的本质机理区别
论文从架构、学习目标、决策方式三个层面,清晰界定了两类模型的底层不同:
实验设计:双基准 + 七维扰动,保证严谨与公平
为避免单一环境带来的偏差,研究采用两个互补的强化基准,并统一施加7 大类共 21 项扰动,高度贴近真实工业与家庭场景。
实验平台
- LIBERO‑Plus:单臂 7 自由度机器人,40 项桌面操作任务,侧重精细操作鲁棒性;
- RoboTwin 2.0‑Plus:双臂 14 自由度机器人,50 项协作操作任务,侧重双臂协调稳定性。
七大类扰动维度
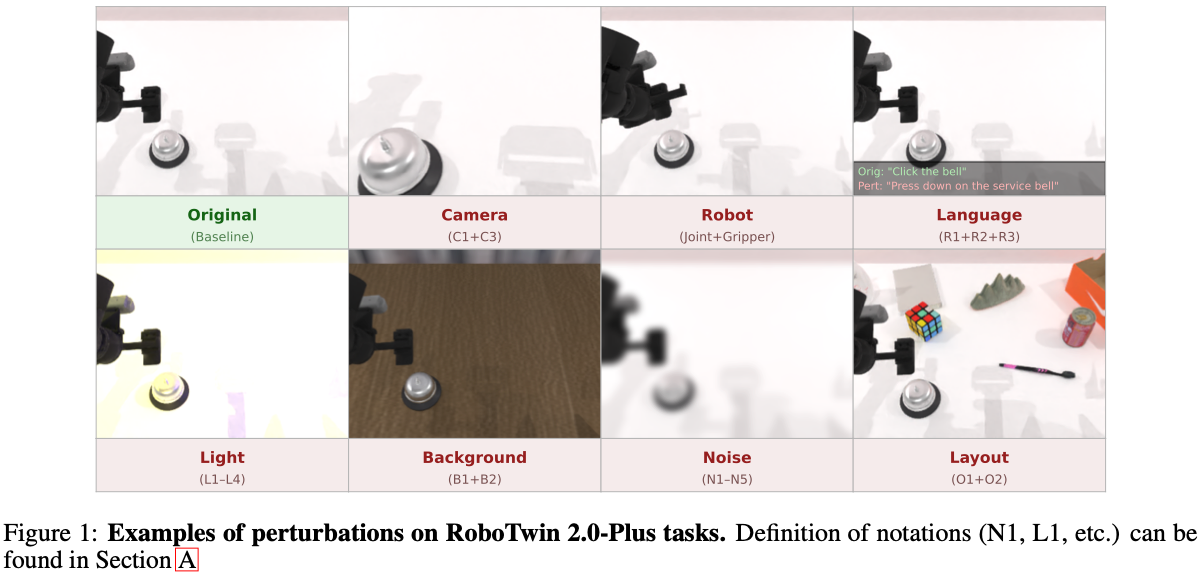
- 机器人初始状态扰动:关节位置、夹爪状态随机化
- 相机视角扰动:距离、角度、朝向变化
- 语言指令扰动:同义改写、增加干扰、目标式描述
- 光照扰动:颜色、强度、阴影、高光变化
- 背景扰动:材质、纹理、颜色替换
- 传感器噪声扰动:模糊、雾化、畸变
- 物体布局扰动:干扰物数量、目标位姿变化
评估指标
- 任务成功率:衡量扰动下的操作鲁棒性;
- 单块动作推理时间:衡量落地部署的实时性。
核心结果:四类关键发现
WAM 在视觉类扰动中具备显著鲁棒优势
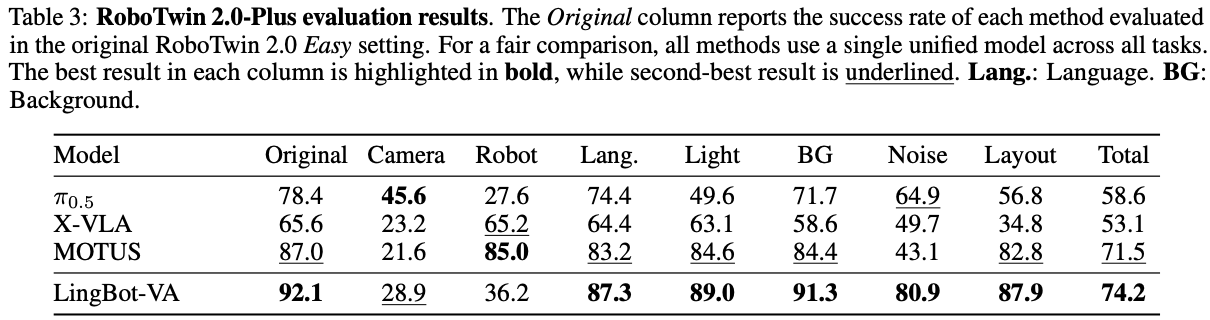
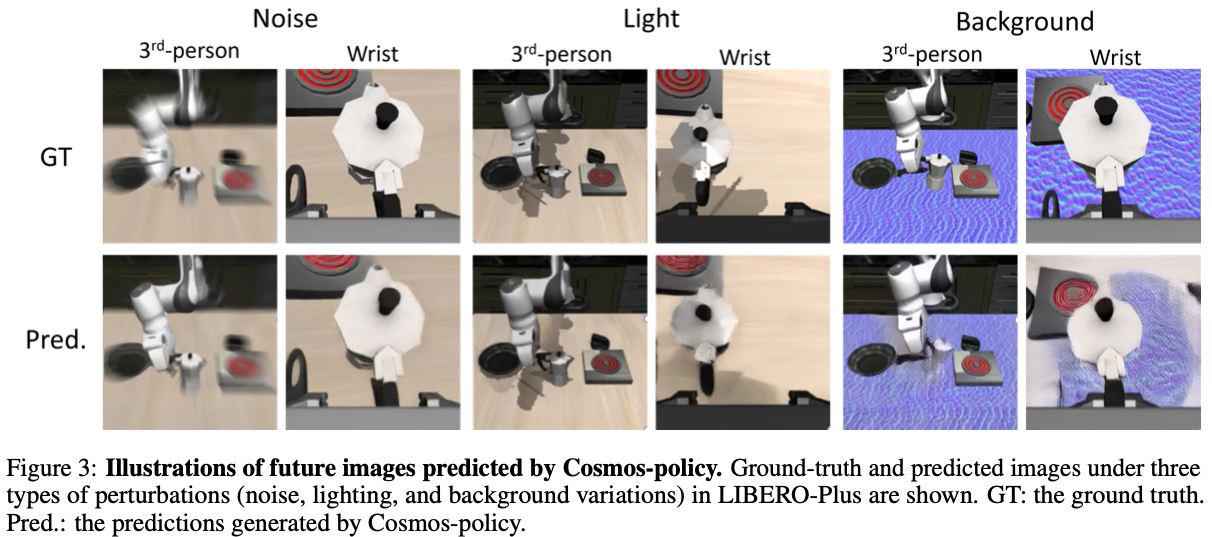
在光照变化、图像噪声、背景杂乱、物体布局干扰等视觉外观类扰动下,WAM 表现明显优于普通 VLA。
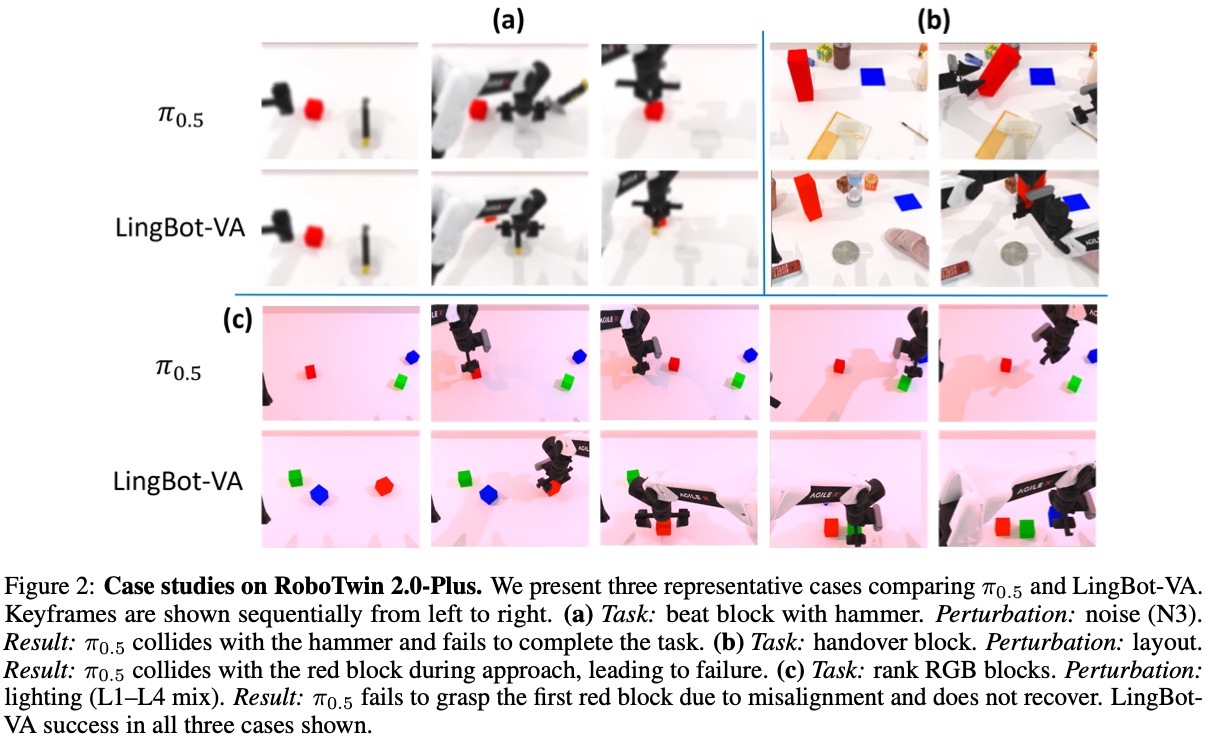
在双臂任务 RoboTwin 2.0‑Plus 中,LingBot‑VA(WAM)整体成功率 74.2%,显著高于 π 0.5 \pi_{0.5} π0.5(VLA)的 58.6%;
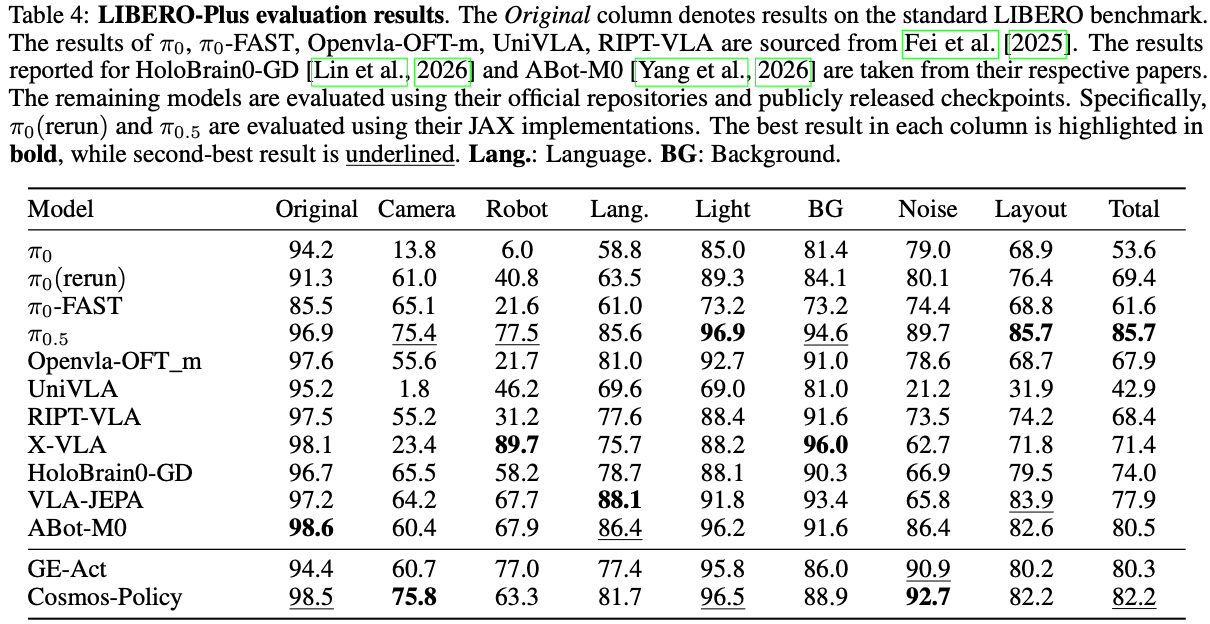
在单臂任务 LIBERO‑Plus 中,Cosmos‑Policy(WAM)达到 82.2%,GE‑Act(WAM)达到 80.3%。
其核心原因是:WAM 从海量视频中学习到了时空动态先验,能够在画面外观发生变化时,依然抓住物体与场景的本质结构。
WAM 存在明确短板:几何配置类扰动鲁棒性不足
当扰动来自相机视角大幅变化、机器人初始关节姿态改变时,WAM 的鲁棒性明显下降,甚至低于部分 VLA 模型。
这是因为视频预训练只学习动态外观,无法覆盖相机几何、机器人运动学结构等物理本体配置变化,而这也是当前所有具身操作模型共同的技术挑战。
顶级 VLA 可通过数据多样性达到超越 WAM 的鲁棒性
π 0.5 \pi_{0.5} π0.5作为经典 VLA 模型,未使用世界模型结构,但依靠大规模多源数据训练(机器人数据 + 互联网图文与视频数据),在 LIBERO‑Plus 上实现 85.7% 的成功率,超过所有参评 WAM。
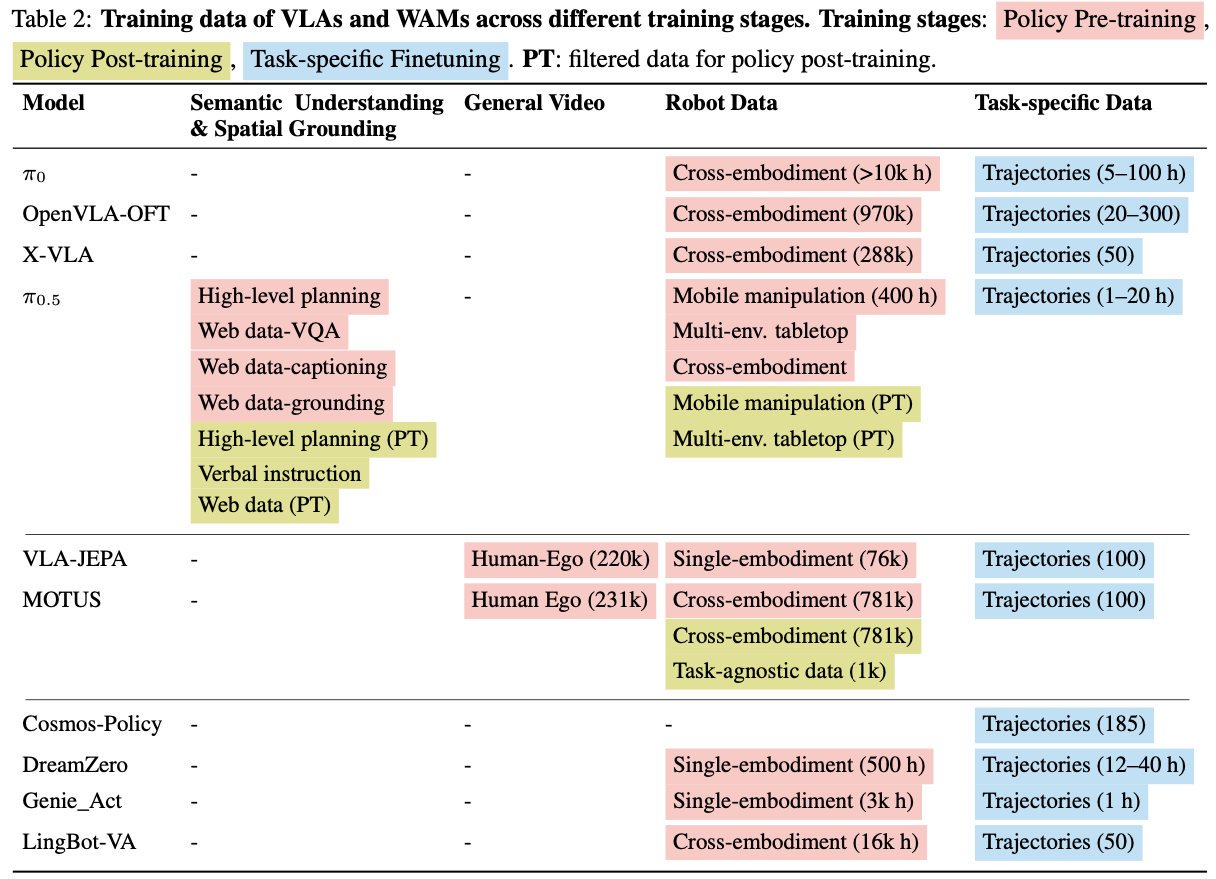
这一结果直接说明:显式世界建模并非鲁棒性的唯一来源,数据规模、多样性与训练策略同样可以让 VLA 达到顶尖水平。
混合架构的性能居中,融合方式决定上限
MOTUS、VLA‑JEPA 等在 VLA 基础上引入世界模型辅助任务的混合架构,鲁棒性高于普通 VLA,但低于纯 WAM。
这表明:简单拼接视频先验不足以发挥世界模型的全部能力,如何将时空动态先验高效融入 VLA,比 “是否融合” 更重要。
工程落地关键:WAM 推理速度存在数量级差距
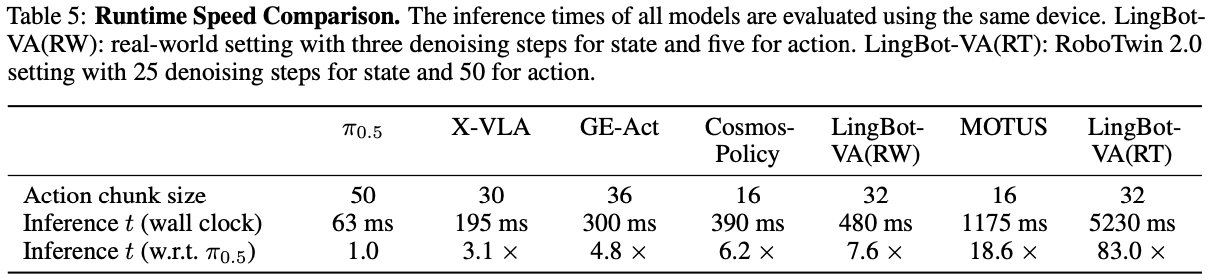
论文给出了可直接用于工程选型的速度对比,以 π 0.5 \pi_{0.5} π0.5(63ms / 动作块)作为基准:
- GE‑Act:慢 4.8 倍
- Cosmos‑Policy:慢 6.2 倍
- LingBot‑VA(实机配置):慢 7.6 倍
- MOTUS:慢 18.6 倍
- LingBot‑VA(仿真配置):慢 83 倍
WAM 的速度瓶颈来自未来状态去噪:为了提升预测准确性,需要多次迭代去噪,鲁棒性越高,延迟越大。这使得 WAM 在需要高频、实时控制的场景中,目前难以直接部署。
机理总结:为什么两类模型表现不同?
论文将所有差异归结为三点底层逻辑:
预训练目标决定先验类型
VLA 擅长静态语义,WAM 擅长动态时序,这是性能分化的根源。
动作生成方式决定泛化路径
VLA 靠数据覆盖泛化,WAM 靠预测物理规律泛化。
计算流程决定落地代价
VLA 推理简单高效,WAM 预测步骤多、成本高。
研究结论与技术选型指南
本文最终给出中立且明确的结论:
WAM 在视觉干扰多、数据稀缺的场景更具优势,但对相机与本体几何变化敏感,且推理速度慢;
VLA 在数据充足、需要实时控制的场景更实用,顶级 VLA 的鲁棒性可超越 WAM;
混合架构是现阶段的折中方案,但仍需优化先验融合方式;
未来方向:提升 WAM 推理效率、增强模型对几何配置变化的鲁棒性、实现 VLA 与 WAM 的深度融合。
基于以上结论,可直接形成技术选型逻辑:
- 视觉干扰强、数据少、对实时性要求不高 → 选择 WAM
- 要求高速控制、硬件资源有限、已有大量机器人数据 → 选择成熟 VLA
- 希望平衡鲁棒性与速度 → 采用 VLA + 世界模型辅助的混合架构
重磅!
VLA+RL方向首个系统教程来啦!Online RL/Offline RL/test time RL等~
推荐阅读
我们用低成本的机械臂完成pi0/pi0.5/GR00T/世界模型等VLA任务~
VLA/VLA+触觉/VLA+RL/具身世界模型等!具身大脑+小脑算法与实战全栈路线来啦~
Diffusion Policy在具身智能领域是怎么应用的?为什么如此重要?
1v1 科研论文辅导来啦!

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 10
 0
- 0


 已为社区贡献21条内容

所有评论(0)