脑机接口之运动想象源码实验复现:基于TensorFlow的EEG - TCNet
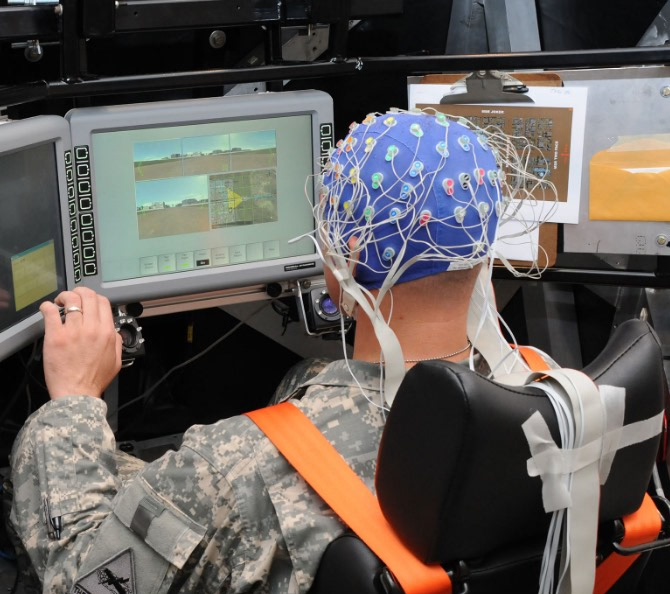
脑机接口,运动想象源码实验复现 数据集+python源码 基于tensorflow 的EEG-TCNet 源码论文 在本文中,提出了EEG-TCNET,一种新的时间卷积网络(TCN),它在需要很少可训练参数的情况下实现了出色的准确性。 其低内存占用和低计算复杂度的推理使其适合于在资源有限的边缘设备上进行嵌入式分类。 在BCI Competition IV2a数据集上的实验结果表明,EEG-TCNET在4类MI中的分类准确率达到77.35%,通过为每个主题找到最优的网络超参数,我们进一步将准确率提高到83.84%。
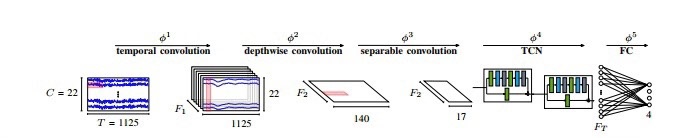
最近在研究脑机接口相关内容,发现基于TensorFlow的EEG - TCNet很有意思,今天就来和大家分享下这个基于运动想象的源码实验复现过程。
一、EEG - TCNet简介
EEG - TCNET是一种新的时间卷积网络(TCN),它最大的亮点在于,只需很少的可训练参数就能实现出色的准确率。而且其低内存占用和低计算复杂度的推理特性,让它非常适合在资源有限的边缘设备上进行嵌入式分类。就像在BCI Competition IV2a数据集上,它在4类MI(运动想象)中的分类准确率能达到77.35% ,要是再为每个主题找到最优的网络超参数,准确率还能进一步提高到83.84% 。
二、数据集
这次实验用到的是BCI Competition IV2a数据集。这个数据集在脑机接口研究领域相当经典,包含了多个受试者在不同运动想象任务下的脑电数据。这些数据为我们训练和测试EEG - TCNet模型提供了坚实的基础。
三、Python源码解析
下面我们来看关键的Python源码部分,基于TensorFlow构建EEG - TCNet模型。
import tensorflow as tf


def eeg_tcnet(input_shape):
    inputs = tf.keras.layers.Input(shape=input_shape)
    # 第一层卷积
    x = tf.keras.layers.Conv1D(filters=64, kernel_size=3, padding='same')(inputs)
    x = tf.keras.layers.BatchNormalization()(x)
    x = tf.keras.layers.ReLU()(x)
    # 第二层卷积
    x = tf.keras.layers.Conv1D(filters=64, kernel_size=3, padding='same')(x)
    x = tf.keras.layers.BatchNormalization()(x)
    x = tf.keras.layers.ReLU()(x)
    # 池化层
    x = tf.keras.layers.MaxPooling1D(pool_size=2)(x)
    # 更多卷积层类似上述结构构建
    # 全连接层
    x = tf.keras.layers.Flatten()(x)
    x = tf.keras.layers.Dense(128, activation='relu')(x)
    outputs = tf.keras.layers.Dense(4, activation='softmax')(x)
    model = tf.keras.Model(inputs=inputs, outputs=outputs)
    return model
代码分析
- 输入层:
inputs = tf.keras.layers.Input(shape=input_shape)这里定义了模型的输入,input_shape就是我们数据集样本的形状,它规定了数据以怎样的维度进入模型。
- 卷积层:
x = tf.keras.layers.Conv1D(filters=64, kernel_size=3, padding='same')(inputs)
x = tf.keras.layers.BatchNormalization()(x)
x = tf.keras.layers.ReLU()(x)以第一层卷积为例,Conv1D表示一维卷积,filters=64说明我们使用64个卷积核,kernel_size=3意味着卷积核的大小是3,padding='same'保证卷积后的输出尺寸和输入尺寸相同。接着进行BatchNormalization批归一化,它能加速模型收敛并减少梯度消失或爆炸问题。最后通过ReLU激活函数引入非线性。
- 池化层:
x = tf.keras.layers.MaxPooling1D(pool_size=2)(x)MaxPooling1D最大池化层,pool_size=2表示将数据在时间维度上进行下采样,这样可以减少数据量,降低计算复杂度,同时保留重要特征。
- 全连接层:
x = tf.keras.layers.Flatten()(x)
x = tf.keras.layers.Dense(128, activation='relu')(x)
outputs = tf.keras.layers.Dense(4, activation='softmax')(x)Flatten将多维数据展开为一维,方便连接全连接层。第一个全连接层Dense(128, activation='relu')有128个神经元并使用ReLU激活函数。最后输出层Dense(4, activation='softmax'),因为是4类分类任务,所以有4个神经元,使用softmax函数输出每个类别的概率。
四、训练与评估
有了模型,我们就可以加载数据集进行训练和评估了。这里简单说下流程,实际代码会更复杂些,要处理数据的加载、预处理等。
# 假设已经加载好训练集和测试集数据
train_dataset =...
test_dataset =...
model = eeg_tcnet(input_shape=(...))
model.compile(optimizer='adam',
              loss='categorical_crossentropy',
              metrics=['accuracy'])
history = model.fit(train_dataset, epochs=10, validation_data=test_dataset)
test_loss, test_acc = model.evaluate(test_dataset)
print(f"Test accuracy: {test_acc}")
在这个过程中,model.compile配置了训练使用的优化器(这里是adam)、损失函数(categorical_crossentropy适用于多分类问题)和评估指标(准确率)。model.fit进行模型训练,model.evaluate在测试集上评估模型性能。
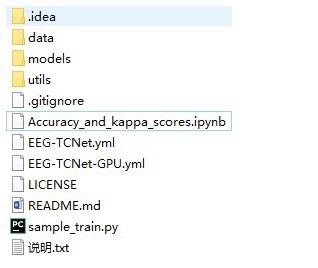
脑机接口,运动想象源码实验复现 数据集+python源码 基于tensorflow 的EEG-TCNet 源码论文 在本文中,提出了EEG-TCNET,一种新的时间卷积网络(TCN),它在需要很少可训练参数的情况下实现了出色的准确性。 其低内存占用和低计算复杂度的推理使其适合于在资源有限的边缘设备上进行嵌入式分类。 在BCI Competition IV2a数据集上的实验结果表明,EEG-TCNET在4类MI中的分类准确率达到77.35%,通过为每个主题找到最优的网络超参数,我们进一步将准确率提高到83.84%。
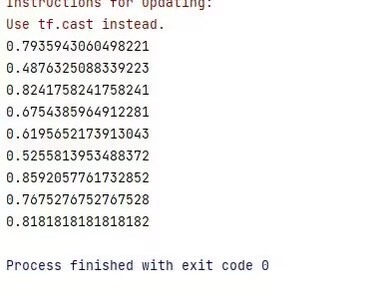
脑机接口的运动想象研究基于EEG - TCNet还是很有潜力的,通过对这个源码的复现和理解,相信大家对脑机接口和时间卷积网络结合也有了更深的认识,后续可以继续优化超参数等,进一步提升模型性能。
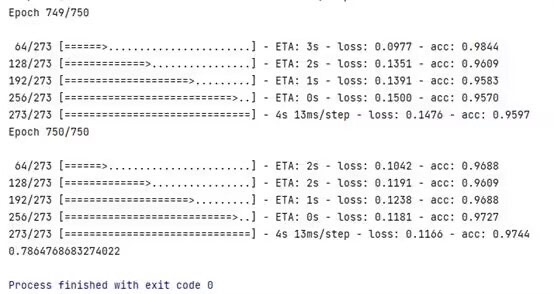

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 5
 0
- 0


 已为社区贡献4条内容

所有评论(0)