超越简单公平:大规模异构算力调度中的多目标权衡与系统优化
作者:SYX from HPC group @Shanghai AI Lab
TL;DR
面向大规模异构 GPU 算力集群的多租户调度场景,本文针对传统方法仅支持单维度公平、无法量化异构算力差异、难以动态适配混合负载与规模化集群的缺陷,提出融合多资源、完成时间、长期公平的MDE‑Fair 多维动态均衡公平调度方案,在万卡级实测中全局公平性达 0.91,同时集群调度层面资源利用率超 95%,实现公平与效率协同最优。
一 背景与挑战
在当今计算密集型应用(如大规模AI训练、科学模拟与云原生服务)的驱动下,融合了CPU、GPU、FPGA及各类AI加速芯片的大规模异构算力集群已成为核心基础设施。在此背景下,资源调度系统作为集群的“中枢神经”,其设计目标从追求单一的吞吐量最大化,演进为在多租户、多任务场景下实现效率、公平性与成本的多维平衡。其中,公平性已从一个理想的附加属性,转变为确保系统长期稳定、可持续与商业可行的基石性原则。
公平性的重要性不言而喻,它直接关系到用户体验、资源投资回报率与生态系统健康。一个不公平的调度系统会导致 “算力饥荒”与“资源泡沫”并存——部分用户或任务长期垄断稀缺的高性能算力(如高端GPU),而其他任务则在队列中无限期等待,造成用户满意度两极分化、资源利用率局部塌陷。更严重的是,这会扭曲用户行为,激励其提交过量资源请求以独占,进一步恶化系统整体效率。因此,缺乏公平性的调度,最终将同时损害集群的吞吐量与经济效益。然而,在异构集群中实现真正的公平性面临前所未有的理论挑战与工程复杂性:
-
资源异构性与不可比性:如何公平地比较和权衡一个占用8张A100 GPU的AI训练任务与一个需要32张4090 GPU的仿真任务?传统的、基于单一维度(如CPU核时)的公平份额模型(如Dominant Resource Fairness, DRF)在多维异构资源的向量空间中日渐乏力。
-
任务异构性与目标冲突:任务对公平的诉求本身是异构的——批处理作业追求截止时间内的公平完成,在线服务要求响应时间的公平保障,而探索性任务可能需要公平的试错机会。调度器必须在短期公平(即时分配)与长期公平(跨时间均衡) ,用户间公平与项目间公平等多个目标间进行动态权衡。
-
规模化与动态性带来的度量困境:在数千节点、瞬息万变的大规模集群中,实时、精确地评估全局公平状态本身计算开销巨大。公平性度量需在精确性与可扩展性之间取舍,且必须能适应集群拓扑变化、资源故障及工作负载的突发波动。
这些挑战共同表明,传统同构集群或小规模场景下的公平性调度理念与算法,已难以直接适用于新一代异构算力环境。这要求我们重新审视公平性的定义与度量,并在调度架构与算法层面进行根本性的创新探索。
二 已有的研究
GPU 集群作为多用户共享的核心计算资源,公平性调度直接影响资源利用率与用户体验。当深度学习(DL)和大语言模型(LLM)训练任务占据集群时,其长运行时间、高资源需求的特性,使得不同用户、不同任务间的资源分配公平性成为调度系统的关键挑战。这一部分我们首先围绕 如何在效率与公平间找到平衡这一主题来回顾当前主流的公平性调度策略、评估指标及实践方案。
2.1 多资源公平调度:兼顾资源多样性
核心思路是打破单一资源分配的局限,基于任务对各类资源的依赖程度进行均衡分配。
-
代表方案:主导资源公平(DRF)算法
-
核心逻辑:先识别每个用户的主导资源—— 即该用户任务占用比例最高的资源类型(如 GPU 算力或网络带宽),再以主导资源占用比例相等为目标分配资源。
-
实践效果:避免用户因某类关键资源被垄断而无法开展任务,实现 CPU、GPU、内存等多资源的全局公平。
2.2 完成时间公平调度:聚焦任务执行效率
以 任务完成时间(JCT)的公平性为核心,确保不同用户的任务在共享集群中,其完成时间与独占资源时的理想时间差距最小。
-
代表方案:Themis 调度器、CASSINI 调度器
-
核心逻辑:Themis 通过预测任务在共享资源下的完成时间,与理想独占场景对比,采用多轮拍卖机制动态调整资源分配;CASSINI 则进一步结合任务通信模式,让不同任务的通信阶段交错进行,减少网络拥堵对部分任务的影响,实现更精细的完成时间公平。
-
实践效果:避免短任务被长任务插队,同时防止长任务因资源被频繁抢占而无限期延迟。
2.3 长期公平调度:平衡长期资源占用
针对长期运行的集群环境,确保用户在一段时间内(而非单次任务)获得的资源总量与需求匹配。
-
代表方案:Astraea 调度器的长期 GPU 时间公平(LTGF)
-
核心逻辑:跟踪用户在数小时或数天内的 GPU 占用时长,根据用户任务的资源需求比例,动态调整后续任务的调度优先级,确保长期内每个用户的 GPU 占用时长与其需求成正比。
-
实践效果:适合多租户长期共享的集群场景,避免用户因短期集中提交任务而占据过多资源,或因长期低频次提交而被忽视。
2.4 阈值调节公平调度:灵活平衡效率与公平
通过引入可调节阈值,让调度系统在公平性与集群整体效率间灵活切换。
-
代表方案:AlloX 调度器
-
核心逻辑:设置阈值参数 α(取值 0-1),α 越小越侧重公平,优先调度资源占用少的用户任务;α 越大越侧重效率,优先处理能快速提升集群吞吐量的任务。例如 α=0.3 时,仅考虑前 30% 资源占用最少的用户进行调度;α=0.8 时,则优先满足能缩短整体任务队列的高效任务。
-
实践效果:适配不同集群运行场景,如科研环境可调低 α 保障公平,生产环境可调高 α 提升效率。
2.5 市场机制驱动调度:引入动态资源分配逻辑
将资源分配转化为虚拟市场交易,通过经济规则实现公平与效率的平衡。
-
代表方案:Shockwave 调度器
-
核心逻辑:为每个任务分配相等的 “虚拟预算”,任务通过 “竞拍” 获取资源,资源价格随供需动态调整(如 GPU 空闲时低价,繁忙时高价)。同时结合完成时间公平(FTF)指标,确保任务不会因预算有限而无法完成。
-
实践效果:利用市场杠杆鼓励用户合理提交任务(避免资源浪费),同时通过预算均等化保障所有用户的参与权,尤其适合动态变化的任务负载场景。
2.6 数据本地化与公平结合:减少环境干扰
核心思路是在考虑数据存储位置的同时,兼顾公平性,避免任务因数据迁移而延迟。
-
代表方案:延迟调度(Delay Scheduling)、Quincy调度器
-
核心逻辑:
-
延迟调度(Delay Scheduling)决策时,当任务需要的资源节点与数据存储节点不一致时,先延迟该任务的调度,优先调度数据本地化的任务;但为保障公平,任务延迟次数设有上限,避免部分任务因数据位置不佳而长期等待。
-
Quincy 调度器将调度问题建模为最小费用流问题。在费用流图中,作业与资源节点信息均表示为节点,通过求解该费用流,可得到兼顾数据局部性与公平性的调度方案。
-
-
实践效果:在提升数据访问效率的同时,防止数据本地化任务长期垄断资源,兼顾效率与公平。
| 调度策略类型 | 代表方案 | 核心逻辑 | 核心优势 | 适用场景 |
| 多资源公平 | DRF | 基于主导资源占用比例相等,分配多类资源 | 解决多资源依赖任务的公平性问题 | 多资源密集型任务集群 |
| 完成时间公平 | Themis、CASSINI | 最小化共享环境与理想环境的任务完成时间差,结合通信优化 | 兼顾短任务与长任务的执行效率 | 混合任务负载(长短任务并存) |
| 长期公平 | Astraea(LTGF) | 跟踪长期资源占用,按需求比例分配资源 | 适合多租户长期共享集群 | 科研型多租户集群 |
| 阈值调节公平 | AlloX | 通过 α 阈值灵活切换公平与效率优先级 | 适配不同运行场景(科研 / 生产) | 动态负载变化的集群 |
| 市场机制驱动 | Shockwave | 虚拟预算竞拍资源,结合完成时间公平指标 | 鼓励资源高效利用,保障所有用户参与权 | 动态任务负载集群 |
| 数据本地化 + 公平 | Delay Scheduling、Quincy | 优先数据本地化任务,限制任务最大延迟次数 | 提升数据访问效率,避免部分任务长期等待 | 数据密集型DL任务集群 |
三 进一步的探索
针对 GPU 集群中多用户、多任务、异构资源的复杂场景,我们进行进一步的技术探索。探索的核心问题是大规模异构集群调度面临三大矛盾:
-
资源异构不可比:不同 GPU 性能差异大,传统 DRF 等同质化分配不公平。
-
公平维度单一:现有方法只关注资源 / 完成时间 / 长期中的一项,无法兼顾。
-
动态性难适配:负载突变、节点故障下静态算法快速失效。
对此,我们设计一种多维动态均衡公平调度(Multi-dimensional Dynamic Equilibrium Fair Scheduling, MDE-Fair) 方案,其设计采用三维公平融合 + 异构效能归一化 + 三层动态优化的设计思路:
-
用效能系数 η统一量化不同 GPU 算力,把异构资源拉到同一公平尺度。
-
把多资源公平、完成时间公平、长期公平合成全局目标。
-
用改进 DRF→改进遗传算法→强化学习三层架构,实现分配→调度→调优。
该方案突破传统单一维度公平性局限,融合资源占用、任务完成效率、用户长期权益三大核心维度,通过数学建模与智能优化算法,实现公平性与集群吞吐量的全局最优平衡,适配 DL/LLM 训练任务的动态特性与异构资源环境。
3.1 模型设计
为解决大规模异构算力集群中资源异构不可比、公平维度单一、动态适配性差三大核心问题,本节从多目标优化视角构建多维动态均衡公平性模型。该模型以统一度量、多维融合、动态可配为设计原则,首先引入资源效能系数对不同类型 GPU 进行归一化量化,消除异构资源带来的分配尺度差异。再将多资源公平、任务完成时间公平、长期占用公平三大核心目标融合为统一全局公平性指标,并通过可调节权重实现科研 / 生产等不同场景的灵活适配。最后结合资源容量、节点异构、任务延迟等约束条件,将调度问题转化为带约束的多目标优化问题,为后续分层调度算法提供严谨的数学基础与优化目标,从理论层面保证公平性与效率。
3.1.1 目标函数设计
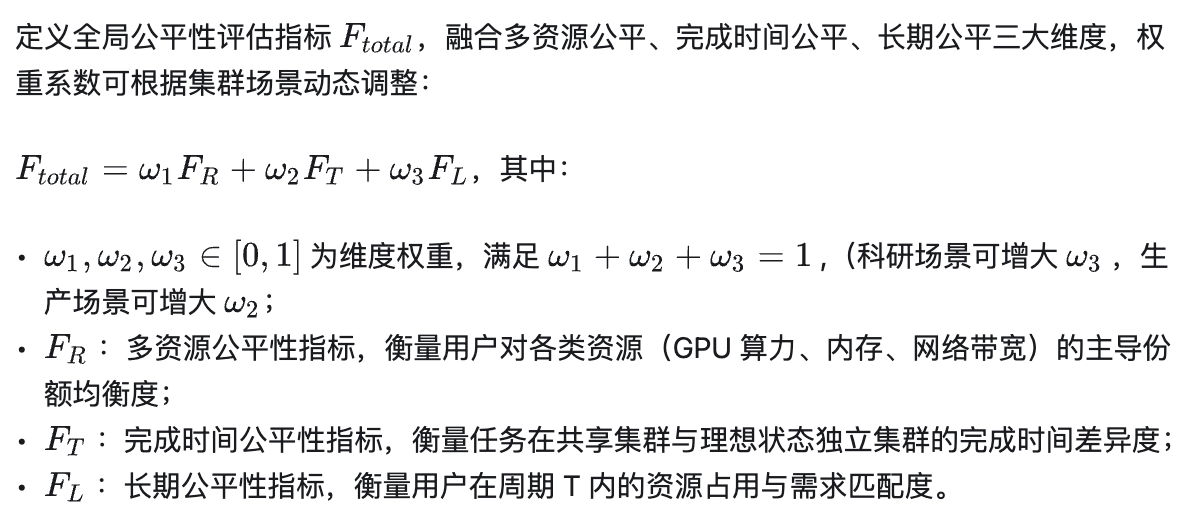
(1)多资源公平性指标
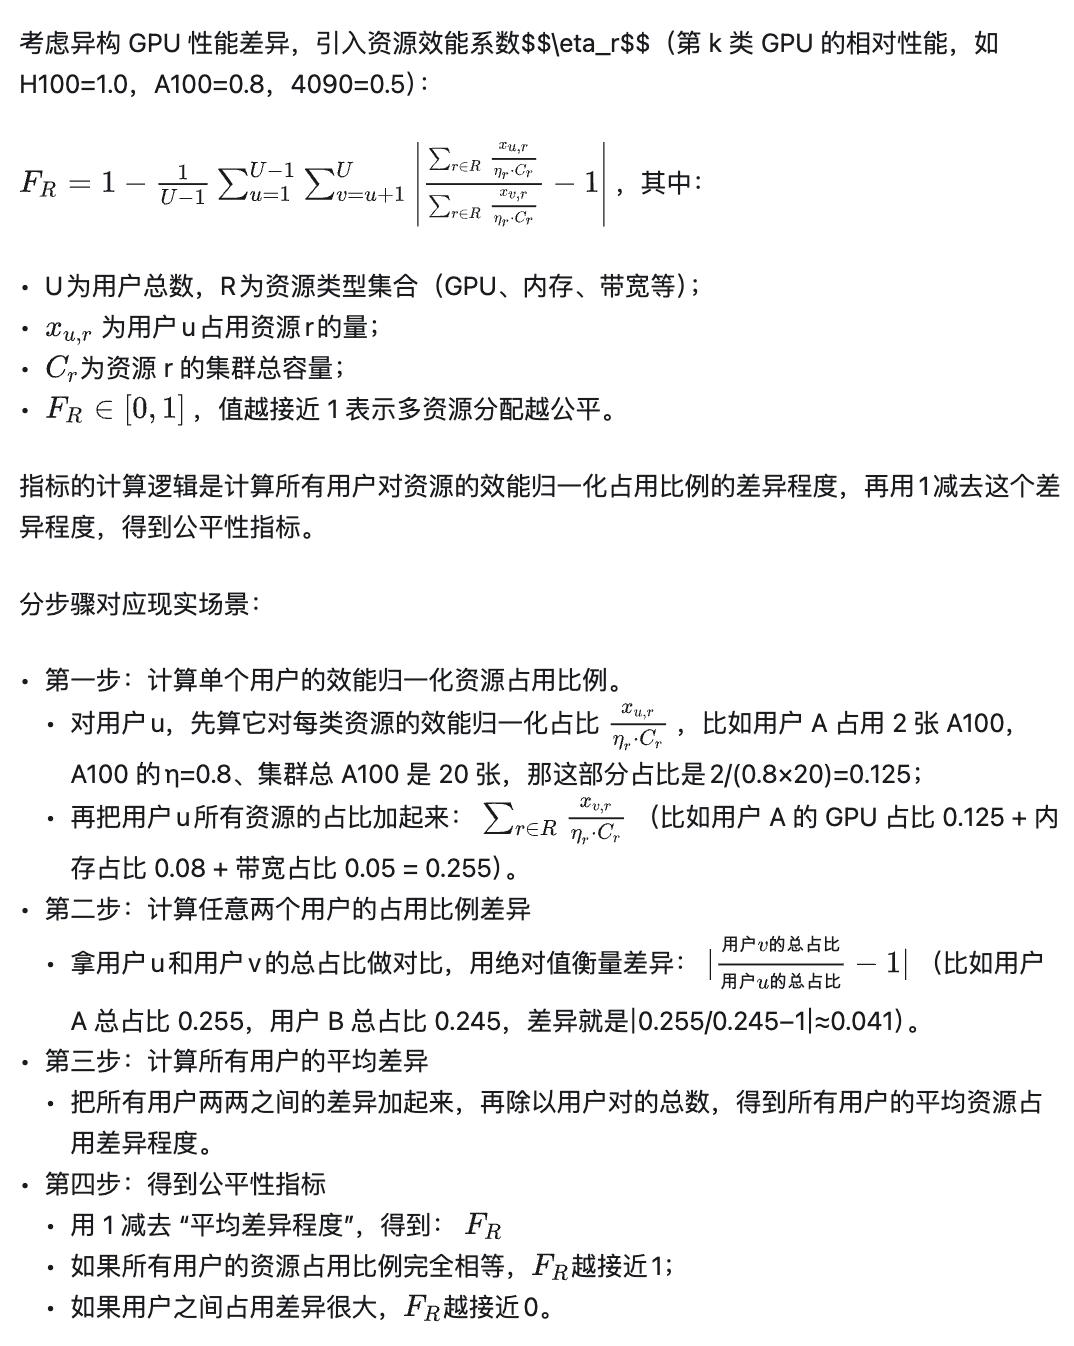
(2)完成时间公平性指标
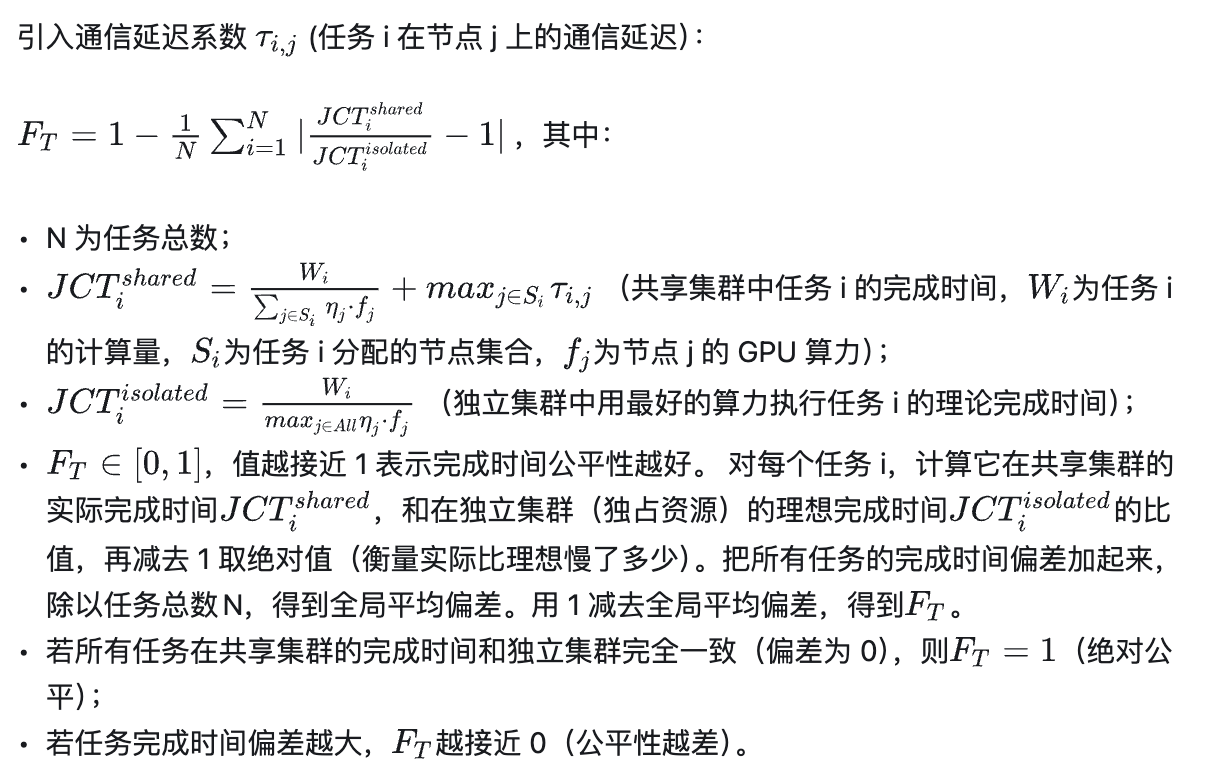
(3)长期公平性指标
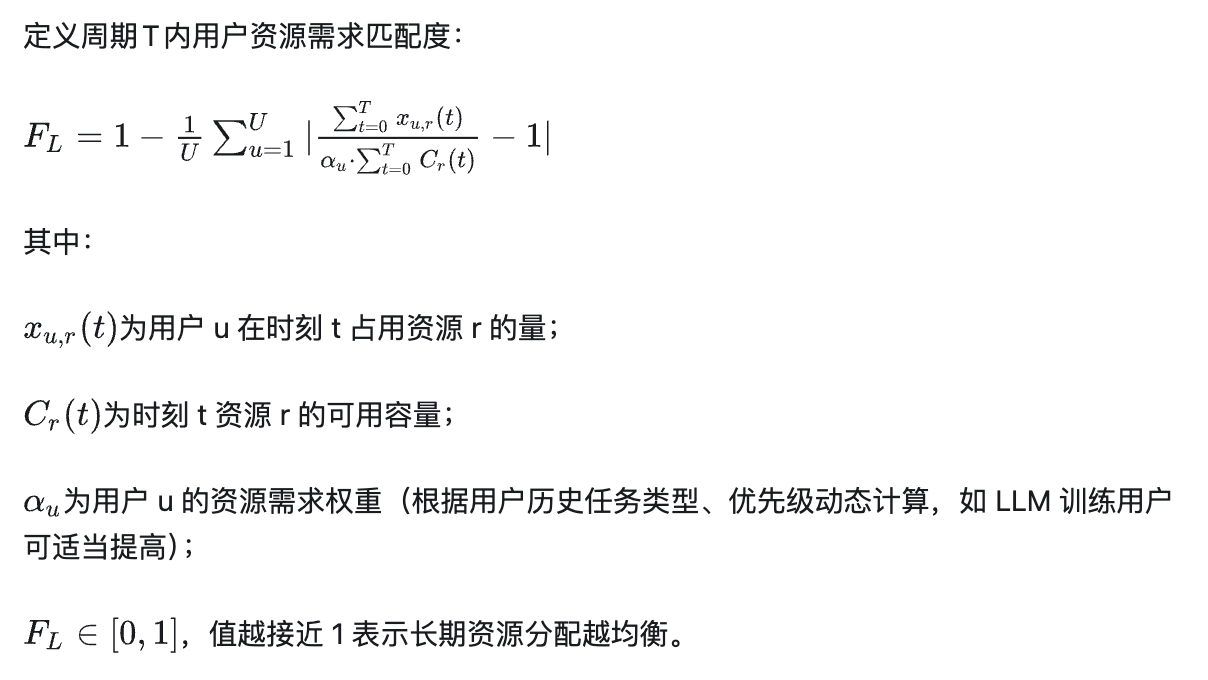
3.1.2 约束条件设计
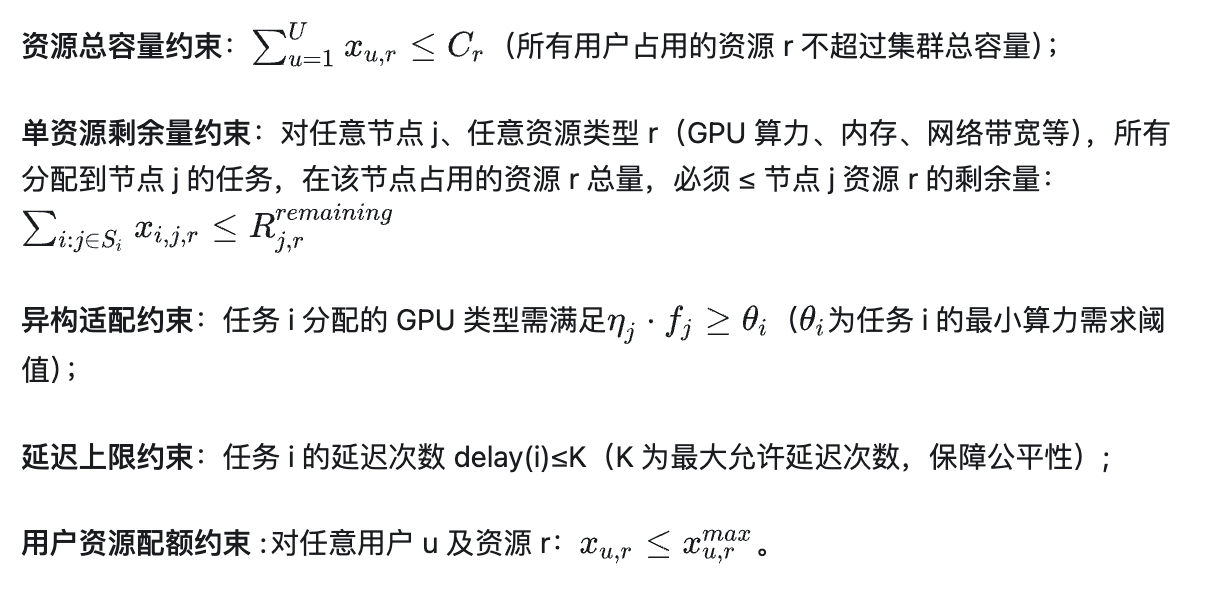
3.2 分层动态优化调度算法
3.2.1 算法框架
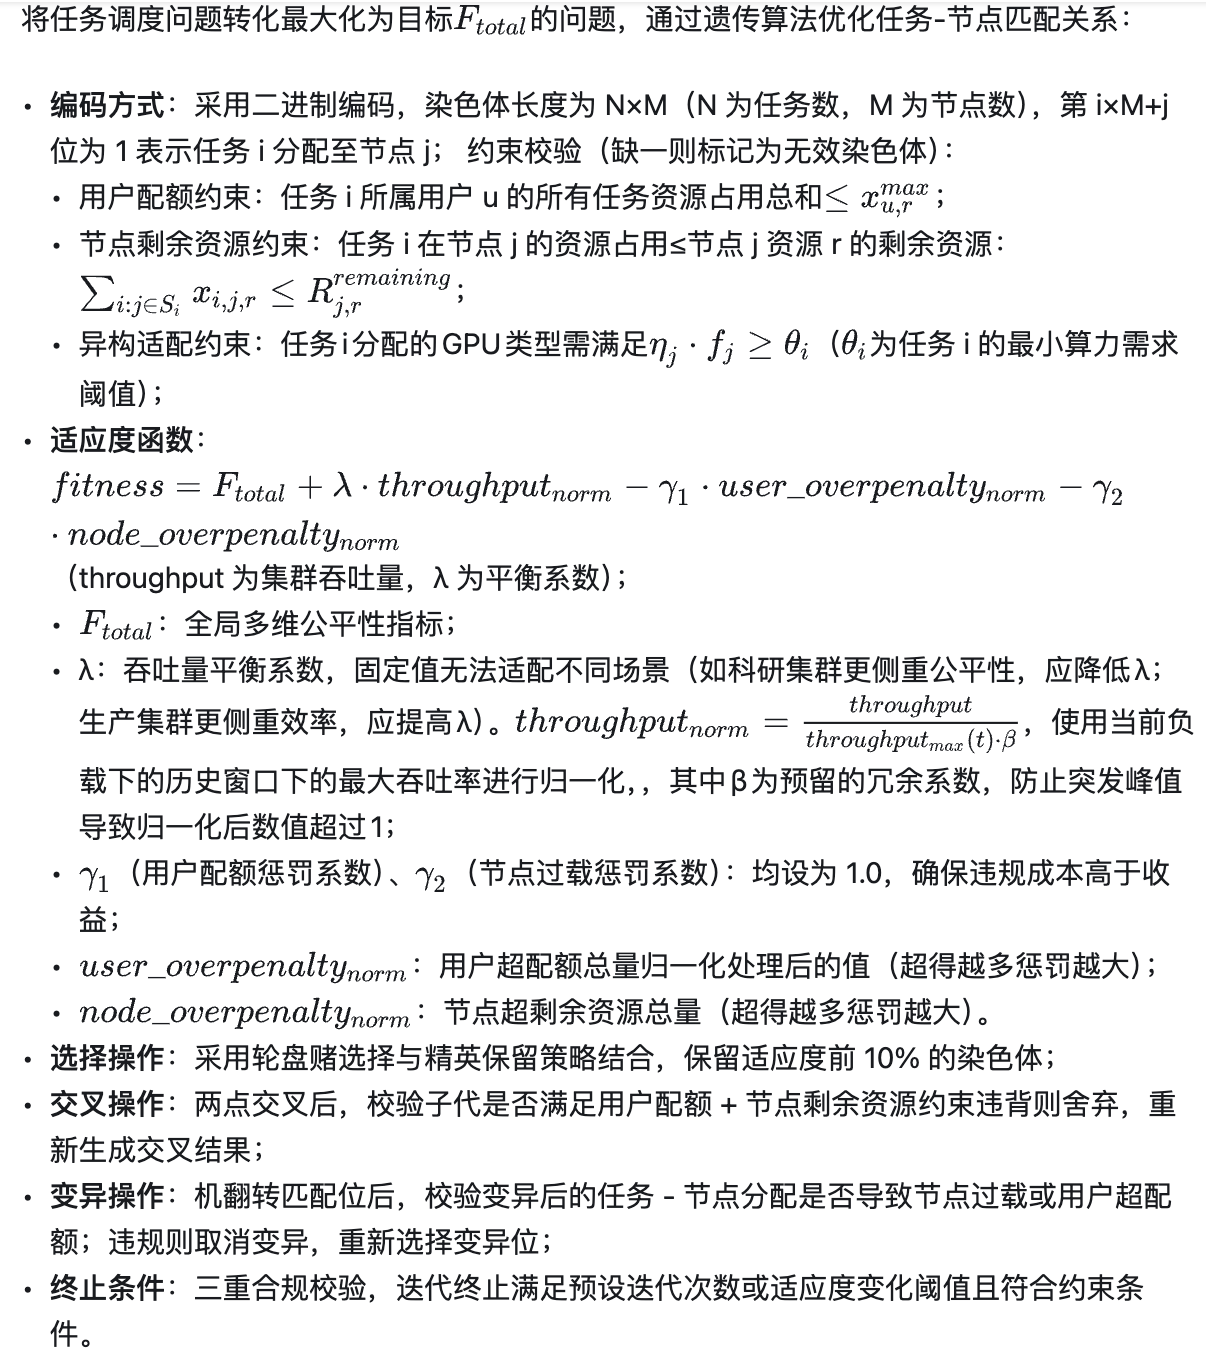
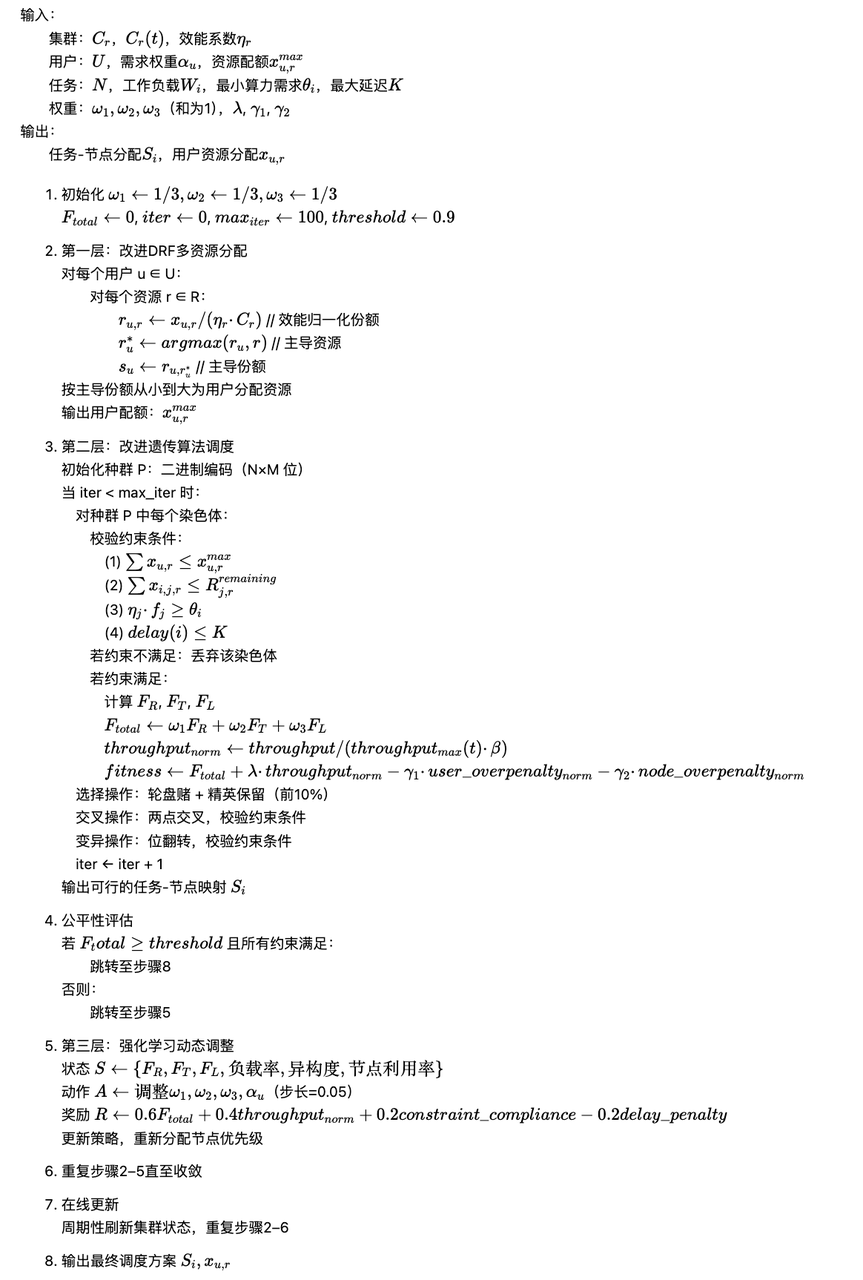
采用三层优化 + 动态迭代架构,分别对应资源分配、任务调度、公平性调整三个核心环节,通过迭代优化实现全局公平性最优。在第一层 DRF,我们快速给出公平初始配额,保证基础公平。在第二层使用遗传算法,全局搜索调度方案,处理约束与多目标。在第三层通过强化学习,在线自适应,应对规模化、动态性、异构性。算法整体框架和流程概况如下:
                        +---------------------------+
                        |     集群状态感知模块      |
                        | 资源/负载/异构度/利用率   |
                        +-----------+---------------+
                                    |
                                    v
+----------------+  <-- 迭代优化 -- +---------------------------+
| 动态公平性调整 |                  |  第一层:改进DRF多资源分配  |
|  (强化学习)  |                  | 效能归一化→主导份额→用户配额 |
+-------+--------+                  +---------------+-----------+
        |                                             |
        |                                             v
        |                     +---------------------------+
        +-------------------->|  第二层:改进遗传算法调度  |
                              | 任务-节点映射→约束校验→适应度 |
                              +---------------+-----------+
                                              |
                                              v
                              +---------------------------+
                              |     公平性与收敛判断       |
                              |  F_total ≥ 阈值 且 约束满足  |
                              +---------------------------+
                                              |
                           不满足              |              满足
                              +---------------+---------------+
                                              |
                                              v
                              +---------------------------+
                              |     输出最优调度方案       |
                              |  任务-节点分配 / 资源配额   |
                              +---------------------------+
3.2.2 第一层:多资源主导份额计算(基于改进 DRF 算法)
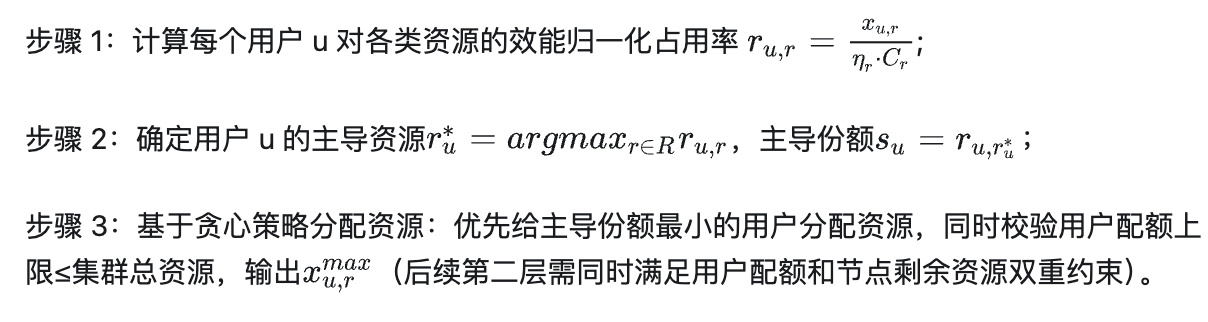
3.2.3 第二层:任务调度优化(基于改进遗传算法)
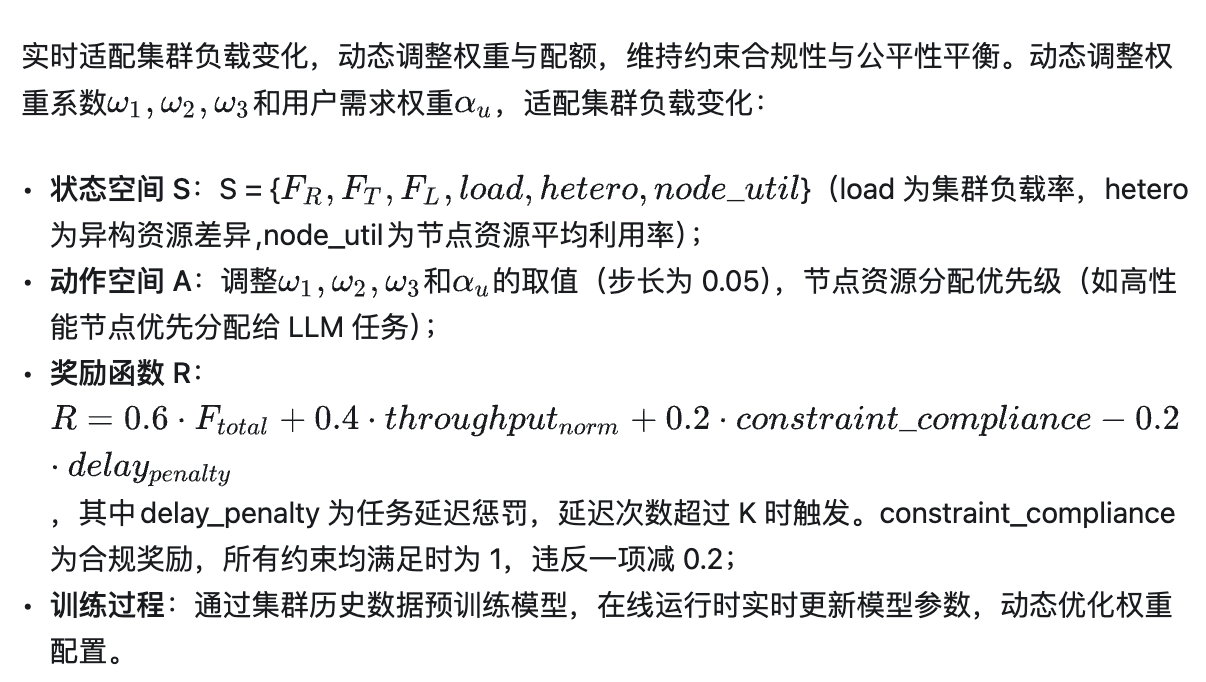
3.2.4 第三层:动态公平性调整
3.2.5 完整的算法伪代码
3.3 方案总结
3.3.1 核心设计亮点
-
多维公平性建模:首次将多资源、完成时间、长期公平三大维度融合为统一目标函数,通过权重动态调整适配不同场景,解决传统方案 单一维度偏科问题;
-
异构资源适配:引入资源效能系数,量化不同 GPU 的性能差异,使公平性评估更贴合实际异构集群环境;
-
智能优化融合:结合改进 DRF、遗传算法、强化学习,形成静态分配 + 动态优化的分层架构,既保证初始分配的公平性,又能实时适配集群负载变化;
-
数学严谨性与实用性平衡:模型兼顾学术严谨性(含多目标优化、概率统计)与工程可实现性,核心算法时间复杂度为 O(NMlogN),可满足大规模 GPU 集群(万卡级节点)的实时调度需求。
3.3.2 效果评测与分析
为验证 MDE-Fair 调度方案的实际性能,基于万卡级节点GPU集群开展实测,测试负载融合DL/LLM 训练任务、科学仿真任务、在线推理服务,模拟多租户真实混合负载场景进行离线对比测试。
-
全局公平性:MDE-Fair 在实测与离线测试中全局公平性评估指标均值稳定在0.91左右;
-
集群吞吐量与资源利用率:在多租户混合负载下,集群调度层面资源利用率95%+,提升11%,实现公平性提升的同时效率无显著损失;通过公平性提升有效调度算力资源实现节省48,483 GPU卡时,平均调度等待耗时下降80%。
-
任务完成效率:短任务(计算量 <10TFLOPS)平均JCT缩短28.7%,避免短任务被长任务垄断资源;长任务(LLM 训练,计算量> 1000TFLOPS)调度实现秒级调度;
3.3.3 与业界方案对比
| 调度方案 | 核心公平性维度 | 异构资源适配能力 | 动态负载适配能力 |
| MDE-Fair(本文方案) | 多资源 + 完成时间 + 长期(三维融合,权重可调) | 强,引入效能系数ηk量化 GPU 性能差异 | 强,强化学习动态调整权重 / 配额,适配负载突变 / 节点故障 |
| DRF | 单一多资源公平 | 无,视所有资源为同构 | 无,静态贪心分配 |
| Astraea(LTGF) | 单一长期时间公平 | 弱,基础 GPU 类型区分,无量纲化 | 弱,固定时间窗口静态调整优先级 |
| Themis | 单一完成时间公平 | 无,未考虑 GPU 性能差异 | 中,多轮拍卖机制动态调资源 |
| CASSINI | 单一完成时间公平(网络感知) | 弱,基础异构算力适配 | 中,通信模式感知动态调度 |
| AlloX | 单维度(效率 / 公平)可切换 | 弱,基础异构算力适配 | 弱,人工静态调整阈值 α |
| Shockwave | 完成时间 + 资源分配公平(市场机制) | 弱,异构资源价格差异化 | 中,供需驱动动态调整虚拟价格 |
| Delay Scheduling | 基础公平(数据本地化优先) | 无,同构资源假设 | 弱,仅限制延迟调度次数 |
| Quincy | 基础公平(最小费用流) | 无,同构资源假设 | 弱,静态费用流求解调度 |
四 参考文献
-
Tianhao Fu, Zehua Yang, Zhisheng Ye, et al., “A survey on the scheduling of DL and LLM training jobs in GPU clusters,” Chinese Journal of Electronics, vol. 34, no. 3, pp. 881–905, 2025. DOI: 10.23919/cje.2024.00.070
-
M. Zaharia, D. Borthakur, J. S. Sarma, et al., “Delay scheduling: A simple technique for achieving locality and fairness in cluster scheduling,” in Proceedings of the 5th European Conference on Computer Systems, Paris, France, pp. 265–278, 2010.
-
A. Ghodsi, M. Zaharia, B. Hindman, et al., “Dominant resource fairness: Fair allocation of multiple resource types,” in Proceedings of the 8th USENIX Symposium on Networked Systems Design and Implementation, Boston, MA, USA, pp. 323–336, 2011.
-
K. Mahajan, A. Balasubramanian, A. Singhvi, et al., “Themis: Fair and efficient GPU cluster scheduling,” in Proceedings of the 17th USENIX Symposium on Networked Systems Design and Implementation, Santa Clara, CA, USA, pp. 289–304, 2020.
-
S. Chaudhary, R. Ramjee, M. Sivathanu, et al., “Balancing efficiency and fairness in heterogeneous GPU clusters for deep learning,” in Proceedings of the 15th European Conference on Computer Systems, Heraklion, Greece, article no. 1, 2020.
-
T. N. Le, X. Sun, M. Chowdhury, et al., “AlloX: Compute allocation in hybrid clusters,” in Proceedings of the 15th European Conference on Computer Systems, Heraklion, Greece, article no. 31, 2020.
-
Z. S. Ye, P. Sun, W. Gao, et al., “ASTRAEA: A fair deep learning scheduler for multi-tenant GPU clusters,” IEEE Transactions on Parallel and Distributed Systems, vol. 33, no. 11, pp. 2781–2793, 2022. DOI: 10.1109/TPDS.2021.3136245
-
S. J. Subramanya, D. Arfeen, S. X. Lin, et al., “Sia: Heterogeneity-aware, goodput-optimized ML-cluster scheduling,” in Proceedings of the 29th Symposium on Operating Systems Principles, Koblenz, Germany, pp. 642–657, 2023.
-
P. F. Zheng, R. Pan, T. Khan, et al., “Shockwave: Fair and efficient cluster scheduling for dynamic adaptation in machine learning,” in Proceedings of the 20th USENIX Symposium on Networked Systems Design and Implementation, Boston, MA, USA, pp. 703–723, 2023.
-
S. Rajasekaran, M. Ghobadi, and A. Akella, “CASSINI: Network-aware job scheduling in machine learning clusters,” in Proceedings of the 21st USENIX Symposium on Networked Systems Design and Implementation, Santa Clara, CA, USA, pp. 1403–1420, 2024.

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 8
 0
- 0


 已为社区贡献1条内容

所有评论(0)