小白从零开始勇闯人工智能:bert自然语言框架(1)
引言
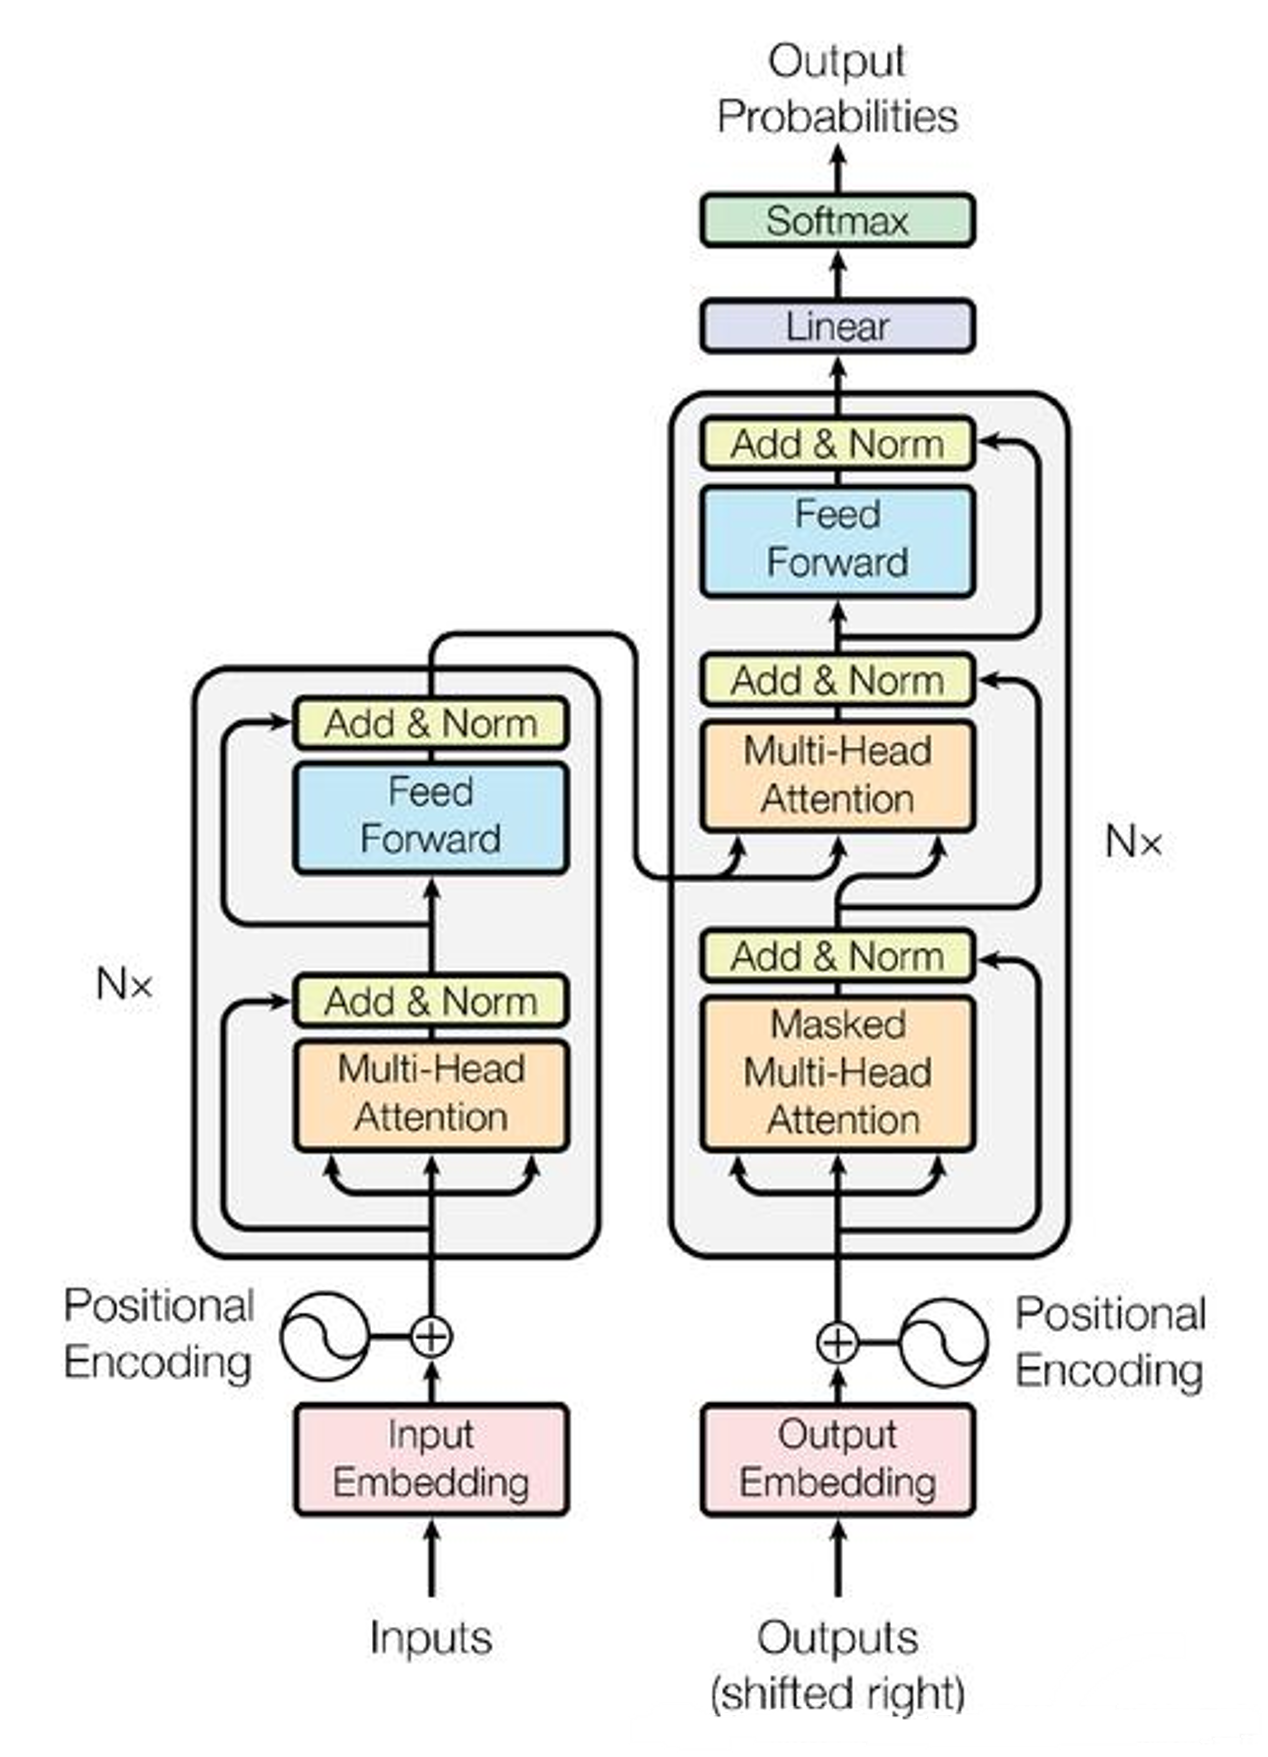
BERT是Google在2018年提出的自然语言处理预训练模型。其基础框架完全基于Transformer架构中的编码器部分。BERT的核心在于采用深度双向训练机制,通过在预训练阶段联合利用左右两侧的上下文信息来生成深度的双向语言表征。BERT通过两个预训练任务完成训练:掩码语言模型随机掩盖部分输入词并让模型根据上下文进行预测,以及下一句预测判断两个句子间的逻辑关系。
一、BERT是什么?
1、模型结构
BERT模型的核心架构来源于Transformer的编码器部分。Transformer最初采用编码器-解码器设计,但BERT仅保留了编码器,并通过堆叠多个编码器层来构建深层网络。在每个编码器层中,包含两个关键组件:多头自注意力机制和前馈神经网络。多头自注意力机制允许模型在处理每个词时,同时关注句子中的所有其他词,从而有效捕捉上下文依赖关系。随后,前馈神经网络对注意力机制的输出进行进一步变换,以提取更深的特征表示。这种结构使得BERT能够同时考虑每个词的左侧和右侧信息,实现真正的双向语言理解。
2、双向性的优点
双向性的最大优势在于,它能够结合完整的上下文来精准把握语义,尤其是处理一词多义的现象。BERT在理解某个词时,可以同时看到它前后所有的词语。举个例子来说:在“我今天要去银行存钱“中,“银行”前后出现了“存钱”,在句子 “我坐在河边的银行上看风景”中,“银行”后面跟着“看风景”。单向模型由于视野受限,可能难以区分这两种“银行”,而BERT的双向结构能同时捕捉“存钱”和“河边的”这些完整的上下文信息,从而准确判断出前者是机构,后者是河岸。
3、预训练 + 微调
BERT的训练采用“预训练 + 微调”的行式,在第一阶段的预训练中,模型在大量无标注的通用文本上进行无监督学习。它被训练去预测被遮住的词,从而在过程中学习词语、语法的知识,从而形成强大的语义理解基础。接着是第二阶段的微调。在预训练阶段掌握了语义理解的能力后,针对具体的任务,只需用少量的标注数据对模型进行小幅度的整体参数调整,就能快速的成为某个领域的适用模型。
二、为什么需要BERT?传统方法的问题
在BERT之前,我们常用RNN(循环神经网络)和word2vec处理语言,但它们有明显的缺陷。
1、RNN的困境
RNN采用顺序处理方式,必须等前一个词计算完毕才能进行下一个词的计算,就像流水线般的串行运作。这种机制带来了两个主要问题:一是训练效率低下,由于无法实现并行计算,难以利用多台服务器同时加速,二是难以捕捉长距离依赖,当句子过长时,序列前端的信息在逐步传递过程中容易衰减或丢失,导致模型无法有效关联远距离的上下文信息。
2、word2vec的局限
Word2Vec为每个词赋予一个静态且固定的向量表示,导致像“苹果”这样的多义词无论出现在“苹果很好吃”还是“苹果发布了新手机”等不同语境中,其向量始终相同,无法区分水果与公司这两种不同的含义。这种静态嵌入方式忽略了一词多义现象,难以捕捉词语随上下文变化而改变的语义。
三、BERT的基石——Transformer
Transformer是一种基于注意力机制的模型,最初用于机器翻译。
1、Encoder-Decoder框架
Encoder-Decoder框架将自然语言处理任务抽象为序列到序列的转换:编码器负责将输入序列压缩成一个蕴含整体语义的向量C,解码器则基于此向量逐步生成目标输出序列。编码器和解码器常采用RNN或LSTM等循环网络,但Transformer架构彻底抛弃了这种时序依赖,完全依靠注意力机制并行处理序列。
2、注意力机制——让模型学会“找重点”
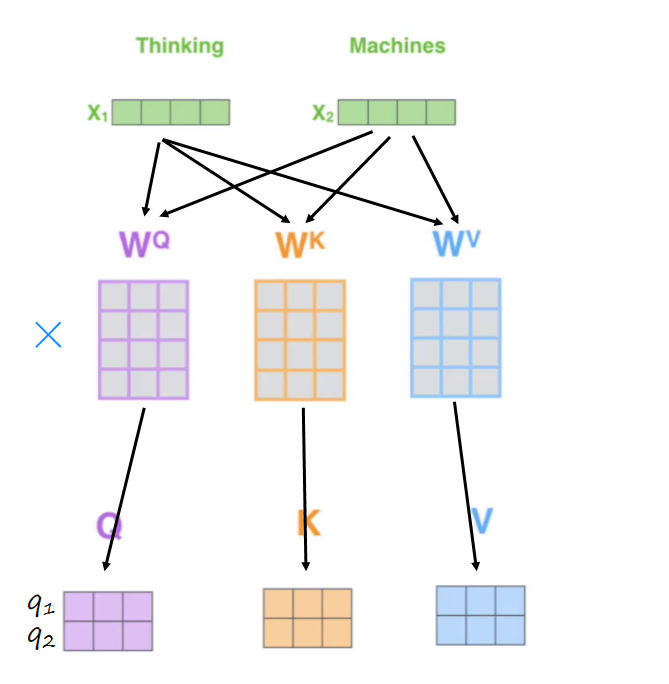
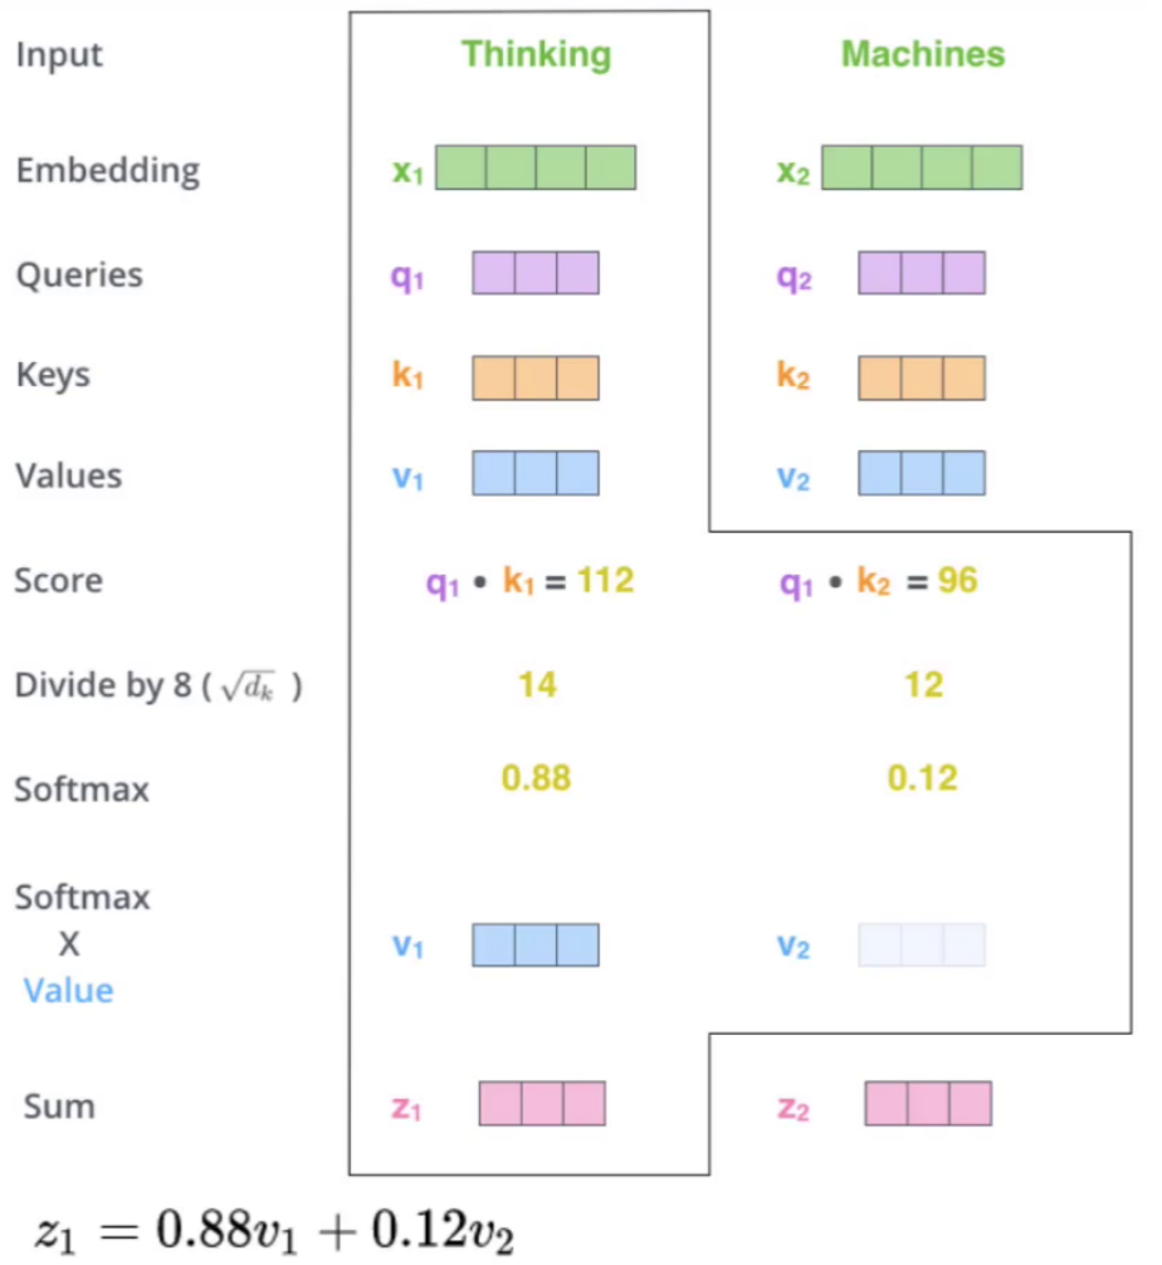
注意力机制是让模型在处理信息时能够聚焦于关键部分,类似于人类阅读时自然关注重要词语。在自然语言处理中,这一机制通过为不同位置的词分配不同的权重来实现,而Self-Attention进一步要求每个词都与序列中所有词(包括自身)计算相关性,并基于这些相关性重新构建自身的表示。以两个词“Thinking”和“Machines”为例,计算过程首先将每个词通过嵌入转化为向量,然后分别为它们乘以三个不同的权重矩阵,生成查询(Q)、键(K)和值(V)向量,其中Q用于匹配其他词,K用于被匹配,V则携带实际信息。接下来,用每个词的Q与所有词的K做点积,得到注意力得分,反映词与词之间的关联强度,这些得分经归一化(如softmax)处理后作为权重,对所有的V进行加权求和,从而得到每个词融合上下文后的新特征向量。
3、如何计算Self-Attention?
假设我们有两个词:“Thinking”和“Machines”。每个词先通过词嵌入变成向量,
,接下来:
1、生成Q、K、V:每个词乘上三个权重矩阵,
,
,得到查询向量q,键向量k,和值向量v。“Thinking”得到
,
,
,“Machines”得到
,
,
。
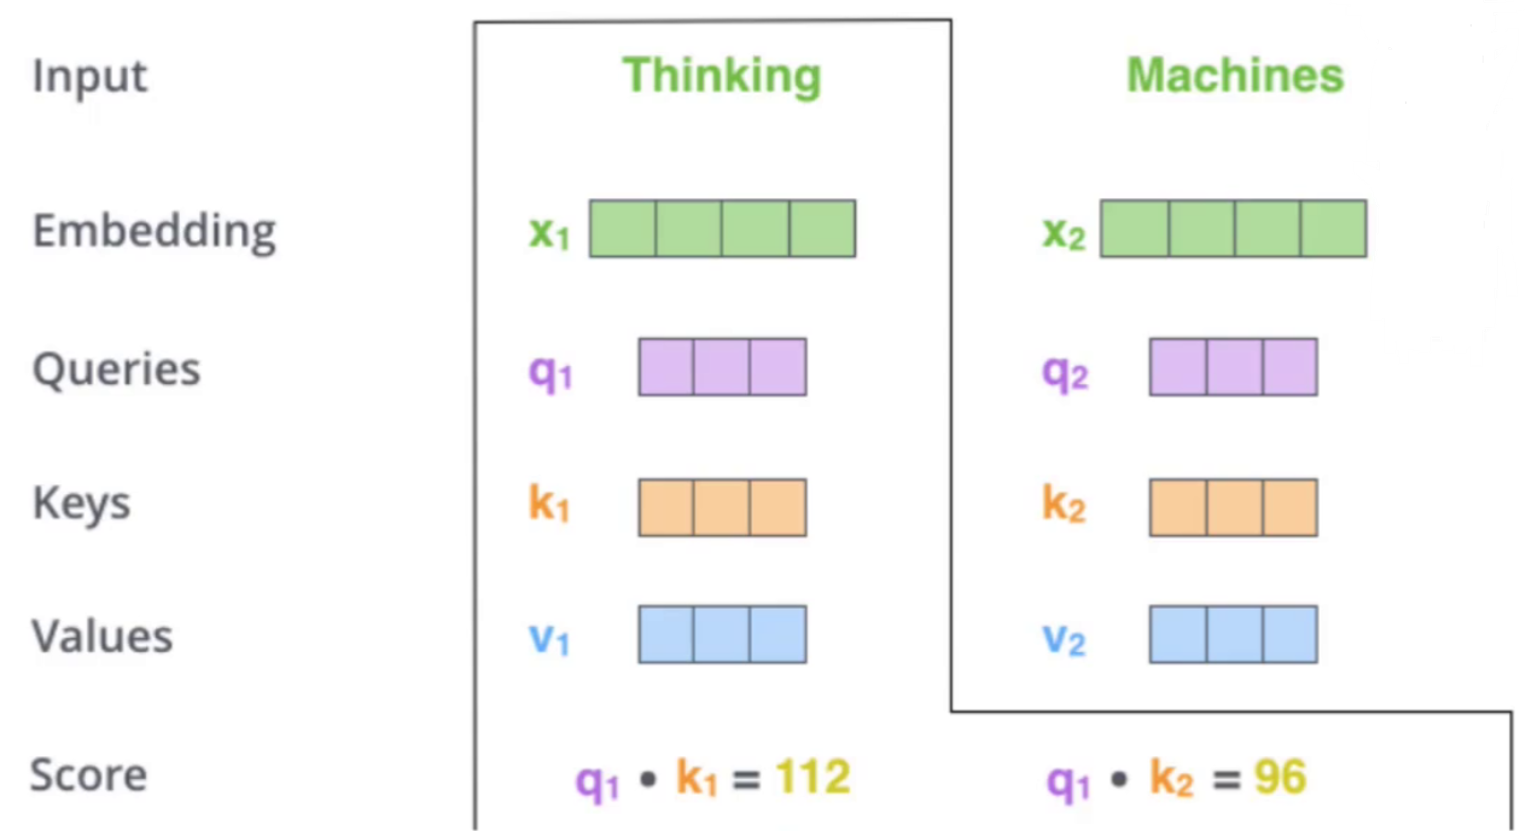
2、计算注意力得分:用每个词的q与所有词的k做点积,得到匹配程度。例如用点积
得112(自己与自己),点积
得96(与“Machines”)。得分越高,表示两个词关系越紧密。
3、缩放与归一化:为防止点积过大导致梯度消失,将得分除以(
是键向量的维度),然后通过Softmax变成权重,如 [0.55, 0.45]。
4、加权求和:用权重对所有的v加权求和,得到“Thinking”融合上下文后的新向量=0.55
+0.45
。
整个过程可以并行计算,因为所有词的Q、K、V是一次性算出来的,大大加快了速度。
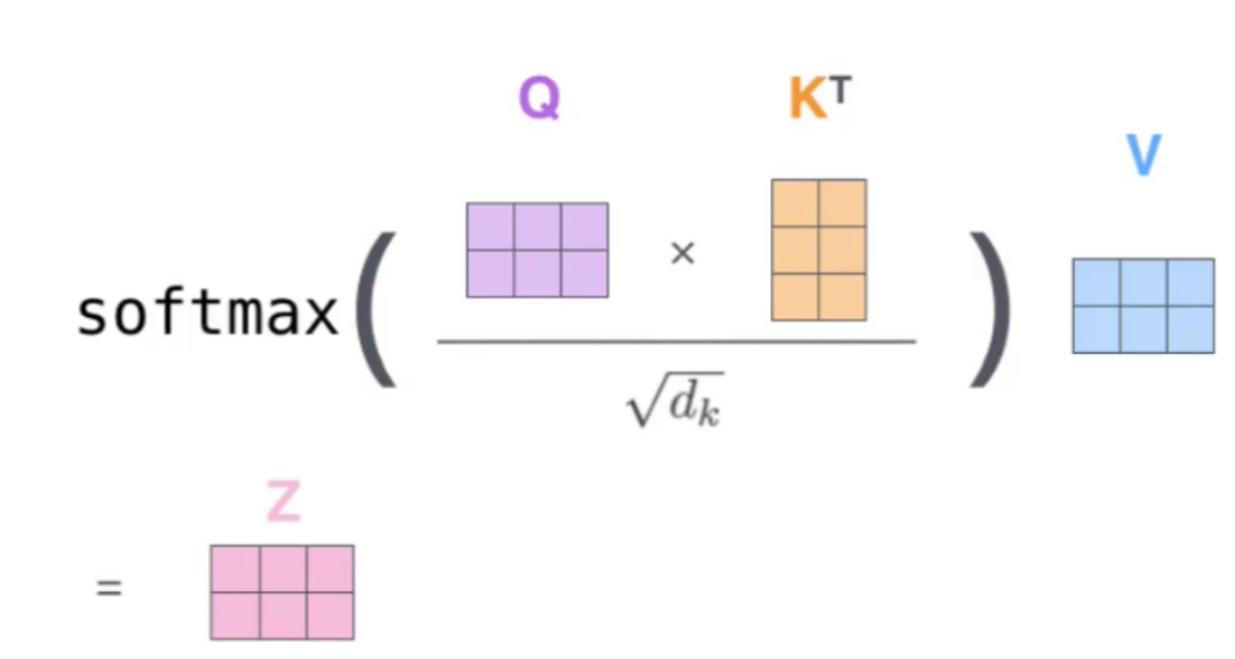
4、Multi-head Attention——多头机制
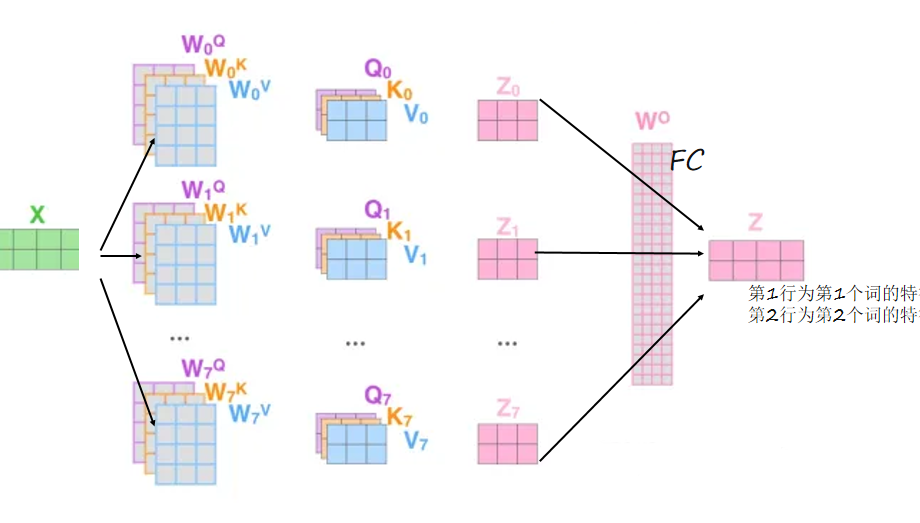
Transformer模型采用了多头注意力机制来实现多角度理解。该机制设置多组(例如8组)不同的权重矩阵,每组称为一个“注意力头”,每个头独立地对输入序列执行自注意力计算,从而得到多个不同的特征矩阵。随后,将这些包含各异语义信息的矩阵拼接起来,并通过一个全连接层进行线性变换以压缩维度,形成最终的输出表示。
5、多层堆叠
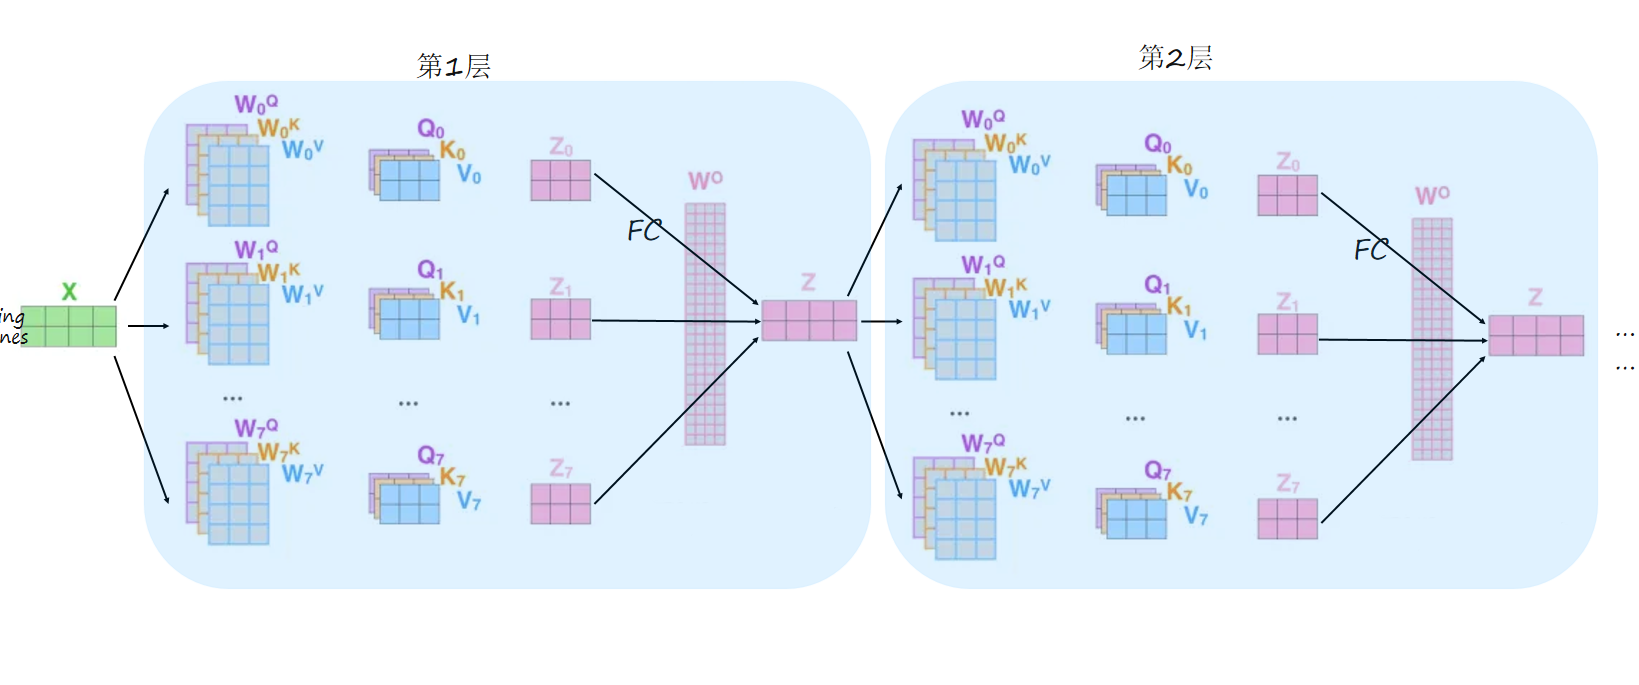
多层堆叠的设计是Transformer模型能够捕捉复杂语言规律的关键。多个相同的编码器层首尾相连,每一层的输出都成为下一层的输入,使得信息能够层层递进。在浅层(如第一、二层),模型可能更关注短语级别的语法特征,随着层数增加,深层网络能够捕捉到更复杂的语义关系

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 9
 0
- 0


 已为社区贡献1条内容

所有评论(0)