MAESTRO:自动驾驶多任务 3D 感知 SOTA 框架,彻底解决 MTL 任务冲突痛点
本文深度拆解 2025 年最新顶会级论文《MAESTRO: Task-Relevant Optimization via Adaptive Feature Enhancement and Suppression for Multi-task 3D Perception》,来自汉阳大学与首尔国立大学的研究团队,直击自动驾驶多任务学习的核心痛点,在 nuScenes/Occ3D 基准上实现 3D 目标检测、BEV 地图分割、3D 占用预测三大核心任务的全面 SOTA,甚至超越单任务精调模型,同时兼顾实时推理效率。
论文:https://arxiv.org/abs/2509.17462
一、前言
在自动驾驶领域中,感知模块是车辆理解周围环境的眼睛,需要同时完成三大核心任务:3D目标检测(识别动态障碍物)、BEV鸟瞰图地图分割(提取静态道路结构)、3D占用预测(构建场景稠密语义表征)。
| 感知任务 | 核心关注目标 | 语义偏好 |
|---|---|---|
| 3D 目标检测 | 车辆、行人、骑行者等动态障碍物 | 聚焦前景动态目标 |
| BEV 地图分割 | 车道线、可行驶区域、人行道、道路边界等 | 聚焦背景静态结构 |
| 3D 占用预测 | 全场景体素的占用状态与语义标签 | 需同时兼顾前景与背景 |
长期以来,该领域遇到的难题:
1、为单个任务啊训练单任务模型,精度高但计算成本高;
2、用共享骨干的多任务学习(MTL)方案压缩计算量,会因为任务冲突和特征干扰出现性能下降。
本文提出的MAESTRO框架,通过三大核心模块,实现了「共享特征→任务专属特征提纯→跨任务协同增益」的效果,在仅比朴素多任务基线增加 30.7ms 延迟的前提下,实现了全任务性能超越单任务 SOTA 模型,为自动驾驶统一感知系统的落地提供了全新的解决方案。
二、MAESTRO 框架整体概览
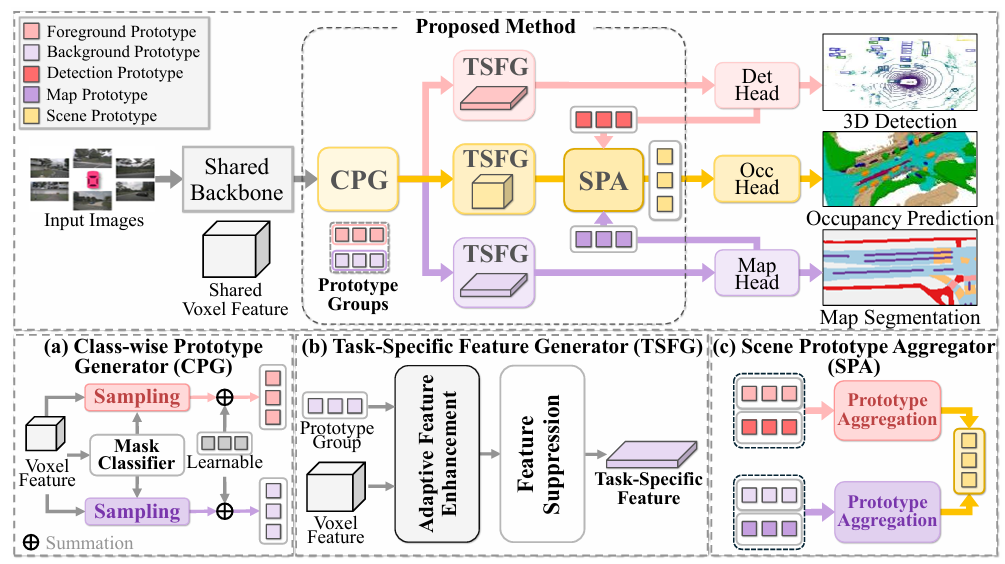
图 3: MAESTRO的整体架构。 多视角图像由共享主干处理,以生成结构化的3D体素表示。 CPG生成前景和背景原型组,指导TSFG完善用于3D目标检测、BEV地图分割和3D占用预测的任务相关特征。 然后,从3D目标检测和BEV地图分割头导出的面向任务的原型通过SPA与原型组集成,形成场景原型。 这些场景原型随后由占用解码器处理,以产生最终的3D占用预测。
MAESTRO 的全称是Multi-task Adaptive Feature Enhancement and Suppression for Task-Relevant Optimization,整体架构遵循「共享特征提取→任务专属特征生成→跨任务协同优化」的核心逻辑,完整 pipeline 如下:
-
输入与共享特征提取:多视角相机图像输入,通过共享骨干网络提取 2D 特征,再通过经典的 LSS方法升维,生成 3D 体素共享特征,作为后续所有模块的输入。
-
三大核心模块协同处理:
-
CPG(类级别原型生成器):对语义类别做前后景分组,生成组级特征原型,为不同任务分配语义对齐的原型先验;
-
TSFG(任务特定特征生成器):基于 CPG 的原型先验,对共享特征做「自适应增强 + 无关抑制」,为每个任务生成专属的提纯特征;
-
SPA(场景原型聚合器):挖掘检测与分割任务的互补信息,生成场景原型,无损提升 3D 占用预测的性能。
-
-
任务头输出结果:提纯后的任务专属特征,分别输入 3D 检测头、BEV 分割头、3D 占用预测头,输出最终的感知结果。
优势:既保留了多任务学习的计算效率优势,又通过「原型引导的特征筛选」消除了任务间的特征干扰,并通过跨任务信息融合实现了协同增益,最终实现全任务性能超越单任务模型。
三、核心模块解读
3.1 CPG:类级别原型生成器,构建任务语义先验
意义:传统共享特征缺乏清晰的语义分离度,无法为不同任务提供精准的语义指导。
CPG的输入为:共享骨干网络 + LSS(Lift-Splat-Shoot)模块生成的 3D 体素共享特征,论文中定义为:
CPG 的核心思路,是先对全量语义类别做「前后景分组」,再生成组级的特征原型,作为后续特征筛选的语义先验,核心流程分为 4 步:
语义类别分组:将所有语义类别划分为前景组和背景组。前景组包含车辆、卡车、行人、骑行者等动态目标;背景组包含可行驶区域、人行道、建筑、植被等静态结构。
类别掩码生成:通过轻量级掩码分类器,对共享体素特征计算每个体素的语义置信度,为每个类别生成二值体素掩码,公式如下:
- 在执行上述公式前,CPG 会通过一个轻量级掩码分类器,对输入的共享体素特征Fs做体素级语义分类,输出语义置信度张量:
-
Sv(i,j,l)代表坐标为(i,j,l)的体素,对应K个类别的置信度分数向量,每个元素是该体素属于对应类别的预测置信度。
-
这个公式用一句话概括:为每个类别k生成一个二值掩码,掩码中只有被分类为类别k的体素位置为 1,其余所有位置均为 0。
类别级特征原型生成:基于步上步生成的类别掩码,CPG 会为每个语义类别计算专属的特征原型,作为该类别的语义中心表征。
组级原型生成与任务专属分配:这一步是输出环节,将单个类别原型聚合为前景 / 背景两组原型,并为三大感知任务分配语义对齐的原型组。
| 感知任务 | 分配的原型组 | 分配逻辑 |
|---|---|---|
| 3D 目标检测 | GDet=PFG | 检测任务仅关注动态前景目标,仅分配前景原型组 |
| BEV 地图分割 | GMap=PBG | 分割任务仅关注静态背景结构,仅分配背景原型组 |
| 3D 占用预测 | GOcc=PFG∪PBG | 占用预测需要建模全场景语义,同时分配前景 + 背景原型组 |
3.2 TSFG:任务特定特征生成器,增强有用特征、抑制干扰信号
共享特征中同时包含任务相关和无关的信息,传统方法无法精准筛选,导致特征干扰、任务冲突。
TSFG 是 MAESTRO 的核心性能引擎,它基于 CPG 提供的任务专属原型,对共享特征做「分任务适配→相关特征增强→无关特征抑制」的三步处理,生成适配任务目标的专属特征。
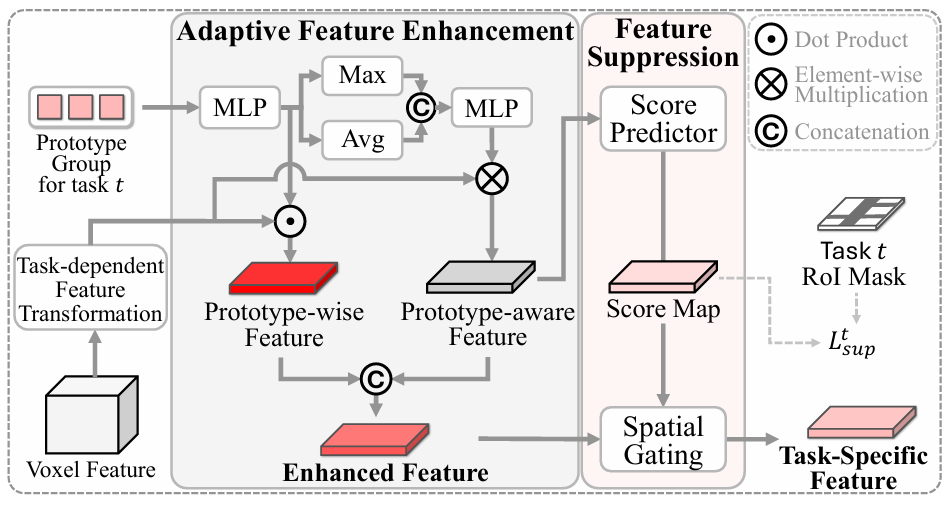
图 4: TSFG的详细结构。 TSFG 通过利用原型组来细化与任务相关的特征,然后进行特征抑制以减轻与任务无关的信息,从而为每个任务生成特定于任务的特征。
3.2.1 任务相关特征变换
首先针对不同任务的特征空间需求,做基础的特征适配:
-
对于 BEV 导向的 3D 检测、BEV 分割任务:将体素特征的高度轴压缩到通道维度,通过 2D 卷积生成 BEV 特征,适配 2D 鸟瞰图的任务需求;
-
对于体素导向的 3D 占用预测任务:通过 3D 卷积处理原始体素特征,保留 3D 空间信息,适配体素级预测需求。
3.2.2 自适应特征增强
这一步的核心是「放大任务相关的特征信号」,通过双路径实现全方位的特征增强:
-
原型级空间增强:将任务原型与变换后的特征做点积,生成原型级特征,激活与任务原型语义对齐的空间区域。比如给检测任务的前景原型,就会精准激活图像中车辆、行人的区域,抑制背景区域。
-
原型感知通道增强:对任务原型做全局池化 + MLP,生成通道缩放向量,通过通道注意力机制,对和任务相关的特征通道做权重放大,无关通道做权重抑制。
-
Cat[ ]:通道维度的拼接操作,将原型级特征与原型感知特征在通道维度合并,融合空间与通道的双重增强信息;
3.2.3 特征抑制
这步的核心是「过滤掉任务无关的干扰特征」:
-
基于原型感知特征,通过轻量级 CNN 生成抑制分数图,以真值监督训练,让分数在任务感兴趣区域(RoI)趋近于 1,其余区域趋近于 0;
-
通过门控操作,将抑制分数图与增强特征做逐元素相乘,直接过滤掉任务无关区域的特征,最终输出纯净的任务专属特征。
举个例子,对于 BEV 分割任务,抑制分数图会在可行驶区域、车道线等区域为 1,在车辆、行人等前景区域为 0,直接把对分割任务无用的前景特征过滤掉,彻底避免了检测任务的前景特征对分割任务的干扰。
| 任务 | RoI (感兴趣区域)定义 |
|---|---|
| 3D 目标检测 | BEV 空间中目标的真值 bounding box 区域 |
| BEV 地图分割 | BEV 空间中语义类别真值激活的区域(车道、可行驶区域等) |
| 3D 占用预测 | 3D 空间中真值标注的被占用体素区域 |
3.3 SPA:场景原型聚合器,挖掘任务间依赖实现性能增益
作用:3D 占用预测需要同时兼顾前景和背景,而 3D 检测和 BEV 分割的输出结果,恰好包含了占用预测需要的精准前景 / 背景语义信息,此前的方法完全没有利用这种任务间的互补性。
SPA 的设计非常巧妙,它不会损害检测和分割任务的性能,仅通过跨任务的原型融合,就能进一步提升 3D 占用预测的精度,核心分为两步:
3.3.1 任务导向原型生成
-
基于检测头输出的预测框,对检测任务的专属特征做 RoIAlign + 类别平均池化,提取前景目标的语义特征,生成检测原型;
-
基于分割头输出的预测掩码,对分割任务的专属特征做掩码平均池化,提取背景结构的生成分割地图原型。
3.3.2 原型聚合
本阶段的核心挑战是解决 “检测 / 分割与占用预测的标签空间异构问题”(例如:占用预测的 “drivable surface” 类别,可能对应分割任务的多个细分类别)。SPA 采用显式规则化聚合,而非简单拼接,确保融合的有效性:
聚合规则:
-
一对一语义对应:若占用预测原型组GOcc中的某个类别,与检测 / 地图原型中的某个类别存在完全语义匹配(如占用预测的 “car” 与检测原型的 “car”),则直接进行保留双方语义信息,增强特征强度;
-
多对一语义对应:若占用预测原型组GOcc中的某个类别,对应检测 / 地图原型中的多个细分类别(如占用预测的 “drivable surface” 对应分割原型的 “lane”“road” 等),则先对这些细分类别的原型做平均池化,再与占用预测的对应原型求和(避免语义冗余,保持特征维度一致)。
四、实验结果全解析
论文在自动驾驶领域权威的 nuScenes 数据集 + Occ3D 占用预测标注上开展了全面的实验,从 SOTA 对比、消融分析等多个维度,验证了 MAESTRO 的有效性。
4.1 核心实验设置
-
数据集:nuScenes 数据集,包含 1000 个驾驶场景的多视角图像与标注,其中 Occ3D 提供了密集的 3D 体素语义标注;
-
评价指标:
-
3D 目标检测:mAP(平均精度均值)、NDS(nuScenes 检测综合得分);
-
BEV 地图分割:mIoU(平均交并比);
-
3D 占用预测:体素级 mIoU;
-
-
基线对比:单任务基线(Baseline-STL)、朴素多任务基线(Baseline-MTL)、业界主流 SOTA 单 / 多任务模型。
4.2 与 SOTA 方法的性能对比
| 模型 | 3D 检测 (mAP/NDS) | BEV 分割 (mIoU) | 3D 占用预测 (mIoU) | 推理延迟 (ms) |
|---|---|---|---|---|
| 单任务 SOTA | 35.2/42.5 (DualBEV) | 48.3 (DifFUSER) | 37.4 (FB-Occ) | - |
| Baseline-STL | 33.8/41.7 | 47.5 | 36.5 | 405.9 |
| Baseline-MTL | 32.7/38.2 | 43.5 | 36.0 | 219.6 |
| MAESTRO (Ours) | 36.4/43.2 | 51.3 | 38.6 | 250.3 |
核心亮点结论:
-
全面超越朴素 MTL 基线:3D 检测 NDS 提升 5.0、BEV 分割 mIoU 提升 7.8、3D 占用预测 mIoU 提升 2.6,彻底解决了传统多任务学习的性能下降问题;
-
超越单任务 SOTA 模型:在三大任务上均超过了各自领域的单任务 SOTA 模型,实现了多任务学习的「反超」,这是此前绝大多数多任务方案都无法做到的;
-
极致的效率平衡:仅比朴素 MTL 基线增加 30.7ms 延迟,相比单任务基线延迟降低了 155.6ms,完美平衡了精度与实时性,完全满足车端部署的要求。
4.3 消融实验:验证每个模块的核心价值
| CPG | TSFG(全任务) | SPA | 3D 检测 NDS | BEV 分割 mIoU | 3D 占用预测 mIoU |
|---|---|---|---|---|---|
| ❌ | ❌ | ❌ | 38.2 | 40.4 | 33.6 |
| ✅ | ❌ | ❌ | 38.2 | 40.3 | 34.6 |
| ✅ | ✅ | ❌ | 39.4 | 44.1 | 35.9 |
| ✅ | ✅ | ✅ | 39.4 | 44.1 | 36.9 |
关键结论:
-
CPG 模块为占用预测带来 1.0% mIoU 提升,为后续特征处理提供了精准的语义先验;
-
全任务 TSFG 模块带来了全维度的性能跃升:检测 NDS+1.2、分割 mIoU+3.8、占用 mIoU+1.3,是解决特征干扰的核心;
-
SPA 模块进一步为占用预测带来 1.0% mIoU 提升,且不影响其他任务,验证了跨任务协同优化的有效性。
五、改进思考
5.1 改进点
单向协同,多任务潜力未充分挖掘:SPA 模块仅实现了检测、分割对占用预测的单向信息赋能,未构建多任务间的双向闭环协同,无法通过占用预测输出的 3D 全局几何信息,反向优化检测的深度估计精度与分割的边界语义完整性,多任务的协同增益存在明显天花板。
5.2 改进思路
双向闭环多任务协同架构:在 SPA 模块基础上新增反向特征增强分支,将占用预测输出的 3D 体素几何与全局语义信息,反向注入检测、分割任务的 TSFG 模块,用 3D 全局几何先验优化检测的深度分布估计,用全场景语义先验修正分割的边界预测误差,实现三大任务的双向协同增益。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 16
 0
- 0


 已为社区贡献2条内容

所有评论(0)