【自然语言处理实战:基于 TF-IDF 的关键词提取】
目录
三、Python 实战:基于 sklearn 实现 TF-IDF 关键词提取
在自然语言处理(NLP)的文本数据分析场景中,关键词提取是核心基础任务之一,它能帮我们快速抓取文本核心信息、过滤无效内容。本文将从理论基础出发,结合 Python 实战代码,详细讲解如何基于TF-IDF 算法实现中文文本的关键词提取,涵盖语料库构建、TF-IDF 原理、代码实现全流程。
一、关键词提取核心流程
想要高效完成关键词提取,需遵循标准化的步骤,从数据准备到最终的加权分析,每一步都是后续结果准确的基础,整体流程分为 5 步:
- 数据收集:收集研究所需的文本数据,建立对应的语料库;
- 数据准备:导入分词库、停用词库,为文本分词做预处理;
- 模型建立:使用分词工具对语料库进行分词处理;
- 模型结果统计:根据分词结果做词频统计,也可绘制词云图直观展示高频词;
- TF-IDF 分析:通过算法计算词的加权值,按权重提取核心关键词。
二、核心概念解析
在动手实现前,需先理解关键词提取中的关键概念,这是读懂代码、优化结果的前提。
1. 语料库
语料库是承载语言知识的基础资源,核心特点有三:
- 存放语言实际使用中真实出现的语言材料;
- 以电子计算机为载体实现数据存储与处理;
- 原始真实语料需经过分析、处理等加工步骤,才能成为可用的分析资源。
简单来说,我们要分析的所有文本集合,就是本次任务的语料库,构建方式也很简单:将需要分析的文档读入计算机内存,通过 Python 即可快速构建。
2. 中文分词与停用词
中文文本不像英文有天然的空格分隔,因此分词是中文 NLP 的必经步骤,而停用词过滤能剔除无意义词汇,提升分析效率。
- 分词库:用于实现中文词汇的切分,本文实战中使用
sklearn的 TF-IDF 工具内置分词能力,也可结合 jieba 分词做更精细化的中文切分; - 停用词:无实际语义的词汇,如 “的、了、呀、呢” 等,这类词出现频率高但对文本核心含义无贡献,需在分析前过滤;
- jieba 库:经典的 Python 中文分词库,可实现对中文文本的精准切分,支持自定义词组补充,解决内置词组缺失问题。
3. TF-IDF 算法:关键词的加权核心
TF-IDF 是提取文章关键词的经典算法,核心思想是过滤常见词,保留重要词,通过 ** 词频(TF)和逆文档频率(IDF)** 的乘积,为每个词汇计算加权值,权重越高则该词作为关键词的优先级越高。
(1)词频(TF)
某一个给定的词语在某一文档中出现的频率,为避免偏向长文档,会做归一化处理,公式为:
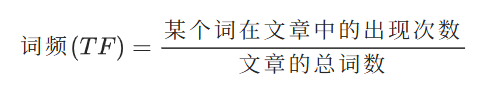
举例:《中国的蜜蜂养殖》分词后共 1000 个词,“蜜蜂” 出现 20 次,则 TF=20/1000=0.02。
(2)逆文档频率(IDF)
衡量词汇在整个语料库中的稀缺性,包含该词的文档越少,IDF 值越大,说明该词的类别区分能力越强,公式为:
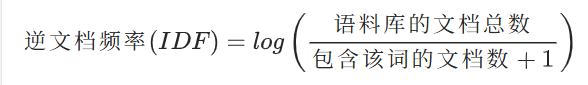
加 1 是为了避免分母为 0 的情况。
(3)TF-IDF 值
由 TF 和 IDF 相乘得到,是词汇作为关键词的最终权重,公式为:
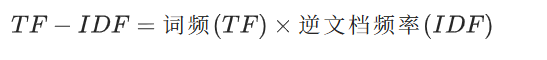
举例:仍以《中国的蜜蜂养殖》为例,TF 均为 0.02 的 “中国”“蜜蜂”“养殖”,在全网语料中 “蜜蜂” 出现的文档数最少,IDF 值最高,最终 TF-IDF 值也最高,因此是更核心的关键词。
三、Python 实战:基于 sklearn 实现 TF-IDF 关键词提取
理论落地的核心是代码实现,本文使用 Python 的sklearn.feature_extraction.text.TfidfVectorizer实现 TF-IDF 计算,结合pandas做结果可视化,最终提取每篇文档的关键词。
1. 环境准备
需安装核心依赖库,命令如下:
pip install scikit-learn pandas2. 完整实战代码
代码实现了语料库构建→TF-IDF 计算→结果可视化→关键词提取全流程,注释清晰可直接运行:
from sklearn.feature_extraction.text import TfidfVectorizer
import pandas as pd

# 读取文本文件,构建语料库
inFile = open(r".\task2_1.txt", 'r')
corpus = inFile.readlines()

# 初始化TF-IDF向量化器
vectorizer = TfidfVectorizer()
# 传入语料库,计算并返回TF-IDF向量
tfidf = vectorizer.fit_transform(corpus)

# 打印稀疏矩阵形式的TF-IDF结果
print(tfidf)

# 获取所有特征词(即语料库中出现的所有词)
wordlist = vectorizer.get_feature_names_out()
print(wordlist)

# 将TF-IDF矩阵转为DataFrame,方便查看
# 行:特征词,列:文档
df = pd.DataFrame(tfidf.T.todense(), index=wordlist)
print(df)

# 遍历每一篇文档,提取按TF-IDF值降序排列的关键词
for j in range(len(corpus)):
    # 获取第j篇文档的所有词的TF-IDF值
    featurelist = df.iloc[:, j].to_list()
    resout = {}
    # 构建“词: TF-IDF值”的字典
    for i in range(len(wordlist)):
        resout[wordlist[i]] = featurelist[i]
    # 按TF-IDF值降序排序
    resout = sorted(resout.items(), key=lambda x: x[1], reverse=True)
    print(resout)
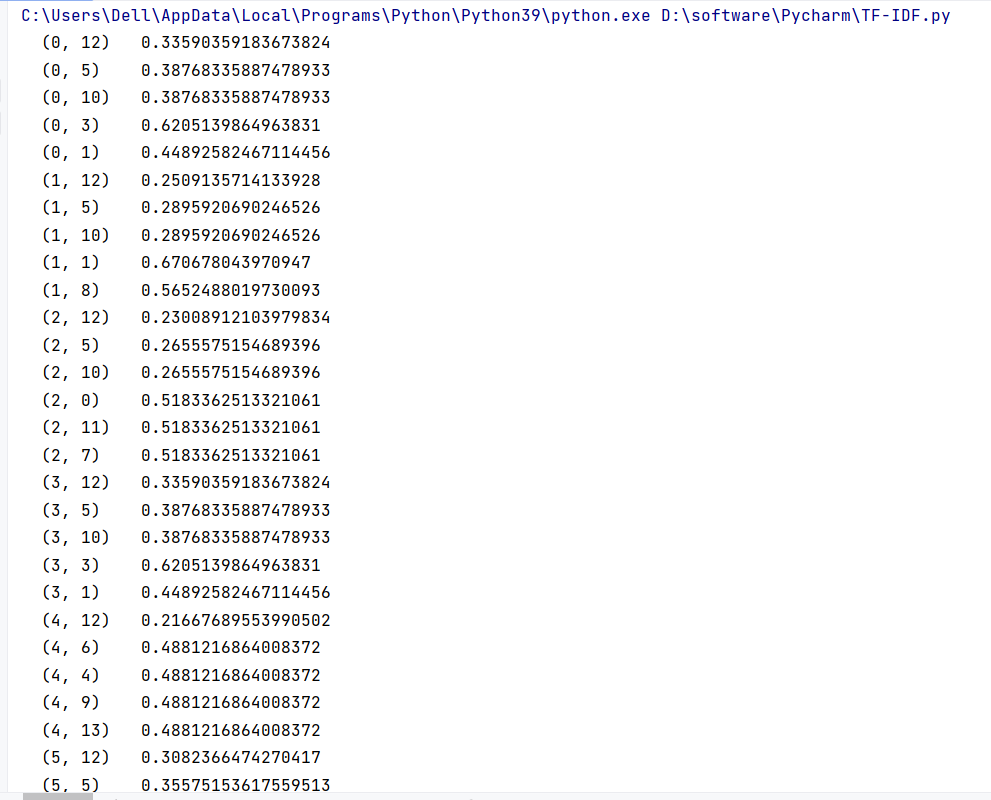
运行结果:
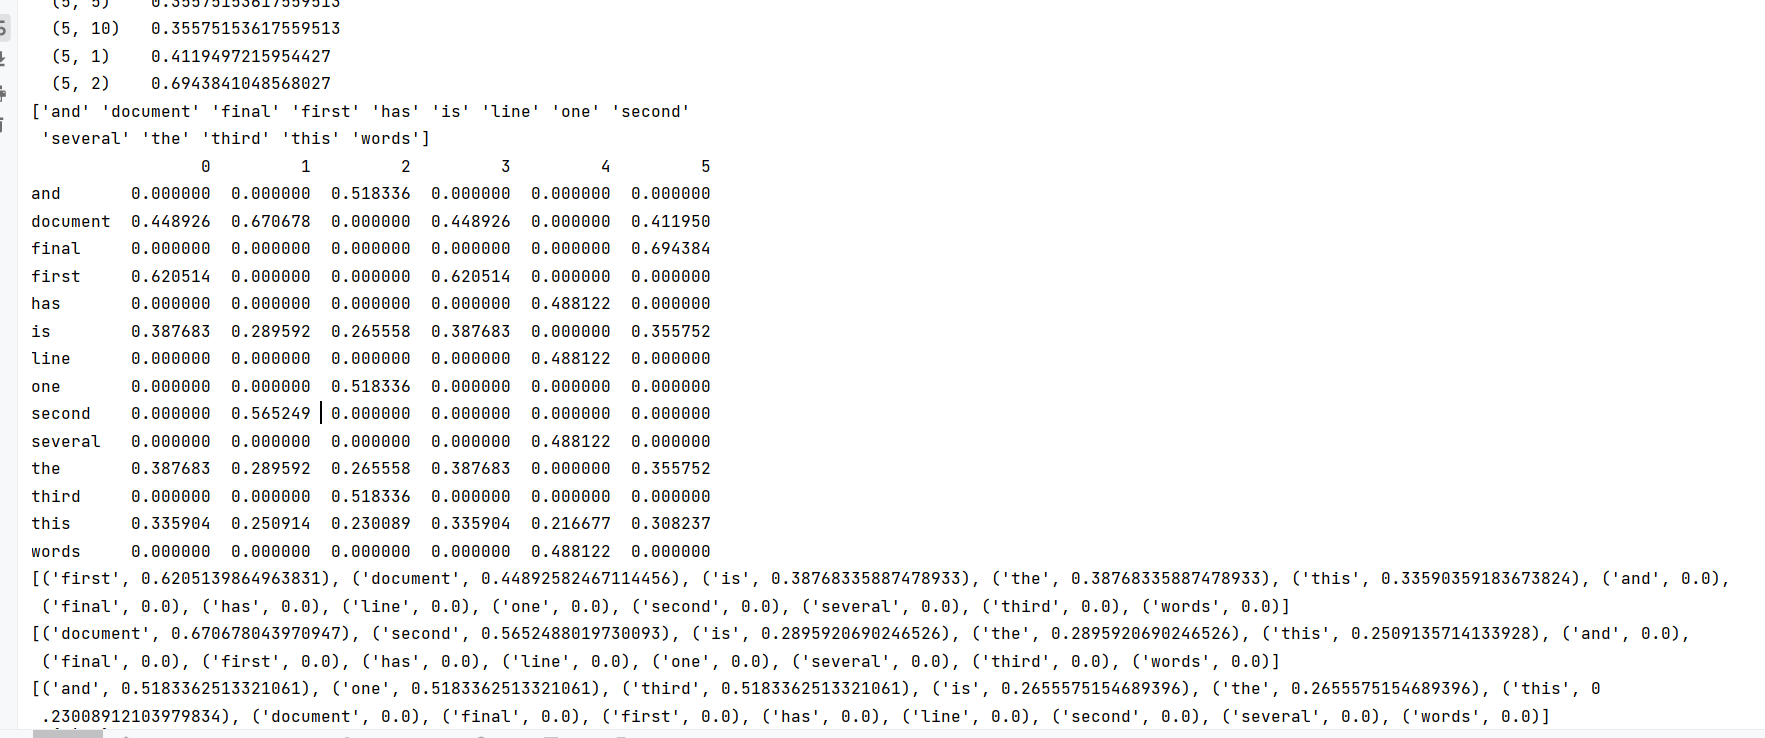
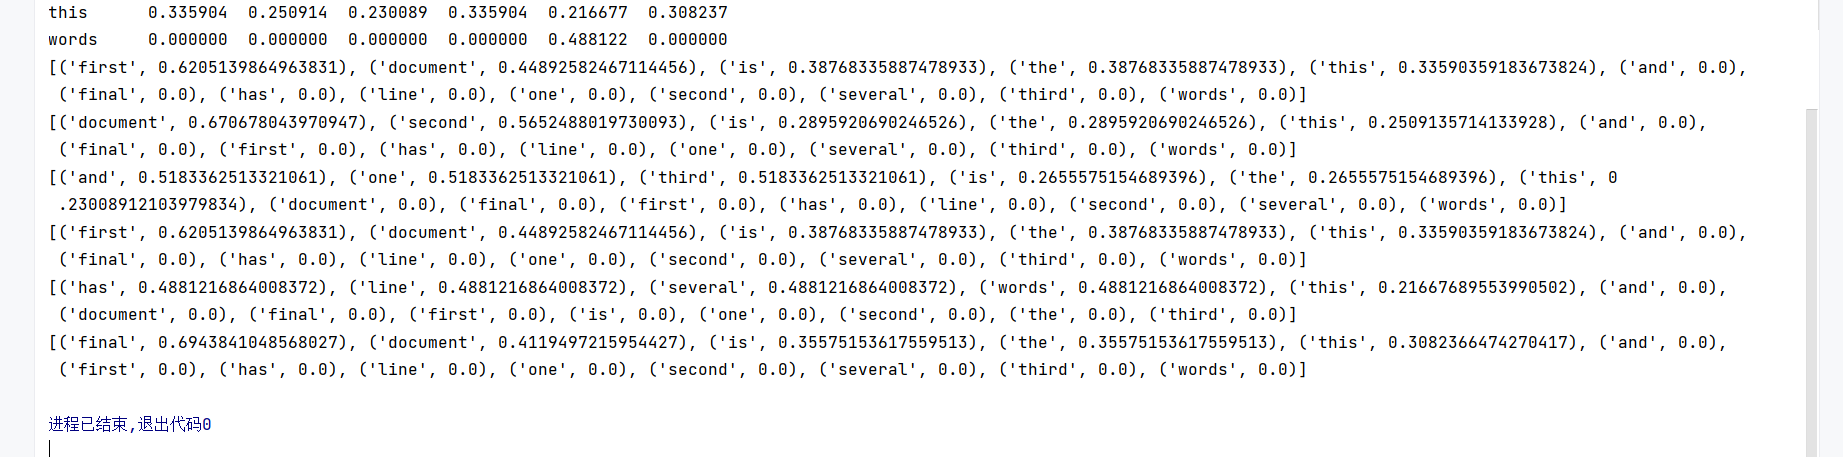
3. 代码关键细节说明
- 语料库构建:以文本文件为输入,每行作为一篇文档,通过
readlines()读取后形成列表,即为语料库corpus; - TfidfVectorizer:
sklearn的 TF-IDF 核心工具,自动完成分词→停用词过滤→TF-IDF 计算,默认过滤英文停用词,可通过stop_words参数传入中文停用词库优化; - 稀疏矩阵:TF-IDF 计算结果默认以稀疏矩阵存储,节省内存,
(i,j)表示第i篇文档中第j个特征词的 TF-IDF 权重; - 结果可视化:通过
T.todense()将稀疏矩阵转置并转为稠密矩阵,结合pandas.DataFrame实现权重的表格化展示,更易查看; - 关键词提取:遍历每篇文档,将词汇与对应权重构建字典,按权重降序排序,过滤权重为 0 的词汇(未在该文档中出现的词),最终得到该文档的关键词列表。
4. 代码优化方向
为提升中文关键词提取的准确性,可对基础代码做两处关键优化:
(1)结合 jieba 做中文精细化分词
sklearn的默认分词对中文支持较弱,可结合 jieba 分词自定义分词函数:
import jieba
# 自定义分词函数
def jieba_cut(text):
    return [word for word in jieba.lcut(text) if len(word) > 1]  # 切分并过滤单字
# 初始化TF-IDF向量化器,指定自定义分词器
vectorizer = TfidfVectorizer(tokenizer=jieba_cut)
(2)添加中文停用词库过滤
准备中文停用词文件stopwords.txt(每行一个停用词),读取后传入TfidfVectorizer:
# 读取中文停用词库
stopwords = [line.strip() for line in open(r".\stopwords.txt", 'r', encoding='utf-8').readlines()]
# 初始化向量化器,指定停用词
vectorizer = TfidfVectorizer(tokenizer=jieba_cut, stop_words=stopwords)
四、词云图辅助:直观展示高频关键词
在 TF-IDF 分析前,可通过词云图对分词后的词频做可视化展示,快速直观看到文本中的高频词汇,作为关键词提取的辅助参考。
1.词云图核心特点
词云图(文字云)会对文本中出现频率较高的关键词做视觉突出(字体越大表示频率越高),过滤大量无效文本信息,让人一眼领略文本核心含义。
2.实现思路
- 用 jieba 对语料库做分词并过滤停用词;
- 统计所有词汇的词频,形成词频字典;
- 使用
wordcloud库绘制词云图,代码示例:
from wordcloud import WordCloud
import matplotlib.pyplot as plt
import jieba
from collections import Counter

# 读取语料库和停用词
corpus = open(r".\task2_1.txt", 'r', encoding='utf-8').read()
stopwords = [line.strip() for line in open(r".\stopwords.txt", 'r', encoding='utf-8').readlines()]

# 分词并过滤
words = [word for word in jieba.lcut(corpus) if word not in stopwords and len(word) > 1]
# 统计词频
word_freq = Counter(words)

# 绘制词云图
wc = WordCloud(
    font_path="simhei.ttf",  # 指定中文字体,避免乱码
    width=800,
    height=600,
    background_color="white"
).generate_from_frequencies(word_freq)

# 展示词云图
plt.imshow(wc)
plt.axis("off")
plt.show()
# 保存词云图
wc.to_file("wordcloud.png")
运行结果: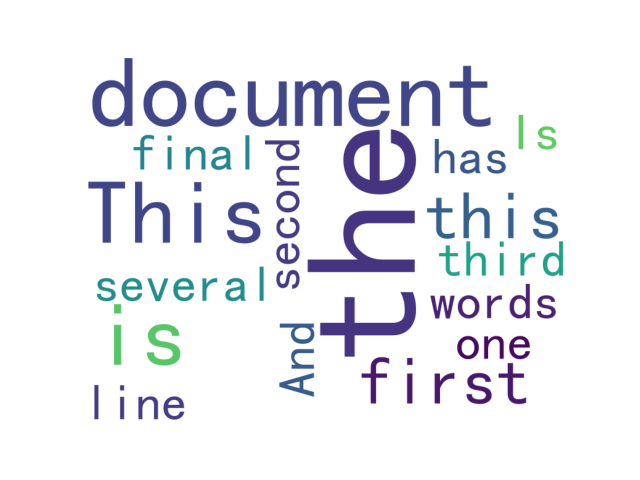
五、总结
本文从理论到实战,完整讲解了基于 TF-IDF 的中文关键词提取方法,核心要点总结如下:
- 关键词提取的核心流程为语料库构建→数据准备→分词→词频统计→TF-IDF 分析,步骤环环相扣;
- TF-IDF 是关键词提取的经典算法,通过 ** 词频(文档内稀缺性)和逆文档频率(语料库内稀缺性)** 的乘积实现词汇加权,权重越高则关键词属性越强;
sklearn的TfidfVectorizer能快速实现 TF-IDF 计算,结合 jieba 分词和中文停用词库,可大幅提升中文处理的准确性;- 词云图可作为辅助工具,直观展示文本高频词汇,与 TF-IDF 的加权关键词提取形成互补。
TF-IDF 算法简单高效、易实现,是文本关键词提取的入门首选,广泛应用于文本分类、舆情分析、文献检索等 NLP 场景,掌握该方法能为后续更复杂的文本分析任务打下坚实基础。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 28
 0
- 0


 已为社区贡献3条内容

所有评论(0)