自然语言处理 —— 句法分析
摘要:句法分析是自然语言处理的关键阶段,旨在通过形式语法规则验证文本语义合理性。解析器作为实现工具,可生成解析树等结构化表示。解析分为自顶向下和自底向上两种方式,涉及最左/最右推导。语法理论包括乔姆斯基的短语结构语法(组构语法)和泰斯尼耶尔的依存语法,前者强调层级结构,后者以动词为核心建立依存关系。上下文无关语法(CFG)作为重要形式化工具,由非终结符、终结符、产生式规则和开始符号四要素构成,是描述语言结构的基础框架。
目录
自然语言处理 —— 句法分析
句法分析也被称作解析或语法分析,是自然语言处理的第三个阶段。该阶段的核心目的是从文本中提取精准的语义,或者说获取文本的字面释义。句法分析会对照形式语法的规则,检验文本表达是否具备语义合理性。例如,“滚烫的冰淇淋” 这类表述会被语义分析器判定为无效。
从这个角度来说,句法分析(解析)可定义为:按照形式语法的规则,对自然语言中的符号串进行分析的过程。“解析(parsing)” 一词源自古拉丁语 “pars”,意为 “部分”。
解析器的概念
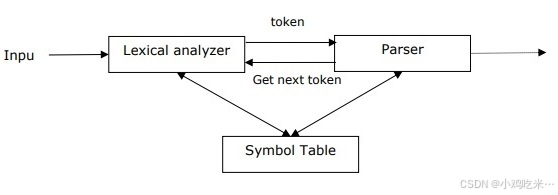
解析器是实现解析任务的工具,可定义为这样一种软件组件:它接收输入数据(文本),按照形式语法校验语法的正确性后,为输入内容生成结构化的表示形式,同时还会构建一种数据结构,这种结构通常表现为解析树、抽象语法树或其他层级结构。
plaintext
词法单元
输入 → 词法分析器 → 解析器
        获取下一个词法单元
        符号表
解析器的主要作用包括:
- 检测并报告所有语法错误;
- 对常见错误进行恢复处理,确保后续的程序处理流程能够继续;
- 生成解析树;
- 构建符号表;
- 生成中间表示形式(IR)。
解析的类型
根据推导方式的不同,解析可分为以下两类:
- 自顶向下解析
- 自底向上解析
自顶向下解析
在这类解析方式中,解析器从开始符号出发构建解析树,随后尝试将开始符号逐步推导为输入的符号串。自顶向下解析最常见的实现形式是通过递归过程处理输入,而递归下降解析法的主要缺点是存在回溯问题。
自底向上解析
在这类解析方式中,解析器从输入的符号串开始,逐步向上构建解析树,直至推导出开始符号。
推导的概念
要得到目标输入字符串,需要遵循一系列产生式规则,推导就是指这组产生式规则的应用过程。在解析过程中,需要确定待替换的非终结符,同时选定用于替换该非终结符的产生式规则。
推导的类型
本节将介绍两种推导方式,它们用于确定使用哪条产生式规则替换非终结符:
最左推导
在最左推导中,对输入的句型从左至右进行扫描并依次替换非终结符,这种推导得到的句型被称为左句型。
最右推导
在最右推导中,对输入的句型从右至左进行扫描并依次替换非终结符,这种推导得到的句型被称为右句型。
解析树的概念
解析树可定义为推导过程的图形化表示,推导的开始符号是解析树的根节点。在任意一棵解析树中,叶节点均为终结符,内部节点均为非终结符。解析树有一个重要特性:对其进行中序遍历,能够得到原始的输入字符串。
语法的概念
语法对于描述结构合法的程序的句法结构而言,是必不可少且至关重要的。从字面含义来讲,语法指自然语言中交流所遵循的句法规则。自英语、印地语等自然语言诞生以来,语言学家就一直在尝试为其定义语法规则。
形式语言理论同样适用于计算机科学领域,尤其在程序设计语言和数据结构方面应用广泛。例如,在 C 语言中,精准的语法规则规定了如何通过语句和列表构建函数。
1956 年,诺姆・乔姆斯基提出了语法的数学模型,该模型为编写计算机语言提供了有效方法。
从数学角度,一个语法 G 可形式化地表示为一个四元组 (N, T, S, P),各元素定义如下:
- N(或 Vₙ):非终结符集合,也可称作变量;
- T(或 Σ):终结符集合;
- S:开始符号,且 S 属于 N;
- P:针对终结符和非终结符的产生式规则集合,规则形式为 α→β。其中,α 和 β 是由 N∪T 中的符号组成的字符串,且 α 中至少包含一个 N 中的非终结符。
短语结构语法(组构语法)
短语结构语法由诺姆・乔姆斯基提出,其核心是组构关系,因此也被称作组构语法,与依存语法相对。
示例
在举例说明组构语法之前,我们需要先了解组构语法和组构关系的基本要点:
- 所有相关的理论框架均从组构关系的角度分析句子结构;
- 组构关系源于拉丁语和希腊语语法中的主谓划分规则;
- 基本的分句结构可通过名词短语(NP)和动词短语(VP)来理解。
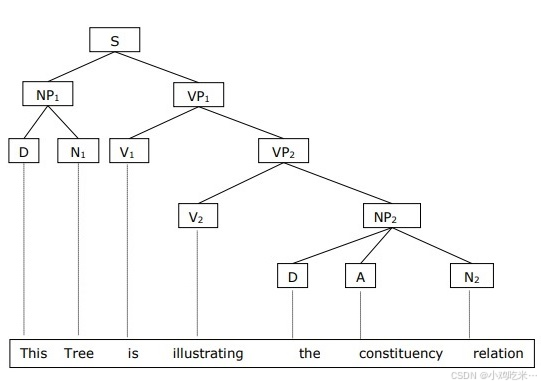
我们可以将句子 “这棵树正阐释组构关系” 的组构结构表示如下:
plaintext
        S
      /   \
    NP1    VP1
   /  \    /  \
  D   N1  V1   VP2
        /   \
       V2   NP2
           / | \
          D  A  N2
This  Tree is illustrating the constituency relation
依存语法
依存语法以依存关系为核心,与组构语法相对,由吕西安・泰斯尼耶尔提出。二者的核心区别在于,依存语法中不存在短语节点。
示例
在举例说明依存语法之前,我们需要先了解依存语法和依存关系的基本要点:
- 在依存语法中,语言单位(即单词)之间通过有向链接相互关联;
- 动词是分句结构的核心;
- 其他所有句法单位均通过有向链接与动词相连,这些句法单位被称为依存成分。
我们可以将句子 “这棵树正阐释依存关系” 的依存结构表示如下:
plaintext
        V
      / | \
     N  V  NP2
    /   |  / | \
   D    /  D  A  N
This  is illustrating the dependency relation
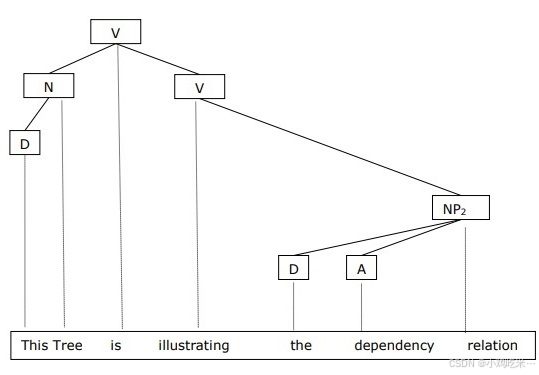
基于组构语法构建的解析树被称为组构型解析树,基于依存语法构建的解析树则被称为依存型解析树。
上下文无关语法
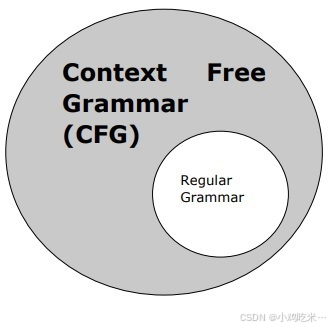
上下文无关语法(简称 CFG)是一种语言描述符号体系,也是正则语法的超集,二者的包含关系可通过下图体现:
plaintext
上下文无关语法(CFG)
    ↑
正则语法
上下文无关语法的定义
上下文无关语法由有限组语法规则构成,包含以下四个核心组成部分:
- 非终结符集合用 V 表示,非终结符是一种句法变量,代表字符串集合,能够进一步帮助定义该语法生成的语言。
- 终结符集合也被称作词法单元,用 Σ 表示,字符串由终结符这一基本符号构成。
- 产生式规则集合用 P 表示,该集合定义了终结符和非终结符的组合方式。每条产生式规则均由非终结符、箭头和终结符(终结符序列)组成,箭头左侧的非终结符称为产生式的左部,箭头右侧的终结符称为产生式的右部。
- 开始符号产生式规则的推导均从开始符号出发,用 S 表示,开始符号始终指定为非终结符。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 16
 0
- 0


 已为社区贡献6条内容

所有评论(0)