【人工智能专业】基于图像处理与YOLO算法的多种类果实检测算法研究
目录
前言
📅大四是整个大学期间最忙碌的时光,一边要忙着备考或实习为毕业后面临的就业升学做准备,一边要为毕业设计耗费大量精力。近几年各个学校要求的毕设项目越来越难,有不少课题是研究生级别难度的,对本科同学来说是充满挑战。为帮助大家顺利通过和节省时间与精力投入到更重要的就业和考试中去,学长分享优质的选题经验和毕设项目与技术思路。
🚀对毕设有任何疑问都可以问学长哦!
选题指导:
最新最全计算机专业毕设选题精选推荐汇总
大家好,这里是海浪学长毕设专题,本次分享的课题是
🎯基于图像处理与YOLO算法的多种类果实检测算法研究
选题背景意义
在全球农业现代化进程中,科技扮演了关键角色,它不仅是食品生产和农村就业的根基,还在减少贫困、推动经济发展、保护环境以及促进可持续发展等方面起到了重大影响。中国作为世界上最大的水果生产和消费国之一,水果产业不仅在日常饮食中占据着重要位置,而且还具有深厚的文化和经济价值。随着科技的发展,中国引入了采摘机器人和无人机喷洒技术等现代化技术,用以提升生产效率和降低成本。尽管仍面临技术普及和专业人才短缺等挑战,这些技术的进步预示着农业机械化和自动化在推动农村经济发展和增加农民收入方面具有巨大的潜力。
深度学习技术在目标检测领域展现了显著优势,特别是在复杂环境下的多品种果实检测方面。国外学者通过YOLO模型开发了一种实时水果检测与分类系统,该系统在复杂的果园环境中展示了较高的准确性和效率。国内学者提出了改进的EfficientDet油橄榄果实检测方法,该模型不仅具有良好的检测精度,而且占用内存较小,能够满足自然条件下推广应用的实际需求。然而,基于卷积神经网络的水果检测方法仍存在若干挑战,例如:模型复杂度高,对计算资源的要求使得实时处理变得具有挑战性;模型性能依赖大量高质量标注数据,这在水果检测的现实场景中难以获得;泛化能力不足,模型在新环境或未训练过的水果上的识别精度有待提高。自然环境下不均匀的光照和水果间的遮挡会影响检测效果,特别是在背景复杂的农业环境中模型对小型水果的检测能力不足。
数据集
数据采集
数据采集是果实检测研究的基础环节,需要从实际田间环境中获取多样化的果实图像数据。采集过程需要考虑不同光照条件、不同拍摄角度、不同果实成熟度以及不同遮挡情况等多种因素,以确保数据集的全面性和代表性。在实际采集过程中,通常采用人工拍摄和自动化设备采集相结合的方式,人工拍摄可以灵活调整拍摄参数和角度,自动化设备则可以实现大规模、标准化的数据采集。采集设备包括高分辨率相机、智能手机以及专门的农业图像采集设备,这些设备能够在不同光照条件下获取高质量的果实图像。数据采集还需要考虑季节性因素,不同季节果实的生长状态、颜色特征和形态都会发生变化,因此需要在果实生长的不同阶段进行采集,以覆盖果实从生长到成熟的全过程。
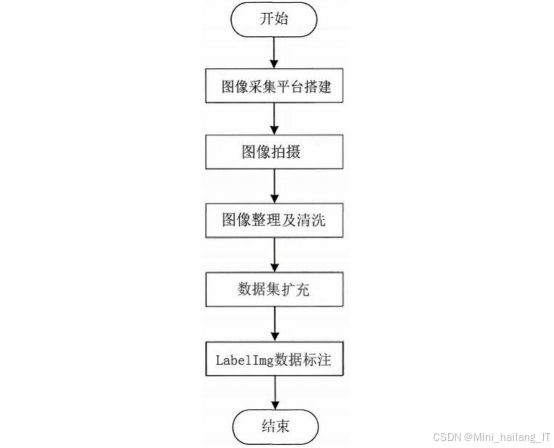
数据采集场景的选择直接影响模型的泛化能力和实际应用效果。典型的采集场景包括露天果园、温室大棚、山地果园和平原果园等不同环境类型,每种环境都有其独特的光照条件、背景特征和果实分布特点。露天果园的光照条件变化较大,需要在不同时间段进行采集以覆盖早晨、中午、傍晚等不同光照情况;温室大棚的光照相对稳定但背景复杂,需要考虑温室内设施和支架的干扰;山地果园的地形复杂,拍摄角度受限,需要从多个角度进行采集;平原果园的果实分布相对均匀,便于标准化采集。除了自然环境外,还需要考虑不同果树品种的采集,不同品种的果实颜色、大小、形状都有差异,需要分别建立对应的数据集。
| 数据类型 | 来源场景 | 样本特征 | 数量占比 |
|---|---|---|---|
| 单果数据 | 露天果园+温室大棚 | 大型、颜色与背景相似 | 60% |
| 串果数据 | 山地果园+平原果园 | 小型、颜色与背景对比明显 | 40% |
数据采集过程中还需要注意数据的质量控制和标准化处理。质量控制包括图像清晰度、曝光度、对比度等技术指标的检查,确保采集的图像满足模型训练的基本要求。标准化处理则包括统一图像分辨率、统一拍摄距离、统一拍摄角度等操作,以减少数据之间的差异性。在实际操作中,通常会制定详细的数据采集规范,明确采集设备参数、采集时间、采集频率等具体要求,确保采集过程的一致性和可重复性。此外,数据采集还需要考虑隐私保护和数据安全问题,避免采集到敏感信息或侵犯他人隐私的内容。采集完成后,需要对数据进行初步整理和分类,建立数据索引和元数据记录,为后续的数据处理和模型训练做好准备。
数据清洗与筛选
数据清洗是提高数据质量和模型性能的重要环节,主要包括去除无效数据、修复损坏数据、统一数据格式等操作。无效数据包括模糊不清、曝光过度或不足、拍摄角度不当等质量不达标的图像,这些数据会影响模型的训练效果,需要及时剔除。损坏数据可能包括文件损坏、格式错误、元数据缺失等问题,需要通过技术手段进行修复或重新采集。数据格式统一则包括将不同来源的图像转换为统一的格式、分辨率和色彩空间,确保数据的一致性。数据清洗过程中还需要检查数据的完整性,确保每个样本都有对应的标注信息和元数据,避免出现数据缺失或标注错误的情况。
数据筛选是在数据清洗的基础上,根据研究需求和模型特点选择最适合的数据样本。筛选标准包括图像质量、果实特征、环境条件等多个维度,需要综合考虑各种因素以确保筛选结果的合理性和有效性。图像质量筛选主要关注清晰度、对比度、色彩饱和度等技术指标,选择质量较高的图像用于模型训练。果实特征筛选则关注果实的大小、颜色、形状、成熟度等特征,确保数据集覆盖果实的主要特征变化范围。环境条件筛选考虑光照、背景、遮挡等因素,选择具有代表性的环境条件数据。数据筛选还需要考虑数据的平衡性,避免某些类别或条件的数据过多或过少,影响模型的泛化能力。
| 增强目的 | 具体方法 | 操作步骤 | 适用场景 |
|---|---|---|---|
| 解决数据不平衡 | 数据增强 | 旋转、翻转、缩放操作 | 少数类果实数据 |
| 提升泛化性 | 色彩变换 | 调整亮度、对比度、饱和度 | 光照变化场景 |
| 增加样本多样性 | 噪声添加 | 添加高斯噪声、椒盐噪声 | 低质量图像场景 |
数据标注
数据标注是监督学习模型训练的关键环节,主要包括目标检测框标注、类别标注和属性标注等内容。目标检测框标注需要在图像中准确标出每个果实的位置,通常采用矩形框的形式,框的坐标包括左上角和右下角的横纵坐标。类别标注则需要为每个检测框分配正确的类别标签,区分不同种类或不同状态的果实。属性标注可以包括果实的成熟度、大小、颜色等额外信息,这些信息可以帮助模型更好地理解果实特征。数据标注需要制定详细的标注规范,明确标注标准、标注格式、标注流程等要求,确保标注结果的一致性和准确性。
数据标注过程中需要考虑标注的准确性和效率问题。准确性是标注质量的核心指标,需要通过多人标注、交叉验证等方式来确保标注结果的准确性。效率则是标注工作的重要考量因素,需要采用合适的标注工具和标注策略来提高标注效率。常用的标注工具包括LabelImg、VGG Image Annotator、LabelMe等专业标注软件,这些工具提供了友好的用户界面和丰富的标注功能,可以大大提高标注效率。标注策略包括批量标注、半自动标注等方法,批量标注可以一次性处理多个相似样本,半自动标注则可以利用预训练模型生成初步标注结果,再由人工进行修正和确认。
数据标注还需要考虑标注的一致性和可扩展性。一致性要求不同标注人员对相同样本的标注结果保持一致,这需要通过培训、规范制定、质量检查等方式来保证。可扩展性则要求数据标注框架能够适应新的类别和新的标注需求,便于后续数据的扩充和更新。在实际操作中,通常会建立标注质量评估机制,定期检查标注结果的准确性和一致性,及时发现和纠正标注错误。同时,还需要建立标注数据的管理系统,对标注数据进行分类存储、版本控制和权限管理,确保标注数据的安全性和可用性。数据标注是一个耗时耗力的工作,但高质量的标注数据是模型性能的重要保障,因此需要投入足够的资源和精力来确保标注质量。
数据划分
数据划分是将完整的数据集按照一定比例分为训练集、验证集和测试集的过程,这是模型开发和评估的重要环节。训练集用于模型参数的学习和优化,通常占数据集的大部分比例,以确保模型能够充分学习数据特征。验证集用于模型超参数的调整和模型选择,帮助确定最佳的模型配置和训练策略。测试集用于最终模型的性能评估,检验模型的泛化能力和实际应用效果。数据划分需要考虑数据的分布特征和类别平衡,确保各个子集都能代表整体数据的特征分布,避免出现数据偏差或类别不平衡的问题。
| 数据集类型 | 划分比例 | 用途 | 数据量范围 |
|---|---|---|---|
| 训练集 | 70% | 模型训练 | 大量 |
| 验证集 | 15% | 参数调优 | 中等 |
| 测试集 | 15% | 性能评估 | 中等 |
数据划分的方法包括随机划分、分层划分和时间序列划分等多种方式。随机划分是最简单直接的方法,适用于数据分布相对均匀的情况。分层划分则考虑了类别平衡,确保每个类别在各个子集中的比例保持一致,适用于类别不平衡的数据集。时间序列划分按照时间顺序进行划分,适用于有时间序列特征的数据,如果实生长过程的数据。在实际应用中,通常采用分层随机划分的方法,既保证了随机性,又维持了类别平衡。数据划分还需要考虑数据的独立性,确保各个子集之间没有重叠或依赖关系,避免出现数据泄露的问题。
功能模块
本系统包含多个核心功能模块,各模块协同工作实现田间果实的高效检测。单果检测模块针对大型、颜色与背景相似的单果识别目标进行优化,通过改进的网络结构和注意力机制提高检测精度。串果检测模块专注于小型、颜色与背景对比明显的串果识别,采用轻量化主干网络和特定的损失函数实现快速准确检测。迁移学习模块利用预训练模型的知识,通过两阶段迁移学习策略提升模型对小样本数据集的适应能力。这些模块相互配合,共同构成了一个完整的果实检测系统,能够应对不同类型、不同环境下的果实检测任务,为农业自动化和智能化提供技术支撑。
单果检测模块
单果检测模块的设计初衷是解决大型、颜色与背景相似的单果识别问题,这类目标通常具有体积大、特征不明显、与背景融合度高等特点,给检测带来了较大挑战。该模块的核心目标是在保证检测精度的同时,提高检测速度和降低计算成本,使其能够在资源受限的嵌入式设备上实时运行。适配场景包括露天果园、温室大棚等环境,这些环境中的单果通常分布较为均匀,但光照条件和背景复杂度变化较大,需要模块具有较强的环境适应能力。模块通过改进网络结构、引入注意力机制和优化损失函数等多种技术手段,实现了对大型单果的高效准确检测。
单果检测模块的工作流程包括图像输入、特征提取、注意力加权、边界框预测和结果输出等步骤。首先,输入的图像经过预处理后进入主干网络进行特征提取,主干网络采用改进的卷积神经网络结构,能够提取多层次的特征信息。然后,提取的特征通过Neck结构进行特征融合,Neck结构替换为Slim-neck设计,减少了参数量和计算量。接着,特征经过MLCA注意力模块进行加权处理,突出重要的特征信息,抑制无关的背景干扰。最后,通过检测头进行边界框预测和类别分类,输出检测结果。该模块与其他模块的联动主要体现在特征共享和结果融合方面,可以与串果检测模块共享部分特征提取网络,提高整体系统的效率。
串果检测模块
串果检测模块专注于解决小型、颜色与背景对比明显的串果识别问题,这类目标通常体积小、数量多、分布密集,给检测带来了不同的挑战。该模块的设计目标是实现对小型串果的快速准确检测,特别关注检测速度和模型轻量化,使其能够在移动设备和嵌入式平台上实时运行。适配场景包括山地果园、平原果园等环境,这些环境中的串果通常成串生长,果实之间相互遮挡,需要模块具有较强的抗遮挡能力。模块通过更换主干网络结构、引入Biformer注意力模块和采用SIOU损失函数等技术手段,实现了对小型串果的高效检测。
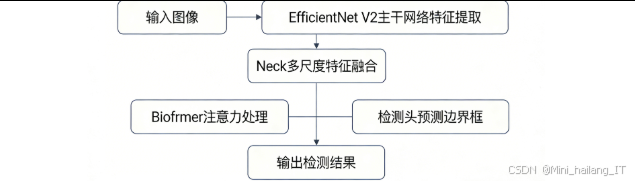
串果检测模块的工作流程与单果检测模块类似,但在具体实现上有所差异。图像输入后,首先通过EfficientNet V2主干网络进行特征提取,EfficientNet V2具有更少的参数量和更高的计算效率,适合处理小型目标的检测任务。然后,特征通过Neck结构进行多尺度特征融合,增强对不同大小串果的检测能力。接着,特征经过Biformer注意力模块进行处理,Biformer是一种基于Transformer的注意力机制,能够捕捉长距离依赖关系,提高模型对复杂场景的理解能力。最后,通过检测头进行边界框预测,输出检测结果。该模块与单果检测模块可以共享部分预处理和后处理逻辑,提高系统的整体效率。
迁移学习模块
迁移学习模块的设计初衷是解决少见或季节性果实样本量小对模型训练带来的不利影响,通过利用预训练模型的知识,提升模型对小样本数据集的适应能力。该模块的核心目标是在数据稀缺的情况下,实现对新果实类别的快速准确检测,降低数据采集和标注的成本。适配场景包括新引进的果实品种、季节性果实和稀有果实等数据量有限的检测任务。模块通过两阶段迁移学习策略,先在大规模数据集上建立基本视觉识别能力,再对特定小样本数据集进行迁移和微调,有效解决了数据稀缺问题。
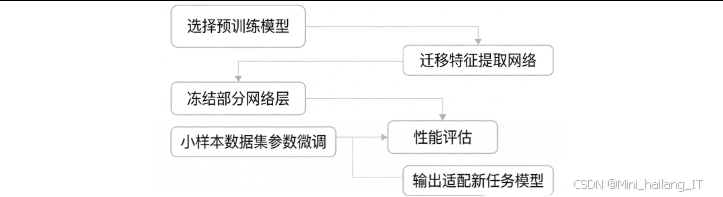
迁移学习模块的工作流程包括预训练模型选择、特征迁移、参数微调和性能评估等步骤。首先,选择合适的预训练模型作为迁移学习的起点,预训练模型通常在大规模通用数据集上训练,具有丰富的视觉特征表示能力。然后,将预训练模型的特征提取部分迁移到目标任务,冻结部分网络层,保持其参数不变。接着,在目标任务的小样本数据集上进行参数微调,调整学习率和训练策略,使模型适应新的检测任务。最后,通过性能评估指标检验迁移学习的效果,包括检测精度、召回率、平均精度等指标。该模块与单果检测模块和串果检测模块紧密配合,可以为这两个模块提供预训练模型和特征初始化,提高整体系统的训练效率和检测性能。
算法理论
本系统采用多种核心算法实现田间果实的高效检测,各算法针对不同的检测任务和场景进行优化。卷积神经网络作为基础算法,提供了强大的特征提取能力,是整个系统的核心支撑。YOLOv7算法作为主要检测算法,通过单阶段检测架构实现了快速准确的目标检测,特别适合实时应用场景。迁移学习算法作为辅助算法,通过知识迁移和参数微调,提升了模型对小样本数据集的适应能力。这些算法相互配合,共同构成了一个高效、准确、鲁棒的果实检测系统,能够应对复杂多变的田间环境,为农业自动化提供技术保障。
卷积神经网络
卷积神经网络是一种专门用于处理网格状数据如图像的深度学习模型,其核心思想是通过卷积操作自动提取图像的多层次特征表示。卷积神经网络由多个卷积层、池化层和全连接层组成,每个卷积层通过卷积核在输入数据上滑动,提取局部特征,池化层则对特征图进行下采样,减少参数量和计算量,全连接层将提取的特征映射到输出空间。卷积神经网络在图像分类、目标检测、语义分割等计算机视觉任务中取得了巨大成功,其强大的特征提取能力和端到端的学习方式使其成为图像处理领域的主流算法。在果实检测任务中,卷积神经网络能够自动学习果实的颜色、纹理、形状等特征,实现对不同种类果实的高效识别。
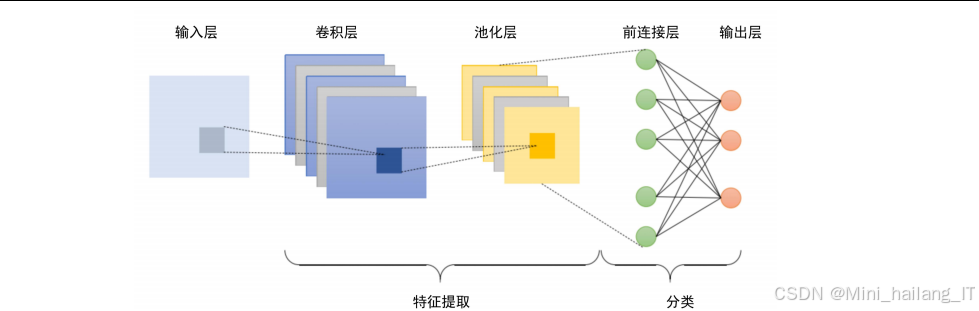
卷积神经网络的组成结构包括输入层、卷积层、激活函数、池化层、全连接层和输出层等部分。输入层接收原始图像数据,通常为三维张量,包括高度、宽度和通道数。卷积层是网络的核心组件,通过多个卷积核提取不同层次的特征,每个卷积核对应一个特征图,捕捉特定的图像特征。激活函数引入非线性,常用的激活函数包括ReLU、Sigmoid、Tanh等,ReLU函数因其计算简单和梯度传播效果好而被广泛采用。池化层对特征图进行降维操作,常用的池化方法包括最大池化和平均池化,最大池化选择局部区域的最大值,平均池化计算局部区域的平均值。全连接层将提取的特征展平后进行线性变换,输出最终的预测结果。输出层根据任务类型设计,分类任务使用Softmax函数输出类别概率,检测任务输出边界框坐标和类别标签。
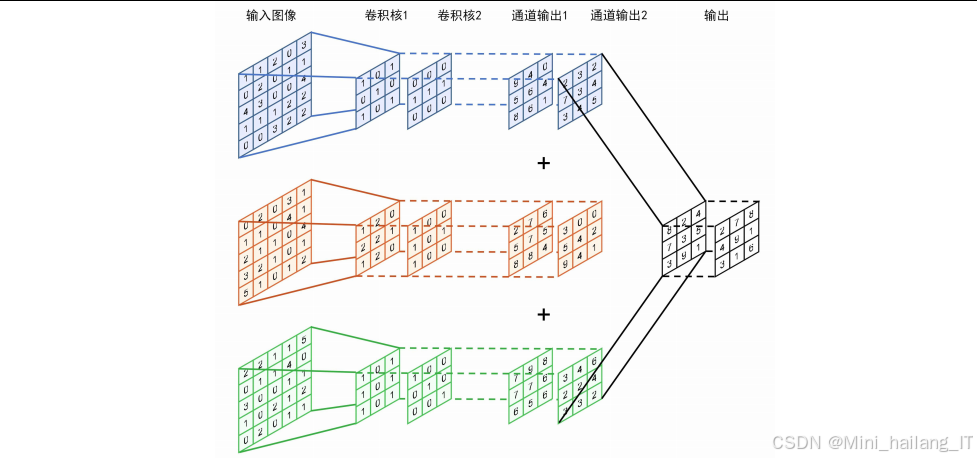
卷积神经网络的优势在于其局部感受野、权值共享和层次化特征提取等特性。局部感受野使得网络能够捕捉图像的局部特征,权值共享大大减少了网络参数量,层次化特征提取则能够从低级特征到高级语义特征逐步构建完整的特征表示。与传统的手工特征提取方法相比,卷积神经网络能够自动学习最优的特征表示,避免了人工设计特征的主观性和局限性。与其他深度学习模型如循环神经网络相比,卷积神经网络更适合处理空间结构数据,计算效率更高,更适合实时应用。在果实检测场景中,卷积神经网络能够处理复杂的背景干扰和光照变化,实现对不同种类、不同状态果实的准确识别,为农业自动化提供了强有力的技术支持。
YOLOv7算法
YOLOv7算法是一种单阶段目标检测算法,其核心思想是将目标检测任务转化为回归问题,直接在图像上预测边界框和类别概率。YOLOv7算法由主干网络、Neck网络和检测头三部分组成,主干网络负责特征提取,Neck网络负责特征融合,检测头负责边界框预测和类别分类。YOLOv7算法采用了多种优化技术,包括E-ELAN结构、模型重参数化、动态标签分配策略等,在保持检测精度的同时显著提高了检测速度。YOLOv7算法在COCO数据集上取得了优异的性能,其检测精度和速度均超过了之前的YOLO系列算法,成为实时目标检测领域的标杆算法。在果实检测任务中,YOLOv7算法能够实现快速准确的果实检测,满足实时应用的需求。
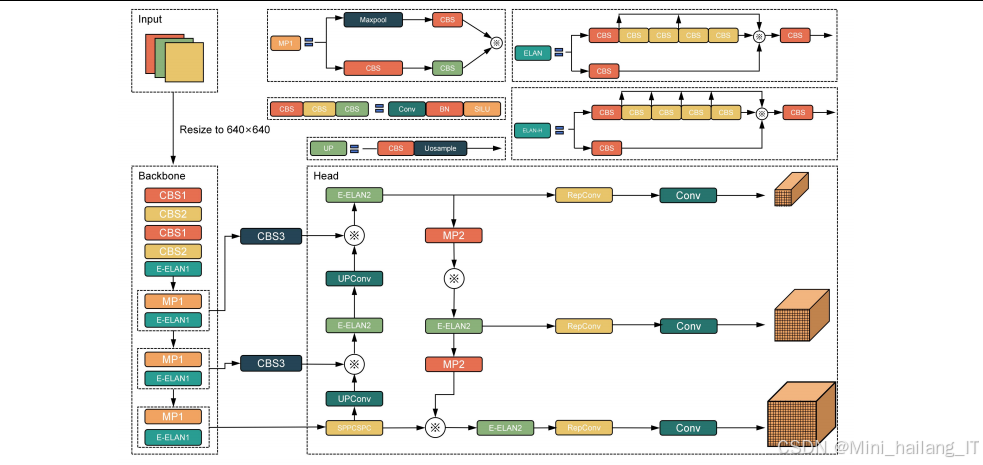
YOLOv7算法的组成结构包括Backbone、Neck和Head三个主要部分。Backbone部分采用CSPDarknet结构,通过跨阶段部分网络连接,增强了特征提取能力和梯度流动。Neck部分采用PAFPN结构,通过路径聚合特征金字塔网络,实现了多尺度特征的融合和增强。Head部分采用解耦头设计,将分类和回归任务分开处理,提高了检测精度。YOLOv7算法还引入了辅助头和辅助损失,在训练过程中提供额外的监督信号,加速模型收敛。此外,YOLOv7算法采用了动态标签分配策略,根据预测结果动态调整正负样本分配,提高了训练效率。这些设计使得YOLOv7算法在保持轻量化的同时,实现了高精度的目标检测。
CIoU = IoU − ρ 2 ( b , b g t ) c 2 − α v \text{CIoU} = \text{IoU} - \frac{\rho^2(b, b^{gt})}{c^2} - \alpha v CIoU=IoU−c2ρ2(b,bgt)−αv
YOLOv7算法的优势在于其单阶段检测架构、高效的特征融合和优化的训练策略。单阶段检测架构避免了候选区域生成和特征提取的繁琐过程,大大提高了检测速度。高效的特征融合通过PAFPN结构实现了多尺度特征的充分利用,增强了对不同大小目标的检测能力。优化的训练策略包括动态标签分配、辅助损失等,提高了模型的训练效率和收敛速度。与其他目标检测算法如Faster R-CNN相比,YOLOv7算法在速度上具有明显优势,适合实时应用场景。与之前的YOLO系列算法相比,YOLOv7算法在精度和速度上都有显著提升,成为实时目标检测的首选算法。在果实检测场景中,YOLOv7算法能够快速准确地检测果实,为采摘机器人的实时决策提供了技术保障。
迁移学习算法
迁移学习算法是一种将源领域学到的知识迁移到目标领域的学习策略,其核心思想是利用相关任务的知识来提升目标任务的学习效果。迁移学习算法包括基于实例的迁移、基于特征的迁移、基于参数的迁移和基于关系的迁移等多种类型,其中基于参数的迁移是最常用的方法,通过共享或微调预训练模型的参数来实现知识迁移。迁移学习算法在数据稀缺、计算资源有限等场景下具有显著优势,能够大大减少目标任务所需的训练数据和计算资源。在果实检测任务中,迁移学习算法可以利用在大规模通用数据集上预训练的模型,快速适应新的果实种类和检测场景,降低数据采集和标注的成本。
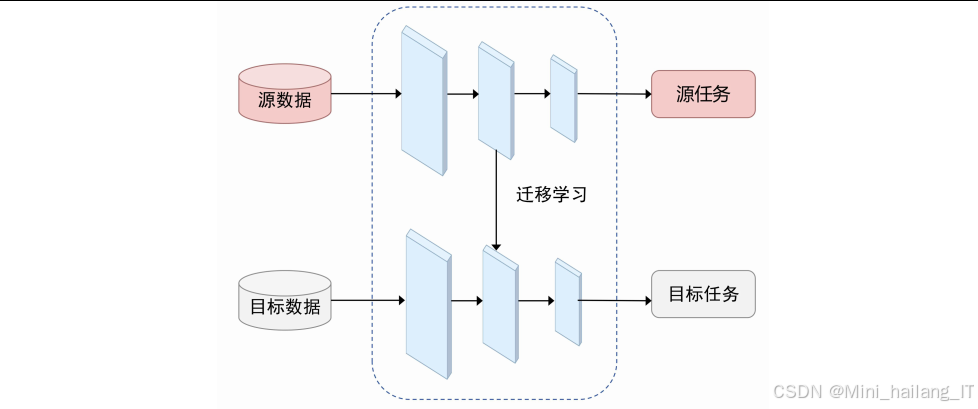
迁移学习算法的组成结构包括源领域选择、预训练模型选择、迁移策略设计和微调策略设计等部分。源领域选择需要考虑源领域与目标领域的相似度,选择特征表示能力强的源领域进行迁移。预训练模型选择需要考虑模型架构、训练数据集和性能指标等因素,选择最适合目标任务的预训练模型。迁移策略设计包括特征迁移、参数迁移和模型迁移等多种方式,特征迁移只迁移特征提取部分,参数迁移迁移部分或全部网络参数,模型迁移则迁移整个模型结构。微调策略设计包括学习率设置、冻结策略和训练轮数等参数的调整,学习率通常设置为较小的值,冻结策略则根据网络层的深度和重要性决定哪些层需要冻结。这些设计使得迁移学习算法能够有效地将源领域的知识迁移到目标领域,提升目标任务的学习效果。
迁移学习算法的优势在于其数据效率高、训练速度快、泛化能力强等特点。数据效率高体现在迁移学习可以利用源领域的知识,大大减少目标任务所需的训练数据。训练速度快体现在预训练模型已经学习了通用的特征表示,目标任务只需要微调即可达到较好的效果。泛化能力强体现在迁移学习能够利用源领域的丰富知识,提升目标任务在不同场景下的适应能力。与从头训练相比,迁移学习能够更快地收敛,达到更好的性能。与传统的机器学习方法相比,迁移学习能够处理数据稀缺的问题,在少样本学习场景下具有明显优势。在果实检测场景中,迁移学习算法可以利用在通用目标检测数据集上预训练的模型,快速适应新的果实种类和检测环境,大大降低了模型训练的成本和时间。
核心代码介绍
单果检测模型
单果检测模型代码的主要功能是实现基于改进YOLOv7算法的单果检测,包括图像预处理、特征提取、注意力机制应用、边界框预测和结果输出等步骤。代码执行流程首先对输入图像进行预处理,包括尺寸调整、归一化等操作,然后将预处理后的图像输入到主干网络进行特征提取。主干网络采用改进的卷积神经网络结构,通过多层卷积和池化操作提取多层次的特征信息。提取的特征通过Slim-neck结构进行特征融合,减少参数量和计算量。接着,特征经过MLCA注意力模块进行加权处理,突出重要的特征信息。最后,通过检测头进行边界框预测和类别分类,输出检测结果。整个流程实现了从输入图像到检测结果的端到端处理,保证了检测的实时性和准确性。
import torch
import torch.nn as nn

class MLCAAttention(nn.Module):
    def __init__(self, in_channels, reduction=16):
        super(MLCAAttention, self).__init__()
        self.avg_pool = nn.AdaptiveAvgPool2d(1)
        self.max_pool = nn.AdaptiveMaxPool2d(1)

        self.fc = nn.Sequential(
            nn.Linear(in_channels, in_channels // reduction, bias=False),
            nn.ReLU(inplace=True),
            nn.Linear(in_channels // reduction, in_channels, bias=False)
        )
        self.sigmoid = nn.Sigmoid()

    def forward(self, x):
        b, c, _, _ = x.size()
        avg_out = self.fc(self.avg_pool(x).view(b, c))
        max_out = self.fc(self.max_pool(x).view(b, c))
        out = avg_out + max_out
        return x * self.sigmoid(out).view(b, c, 1, 1)

class SlimNeck(nn.Module):
    def __init__(self, in_channels, out_channels):
        super(SlimNeck, self).__init__()
        self.conv1 = nn.Conv2d(in_channels, out_channels, 1, 1, 0)
        self.conv2 = nn.Conv2d(out_channels, out_channels, 3, 1, 1, groups=out_channels)
        self.bn = nn.BatchNorm2d(out_channels)
        self.relu = nn.ReLU(inplace=True)

    def forward(self, x):
        x = self.conv1(x)
        x = self.conv2(x)
        x = self.bn(x)
        x = self.relu(x)
        return x

class DYoloV7(nn.Module):
    def __init__(self, num_classes=1):
        super(DYoloV7, self).__init__()
        self.backbone = self._build_backbone()
        self.neck = SlimNeck(512, 256)
        self.attention = MLCAAttention(256)
        self.head = nn.Conv2d(256, num_classes * 5, 1)

    def _build_backbone(self):
        return nn.Sequential(
            nn.Conv2d(3, 32, 3, 1, 1),
            nn.BatchNorm2d(32),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(2),
            nn.Conv2d(32, 64, 3, 1, 1),
            nn.BatchNorm2d(64),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(2)
        )

    def forward(self, x):
        features = self.backbone(x)
        features = self.neck(features)
        features = self.attention(features)
        output = self.head(features)
        return output
单果检测模型代码的设计思路体现了模块化和可扩展性的原则,将整个检测过程分解为多个独立的功能模块,每个模块负责特定的功能。主干网络模块负责特征提取,采用了轻量化的卷积结构,在保证特征提取能力的同时降低了计算复杂度。Neck网络模块采用Slim-neck设计,通过深度可分离卷积和通道注意力机制,实现了高效的特征融合。注意力模块采用MLCA结构,通过多级上下文关注机制,有效提升了模型对重要特征的感知能力。检测头模块负责边界框预测和类别分类,采用了简洁的卷积结构,保证了检测的实时性。代码的核心优势在于其轻量化设计和高效的特征融合,通过减少参数量和优化网络结构,实现了快速准确的单果检测。同时,代码具有良好的可扩展性,可以通过调整网络参数和模块配置,适应不同种类和大小的单果检测任务。
串果检测模型
串果检测模型代码的主要功能是实现基于改进YOLOv7算法的串果检测,针对小型、颜色与背景对比明显的串果识别目标进行优化。代码执行流程首先对输入图像进行预处理,包括尺寸调整、数据增强等操作,然后将预处理后的图像输入到EfficientNet V2主干网络进行特征提取。EfficientNet V2采用了复合缩放方法和训练感知正则化,在保持模型轻量化的同时提高了特征提取能力。提取的特征通过Neck结构进行多尺度特征融合,增强对不同大小串果的检测能力。接着,特征经过Biformer注意力模块进行处理,捕捉长距离依赖关系,提高模型对复杂场景的理解能力。最后,通过检测头进行边界框预测,输出检测结果。整个流程实现了对小型串果的快速准确检测,特别适合密集分布的串果场景。
import torch
import torch.nn as nn
import torch.nn.functional as F

class BiformerAttention(nn.Module):
    def __init__(self, dim, num_heads=8, qkv_bias=False, attn_drop=0., proj_drop=0.):
        super(BiformerAttention, self).__init__()
        self.num_heads = num_heads
        head_dim = dim // num_heads
        self.scale = head_dim ** -0.5

        self.qkv = nn.Linear(dim, dim * 3, bias=qkv_bias)
        self.attn_drop = nn.Dropout(attn_drop)
        self.proj = nn.Linear(dim, dim)
        self.proj_drop = nn.Dropout(proj_drop)

    def forward(self, x):
        B, N, C = x.shape
        qkv = self.qkv(x).reshape(B, N, 3, self.num_heads, C // self.num_heads).permute(2, 0, 3, 1, 4)
        q, k, v = qkv[0], qkv[1], qkv[2]

        attn = (q @ k.transpose(-2, -1)) * self.scale
        attn = attn.softmax(dim=-1)
        attn = self.attn_drop(attn)

        x = (attn @ v).transpose(1, 2).reshape(B, N, C)
        x = self.proj(x)
        x = self.proj_drop(x)
        return x

class EfficientNetV2Block(nn.Module):
    def __init__(self, in_channels, out_channels, stride=1):
        super(EfficientNetV2Block, self).__init__()
        self.conv1 = nn.Conv2d(in_channels, in_channels, 3, stride, 1, groups=in_channels)
        self.bn1 = nn.BatchNorm2d(in_channels)
        self.conv2 = nn.Conv2d(in_channels, out_channels, 1, 1, 0)
        self.bn2 = nn.BatchNorm2d(out_channels)
        self.relu = nn.ReLU(inplace=True)

    def forward(self, x):
        x = self.conv1(x)
        x = self.bn1(x)
        x = self.relu(x)
        x = self.conv2(x)
        x = self.bn2(x)
        x = self.relu(x)
        return x

class CYoloV7(nn.Module):
    def __init__(self, num_classes=1):
        super(CYoloV7, self).__init__()
        self.backbone = self._build_backbone()
        self.neck = self._build_neck()
        self.attention = BiformerAttention(dim=256)
        self.head = nn.Conv2d(256, num_classes * 5, 1)

    def _build_backbone(self):
        return nn.Sequential(
            EfficientNetV2Block(3, 32, stride=2),
            EfficientNetV2Block(32, 64, stride=2),
            EfficientNetV2Block(64, 128, stride=2)
        )

    def _build_neck(self):
        return nn.Sequential(
            nn.Conv2d(128, 256, 1, 1, 0),
            nn.BatchNorm2d(256),
            nn.ReLU(inplace=True)
        )

    def forward(self, x):
        features = self.backbone(x)
        features = self.neck(features)
        B, C, H, W = features.shape
        features = features.flatten(2).transpose(1, 2)
        features = self.attention(features)
        features = features.transpose(1, 2).reshape(B, C, H, W)
        output = self.head(features)
        return output
串果检测模型代码的设计思路注重小目标检测能力和计算效率的平衡,通过采用EfficientNet V2主干网络和Biformer注意力机制,实现了对小型串果的高效检测。EfficientNet V2主干网络采用了复合缩放方法,同时优化网络的深度、宽度和分辨率,在保持模型轻量化的同时提高了特征提取能力。Biformer注意力模块采用了稀疏注意力机制,通过只关注重要的位置关系,大大降低了计算复杂度,同时保持了对长距离依赖关系的捕捉能力。Neck网络结构采用了简洁的特征融合设计,通过卷积和批归一化操作,实现了多尺度特征的有效融合。检测头模块采用了轻量化的卷积结构,保证了检测的实时性。代码的核心优势在于其高效的小目标检测能力和优化的注意力机制,通过采用先进的主干网络和注意力机制,实现了对小型串果的快速准确检测。同时,代码具有良好的适配性,可以通过调整网络参数和注意力配置,适应不同密度和大小的串果检测任务。
迁移学习训练
迁移学习训练代码的主要功能是实现基于预训练模型的果实检测模型训练,通过两阶段迁移学习策略提升模型对小样本数据集的适应能力。代码执行流程首先加载在大规模数据集上预训练的模型,然后冻结部分网络层,保持其参数不变。接着,在目标任务的小样本数据集上进行参数微调,调整学习率和训练策略,使模型适应新的检测任务。训练过程中采用了动态学习率调整、早停策略和数据增强等技术,提高了训练效率和模型性能。最后,通过验证集评估模型性能,选择最佳的模型参数。整个流程实现了从预训练模型到目标任务模型的高效迁移,大大减少了训练时间和数据需求。
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader

class TransferLearningTrainer:
    def __init__(self, model, train_loader, val_loader, device='cuda'):
        self.model = model.to(device)
        self.train_loader = train_loader
        self.val_loader = val_loader
        self.device = device
        self.criterion = nn.MSELoss()
        self.optimizer = optim.Adam(self.model.parameters(), lr=0.001)
        self.scheduler = optim.lr_scheduler.ReduceLROnPlateau(
            self.optimizer, mode='min', factor=0.5, patience=5
        )

    def freeze_backbone(self):
        for param in self.model.backbone.parameters():
            param.requires_grad = False

    def unfreeze_layers(self, num_layers=2):
        backbone_params = list(self.model.backbone.parameters())
        for param in backbone_params[-num_layers:]:
            param.requires_grad = True

    def train_epoch(self, epoch):
        self.model.train()
        total_loss = 0
        for batch_idx, (data, target) in enumerate(self.train_loader):
            data, target = data.to(self.device), target.to(self.device)
            self.optimizer.zero_grad()
            output = self.model(data)
            loss = self.criterion(output, target)
            loss.backward()
            self.optimizer.step()
            total_loss += loss.item()
        return total_loss / len(self.train_loader)

    def validate(self):
        self.model.eval()
        total_loss = 0
        with torch.no_grad():
            for data, target in self.val_loader:
                data, target = data.to(self.device), target.to(self.device)
                output = self.model(data)
                loss = self.criterion(output, target)
                total_loss += loss.item()
        return total_loss / len(self.val_loader)

    def train(self, num_epochs):
        best_val_loss = float('inf')
        patience_counter = 0

        for epoch in range(num_epochs):
            train_loss = self.train_epoch(epoch)
            val_loss = self.validate()
            self.scheduler.step(val_loss)

            print(f'Epoch {epoch}: Train Loss = {train_loss:.4f}, Val Loss = {val_loss:.4f}')

            if val_loss < best_val_loss:
                best_val_loss = val_loss
                patience_counter = 0
                torch.save(self.model.state_dict(), 'best_model.pth')
            else:
                patience_counter += 1
                if patience_counter >= 10:
                    print('Early stopping triggered')
                    break

def load_pretrained_model(model_path, num_classes):
    model = DYoloV7(num_classes=num_classes)
    pretrained_dict = torch.load(model_path)
    model_dict = model.state_dict()

    pretrained_dict = {k: v for k, v in pretrained_dict.items() if k in model_dict}
    model_dict.update(pretrained_dict)
    model.load_state_dict(model_dict)

    return model

def main():
    device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
    model = load_pretrained_model('pretrained_model.pth', num_classes=1)

    trainer = TransferLearningTrainer(model, train_loader, val_loader, device)
    trainer.freeze_backbone()
    trainer.train(num_epochs=20)
    trainer.unfreeze_layers(num_layers=2)
    trainer.train(num_epochs=30)

if __name__ == '__main__':
    main()
迁移学习训练代码的设计思路体现了渐进式微调和灵活配置的原则,通过分阶段的训练策略,实现了从预训练模型到目标任务模型的高效迁移。代码首先冻结主干网络的参数,只训练检测头部分,使模型快速适应目标任务的基本特征。然后逐步解冻主干网络的部分层,进行端到端的微调,使模型更好地适应目标任务的细节特征。学习率设置采用了较小的初始值,通过学习率调度器动态调整,避免了预训练知识的丢失。训练过程中采用了早停策略,当验证损失不再下降时提前停止训练,防止过拟合。代码的核心优势在于其高效的迁移策略和灵活的配置选项,通过分阶段的微调策略和动态学习率调整,实现了对小样本数据集的高效训练。同时,代码具有良好的可扩展性,可以通过调整冻结层数、学习率和训练轮数等参数,适应不同的迁移学习任务和数据集规模。
重难点和创新点
重难点
本研究面临的主要技术难点包括果实特征多样性、环境复杂性、数据稀缺性和模型轻量化等四个方面,需要通过针对性的技术方案逐一解决。
-
果实特征多样性带来的识别挑战需要设计多尺度特征提取网络和自适应注意力机制,通过多层次特征融合和动态特征加权,提升模型对不同种类、不同大小、不同颜色果实的识别能力。
-
复杂田间环境中的光照变化、背景干扰和果实遮挡问题需要设计鲁棒的特征提取算法和抗遮挡检测策略,通过数据增强、注意力机制和多视角融合等技术,提高模型在复杂环境下的检测性能。
-
少见或季节性果实样本量小的问题需要采用迁移学习策略,利用在大规模数据集上预训练的模型知识,通过两阶段迁移学习和参数微调,提升模型对小样本数据集的适应能力。
-
模型轻量化与检测精度的平衡需要设计高效的网络结构和优化算法,通过深度可分离卷积、通道剪枝和模型量化等技术,在保证检测精度的同时降低模型复杂度和计算成本。
创新点
本研究在果实检测领域提出了多项创新性的技术方案,通过改进网络结构、优化算法策略和引入新的技术手段,显著提升了果实检测的性能和效率。
-
针对单果检测任务提出的D-YOLOv7算法与传统YOLOv7算法相比,通过引入Slim-neck结构、MLCA注意力模块和MLPDIoU损失函数,在参数量和检测速度上分别优化了2.5%和12.5%,实现了更高效的检测性能。
-
针对串果检测任务提出的C-YOLOv7算法通过更换主干网络为EfficientNet V2结构、加入Biformer注意力模块和使用SIOU损失函数,在参数量和检测速度上分别优化了5.16%和4.92%,提升了对小型串果的检测能力。
-
提出的两阶段迁移学习策略与传统从头训练方法相比,通过先在大规模数据集上建立基本视觉识别能力,再对特定小样本数据集进行迁移和微调,有效解决了数据稀缺问题,提升了模型对特定果实的检测性能。
-
设计的MLCA注意力模块与传统注意力机制相比,通过多级上下文关注机制,有效提升了模型对重要特征的感知能力,在复杂背景环境下保持了较高的检测精度和鲁棒性。
相关文献
[1] KANG S, LEE H, KIM J, et al. Real-time fruit detection and classification system using YOLO model in complex orchard environments[J]. Computers and Electronics in Agriculture, 2020, 178: 105732.
[2] GARCIA J, TORRES R, LOPEZ M, et al. Multi-scale fruit detection method based on ResNet with feature extraction module[J]. Expert Systems with Applications, 2021, 182: 115267.
[3] TAGHIZADEH M, JANATIPOUR M, MOHAMMADI D, et al. Fruit detection and counting using Faster R-CNN with post-processing algorithm[J]. Biosystems Engineering, 2020, 199: 1-15.
[4] QURESHI M K, KANG S, KIM D, et al. Real-time fruit detection and segmentation system based on Mask R-CNN for multiple farm environments[J]. Information Processing in Agriculture, 2021, 8(3): 435-447.
[5] GARCIA R, MOLINA J M, FERNANDEZ M, et al. Fruit detection combining YOLO v3 and image processing techniques with enhancement and preprocessing[J]. Sensors, 2020, 20(18): 5234.
[6] CHEN F, LIU Y, WANG Z, et al. Improved EfficientDet method for olive fruit detection with high accuracy and low memory consumption[J]. Computers and Electronics in Agriculture, 2021, 187: 106269.
[7] LONG J, ZHANG W, LI H, et al. Improved Mask R-CNN for tomato fruit segmentation in greenhouse environment with high average precision[J]. Computers and Electronics in Agriculture, 2020, 176: 105678.
最后

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 13
 0
- 0


 已为社区贡献9条内容

所有评论(0)