多智能体协同与分布式博弈的优化一致性方法
多智能体一致性的分布式博弈方法
最近在折腾多智能体系统的时候发现个有意思的现象:一群各怀心思的个体,居然能通过互相算计达成微妙平衡。这就好比菜市场里讨价还价的大妈们,表面上争得面红耳赤,最后总能形成个大家勉强接受的价格区间。这种分布式博弈的默契到底怎么实现的?咱们今天就拿Python做个活体实验。
先搞个最简单的场景:五个智能体围成一圈,每个都揣着自己的小心思。咱们用numpy初始化他们的初始策略值:
import numpy as np

agents = np.array([3.0, 8.0, 5.0, 1.0, 9.0])
neighbors = [[4,1], [0,2], [1,3], [2,4], [3,0]]  # 每个节点的邻居索引
print("初始策略值:", agents)
这时候策略值分布得七零八落,就像刚开盘的股票市场。关键是怎么让这群各怀鬼胎的家伙达成共识。分布式博弈的精髓在于:每个智能体既要考虑自己的利益,又要兼顾邻居的动态。
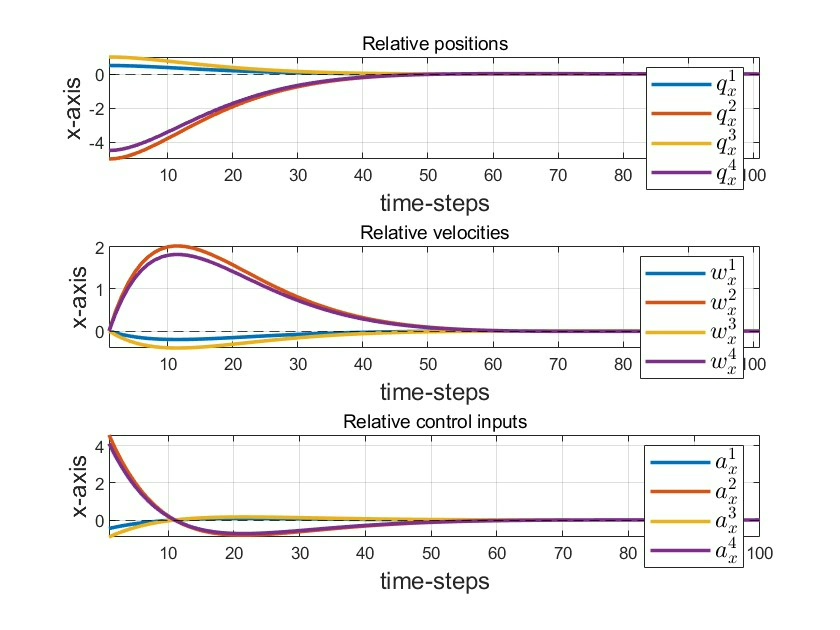
咱们设计个带博弈因子的更新规则:
def update_strategy(current, neighbor_values, alpha=0.2):
    conflict_term = alpha * (np.mean(neighbor_values) - current)
    # 共识趋势:向邻居靠拢
    consensus_term = (1 - alpha) * (np.mean(neighbor_values) - current)
    return current + conflict_term + consensus_term
这个函数里alpha参数特别有意思。当alpha=0就是纯共识算法,大家和和气气往中间凑;alpha>0时就开始勾心斗角了——邻居们要是集体往东,我偏要往西拽一把,但又不撕破脸。
多智能体一致性的分布式博弈方法
跑个20轮看看效果:
import matplotlib.pyplot as plt

history = [agents.copy()]
for _ in range(20):
    new_agents = np.zeros_like(agents)
    for i in range(len(agents)):
        neighbor_vals = agents[neighbors[i]]
        new_agents[i] = update_strategy(agents[i], neighbor_vals, alpha=0.3)
    agents = new_agents
    history.append(agents)
    print(f"第{_+1}轮:", np.round(agents, 2))

plt.figure(figsize=(10,6))
for i in range(len(history[0])):
    plt.plot([step[i] for step in history], marker='o', linestyle='--')
plt.title('分布式博弈收敛过程')
plt.xlabel('迭代次数')
plt.ylabel('策略值')
plt.grid(True)
plt.show()
跑出来的曲线会像几条扭打的蛇,刚开始上蹿下跳,后来慢慢纠缠在一起。有意思的是,最终平衡点既不是初始平均值也不是某个极端值,而是各方博弈后的微妙妥协。
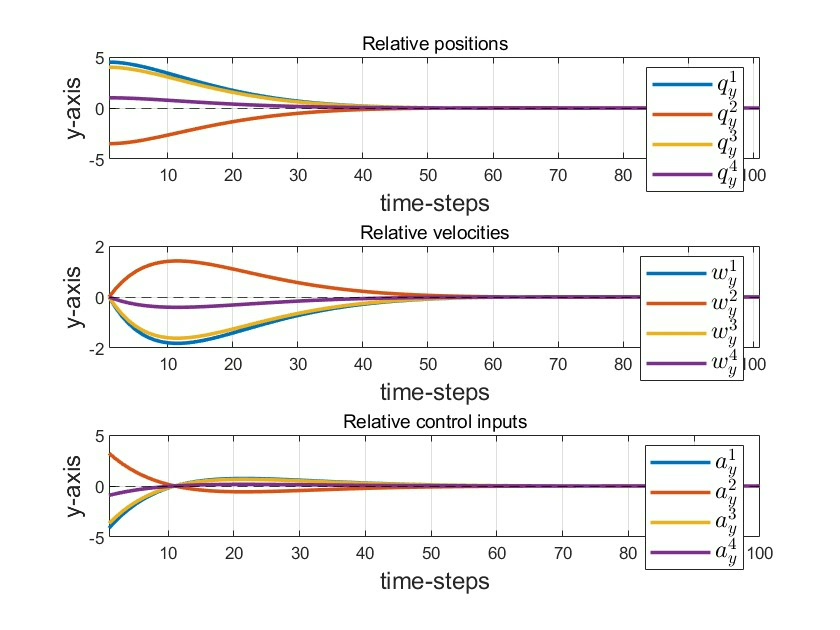
重点看第7轮左右可能出现震荡:
第7轮: [4.12 4.89 4.31 3.97 4.71]
第8轮: [4.35 4.62 4.41 4.23 4.53]
这时候个别智能体还在较劲,但大趋势已经明朗。背后的数学原理其实是博弈论中的虚张声势策略——每个参与者都在试探对手的底线,同时调整自己的底线。
实际工程中这种算法要注意通信延迟的问题。比如改成异步更新,代码需要加个随机因子:
def async_update(current, neighbor_vals, alpha=0.3, delay_prob=0.2):
    if np.random.rand() < delay_prob:
        return current  # 模拟通信延迟
    return update_strategy(current, neighbor_vals, alpha)
这种不确定性反而让系统更接近真实场景。试过就知道,有时候延迟会制造新的平衡点,就像现实谈判中故意拖延战术的效果。
最后给个实用建议:调参时alpha别超过0.5,不然系统容易精神分裂。就像让一群杠精达成共识,得给对抗留余地,但不能让他们真打起来。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 4
 0
- 0


 已为社区贡献8条内容

所有评论(0)