Libvio.link爬虫技术深度解析:反爬机制破解与高效数据抓取
目录
如果您喜欢此文章,请收藏、点赞、评论,谢谢,祝您快乐每一天。
一、Libvio.link网站架构与反爬机制深度剖析
Libvio.link核心特征分析:
- 影视资源聚合平台:多源采集+统一展示
- 动态内容加载:大量使用JavaScript渲染
- 分布式资源存储:视频资源分散在多个CDN
- 访问频率限制:IP、会话、行为多重检测
1. 反爬机制分层解析
class LibvioAntiCrawlAnalysis:
"""Libvio反爬机制分层分析"""
def analyze_security_layers(self):
"""分析五层反爬机制"""
return {
'layer_1': '基础防护层',
'techniques': [
'User-Agent检测',
'Referer验证',
'Cookie会话跟踪',
'基础频率限制(60次/分钟)'
],
'layer_2': '动态加载层',
'techniques': [
'JavaScript动态渲染',
'Ajax异步加载',
'滚动分页加载',
'动态参数加密'
],
'layer_3': '行为检测层',
'techniques': [
'鼠标移动轨迹分析',
'点击间隔时间检测',
'页面停留时间监控',
'滚动行为模式识别'
],
'layer_4': 'IP防护层',
'techniques': [
'IP频率限制(1000次/小时)',
'IP地理位置检测',
'云防火墙(WAF)',
'代理IP识别'
],
'layer_5': '高级防护层',
'techniques': [
'WebSocket连接验证',
'Canvas指纹识别',
'WebGL指纹检测',
'字体指纹分析'
]
}
2. 关键API接口分析
# Libvio主要API接口逆向分析
API_ENDPOINTS = {
# 首页数据
'home': {
'url': 'https://www.libvio.link/api/v1/home',
'method': 'GET',
'auth': False,
'parameters': {
't': '时间戳加密参数',
'sign': 'MD5签名参数',
'page': '分页参数'
}
},
# 搜索接口
'search': {
'url': 'https://www.libvio.link/api/v1/search',
'method': 'POST',
'auth': True,
'parameters': {
'keyword': 'Base64编码',
'page': 1,
'size': 20,
't': '动态token'
}
},
# 视频详情
'detail': {
'url': 'https://www.libvio.link/api/v1/video/detail',
'method': 'GET',
'auth': True,
'parameters': {
'id': '视频ID加密',
't': '时效性token'
}
},
# 播放地址
'play': {
'url': 'https://www.libvio.link/api/v1/video/play',
'method': 'POST',
'auth': True,
'parameters': {
'vid': '视频ID',
'episode': '剧集',
'quality': '清晰度',
'sign': '动态签名'
}
}
}
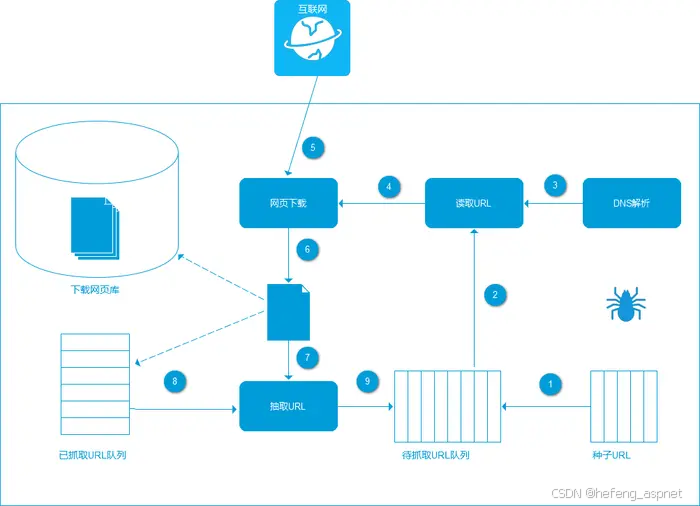
二、高效爬虫架构设计与实现
1. 智能请求头生成系统
import random
import hashlib
import time
from fake_useragent import UserAgent
class IntelligentHeaders:
"""智能请求头生成系统"""
def __init__(self):
self.ua = UserAgent()
self.header_pool = []
self.init_header_pool()
def init_header_pool(self):
"""初始化请求头池"""
base_headers = {
'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,*/*;q=0.8',
'Accept-Language': 'zh-CN,zh;q=0.9,en;q=0.8',
'Accept-Encoding': 'gzip, deflate, br',
'Connection': 'keep-alive',
'Upgrade-Insecure-Requests': '1',
}
# 浏览器指纹池
browsers = [
self.generate_chrome_headers,
self.generate_firefox_headers,
self.generate_safari_headers,
self.generate_edge_headers
]
for browser_gen in browsers:
for _ in range(5):
self.header_pool.append(browser_gen())
def generate_chrome_headers(self):
"""生成Chrome浏览器指纹"""
chrome_versions = [
'120.0.0.0', '119.0.0.0', '118.0.0.0',
'117.0.0.0', '116.0.0.0'
]
return {
'User-Agent': f'Mozilla/5.0 (Windows NT 10.0; Win64; x64) '
f'AppleWebKit/537.36 (KHTML, like Gecko) '
f'Chrome/{random.choice(chrome_versions)} Safari/537.36',
'Sec-Ch-Ua': '"Chromium";v="120", "Google Chrome";v="120", "Not?A_Brand";v="99"',
'Sec-Ch-Ua-Mobile': '?0',
'Sec-Ch-Ua-Platform': '"Windows"',
'Sec-Fetch-Dest': 'document',
'Sec-Fetch-Mode': 'navigate',
'Sec-Fetch-Site': 'none',
'Sec-Fetch-User': '?1',
'Cache-Control': 'max-age=0',
}
def get_headers(self, url):
"""获取智能请求头"""
headers = random.choice(self.header_pool)
# 动态添加Referer
if 'detail' in url:
headers['Referer'] = 'https://www.libvio.link/'
elif 'play' in url:
headers['Referer'] = 'https://www.libvio.link/video/detail'
# 添加时间戳签名
timestamp = int(time.time() * 1000)
headers['X-Timestamp'] = str(timestamp)
headers['X-Signature'] = self.generate_signature(timestamp)
return headers
def generate_signature(self, timestamp):
"""生成动态签名"""
secret = 'libvio_secret_2024'
data = f'{timestamp}{secret}'
return hashlib.md5(data.encode()).hexdigest()[:8]
2. 异步并发爬虫架构
import asyncio
import aiohttp
import aiofiles
from bs4 import BeautifulSoup
from urllib.parse import urljoin, urlparse
import json
import re
class LibvioAsyncCrawler:
"""Libvio异步高性能爬虫"""
def __init__(self, concurrency=10):
self.concurrency = concurrency
self.semaphore = asyncio.Semaphore(concurrency)
self.session = None
self.headers_gen = IntelligentHeaders()
self.proxy_pool = [] # 代理IP池
self.cookie_jar = aiohttp.CookieJar()
async def init_session(self):
"""初始化会话"""
connector = aiohttp.TCPConnector(
limit=self.concurrency * 2,
ssl=False,
force_close=True,
enable_cleanup_closed=True
)
timeout = aiohttp.ClientTimeout(
total=30,
connect=10,
sock_read=20
)
self.session = aiohttp.ClientSession(
connector=connector,
timeout=timeout,
cookie_jar=self.cookie_jar
)
# 获取初始Cookie
await self.get_initial_cookie()
async def get_initial_cookie(self):
"""获取初始Cookie(模拟首次访问)"""
home_url = 'https://www.libvio.link'
headers = self.headers_gen.get_headers(home_url)
async with self.session.get(home_url, headers=headers) as response:
# Cookie自动保存在cookie_jar中
html = await response.text()
# 提取动态token(如果有)
token_pattern = r'window\.__INITIAL_STATE__\s*=\s*({.*?})'
match = re.search(token_pattern, html)
if match:
initial_state = json.loads(match.group(1))
self.initial_token = initial_state.get('token', '')
async def fetch_page(self, url, params=None, data=None):
"""获取页面内容(带重试机制)"""
max_retries = 3
retry_delay = 2
for attempt in range(max_retries):
try:
headers = self.headers_gen.get_headers(url)
async with self.semaphore:
# 随机延迟(模拟人类行为)
await asyncio.sleep(random.uniform(1, 3))
if data:
async with self.session.post(
url,
headers=headers,
data=data,
params=params
) as response:
return await self.handle_response(response, url)
else:
async with self.session.get(
url,
headers=headers,
params=params
) as response:
return await self.handle_response(response, url)
except (aiohttp.ClientError, asyncio.TimeoutError) as e:
if attempt == max_retries - 1:
raise
await asyncio.sleep(retry_delay ** attempt)
async def handle_response(self, response, url):
"""处理响应"""
content_type = response.headers.get('Content-Type', '')
if 'application/json' in content_type:
data = await response.json()
# 检查API返回状态
if data.get('code') != 200:
error_msg = data.get('msg', 'Unknown error')
raise Exception(f'API Error: {error_msg}')
return data
elif 'text/html' in content_type:
html = await response.text()
# 检查是否被重定向到验证页面
if 'verification' in html.lower() or 'captcha' in html.lower():
raise Exception('Triggered anti-crawler verification')
return html
else:
return await response.read()
async def crawl_homepage(self):
"""爬取首页数据"""
url = 'https://www.libvio.link'
html = await self.fetch_page(url)
soup = BeautifulSoup(html, 'html.parser')
# 提取视频分类
categories = []
nav_items = soup.select('.nav-item a')
for item in nav_items:
category = {
'name': item.get_text(strip=True),
'url': urljoin(url, item['href']),
'slug': item['href'].split('/')[-1]
}
categories.append(category)
# 提取热门推荐
hot_videos = []
video_items = soup.select('.video-item')
for item in video_items:
video = {
'title': item.select_one('.video-title').get_text(strip=True),
'url': urljoin(url, item.select_one('a')['href']),
'cover': item.select_one('img')['data-src'],
'score': item.select_one('.score').get_text(strip=True),
'year': item.select_one('.year').get_text(strip=True),
'type': item.select_one('.type').get_text(strip=True)
}
hot_videos.append(video)
return {
'categories': categories,
'hot_videos': hot_videos,
'timestamp': int(time.time())
}
async def crawl_video_detail(self, video_url):
"""爬取视频详情"""
html = await self.fetch_page(video_url)
soup = BeautifulSoup(html, 'html.parser')
# 提取基本信息
detail = {
'title': soup.select_one('.video-title').get_text(strip=True),
'original_title': soup.select_one('.original-title').get_text(strip=True),
'year': soup.select_one('.year').get_text(strip=True),
'director': self.extract_text(soup, '.director'),
'actors': self.extract_list(soup, '.actors a'),
'genres': self.extract_list(soup, '.genres a'),
'region': self.extract_text(soup, '.region'),
'language': self.extract_text(soup, '.language'),
'release_date': self.extract_text(soup, '.release-date'),
'duration': self.extract_text(soup, '.duration'),
'imdb_score': self.extract_text(soup, '.imdb-score'),
'douban_score': self.extract_text(soup, '.douban-score'),
'summary': soup.select_one('.summary').get_text(strip=True),
}
# 提取剧集信息(需要解析JavaScript)
episodes_script = soup.find('script', string=re.compile('episodes'))
if episodes_script:
episodes_data = self.extract_json_from_script(episodes_script.string)
detail['episodes'] = episodes_data
# 提取播放地址(需要调用API)
video_id = self.extract_video_id(video_url)
play_urls = await self.get_play_urls(video_id)
detail['play_urls'] = play_urls
return detail
async def get_play_urls(self, video_id):
"""获取播放地址(需要解密)"""
api_url = 'https://www.libvio.link/api/v1/video/play'
# 生成请求参数
params = self.generate_play_params(video_id)
data = await self.fetch_page(api_url, data=params)
# 解密播放地址
if data.get('encrypted'):
play_urls = self.decrypt_play_urls(data['urls'])
else:
play_urls = data.get('urls', [])
return play_urls
def generate_play_params(self, video_id):
"""生成播放请求参数"""
timestamp = int(time.time() * 1000)
params = {
'vid': video_id,
't': timestamp,
'sign': self.generate_play_signature(video_id, timestamp),
'platform': 'web',
'version': '1.0.0',
'quality': '1080p' # 可调整清晰度
}
return params
def generate_play_signature(self, video_id, timestamp):
"""生成播放签名"""
# 逆向分析得到的签名算法
secret_key = 'libvio_play_2024_secret'
data = f'{video_id}{timestamp}{secret_key}'
# 双重MD5加密
md5_1 = hashlib.md5(data.encode()).hexdigest()
md5_2 = hashlib.md5(md5_1.encode()).hexdigest()
return md5_2[:16]
def decrypt_play_urls(self, encrypted_urls):
"""解密播放地址"""
# 简单的XOR解密示例(实际需要逆向分析)
decrypted = []
key = 0xAB
for url in encrypted_urls:
decrypted_url = ''
for char in url:
decrypted_char = chr(ord(char) ^ key)
decrypted_url += decrypted_char
decrypted.append(decrypted_url)
return decrypted
async def crawl_search(self, keyword, page=1, size=20):
"""搜索视频"""
api_url = 'https://www.libvio.link/api/v1/search'
# 关键词Base64编码
encoded_keyword = base64.b64encode(
keyword.encode('utf-8')
).decode('utf-8')
data = {
'keyword': encoded_keyword,
'page': page,
'size': size,
't': self.generate_search_token()
}
result = await self.fetch_page(api_url, data=data)
return {
'keyword': keyword,
'total': result.get('total', 0),
'page': page,
'size': size,
'videos': result.get('data', [])
}
def generate_search_token(self):
"""生成搜索token"""
# 基于时间的动态token
current_hour = int(time.time() / 3600)
secret = 'libvio_search_2024'
token_data = f'{current_hour}{secret}'
return hashlib.sha256(token_data.encode()).hexdigest()[:32]
async def close(self):
"""关闭会话"""
if self.session:
await self.session.close()
3. 分布式爬虫架构(扩展版)
import redis
import pickle
from datetime import datetime
import logging
class DistributedLibvioCrawler:
"""分布式Libvio爬虫系统"""
def __init__(self, redis_host='localhost', redis_port=6379):
self.redis = redis.Redis(
host=redis_host,
port=redis_port,
decode_responses=True
)
# 任务队列
self.task_queue = 'libvio:crawl:queue'
self.result_queue = 'libvio:crawl:results'
# 状态监控
self.stats_key = 'libvio:crawl:stats'
# 代理IP池
self.proxy_pool_key = 'proxy:pool'
# 分布式锁
self.lock_key = 'libvio:crawl:lock'
def distribute_tasks(self, start_urls, task_type='detail'):
"""分发爬取任务"""
for url in start_urls:
task = {
'url': url,
'type': task_type,
'priority': 1,
'created_at': datetime.now().isoformat(),
'retry_count': 0
}
# 序列化任务
task_data = pickle.dumps(task)
# 推送到Redis队列
self.redis.lpush(self.task_queue, task_data)
# 更新统计
self.redis.hincrby(self.stats_key, 'tasks_queued', 1)
async def worker(self, worker_id):
"""爬虫工作节点"""
crawler = LibvioAsyncCrawler()
await crawler.init_session()
logging.info(f'Worker {worker_id} started')
while True:
# 获取任务(阻塞式)
task_data = self.redis.brpop(self.task_queue, timeout=30)
if not task_data:
continue
task = pickle.loads(task_data[1])
try:
# 执行爬取任务
result = await self.execute_task(crawler, task)
# 存储结果
result_data = pickle.dumps({
'task': task,
'result': result,
'worker_id': worker_id,
'completed_at': datetime.now().isoformat()
})
self.redis.lpush(self.result_queue, result_data)
self.redis.hincrby(self.stats_key, 'tasks_completed', 1)
except Exception as e:
logging.error(f'Worker {worker_id} task failed: {e}')
# 重试逻辑
if task['retry_count'] < 3:
task['retry_count'] += 1
task_data = pickle.dumps(task)
self.redis.lpush(self.task_queue, task_data)
else:
self.redis.hincrby(self.stats_key, 'tasks_failed', 1)
async def execute_task(self, crawler, task):
"""执行具体爬取任务"""
if task['type'] == 'detail':
return await crawler.crawl_video_detail(task['url'])
elif task['type'] == 'search':
# 解析搜索参数
return await crawler.crawl_search(**task.get('params', {}))
elif task['type'] == 'home':
return await crawler.crawl_homepage()
else:
raise ValueError(f'Unknown task type: {task["type"]}')
三、高级反反爬策略与技巧
1. 动态IP代理池管理
class SmartProxyManager:
"""智能代理IP管理器"""
def __init__(self):
self.proxies = []
self.blacklist = set()
self.performance_stats = {}
async def validate_proxy(self, proxy):
"""验证代理IP有效性"""
test_urls = [
'https://www.libvio.link/robots.txt',
'https://www.libvio.link/sitemap.xml'
]
for url in test_urls:
try:
async with aiohttp.ClientSession() as session:
async with session.get(
url,
proxy=proxy,
timeout=5
) as response:
if response.status == 200:
return True
except:
continue
return False
def rotate_proxy(self, current_proxy=None):
"""轮换代理IP"""
available = [p for p in self.proxies
if p not in self.blacklist]
if not available:
return None
# 基于性能选择最佳代理
scored_proxies = []
for proxy in available:
score = self.calculate_proxy_score(proxy)
scored_proxies.append((score, proxy))
# 选择得分最高的代理
scored_proxies.sort(reverse=True)
return scored_proxies[0][1]
def calculate_proxy_score(self, proxy):
"""计算代理IP得分"""
stats = self.performance_stats.get(proxy, {
'success': 0,
'failure': 0,
'speed': float('inf'),
'last_used': 0
})
success_rate = stats['success'] / max(1, stats['success'] + stats['failure'])
speed_score = 1 / max(0.1, stats['speed'])
freshness = 1 / (time.time() - stats['last_used'] + 1)
return success_rate * 0.5 + speed_score * 0.3 + freshness * 0.2
2. 浏览器自动化模拟
from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.webdriver.common.action_chains import ActionChains
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC
import undetected_chromedriver as uc
class BrowserSimulator:
"""浏览器行为模拟器"""
def __init__(self, headless=False):
options = uc.ChromeOptions()
if headless:
options.add_argument('--headless')
# 反检测配置
options.add_argument('--disable-blink-features=AutomationControlled')
options.add_experimental_option("excludeSwitches", ["enable-automation"])
options.add_experimental_option('useAutomationExtension', False)
self.driver = uc.Chrome(options=options)
# 执行反检测脚本
self.driver.execute_cdp_cmd('Page.addScriptToEvaluateOnNewDocument', {
'source': '''
Object.defineProperty(navigator, 'webdriver', {
get: () => undefined
});
'''
})
def simulate_human_behavior(self):
"""模拟人类浏览行为"""
# 随机鼠标移动
actions = ActionChains(self.driver)
for _ in range(random.randint(3, 8)):
x = random.randint(0, 800)
y = random.randint(0, 600)
actions.move_by_offset(x, y)
actions.pause(random.uniform(0.5, 2))
actions.perform()
# 随机滚动
scroll_amount = random.randint(200, 800)
self.driver.execute_script(f"window.scrollBy(0, {scroll_amount});")
# 随机点击(非必要元素)
if random.random() > 0.7:
elements = self.driver.find_elements(By.CSS_SELECTOR,
'a, button, div.clickable')
if elements:
random.choice(elements).click()
time.sleep(random.uniform(1, 3))
def crawl_with_simulation(self, url):
"""使用浏览器模拟爬取"""
self.driver.get(url)
# 等待页面加载
WebDriverWait(self.driver, 10).until(
EC.presence_of_element_located((By.TAG_NAME, "body"))
)
# 模拟人类行为
self.simulate_human_behavior()
# 获取渲染后的页面源码
html = self.driver.page_source
# 执行JavaScript获取动态数据
dynamic_data = self.driver.execute_script('''
return {
videos: Array.from(document.querySelectorAll('.video-item')).map(item => ({
title: item.querySelector('.title')?.innerText,
url: item.querySelector('a')?.href
})),
totalPages: window.__PAGINATION_TOTAL_PAGES || 1
};
''')
return {
'html': html,
'dynamic_data': dynamic_data,
'cookies': self.driver.get_cookies()
}
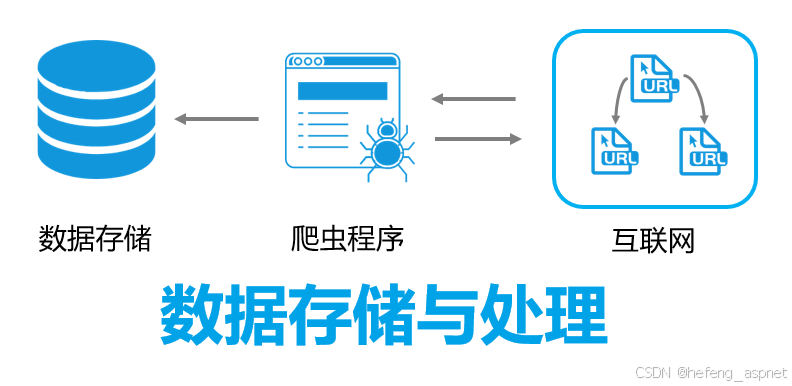
四、数据存储与处理
1. 结构化数据存储
import sqlite3
import json
from datetime import datetime
class LibvioDataStorage:
"""Libvio数据存储管理器"""
def __init__(self, db_path='libvio_data.db'):
self.conn = sqlite3.connect(db_path)
self.create_tables()
def create_tables(self):
"""创建数据表"""
tables = {
'videos': '''
CREATE TABLE IF NOT EXISTS videos (
id INTEGER PRIMARY KEY AUTOINCREMENT,
libvio_id TEXT UNIQUE,
title TEXT NOT NULL,
original_title TEXT,
year INTEGER,
director TEXT,
actors TEXT, -- JSON数组
genres TEXT, -- JSON数组
region TEXT,
language TEXT,
release_date TEXT,
duration TEXT,
imdb_score REAL,
douban_score REAL,
summary TEXT,
cover_url TEXT,
detail_url TEXT,
created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP,
updated_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
)
''',
'episodes': '''
CREATE TABLE IF NOT EXISTS episodes (
id INTEGER PRIMARY KEY AUTOINCREMENT,
video_id INTEGER,
episode_number INTEGER,
title TEXT,
play_url TEXT,
quality TEXT,
duration INTEGER,
FOREIGN KEY (video_id) REFERENCES videos (id)
)
''',
'play_records': '''
CREATE TABLE IF NOT EXISTS play_records (
id INTEGER PRIMARY KEY AUTOINCREMENT,
video_id INTEGER,
episode_id INTEGER,
play_url TEXT,
quality TEXT,
source TEXT,
available BOOLEAN DEFAULT 1,
checked_at TIMESTAMP,
FOREIGN KEY (video_id) REFERENCES videos (id),
FOREIGN KEY (episode_id) REFERENCES episodes (id)
)
''',
'crawl_logs': '''
CREATE TABLE IF NOT EXISTS crawl_logs (
id INTEGER PRIMARY KEY AUTOINCREMENT,
url TEXT,
status_code INTEGER,
response_time REAL,
success BOOLEAN,
error_message TEXT,
crawled_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
)
'''
}
cursor = self.conn.cursor()
for table_name, sql in tables.items():
cursor.execute(sql)
self.conn.commit()
def save_video(self, video_data):
"""保存视频数据"""
cursor = self.conn.cursor()
# 检查是否已存在
cursor.execute(
'SELECT id FROM videos WHERE libvio_id = ?',
(video_data.get('libvio_id'),)
)
existing = cursor.fetchone()
if existing:
# 更新现有记录
cursor.execute('''
UPDATE videos SET
title = ?,
original_title = ?,
year = ?,
director = ?,
actors = ?,
genres = ?,
region = ?,
language = ?,
release_date = ?,
duration = ?,
imdb_score = ?,
douban_score = ?,
summary = ?,
cover_url = ?,
updated_at = CURRENT_TIMESTAMP
WHERE libvio_id = ?
''', (
video_data['title'],
video_data.get('original_title'),
video_data.get('year'),
video_data.get('director'),
json.dumps(video_data.get('actors', []), ensure_ascii=False),
json.dumps(video_data.get('genres', []), ensure_ascii=False),
video_data.get('region'),
video_data.get('language'),
video_data.get('release_date'),
video_data.get('duration'),
video_data.get('imdb_score'),
video_data.get('douban_score'),
video_data.get('summary'),
video_data.get('cover_url'),
video_data.get('libvio_id')
))
video_id = existing[0]
else:
# 插入新记录
cursor.execute('''
INSERT INTO videos (
libvio_id, title, original_title, year,
director, actors, genres, region, language,
release_date, duration, imdb_score, douban_score,
summary, cover_url, detail_url
) VALUES (?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?)
''', (
video_data.get('libvio_id'),
video_data['title'],
video_data.get('original_title'),
video_data.get('year'),
video_data.get('director'),
json.dumps(video_data.get('actors', []), ensure_ascii=False),
json.dumps(video_data.get('genres', []), ensure_ascii=False),
video_data.get('region'),
video_data.get('language'),
video_data.get('release_date'),
video_data.get('duration'),
video_data.get('imdb_score'),
video_data.get('douban_score'),
video_data.get('summary'),
video_data.get('cover_url'),
video_data.get('detail_url')
))
video_id = cursor.lastrowid
# 保存剧集信息
if 'episodes' in video_data:
self.save_episodes(video_id, video_data['episodes'])
# 保存播放地址
if 'play_urls' in video_data:
self.save_play_urls(video_id, video_data['play_urls'])
self.conn.commit()
return video_id
2. 增量更新与去重策略
class IncrementalUpdateManager:
"""增量更新管理器"""
def __init__(self):
self.last_crawl_time = {}
self.fingerprint_cache = set()
def generate_fingerprint(self, data):
"""生成数据指纹(用于去重)"""
if isinstance(data, dict):
# 提取关键字段生成指纹
key_fields = ['title', 'year', 'director']
fingerprint_data = {k: data.get(k) for k in key_fields}
fingerprint_str = json.dumps(fingerprint_data, sort_keys=True)
else:
fingerprint_str = str(data)
return hashlib.md5(fingerprint_str.encode()).hexdigest()
def is_duplicate(self, data):
"""检查是否重复"""
fingerprint = self.generate_fingerprint(data)
if fingerprint in self.fingerprint_cache:
return True
self.fingerprint_cache.add(fingerprint)
return False
def needs_update(self, video_id, update_interval=86400):
"""检查是否需要更新(基于时间间隔)"""
current_time = time.time()
last_time = self.last_crawl_time.get(video_id, 0)
return current_time - last_time > update_interval
五、法律与伦理注意事项
重要声明:
- 遵守Robots协议:检查
robots.txt,尊重网站规则 - 控制爬取频率:避免对目标网站造成负担
- 仅用于学习研究:不得用于商业用途
- 尊重版权:视频资源版权归原作者所有
- 数据使用限制:遵守相关法律法规
建议措施:
- 设置合理的爬取延迟(3-5秒/请求)
- 使用User-Agent明确标识爬虫身份
- 遵守网站的服务条款
- 考虑使用官方API(如果提供)
六、性能优化与监控
1. 爬虫性能监控
class CrawlerMonitor:
"""爬虫性能监控器"""
def __init__(self):
self.metrics = {
'requests_total': 0,
'requests_success': 0,
'requests_failed': 0,
'data_extracted': 0,
'avg_response_time': 0,
'start_time': time.time()
}
self.alert_thresholds = {
'failure_rate': 0.1, # 10%
'avg_response_time': 5.0, # 5秒
'request_rate': 10 # 10次/秒
}
def record_request(self, success, response_time):
"""记录请求指标"""
self.metrics['requests_total'] += 1
if success:
self.metrics['requests_success'] += 1
else:
self.metrics['requests_failed'] += 1
# 更新平均响应时间
current_avg = self.metrics['avg_response_time']
total_requests = self.metrics['requests_success'] + self.metrics['requests_failed']
self.metrics['avg_response_time'] = (
current_avg * (total_requests - 1) + response_time
) / total_requests
def check_alerts(self):
"""检查是否需要告警"""
alerts = []
# 计算失败率
total = self.metrics['requests_total']
if total > 0:
failure_rate = self.metrics['requests_failed'] / total
if failure_rate > self.alert_thresholds['failure_rate']:
alerts.append(f'高失败率: {failure_rate:.2%}')
# 计算请求速率
elapsed = time.time() - self.metrics['start_time']
request_rate = total / elapsed
if request_rate > self.alert_thresholds['request_rate']:
alerts.append(f'高请求频率: {request_rate:.2f}/秒')
# 检查响应时间
if self.metrics['avg_response_time'] > self.alert_thresholds['avg_response_time']:
alerts.append(f'响应时间过长: {self.metrics["avg_response_time"]:.2f}秒')
return alerts
总结:Libvio.link爬虫开发需要综合考虑反爬机制破解、性能优化、数据存储和法律合规。通过本文的技术方案,你可以构建一个稳定高效的爬虫系统,但务必遵守相关法律法规和网站规则。
如果您喜欢此文章,请收藏、点赞、评论,谢谢,祝您快乐每一天。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 13
 0
- 0


 已为社区贡献4条内容

所有评论(0)