一篇看懂:算力、TOPS、TFLOPS、FP32/FP16/INT8 全解析
作为 AI、深度学习领域的新人,刚接触硬件参数时,肯定会被各种算力单位和数据类型绕晕:TOPS、TFLOPS 到底啥区别?FP32、FP16、INT8 又是什么?它们和算力有啥关系?
今天就用最通俗的语言,把这些核心知识点一次性讲透,看完再也不踩坑!
一、先搞懂:算力到底按什么标准算?
算力的本质很简单,就是芯片单位时间内完成计算操作的次数,就像跑步的 “米 / 秒”、打字的 “字 / 分钟”,算力的核心衡量标准就是 “多少次计算 / 秒”。
不同芯片擅长的计算类型不同,有的擅长算整数,有的擅长算带小数点的数,所以衍生出了不同的算力单位,最常见的就是 TOPS 和 TFLOPS,二者不能直接混比,要对应不同的计算场景。
二、核心算力单位:TOPS vs TFLOPS
1. TOPS:整数算力的代表
TOPS 的全称是Tera Operations Per Second,拆解来看:
- OPS:Operations Per Second,即每秒完成的计算操作次数;
- T:Tera,代表 1 万亿(10¹²)。
所以1 TOPS = 每秒完成 1 万亿次整数运算。
它主要用于衡量AI 推理场景的算力,比如图像识别、目标检测、分类等边缘 AI 任务,像 Jetson 系列边缘开发板,标注算力时就常用 TOPS。
简单记:TOPS = 整数算力,看 AI 推理快不快。
2. TFLOPS:浮点算力的代表
TFLOPS 的全称是Tera Floating-point Operations Per Second,拆解来看:
- FLOPS:Floating-point Operations Per Second,即每秒完成的浮点运算(带小数点的数)次数;
- T:同样代表 1 万亿。
所以1 TFLOPS = 每秒完成 1 万亿次浮点运算。
它主要用于衡量深度学习训练、科学计算场景的算力,比如显卡、大型训练集群标注算力时,就常用 TFLOPS。
简单记:TFLOPS = 小数算力,看训练 / 科学计算强不强。
三、关键数据类型:FP32、FP16、INT8 详解
FP32、FP16、INT8 是深度学习中最常用的数据类型,它们决定了 “用多少位二进制存储一个数”,直接影响算力大小、计算速度和精度。下面从存储位数、小数点精度、实际区别、算力影响四个维度,把三者讲透。
1. INT8:8 位整数
- 存储规则:用 8 位二进制存储,只能表示整数,范围是 - 128~127,没有小数点,不存在 “小数点后几位” 的概念;
- 通俗举例:只能存 1、5、-10 这类整数,存不了 1.5、3.14 这类小数;
- 核心特点:占用空间最小,计算速度最快,精度最低(仅支持整数运算);
- 对应算力单位:TOPS;
- 适用场景:AI 推理(模型量化后常用,在保证精度损失极小的前提下,大幅提升推理速度、降低内存占用)。
2. FP16:16 位浮点
- 存储规则:用 16 位二进制存储小数,其中1 位符号位、5 位指数位、10 位尾数位,小数点后能保留约 3~4 位有效数字;
- 通俗举例:能存 3.14、0.005、-2.7 这类小数,但如果是 3.1415926,会近似存为 3.1416,小数点后第 5 位会四舍五入;
- 核心特点:速度快,显存 / 内存占用小,平衡了速度与精度;
- 对应算力单位:TFLOPS;
- 适用场景:深度学习训练、推理都常用(混合精度训练的核心数据类型,既能保证训练效果,又能提升速度)。
3. FP32:32 位浮点
- 存储规则:用 32 位二进制存储小数,其中1 位符号位、8 位指数位、23 位尾数位,小数点后能保留约 6~7 位有效数字;
- 通俗举例:能精准存 3.1415926、0.0001234、-5.678901 这类小数,小数点后前 7 位基本不会丢失精度;
- 核心特点:精度最高,但计算速度最慢,占用空间最大(是 FP16 的 2 倍、INT8 的 4 倍);
- 对应算力单位:TFLOPS;
- 适用场景:科学计算、部分对精度要求极高的训练 / 推理任务(比如医学影像分析、高精度数值模拟)。
三者核心区别与算力影响总结
| 数据类型 | 存储位数 | 小数点精度 | 核心特点 | 算力表现 |
|---|---|---|---|---|
| INT8 | 8 位 | 无(仅整数) | 最小、最快、精度低 | 同芯片下算力最高 |
| FP16 | 16 位 | 约 3~4 位有效数字 | 速度与精度平衡 | 算力中等 |
| FP32 | 32 位 | 约 6~7 位有效数字 | 最大、最慢、精度高 | 同芯片下算力最低 |
对算力的核心影响:数据类型位数越少,芯片一次能并行处理的计算次数越多,算力自然越高。比如同一块芯片,INT8 算力通常是 FP16 的 2 倍、FP32 的 4 倍 —— 因为 INT8 占 8 位,芯片一次能处理 4 个 INT8 数据,而 FP32 占 32 位,一次只能处理 1 个,算力差距就此拉开。
四、数据类型与算力的关系:越小越快,算力越高
很多新人会疑惑:为什么同一块芯片,INT8 算力比 FP32 高这么多?核心原因就在于数据类型的位数。
数据类型的位数越少,芯片一次能并行处理的计算次数就越多,算力自然越高。同一块芯片的算力规律是:INT8 算力 > FP16 算力 > FP32 算力。
举个直观的例子:
- 算 INT8(8 位):芯片一次能处理 8 个数据,算力达到峰值;
- 算 FP16(16 位):芯片一次只能处理 4 个数据,算力减半;
- 算 FP32(32 位):芯片一次仅能处理 2 个数据,算力最低。
这也是为什么 AI 推理常用 INT8,训练常用 FP16,高精度计算才用 FP32 的原因。
五、实战结合:从硬件算力到模型推理速度
我们先来看这张 YOLO26 系列模型的性能对比表,它直观展示了不同尺寸模型在精度、速度、计算量上的差异,是我们理解 “硬件算力” 和 “模型计算量” 关系的绝佳例子:
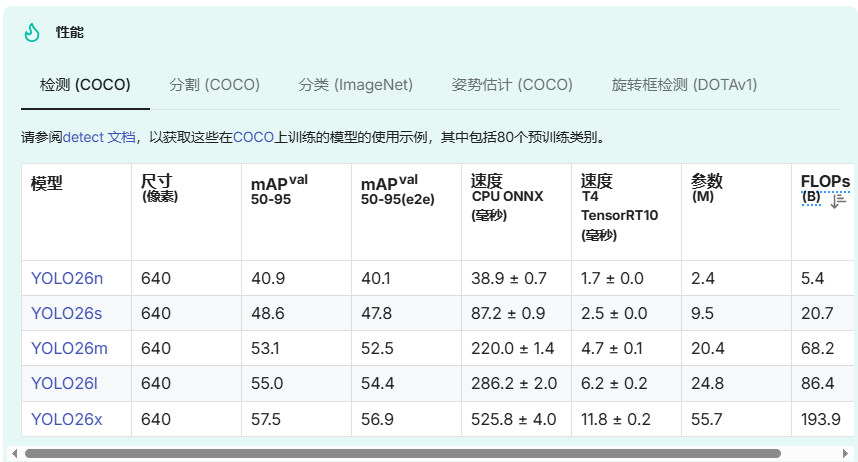
这张表是 YOLO26 系列(n/s/m/l/x 从最小到最大)在 COCO 数据集上的实测结果,其中最关键的一列是 FLOPs(B),它代表每个模型完成一次推理(输入一张 640×640 图片)需要的浮点运算次数(单位是十亿次)。
1. 先看 Jetson AGX Orin 的硬件算力(FLOPS)
Jetson AGX Orin 作为边缘 AI 硬件,它的算力是硬件本身的 “速度指标”,表示每秒能完成多少次浮点运算,官方参数如下:
- FP16(半精度浮点)算力:约 6.666 TFLOPS(每秒 6.666 万亿次浮点运算)
- FP32(单精度浮点)算力:约 3.333 TFLOPS(每秒 3.333 万亿次浮点运算)
- INT8(整数)算力:200~275 TOPS(对应边缘 AI 推理场景)
简单记:硬件算力(FLOPS)就像你的 “跑步速度”,比如每秒能跑 10 米。
2. 再看模型计算量(FLOPs)
表中的 FLOPs(B) 是模型的 “工作量指标”,表示完成一次推理需要多少次浮点运算。比如:
- YOLO26n(最小模型):5.4B → 一次推理需要 5.4 十亿次浮点运算
- YOLO26s(中等模型):20.7B → 一次推理需要 20.7 十亿次浮点运算
- YOLO26x(最大模型):193.9B → 一次推理需要 193.9 十亿次浮点运算
简单记:模型计算量(FLOPs)就像你要跑的 “路程”,比如跑 100 米需要 100 步。
3. 两者的核心区别:速度 vs 工作量
| 概念 | 通俗类比 | 单位 | 例子(来自表格 + 硬件) |
|---|---|---|---|
| 硬件算力(FLOPS) | 跑步速度(每秒跑多少米) | TFLOPS(万亿次 / 秒) | Jetson AGX Orin FP16 算力:6.666 TFLOPS |
| 模型计算量(FLOPs) | 跑步距离(跑完需要多少米) | B(十亿次) | YOLO26s 的 FLOPs:20.7B(20.7 十亿次) |
4. 两者的关系:硬件算力 × 时间 = 模型计算量
就像 “跑步速度 × 跑步时间 = 跑步距离”,硬件算力和模型计算量的关系可以用公式表示:理论推理速度(FPS,每秒处理图片数)= 硬件算力(FLOPS) ÷ 模型计算量(FLOPs)
用 Jetson AGX Orin + YOLO26 系列举例:
我们用 Orin 的 FP16 算力(6.666 TFLOPS = 6.666×10¹² 次 / 秒)来计算不同模型的理论 FPS:
| 模型 | 模型计算量(FLOPs) | 理论 FPS(每秒处理图片数) | 实际意义 |
|---|---|---|---|
| YOLO26n | 5.4B(5.4×10⁹ 次 / 张) | 6.666×10¹² ÷ 5.4×10⁹ ≈ 1234 FPS | 速度极快,适合对延迟要求极高的场景(如实时机器人视觉) |
| YOLO26s | 20.7B(20.7×10⁹ 次 / 张) | 6.666×10¹² ÷ 20.7×10⁹ ≈ 322 FPS | 速度与精度平衡,适合大多数边缘推理场景 |
| YOLO26x | 193.9B(193.9×10⁹ 次 / 张) | 6.666×10¹² ÷ 193.9×10⁹ ≈ 34 FPS | 刚好满足实时需求(通常 30 FPS 以上为实时),适合对精度要求高的场景 |
注:这是理论值,实际推理速度会受内存带宽、软件优化(如 TensorRT)、模型量化等因素影响。比如表格中 YOLO26s 在 T4 显卡上的速度是 2.5 毫秒(约 400 FPS),而在 Orin 上实际跑 TensorRT 优化后可能在 100~200 FPS 左右,比理论值低,但依然远高于实时要求。
5. 实际意义:选模型、配硬件的核心逻辑
- 如果你的硬件算力(FLOPS)固定(比如用 Jetson AGX Orin),模型计算量(FLOPs)越小,推理速度越快,越适合边缘场景;
- 如果你的模型计算量(FLOPs)固定(比如选 YOLO26x),硬件算力(FLOPS)越高,推理速度越快,越适合高性能场景。
这也是为什么表格中 YOLO26n 速度最快、YOLO26x 速度最慢的原因 —— 计算量直接决定了硬件需要 “跑多远”。
六、总结:核心要点
最后把所有知识点浓缩成 7 句话,记牢这几句就够:
- 算力 = 芯片每秒完成的计算次数;
- TOPS 是整数算力,对应 INT8,主打 AI 推理;
- TFLOPS 是浮点算力,对应 FP16/FP32,主打训练 / 科学计算;
- INT8:8 位整数,无小数点,最快、最小、精度最低;
- FP16:16 位浮点,小数点后约 3~4 位精度,速度与精度平衡,最常用;
- FP32:32 位浮点,小数点后约 6~7 位精度,精度最高、最慢、占用最大;
- 同芯片算力:INT8 > FP16 > FP32。
写在最后
理解算力和数据类型,是选硬件、做 AI 开发的基础。不管是选显卡做训练,还是选边缘板做部署,先明确自己的场景是推理还是训练,再对应看 TOPS 或 TFLOPS,结合数据类型的特点,就能精准判断硬件是否满足需求。
如果觉得这篇文章对你有帮助,欢迎点赞、收藏、关注,后续会分享更多 AI 硬件选型、深度学习入门的干货!

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 21
 0
- 0


 已为社区贡献1条内容

所有评论(0)