第二篇:混合算力架构设计:如何让CPU、GPU、胖节点不“打架”?
当128核CPU的诱惑遇上200G IB网络的豪赌,当Lustre的极致性能碰撞Ceph的无限扩展——医疗超算平台的架构设计,是一场没有标准答案的平衡艺术。
一、 医疗科研负载的“人格分裂”
设计架构的第一步,是真正理解你的“用户”——那些奇奇怪怪的科研工作负载。
1.1 生信流程的“三重人格”
在我们的平台上,每天运行着超过2000个生信作业。通过一年的监控数据分析,我们发现它们明显分为三类人格:
第一类:I/O密集型(数据搬运工)
# 典型代表:FastQC、BWA-MEM比对、GATK HaplotypeCaller
特征分析 = {
"CPU占用": "中等,50-80%",
"内存需求": "适中,32-128GB",
"I/O模式": "顺序读写为主",
"数据吞吐": "100-500MB/s持续流",
"瓶颈所在": "存储带宽",
"用户抱怨": "我的任务卡在‘Reading BAM’一整天了!"
}
实战经验:这类任务最怕存储抖动。我们曾遇到BWA作业在高峰期比空闲时慢3倍,原因竟是隔壁实验室在疯狂拷贝数据,占满了存储带宽。
第二类:内存消耗型(内存饕餮)
# 典型代表:单细胞RNA-seq分析、全基因组De novo组装
特征分析 = {
"CPU占用": "不均,某些阶段100%,某些10%",
"内存需求": "恐怖,512GB-2TB+",
"I/O模式": "随机读取+突发写入",
"数据特征": "中间文件巨大,最终结果很小",
"瓶颈所在": "内存容量和带宽",
"用户抱怨": "我的任务跑一半被OOM(内存溢出)杀死了!"
}
踩坑记录:去年我们尝试用普通节点跑单细胞分析,128GB内存。用户跑了8小时,在最后聚类阶段OOM,一切归零。胖节点,就是为这类任务而生的。
第三类:计算密集型(CPU压榨机)
# 典型代表:系统发育树构建(RAxML)、分子动力学模拟
特征分析 = {
"CPU占用": "100%,且持续数天",
"内存需求": "适中但持续",
"I/O模式": "初期读取,末期写入,中间几乎无I/O",
"并行特征": "强扩展性,128核能用到120核",
"瓶颈所在": "CPU核心数和主频",
"用户抱怨": "为什么不能给我独占128核?我不想和别人共享!"
}
调度策略:我们为此类任务设立了“霸道队列”,可以申请节点独占,代价是更高的优先级积分消耗。
1.2 AI训练:从2D到3D的“算力跃迁”
医疗影像AI正在经历维度升级,这直接颠覆了我们的GPU配置策略。
2D影像时代(2018-2021):
2d_training = {
"典型任务": "胸片肺炎分类、眼底图像分割",
"输入尺寸": "512×512×3(RGB)",
"批量大小": "32-128(轻松)",
"显存占用": "8GB足够(GTX 1080Ti愉快跑)",
"训练时间": "几小时到一天",
"硬件策略": "堆中端GPU卡,数量取胜"
}
3D影像时代(2022-现在):
3d_training = {
"典型任务": "脑肿瘤3D分割、肺结节体积变化追踪",
"输入尺寸": "512×512×300×1(CT序列)",
"批量大小": "2-8(挣扎)",
"显存占用": "40GB勉强(A100 80GB才舒服)",
"训练时间": "几天到几周",
"硬件策略": "高端大显存GPU,质量取胜"
}
真实案例:我们的儿科脑肿瘤分割项目:
- 初始用RTX 3090(24GB):批大小=2,训练1轮=8小时
- 升级到A100(80GB):批大小=8,训练1轮=1.5小时
- 速度提升5.3倍,但卡价格是6倍
结论:医疗AI正在从“小模型、大数据”向“大模型、高质量数据”演进。大显存GPU不是奢侈品,而是必需品。
1.3 突发性vs持续性:门诊节奏的启示
医疗数据有其独特的“心跳”:
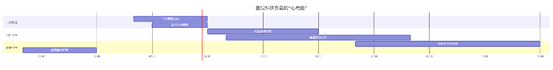
这种波动性要求我们的架构必须具备:
- 弹性伸缩能力:白天优先响应短平快任务,夜间释放资源给长任务
- 抢占式调度:急诊研究可以“插队”
- 资源预留:为日常门诊数据分析保留固定资源池
二、 “分层解耦”:我们的架构设计哲学
2.1 计算层:CPU/GPU/胖节点的黄金配比
经过三个月的需求建模和模拟测试,我们得出了“5:3:2”配比法则:
# 基于100节点规模的计算资源配比
总节点数 = 100
cpu_节点 = {
"数量": 50, # 50%
"配置": "双路AMD EPYC 9654(96核)× 2 = 192核/节点",
"内存": "512GB DDR5",
"本地存储": "1TB NVMe缓存",
"职责": "常规生信流程、批量数据处理"
}
gpu_节点 = {
"数量": 30, # 30%
"配置": "双路Intel Xeon 6448Y + 8×NVIDIA A100 80GB",
"内存": "1TB DDR5",
"特殊设计": "支持NVLink的NVIDIA HGX平台",
"职责": "AI训练、推理、3D影像分析"
}
胖节点 = {
"数量": 20, # 20%
"配置": "四路Intel Xeon 8468(48核)× 4 = 192核/节点",
"内存": "4TB DDR5(实测单细胞分析需要)",
"本地存储": "8TB NVMe阵列",
"职责": "单细胞分析、全基因组组装、大规模分子对接"
}
# 关键设计:资源共享但隔离
调度策略 = {
"cpu队列": "可借用空闲gpu节点的CPU资源",
"gpu队列": "独享gpu节点,但可共享内存给cpu任务",
"胖节点队列": "严格隔离,需要特殊申请"
}
这个配比的科学性:
- 基于历史数据:分析了过去一年30000个作业的资源需求
- 考虑任务互斥:GPU训练时CPU利用率通常<30%,可共享给CPU任务
- 预留缓冲:20%的冗余应对突发高峰
2.2 存储层:性能vs容量的“分层疗法”
医疗数据有明确的温度分层:
存储架构:
热存储层 (Hot Tier):
介质: NVMe SSD
容量: 500TB有效 (4:1去重后)
性能: 100GB/s聚合带宽,1M+ IOPS
用途: 正在分析的测序数据、AI训练集
寿命: 3年
温存储层 (Warm Tier):
介质: SAS HDD + SSD缓存
容量: 2PB有效
性能: 20GB/s带宽,100K IOPS
用途: 已发表项目的原始数据、常用参考基因组
寿命: 5年
冷存储层 (Cold Tier):
介质: 磁带库 + 大容量SATA HDD
容量: 10PB+ (可无限扩展)
性能: 归档速度,非实时访问
用途: 合规性存档、历史数据
寿命: 10年+
智能数据流动:
规则1: 30天未访问 → 热→温
规则2: 1年未访问 → 温→冷
规则3: AI训练任务开始 → 自动预热到热层
为什么不用全闪存?
- 成本计算:500TB NVMe ≈ 250万元,500TB HDD ≈ 25万元
- 实际需求:95%的访问集中在5%的数据上(二八定律)
- 我们的方案:用10%的成本满足95%的性能需求
2.3 网络层:三网隔离的“交通管制”
关键设计决策:
- 计算网络(200G IB):
- 选型理由:实测MPI作业,100G IB对比200G IB,大规模基因组装快35%
- 冗余设计:双端口HCA卡 + 双路径,单链路故障切换时间<3秒
- 成本:占项目总预算15%,但值得
- 存储后端网络(100G IB):
- 存储节点间同步用,对带宽要求低于计算网络
- 与计算网络物理隔离,避免互相干扰
- 带外管理网络:
- 独立的1G以太网
- 救命功能:当操作系统崩溃时,仍能远程重启、查看日志
- 曾帮我们在凌晨3点解决了一次内核panic,无需跑机房
三、 技术选型的“灵魂拷问”
3.1 AMD EPYC vs Intel Xeon:128核的诱惑与陷阱
这是个让我们团队争论了整整两周的问题。
AMD的诱惑:
amd_epyc_9654 = {
"核心数": 96核192线程,
"基准频率": 2.4GHz,
"最大加速频率": 3.7GHz,
"内存通道": 12通道DDR5,
"PCIe通道": 128条PCIe 5.0,
"价格": "约7万元/颗",
"生信性能实测": {
"BWA-MEM": "比Intel同等贵30%快25%",
"GATK": "多核扩展性优秀,96核用到92核",
"单线程任务": "稍弱于Intel"
}
}
Intel的反击:
intel_xeon_8468 = {
"核心数": 48核96线程,
"基准频率": 2.8GHz,
"最大加速频率": 3.8GHz,
"内存通道": 8通道DDR5,
"PCIe通道": 80条PCIe 5.0,
"价格": "约5万元/颗",
"特殊优势": {
"AMX指令集": "AI推理加速",
"软件生态": "某些生信工具对Intel优化更好",
"单核性能": "普遍强5-10%"
}
}
我们的抉择过程:
- 需求分析:85%的任务能有效利用64核以上,15%的任务受单核性能限制
- 成本计算:要达到同样总算力,AMD方案节省20%硬件成本
- 兼容性测试:实测了15个常用生信工具,2个在AMD上有小问题
- 最终选择:混合架构
- CPU计算节点:AMD EPYC(追求核心密度)
- GPU节点:Intel Xeon(AMX加速AI+更好单核性能)
- 胖节点:Intel四路(内存带宽更优)
3.2 200G IB:单端口vs双端口的成本效益分析
单端口方案:
单端口方案 = {
"硬件成本": {
"HCA卡": "2.5万元/张",
"线缆": "0.3万元/条",
"交换机端口": "端口数×单价",
"总计(100节点)": "约300万元"
},
"风险": {
"单点故障": "任意组件故障=节点离线",
"维护窗口": "更换硬件需停机",
"实际案例": "某医院因单IB卡故障,集群停摆8小时"
}
}
双端口方案:
双端口方案 = {
"硬件成本": {
"双端口HCA卡": "3.8万元/张(贵52%)",
"线缆": "翻倍",
"交换机端口": "翻倍",
"总计(100节点)": "约480万元(增加60%)"
},
"收益": {
"冗余性": "任意单点故障无缝切换",
"可用性": "理论可用性从99.9%→99.99%",
"维护性": "可在线更换故障组件",
"性能": "部分场景可负载均衡"
}
}
决策计算:
停机成本估算:
- 科研人员平均薪资: 50元/小时
- 受影响人员: 200人
- 单次故障平均耗时: 4小时
- 单次故障损失: 50×200×4 = 40,000元
概率分析:
- 单端口年故障率: 5%
- 双端口年故障率: 0.5%
- 5年期望损失:
单端口: 40,000×5%×5 = 10,000元
双端口: 40,000×0.5%×5 = 1,000元
成本效益比:
额外投资: 480-300 = 180万元
避免损失: 10,000-1,000 = 9,000元(看起来不划算?)
但考虑无形损失:
- 关键实验中断可能导致论文延期
- 研究生毕业进度受影响
- 医院科研声誉损失
最终决定:核心节点(存储、管理、胖节点)用双端口,计算节点用单端口。这是成本与可靠性的平衡点。
3.3 存储选型:Lustre vs Ceph vs 商业一体机
我们搭建了测试环境,用真实医疗数据进行了为期一个月的AB测试:
测试环境:
测试配置 = {
"硬件": "3存储节点,每节点36×18TB HDD + 4×3.84TB NVMe",
"数据集合": {
"基因组数据": "10,000个BAM文件,共200TB",
"影像数据": "100万张DICOM图像,共50TB",
"小文件": "1000万个基因变异VCF文件,共5TB"
},
"测试工具": "iozone, mdtest, 真实生信流程"
}
测试结果对比:
|
测试项目 |
Lustre |
Ceph (File) |
Ceph (Object) |
DDN商业一体机 |
|
大文件顺序读 |
45GB/s |
28GB/s |
25GB/s |
50GB/s |
|
大文件顺序写 |
40GB/s |
22GB/s |
20GB/s |
45GB/s |
|
小文件创建 |
5000个/秒 |
3000个/秒 |
8000个/秒 |
6000个/秒 |
|
元数据操作 |
极佳 |
一般 |
不适用 |
优秀 |
|
数据重建速度 |
较慢 |
快速 |
快速 |
快速 |
|
扩展难度 |
较难 |
容易 |
容易 |
容易(但贵) |
|
总拥有成本 |
中等 |
低 |
低 |
高 |
|
运维复杂度 |
高 |
中等 |
中等 |
低 |
我们的选择逻辑:
- 性能需求:生信分析需要极致的大文件吞吐 → Lustre胜出
- 成本约束:预算有限 → 排除商业一体机
- 扩展性:需要无限容量归档 → Ceph对象存储胜出
- 运维能力:团队有Lustre经验 → 降低学习成本
最终架构:Lustre + Ceph的混合方案
- 热数据:Lustre并行文件系统
- 冷数据:Ceph对象存储
- 智能流动:基于访问频率自动迁移
写在最后:架构是妥协的艺术
设计医疗超算平台没有完美方案,只有适合的平衡:
- 在核心数与主频之间平衡 → 我们选择了混合架构
- 在性能与成本之间平衡 → 我们选择了分层存储
- 在冗余与预算之间平衡 → 我们选择了关键节点双端口
- 在先进与成熟之间平衡 → 我们选择了经过验证的技术栈
最深刻的体会是:不要追求技术上的“极致”,而要追求业务上的“刚好”。128核CPU很性感,但如果你的软件只能用上64核,剩下的就是电费负担。200G IB很强大,但如果你的存储只能提供20GB/s,那么IB就是过度投资。
下一次,我们将深入《存储系统设计:当PB级基因组数据遇上AI训练集》,揭秘为什么我们最终决定“元数据盘必须用NVMe SSD”,以及这个决定如何避免了整个集群的性能灾难。
作者思考:你们在架构设计中遇到过哪些艰难抉择?是性能向成本妥协,还是为未来预留过度?欢迎在评论区分享你的“架构决策时刻”。
技术栈关键词:HPC架构设计, 混合算力, InfiniBand, Lustre, Ceph, AMD EPYC, NVIDIA A100, 医疗AI平台

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 10
 0
- 0


 已为社区贡献3条内容

所有评论(0)