全模态全领域知识库智能体构建指南:企业在上下文时代如何打造独特竞争优势?
【收藏必备】构建企业上下文智能体系统,打造AI时代不可复制的竞争优势 | 程序员必学指南
文章阐述了从"知识时代"到"上下文时代"的转变,指出企业竞争优势在于构建专属的"上下文智能体系统"。这一系统需通过数据融合、动态图谱、权限治理、智能体编排和反馈闭环五大支柱构建。企业需让员工转变为"智能体管理者",系统性构建和维护上下文知识库,才能在AI浪潮中保持独特竞争优势。
——致2026年首席智能官(CAIO )
引言:从“知识时代”到“上下文时代”
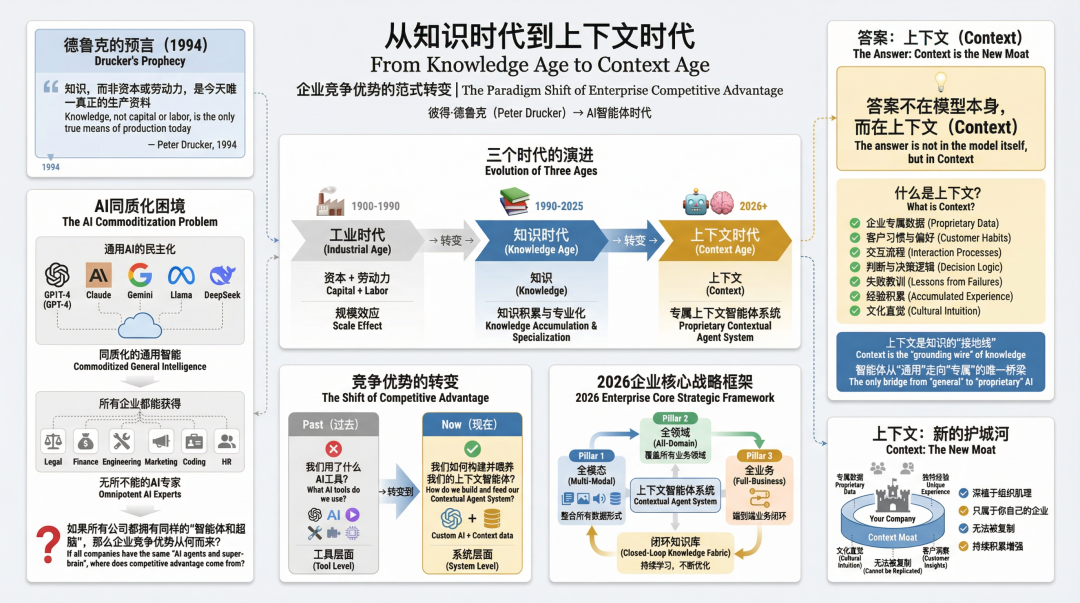
彼得·德鲁克是知识工作者一词的定义者,德鲁克曾断言:“知识,而非资本或劳动力,是今天唯一真正的生产资料。” 在1994年写下这句话时,他或许无法想象短短三十年后,知识不仅被编码、被存储,更被“agent”——由人工智能智能体(AI Agents)主动调用、推理、执行。如今,我们已站在德鲁克预言的终点,也站在一个新纪元的起点:上下文时代(The Age of Context)。
在这一时代,算力不再是稀缺资源,模型架构也不再是护城河。OpenAI、Anthropic、Meta、Gemini、DeepSeek、Qwen、GLM等已将通用智能推向近乎同质化的高点。任何一家初创公司都能在一天之内接入与高盛、摩根士丹利、微软、英伟达、亚马逊相同的AI专家——法律、金融、工程、营销、财务、HR、写代码等等,无所不能。
但问题来了:如果所有公司都拥有同样的“智能体和超脑”,那么企业竞争优势从何而来?
答案不在模型本身,而在上下文(Context)——那些只属于你自己的企业、无法被复制、深植于组织肌理的数据,客户谈判和付款习惯、交互流程、判断、失败教训、经验、客户语境与文化直觉。上下文,是知识的“接地线”,是智能体从“通用”走向“专属”的唯一桥梁。
因此,2026开启的企业的核心战略,不仅仅再是“我们用了什么AI工具”,而是“我们如何构建并喂养我们的上下文智能体系统(Contextual Agent System)”,并以此打造一个全模态、全领域、全业务的闭环知识库(Closed-Loop Knowledge Fabric)。
一、何谓“上下文智能体”?
许多人误以为“上下文”就是RAG(Retrieval-Augmented Generation)——把PDF喂给大模型,让它回答问题。但这只是婴儿学步。
真正的上下文智能体,是一个动态、多模态、有记忆、有权限、可协作、可演化的组织级智能层。它不是单一工具,而是一整套系统:
- 感知层:实时接入企业所有数据源——CRM、ERP、Slack、邮件、会议录音、代码仓库、客户支持工单、产品使用日志、财务系统、HRIS、内部Wiki、甚至离线会议手写笔记的OCR扫描件。
- 理解层:将异构数据统一为“事实图谱”(Factual Graph),而非孤立文档。例如,一个客户投诉不仅是一条Zendesk工单,它关联到该客户的合同条款、历史交互、产品使用模式、销售承诺、内部讨论线程。
- 推理层:智能体基于上下文进行跨域推理。比如,法务智能体在审查合同时,自动调取财务系统中的付款条款、销售系统的客户等级、产品路线图中的交付时间,生成风险评估。
- 执行层:智能体不仅能“说”,还能“做”——创建Jira任务、更新Notion页面、起草邮件、调用API、甚至发起审批流。
- 学习层:每一次人类对智能体输出的修正、确认或否决,都会反馈回系统,形成强化学习闭环,使上下文越来越精准。
这不再仅仅是“AI助手”,而是企业组织的数字孪生神经系统,是企业的数字员工,是企业各位的默默无闻的同事、伙伴。
二、为什么传统知识管理失灵?因为“知识”不是静态资产,而是动态上下文流
过去三十年,企业知识管理(KM)几乎是一场集体幻觉。企业建了Confluence、SharePoint、Notion,各种大大小小的OA等等,但知识库90%的内容过时、无人维护、无法检索。为什么?
因为传统KM犯了一个根本错误:把知识当作“文档”来管理,而非“上下文”来激活。
文档是死的。与企业业务和组织信息上下文是活的。
- 惠普前CEO Lew Platt说:“如果HP知道HP知道的,生产力将提高三倍。” 这句话的潜台词是:知识分散在人的头脑、邮件线程、Excel表格、Slack频道里,从未被整合成可操作的上下文。
- 一个销售新人无法知道三年前某次关键客户会议中,CEO私下承诺了什么交付时间——因为那条信息只存在于某位离职员工的Outlook邮件里。
- 一个产品经理无法理解为什么某功能被砍掉——因为决策记录散落在20个不同会议的录音和笔记中,无人整理。
AI智能体的出现,第一次让“整合企业级所有上下文”成为可能。但前提是:企业必须重构其AI数据架构与组织语境流程,以适配企业级智能体的需求。
三、构建智能体闭环知识库的五大支柱
打造真正属于企业的上下文智能体系统,须围绕以下五大支柱系统化建设:
1. 全模态数据融合引擎(Omni-Modal Ingestion Engine)
智能体需要处理文本、语音、图像、表格、代码、视频、甚至传感器数据。系统包括:
- 自动转录会议录音(Zoom、Teams、钉钉、微信、飞书及企业五花八门的OA),并提取决策点、待办事项、关键术语和企业各种内部黑话行话口头禅和习俗。
- 解析企业级别的各种采购销售人事工程法务财务等PDF合同、扫描件、手写笔记,转化为结构化实体。
- 将Slack/Teams/钉钉、微信、飞书/OA对话按项目、客户、主题聚类,识别隐性知识。
- 从代码提交、CI/CD日志中提取工程上下文。
- 连接企业相关的各种外部数据:行业报告、竞品动态、国家和行业协会监管文件,作为补充上下文。
技术栈建议:结合LlamaIndex、Unstructured.io、Whisper、LangChain、专用OCR与NLP流水线,构建“数据摄入工厂”。
2. 动态上下文图谱(Dynamic Context Graph)
不要用关键词搜索,要用关系和图推理。
-
每个实体(客户、员工、产品、项目、合同)都是图谱中的节点。
-
每次交互、文档、决策都成为边(edge),带有时间戳、置信度、来源。
-
智能体提问“为什么客户X取消订单?”时,系统返回的不是文档列表,而是一条推理路径:
客户X → 收到延迟通知(邮件2025-11-03) → 支持工单#4521(不满交付) → 产品经理Y在Slack说‘供应链问题持续到Q1’ → 合同第7条允许取消
技术实现:Neo4j、Amazon Neptune、或自研向量+图混合引擎。
3. 智能体权限与治理层(Agent Governance Fabric)
上下文强大,但危险。你不能让营销智能体直接访问企业员工薪酬数据,也不能让实习生智能体修改财务报表并发布。
- 实现细粒度上下文权限:基于角色、项目、数据敏感度动态过滤可访问上下文。
- 每次智能体调用都记录决策溯源(Audit Trail):用了哪些数据?为何得出此结论?
- 建立人机协同(**人类-in-the-loop)**机制:高风险操作(如合同签署、大额支付/退款等等)必须人工确认。
- 符合GDPR、HIPAA、SOX等合规要求,自动脱敏敏感字段。
关键原则:上下文自由流动,但受控于组织安全和治理策略。
4. 智能体编排协作协议(Agent Orchestration Protocol)
企业不会只有一个智能体,而是一大群智能体组成的“数字员工团队”:
- 销售智能体发现客户有新需求 → 自动调用产品智能体检查功能路线图 → 若无,触发战略智能体生成市场机会报告 → 同时通知法务智能体预审可能的合规风险。
- 所有智能体共享同一上下文图谱,但各有专业边界。
- 通过自然语言工作流引擎(如LangGraph、Microsoft AutoGen)协调任务分配、冲突解决、优先级排序。
隐喻:就像交响乐团,每个乐手(智能体)精通一种乐器,但共享同一份乐谱(上下文)。
5. 上下文反馈人机协同闭环(Context Feedback Loop)
最强大的系统,能从失败中学习。
- 当人类否决智能体的建议时,系统记录“为什么”——是因为上下文缺失?推理错误?数据过时?
- 这些反馈自动触发上下文更新任务:例如,若法务多次修正智能体对“不可抗力条款”的理解,则系统标记该条款需重新标注,并通知知识管理员。
- 智能体的表现(准确性、效率、用户满意度)成为上下文质量的晴雨表,驱动持续优化。
四、组织变革:从“员工”到“智能体管理者”
技术只是50%。另一半是人。
在上下文时代,每个员工的新角色是:智能体管理者(Agent Manager)。
- 个人贡献者(IC) 不再写周报,而是训练自己的“工作智能体”:设定目标、提供上下文、审核输出、迭代策略。
- 中层管理者 变成“智能体编排师”:协调跨职能智能体团队,解决冲突,优化工作流。
- 高管 的核心KPI变成:“我们的上下文资产是否足够丰富、准确、可访问?” 而非“我们用了多少AI工具”。
这要求企业:
- 重新设计智能体JD岗位说明书,加入“上下文维护”职责。
- 建立“上下文质量”指标:如上下文覆盖率、更新频率、智能体贴合度。
- 投资内部“上下文工程师”团队——他们不是数据科学家,而是组织知识的架构师。
文化转变:从“我知道什么”到“我的智能体能访问什么”。
五、案例:某全球制药公司如何用上下文智能体加速新药研发
一家Top 5制药公司面临研发瓶颈:每年投入200亿美元,但新药上市周期长达12年。
他们构建了研发上下文智能体平台:
- 数据融合:整合实验室笔记、临床试验数据、专利库、FDA批文、科学家Slack讨论、会议录音、甚至文献PDF。
- 上下文图谱:将“靶点-化合物-副作用-患者亚群-监管路径”全部关联。
- 智能体协作:
- 发现智能体 提出新分子结构。
- 毒理智能体 模拟潜在副作用。
- 合规智能体 预审FDA申报路径。
- 市场智能体 预测定价与医保覆盖。
- 结果:候选药物筛选时间从18个月缩短至5个月,临床试验设计效率提升40%。
关键不是AI多聪明,而是上下文多完整。
六、上下文知识库是企业参与竞争护城河
德鲁克说知识是竞争优势。
在AI时代,上下文是知识的唯一载体。
那些能系统性构建、维护、演进其上下文知识库的企业,将:
- 比竞争对手更快决策
- 以更低的成本提供更个性化的服务
- 将组织经验转化为可复用的智能资产
- 在AI浪潮中不被“通用智能”同质化
而那些继续把知识锁在PDF、邮件和人脑中的公司,将沦为AI时代的“知识佃农”——租用别人的智能,却无法积累自己的上下文。
最后唠两句
为什么AI大模型成为越来越多程序员转行就业、升职加薪的首选
很简单,这些岗位缺人且高薪
智联招聘的最新数据给出了最直观的印证:2025年2月,AI领域求职人数同比增幅突破200% ,远超其他行业平均水平;整个人工智能行业的求职增速达到33.4%,位居各行业榜首,其中人工智能工程师岗位的求职热度更是飙升69.6%。
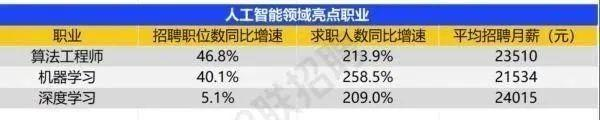
AI产业的快速扩张,也让人才供需矛盾愈发突出。麦肯锡报告明确预测,到2030年中国AI专业人才需求将达600万人,人才缺口可能高达400万人,这一缺口不仅存在于核心技术领域,更蔓延至产业应用的各个环节。
那0基础普通人如何学习大模型 ?
深耕科技一线十二载,亲历技术浪潮变迁。我见证那些率先拥抱AI的同行,如何建立起效率与薪资的代际优势。如今,我将积累的大模型面试真题、独家资料、技术报告与实战路线系统整理,分享于此,为你扫清学习困惑,共赴AI时代新程。
我整理出这套 AI 大模型突围资料包【允许白嫖】:
-
✅从入门到精通的全套视频教程
-
✅AI大模型学习路线图(0基础到项目实战仅需90天)
-
✅大模型书籍与技术文档PDF
-
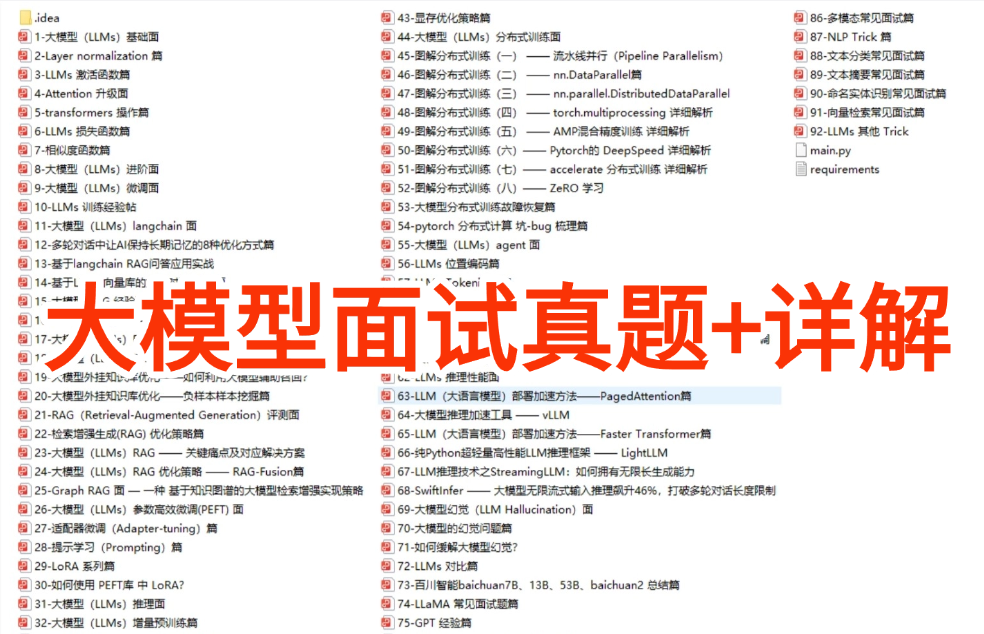
✅各大厂大模型面试题目详解
-
✅640套AI大模型报告合集
-
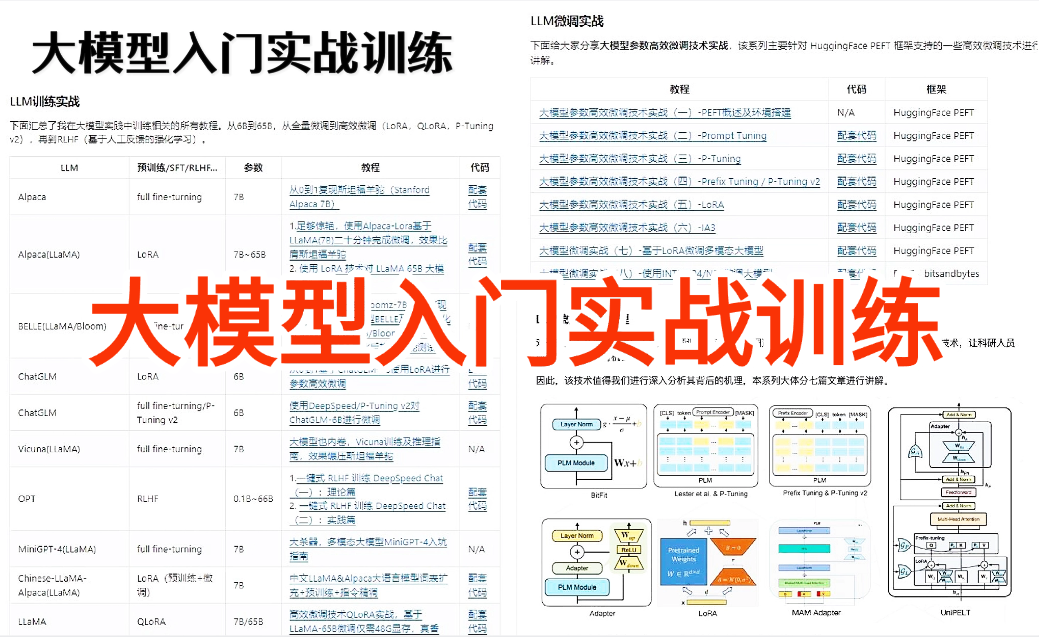
✅大模型入门实战训练
这份完整版的大模型 AI 学习和面试资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

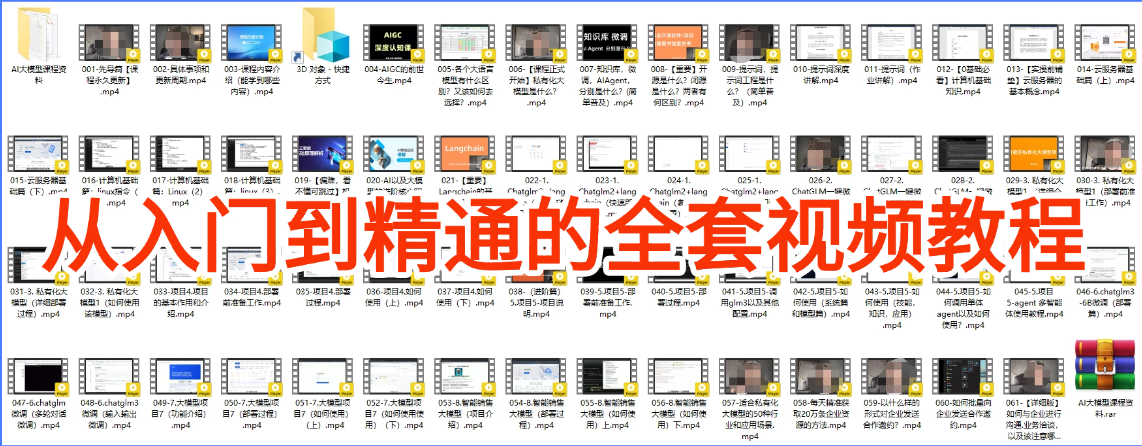
①从入门到精通的全套视频教程
包含提示词工程、RAG、Agent等技术点
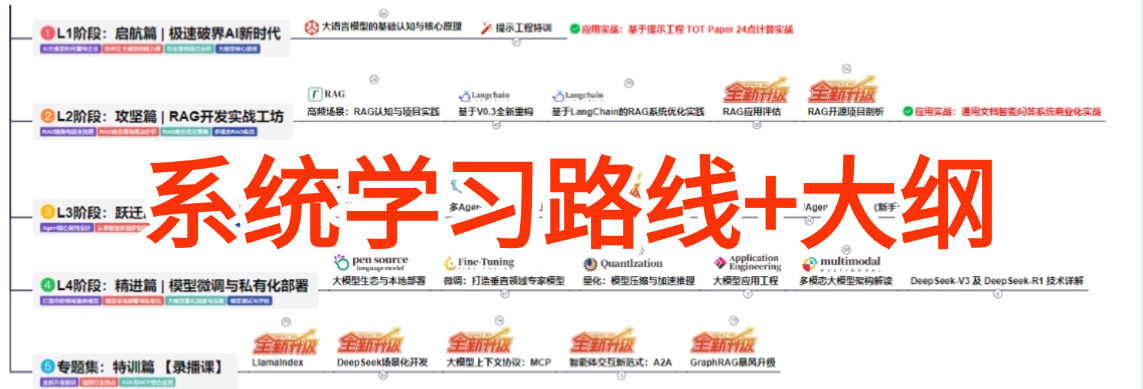
② AI大模型学习路线图(0基础到项目实战仅需90天)
全过程AI大模型学习路线
③学习电子书籍和技术文档
市面上的大模型书籍确实太多了,这些是我精选出来的
④各大厂大模型面试题目详解
⑤640套AI大模型报告合集
⑥大模型入门实战训练
如果说你是以下人群中的其中一类,都可以来智泊AI学习人工智能,找到高薪工作,一次小小的“投资”换来的是终身受益!
应届毕业生:无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型:非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能 突破瓶颈:传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。
👉获取方式:
有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 39
 0
- 0


 已为社区贡献22条内容

所有评论(0)