SME-人工智能(六)习题(优化理论 损失函数 梯度下降)
本文聚焦优化理论核心知识点与神经网络参数计算实操内容。
优化理论部分,以矩阵求导为基础,推导标签y∈{-1,1}场景下逻辑回归损失函数,
通过Hessian矩阵证明损失函数凸性,还深入探讨强凸函数特性、log-sum-exp函数性质及梯度下降(GD)的线搜索特性与收敛性;
神经网络部分,详细讲解MLP与CNN的参数计算逻辑,包含单/多卷积层输出维度求解、池化对维度的影响等。
目录
2. log-sum-exp函数 1-Lipschitz smooth
2. 凸函数不一定有唯一最优解,强凸函数的最优点 x* 唯一(反证法)
1. 矩阵求导 + 链式法则
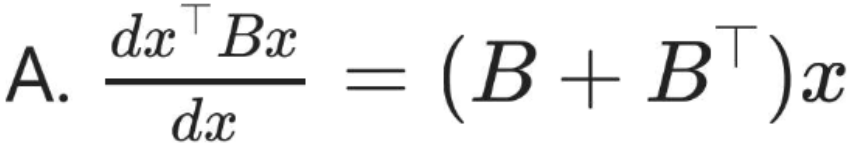
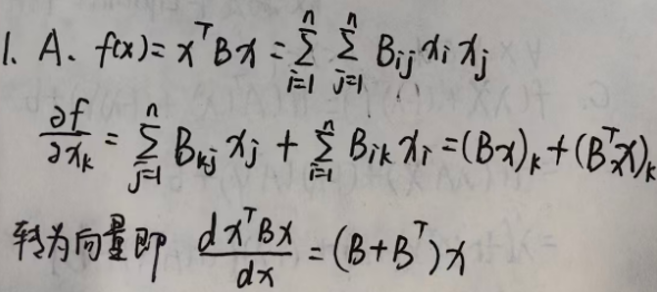
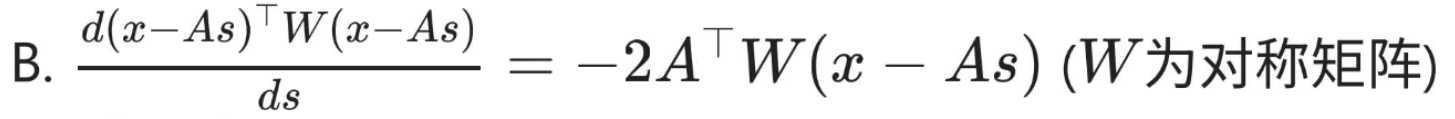
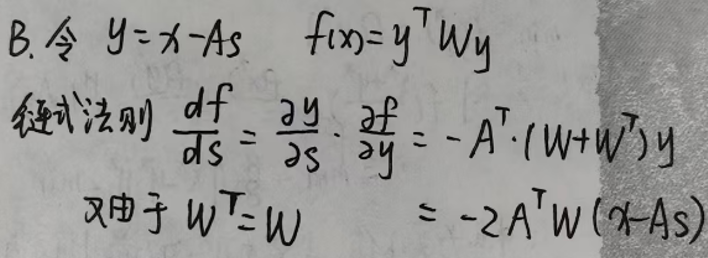
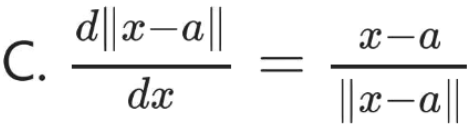
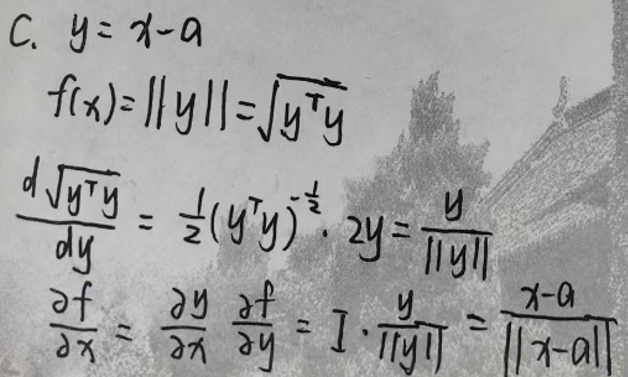
2. 最大似然估计与损失函数
1. 回归 -> MLE -> 优化问题
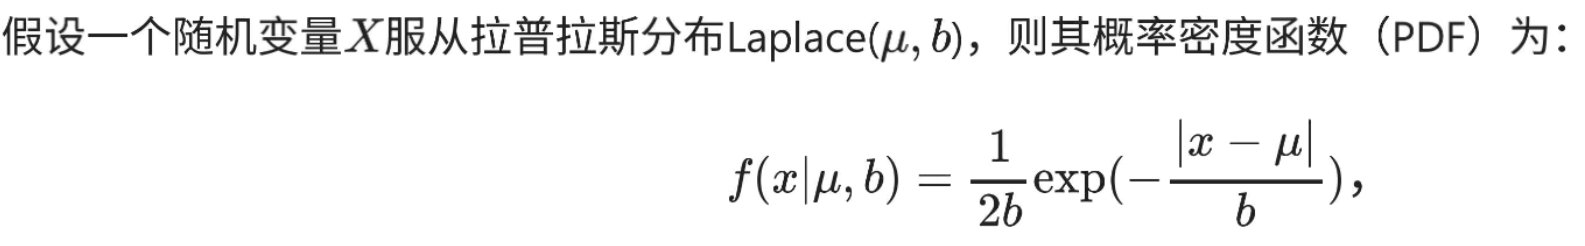 b=1

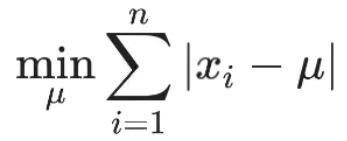
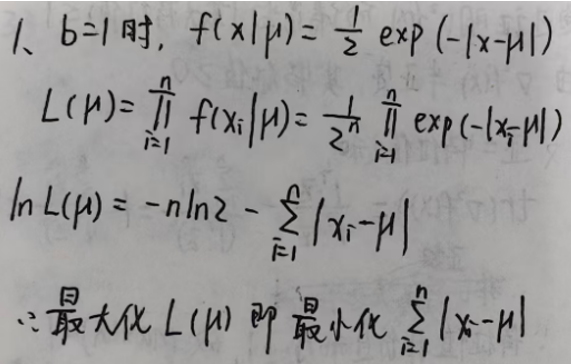
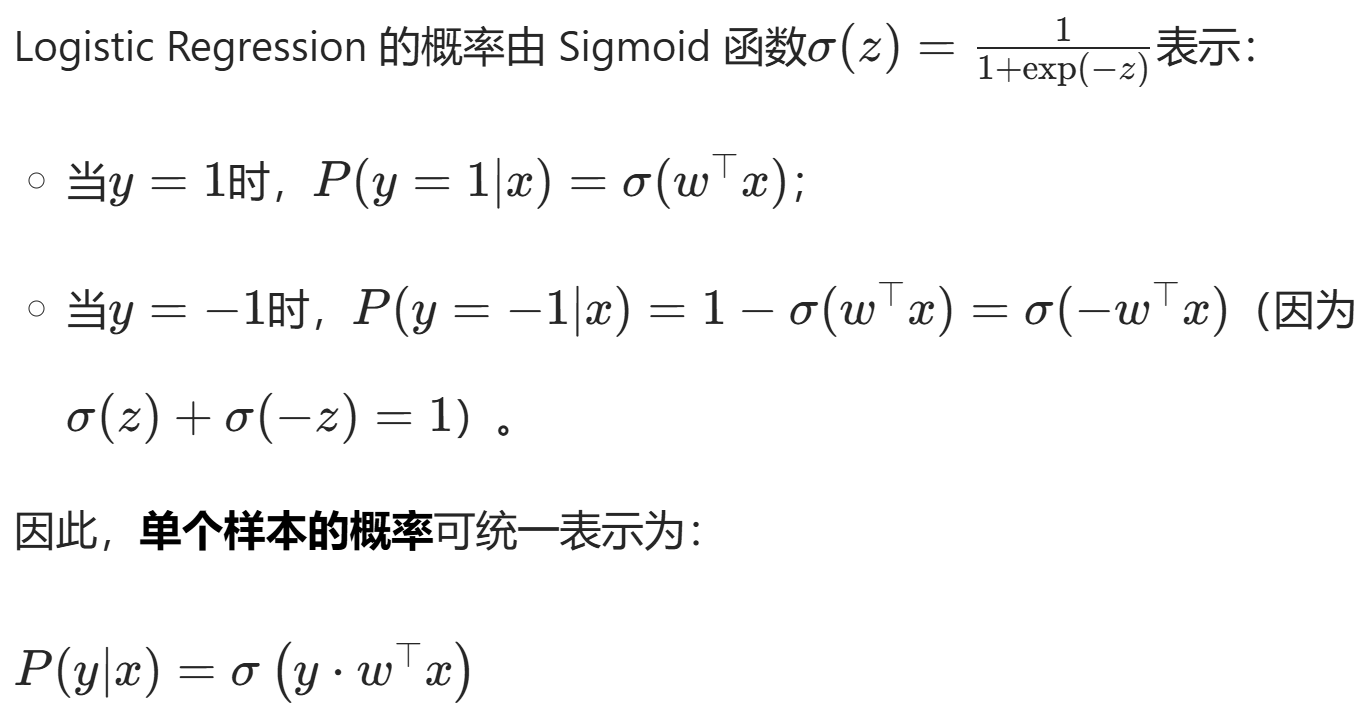
2. ±1 二分类的损失函数
课堂上推导 Logistic Regression 的 Loss Function 时,规定标签y∈{0,1};
现重新假定y∈{-1,1}(Negative 类标签为 -1),重新推导此时的 Loss Function。
对于N个独立样本,似然函数 MLE 为各样本概率的乘积:
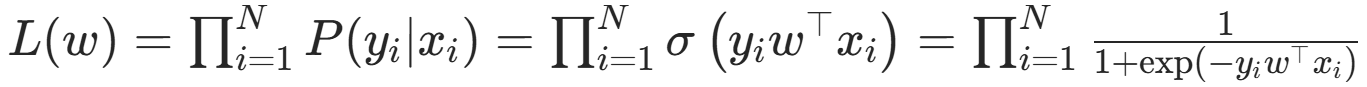
对似然函数取负对数似然(转化为极小化问题),并取样本平均,得到损失函数:
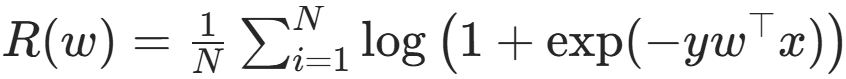
3. 证明损失函数是凸函数
单样本损失函数项对 w 求偏导:
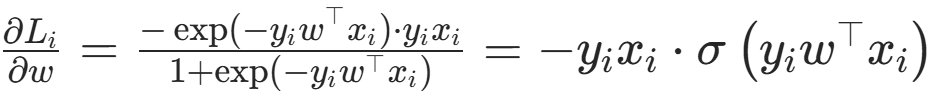
利用 sigmoid 函数的性质 求二阶导 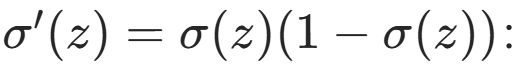
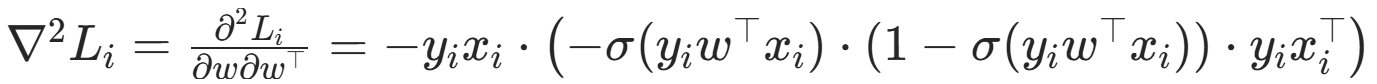
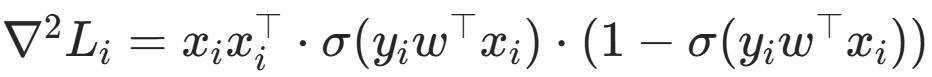
证明 Hessian 半正定(凸性的核心)
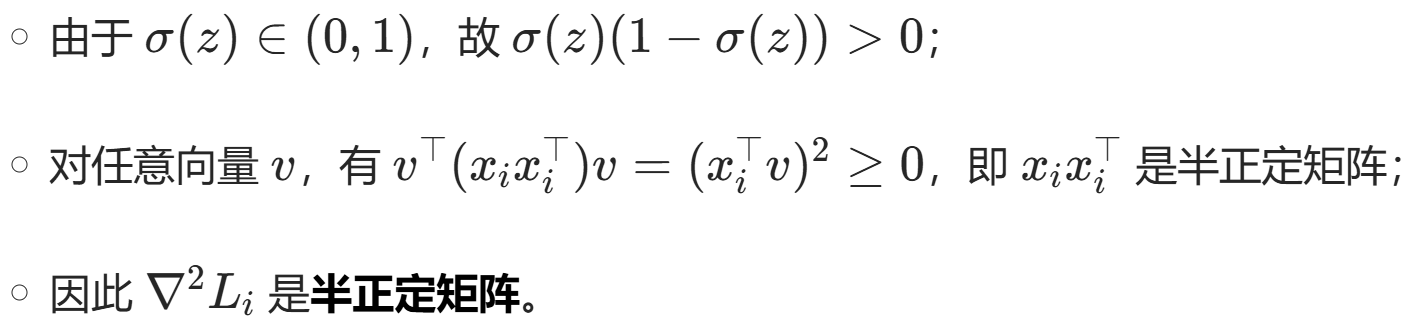
半正定矩阵的加权平均仍为半正定矩阵,
损失函数 R(w) 的 Hessian 是各样本项 Hessian 的平均,故半正定,是凸函数。
4. 证明凸函数
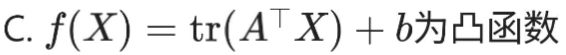
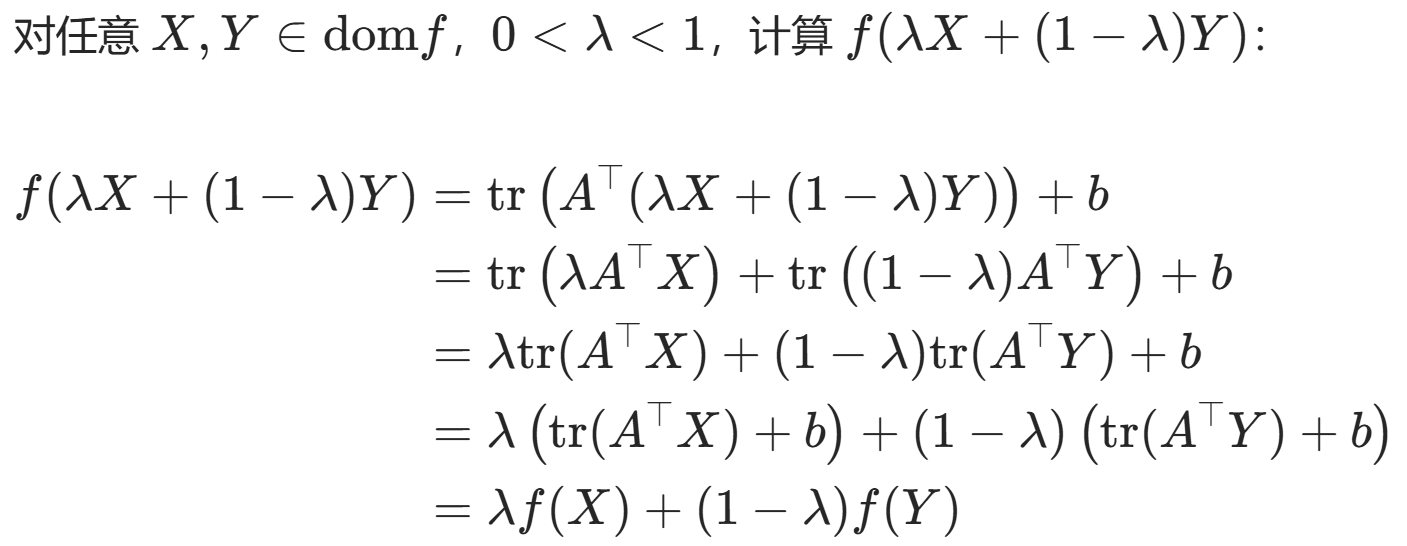
所以是仿射函数(也是 凸/凹函数)
3. L-Lipschitz 光滑
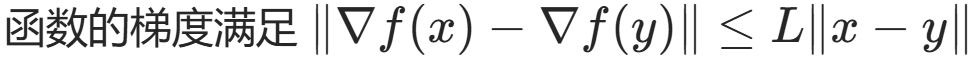

1. log-sum-exp函数 为凸函数
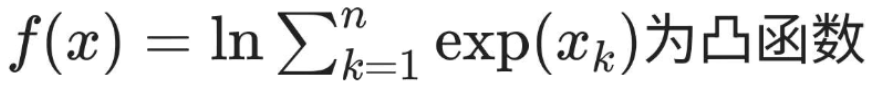
把指数记为 z 简化;
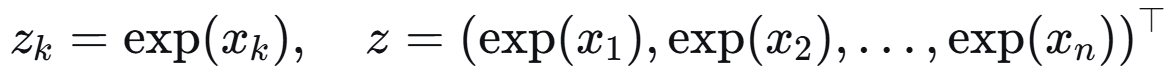
求一阶偏导
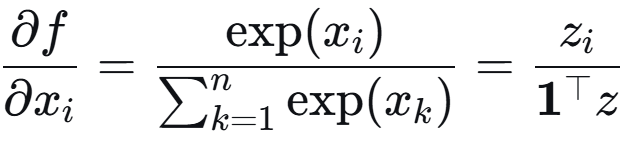
求 Hessian 矩阵:
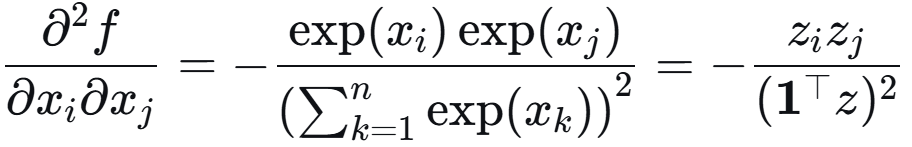
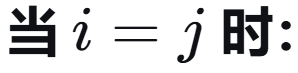
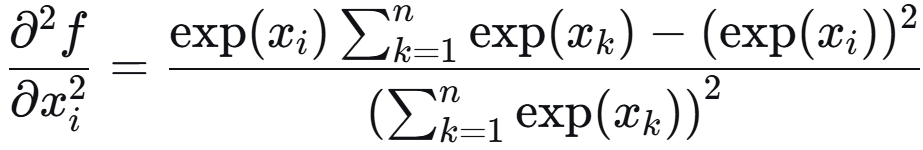
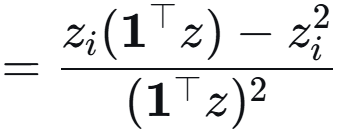
整合一下,Hessian 矩阵就是对角线多一项:
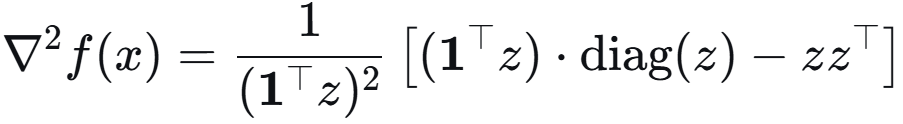
计算二次型 右边是柯西不等式形式,故正定。
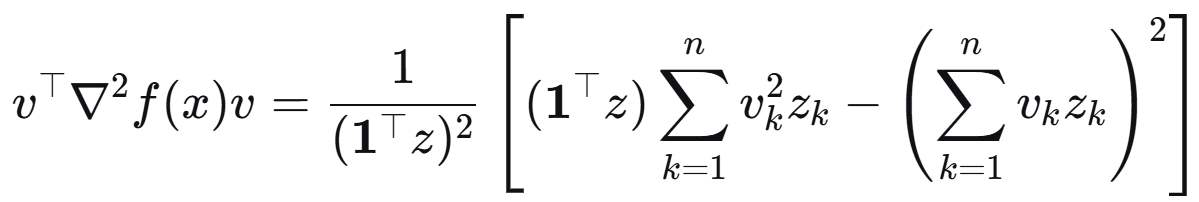
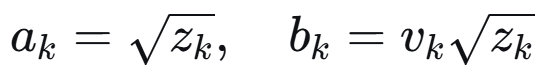
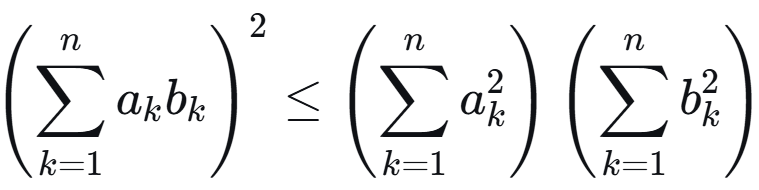
2. log-sum-exp函数 1-Lipschitz smooth
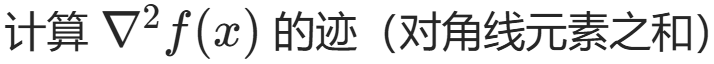
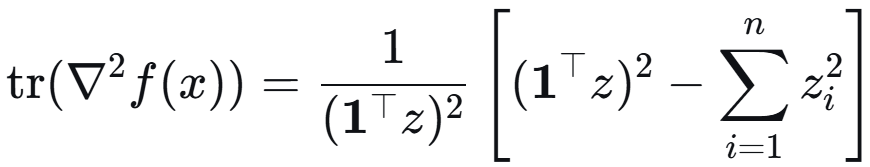
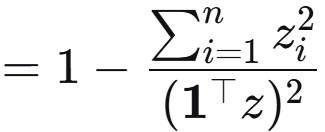
又因为正定,特征值均为正,且 tr = 特征值的和<1。
故 Hessian矩阵 最大特征值<1,故满足 1-Lipschitz smooth。
4. μ-强凸
1. 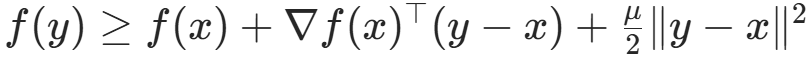
2. 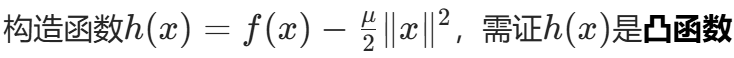
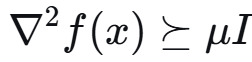
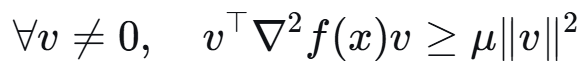
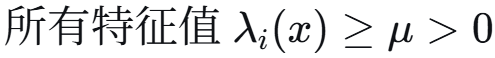
1. μ-强凸 等价不等式(充分性 + 必要性)
证明: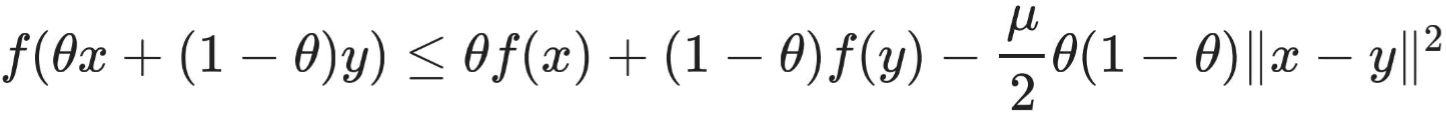
用强凸的结论 推必要性:
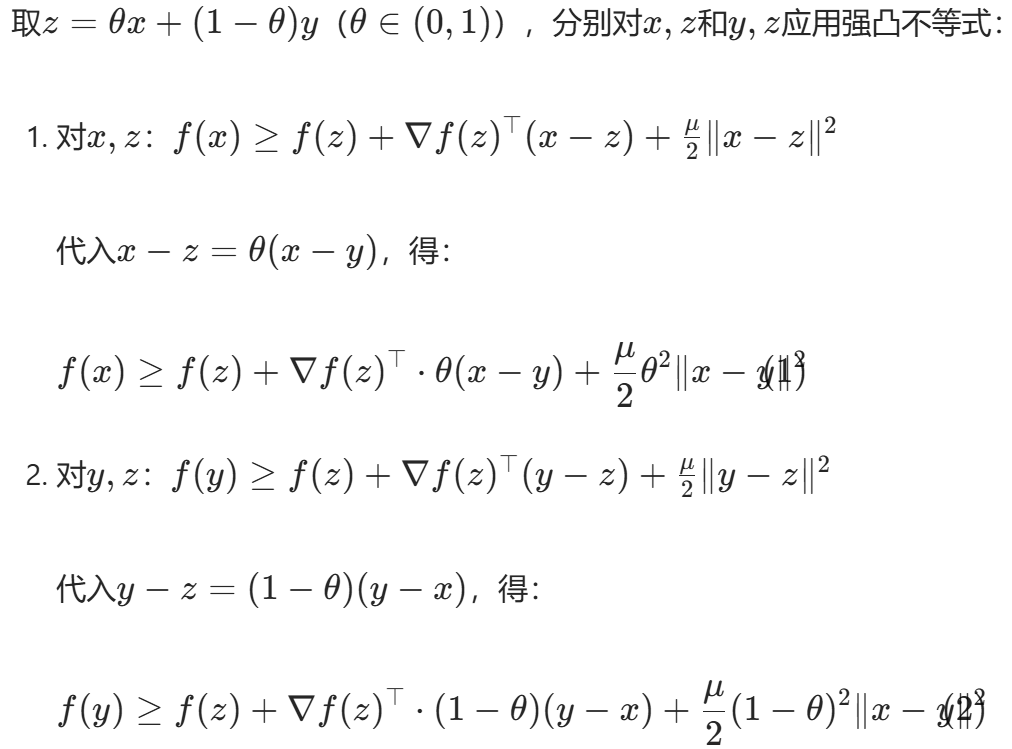
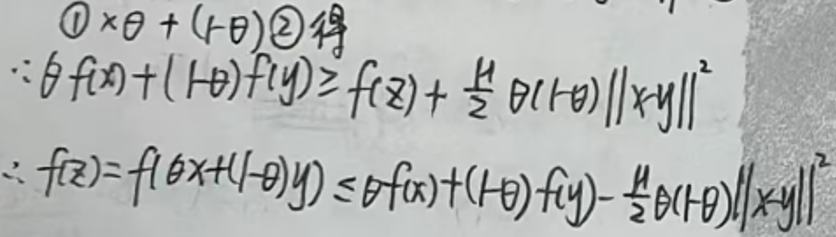
充分性:
把 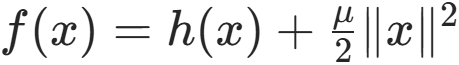 代入题设不等式:
左边为: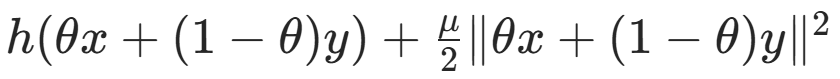
右边为: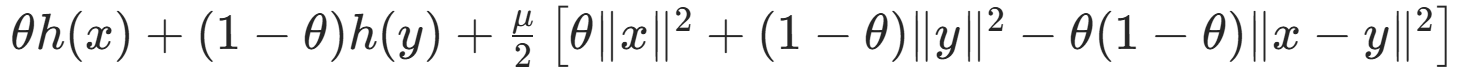
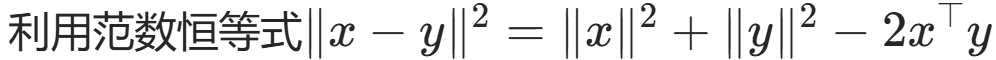
化简得 左边和右边的常数项相等。
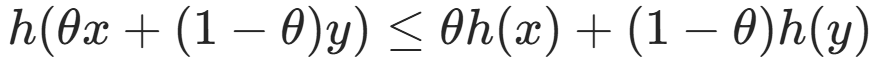
所以 h(x) 是凸函数,f(x) 是 μ-强凸函数。
2. 凸函数不一定有唯一最优解,强凸函数的最优点 x* 唯一(反证法)
假设存在两个不同的最优解 x*,y*:取 θ=0.5,代入强凸性不等式:
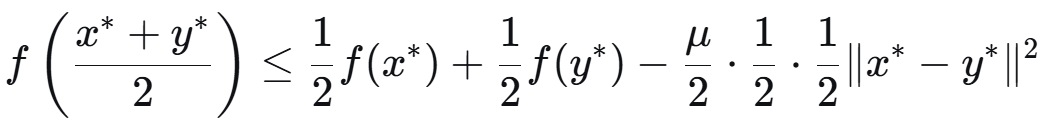
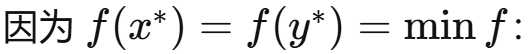
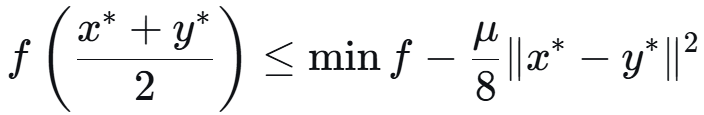 与 min f 是最优值矛盾。
5. 强凸 + 迭代求解
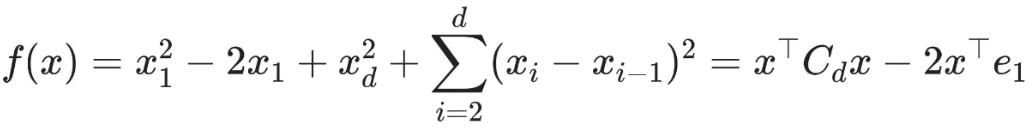
e_i 是只有第 i 位为 1 ,其余位置为 0 的向量;C_d 为 d*d 的对称矩阵。
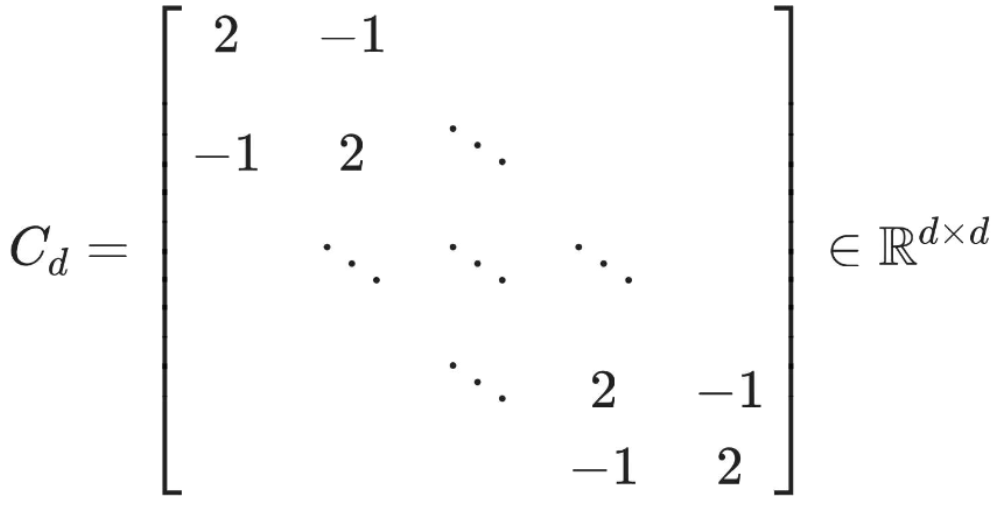
1. 证明是凸函数
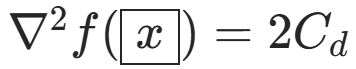 只需证明 C_d 半正定。

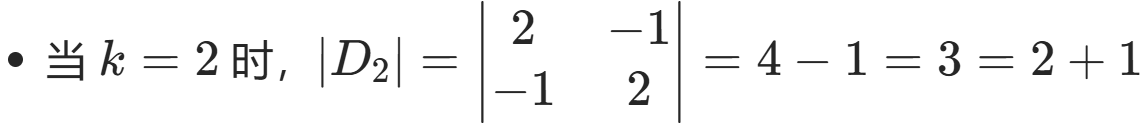
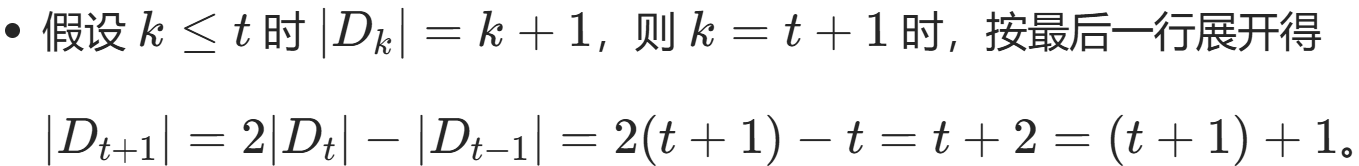
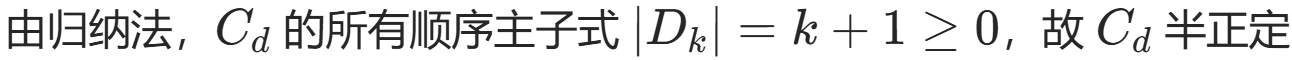
2. 证明是强凸函数 -- 证C_d所有特征值 > 0

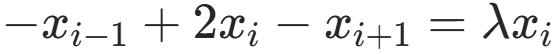
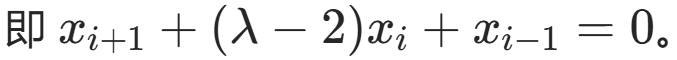
三角形式 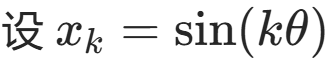 代入得
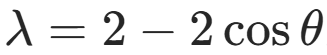
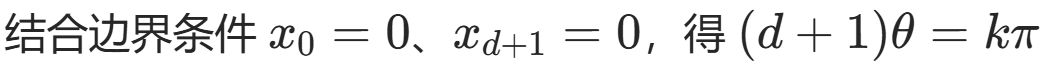
不同的 λ 对应不同的 θ
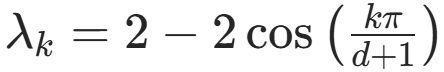

3. 求最优解和最优值
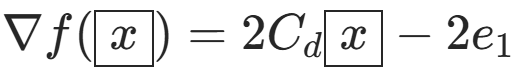
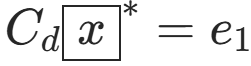
代入得下面 d个等式
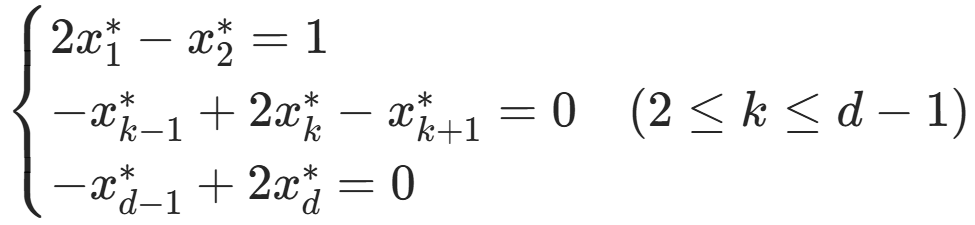
从后往前递推得: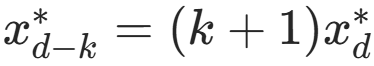
代入第一行得:(d+1)x*=1,x* = 1/(1+d)
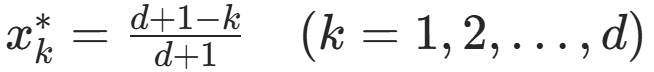 代入得
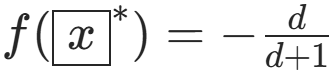
4. 证明该问题梯度下降迭代 至少需要 d 次才能解决
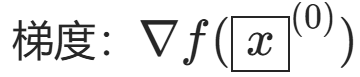 + 迭代更新
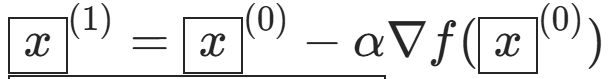
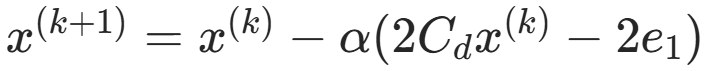
d=10000 假设定义解决为:与最优点非常接近 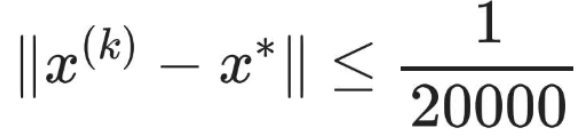
引理1:最后一个维度 x_d = 0 则问题没有被解决。
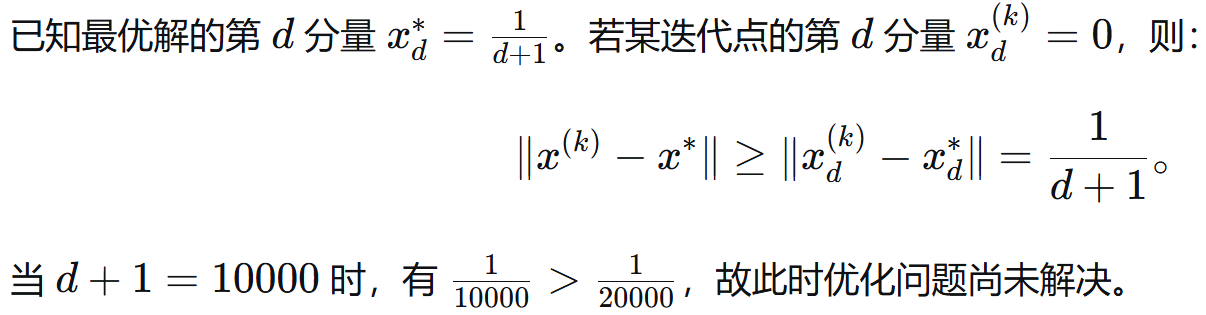
引理2:一次迭代,最后非零位置后移一位。

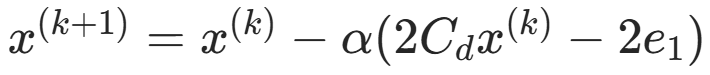
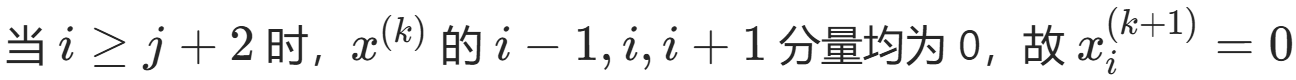
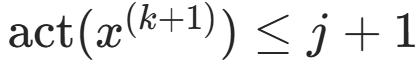

综上:初始全0,每次迭代 最后非零位置后移一位 + 最后一位为 0 则还没解好,说明至少需要迭代后移 d 次。
6. GD with Line Search 线搜索步长
精确线搜索是在搜索方向上最小化目标函数,即步长 α 为:
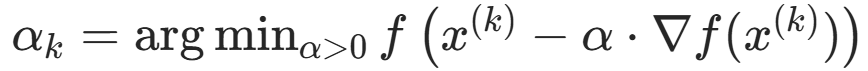
1. GD线搜索,非稳定点则,前后两个迭代点的梯度方向垂直
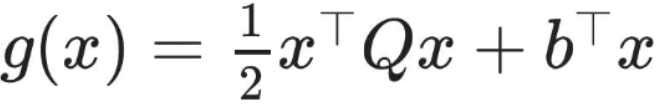 证明
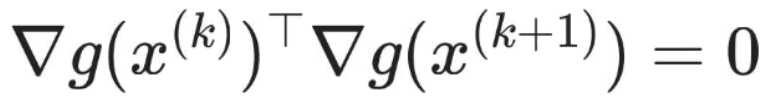
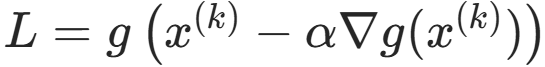
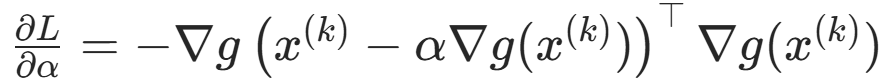
即 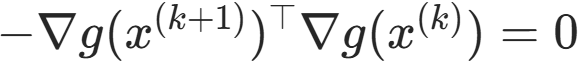
2. 证明下问题线搜索 无法在有限步时间内精确到达该最优点
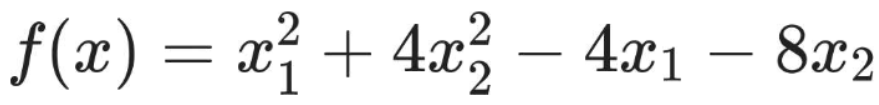 最优点为x*=(2,1),令起始点 x(0)=(0,0)
先换元变得更简洁:
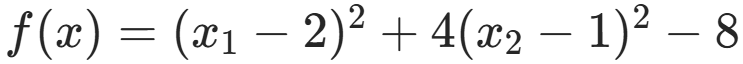
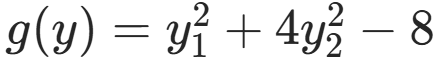 最优解对应 y*=(0,0)
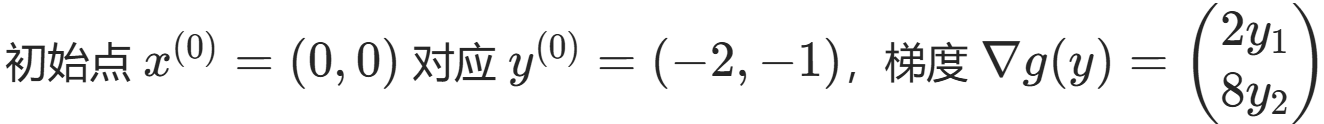
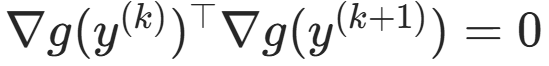
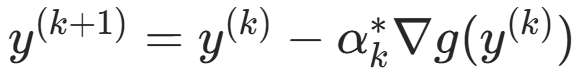 代入得:
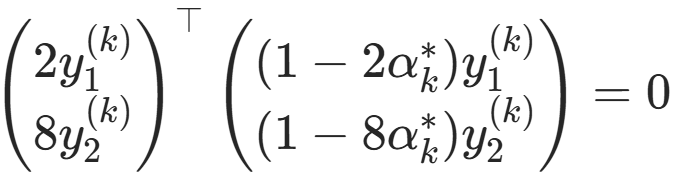 化简得:
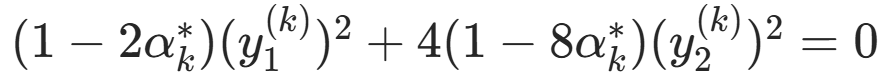
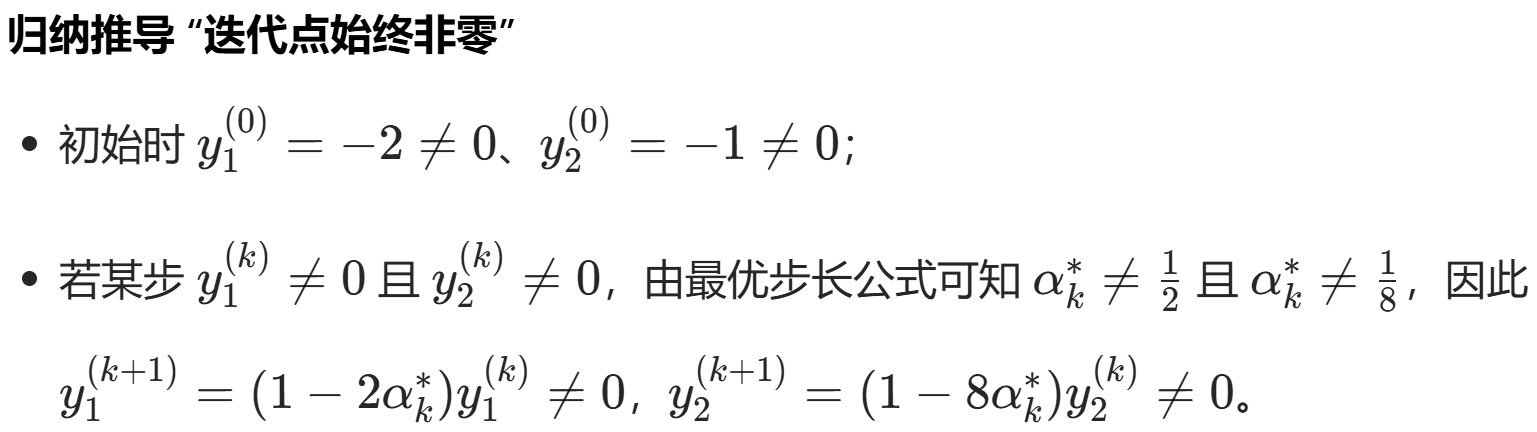
所以一直无法到最优点 (0,0)
7. GD收敛的解
特征数 d 多于样本数 n,无穷多解 找最小范数解。
1. 自动趋于最小范数解
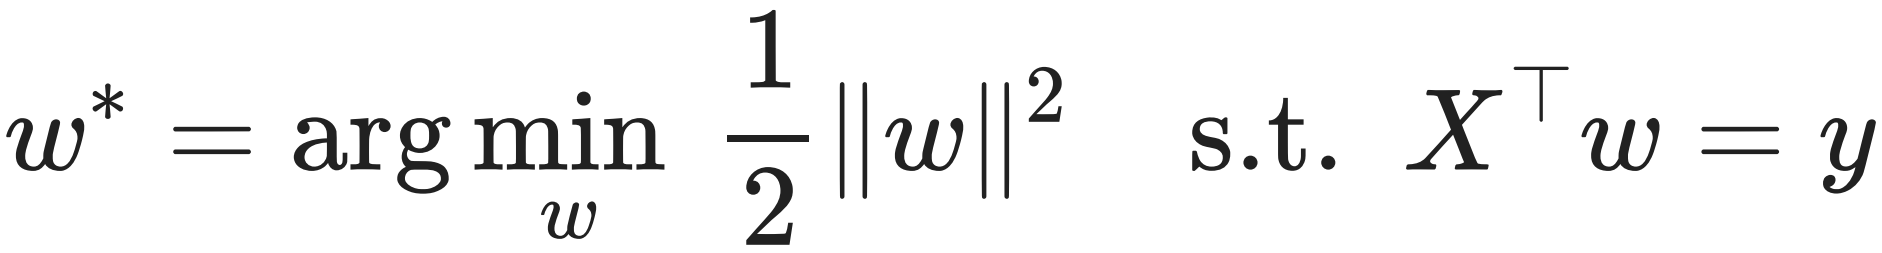
构造拉格朗日函数: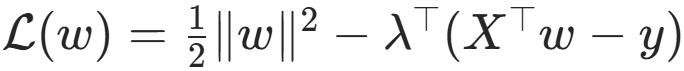
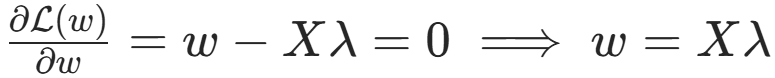
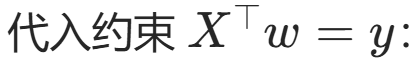
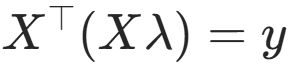
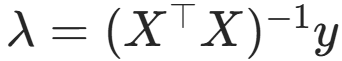
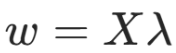
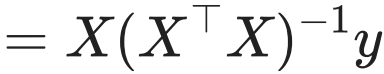
2. T 次迭代
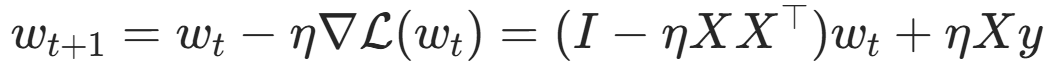
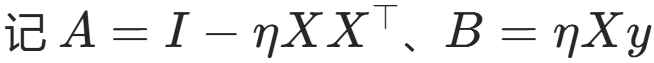
数列形式迭代得 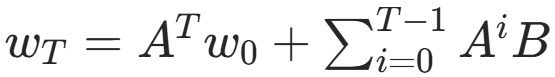
代入即为 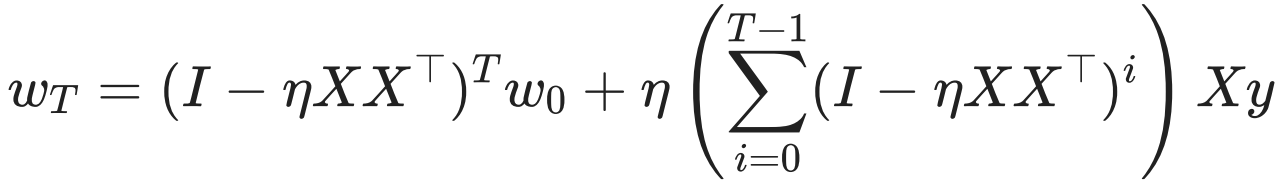
还可以进一步改写
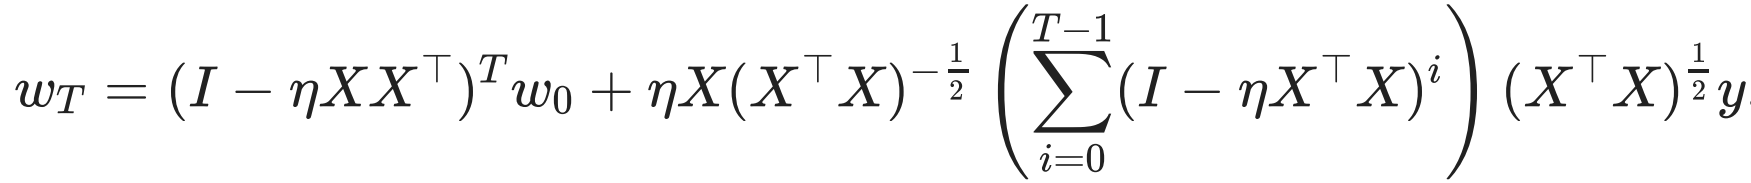
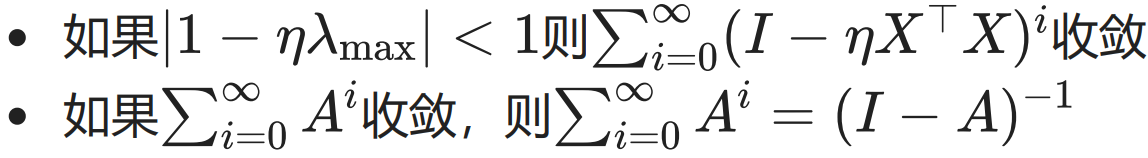
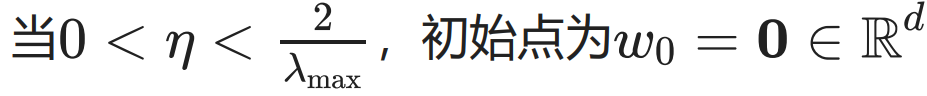
则前一项带 w0的为0,后一项无限求和收敛,最终收敛到
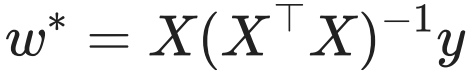
8. MLP 和 CNN 参数数目
1920 (W) × 1080 (H) 像素 * 3 个通道
1. MLP:一个隐藏层,共 256 个节点;一个输出层,共 10 个节点,包含偏置项。
总参数数(1920*1080*3+1)*256 + (256+1)*10
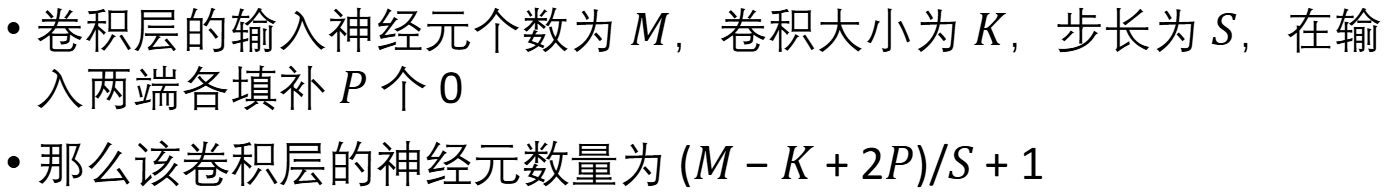
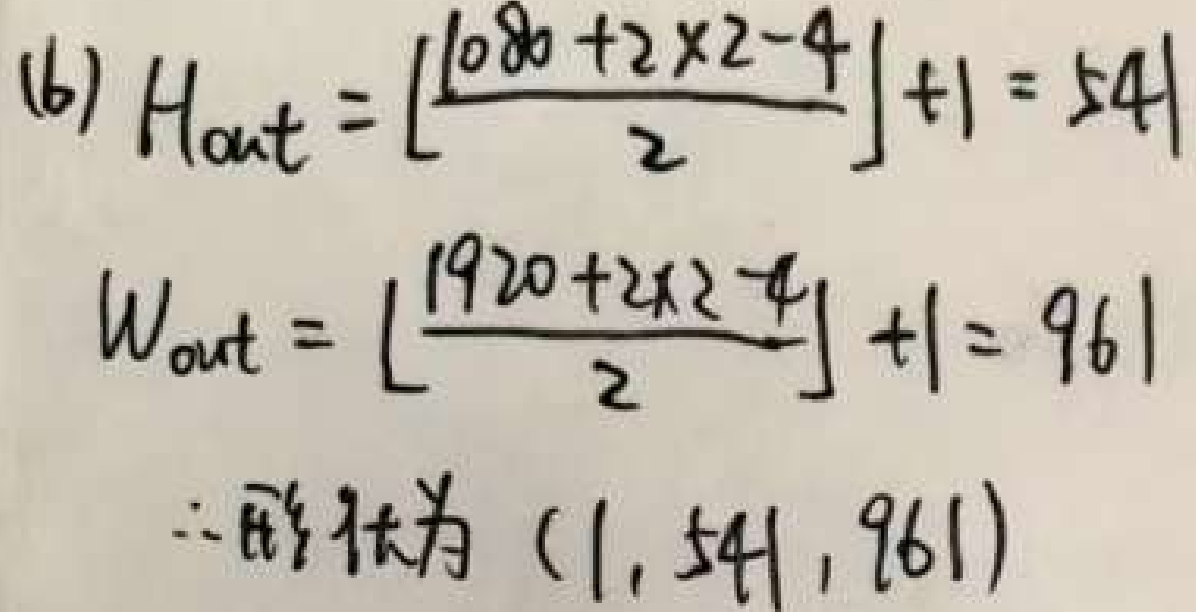
2. Simple CNN:只有一层卷积层,并且对3个通道同时使用一个 4 × 4 × 3 的滤波器(kernel)
stride = 2,padding = 2,问该层的的输出特征图(feature map)维度是多少?(1,H,W)
3. 共 3 个卷积层,stride = 1 每层对每个通道使用 64 个(输出通道数) 5 × 5 滤波器
每层之后跟随 2 × 2 平均池化(average pooling)
每层卷积都会对输入进行 padding = 2
卷积层均使用偏置项(bias)
最后使用一个线性输出层,将特征映射到 10 个节点。
问总参数数目(卷积核+最后的线性层 池化层没有)
卷积层输入输出维度不变,池化层维度为 2 输出减半。1920*1080 分别除以8 -> 240*135
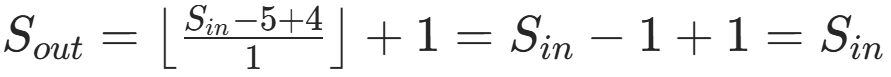
一个 kernel 的参数数: 输入通道数 * K *K + 1个bias;有输出通道数个 kernel。
卷积核:(3*5*5+1)*64 + (64*5*5+1)*64 + (64*5*5+1)*64 = 209792
最后线性层:(240×135×64+1)*10 = 20736010;总参数为二者加起来。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 13
 0
- 0


 已为社区贡献12条内容

所有评论(0)