你的VLA太慢了!?算力不够也能提速:这篇综述教你打造高效VLA新范式
-
作者:Weifan Guan、Qinghao Hu、Aosheng Li、Jian Cheng
-
单位:Institute of Automation Chinese Academy of Sciences;University of Chinese Academy of Sciences;AiRiA;Nanjing University of Information Science and Technology
-
论文链接:https://arxiv.org/abs/2510.17111
-
Github仓库:https://github.com/guanweifan/awesome-efficient-vla
本文章系作者投稿,转载请后台联系我们。
提出背景与价值
随着具身智能的快速发展,动作视觉语言(Vision-Language-Action,VLA)模型正成为机器人理解环境与执行任务的核心框架。通过将视觉感知、语言理解与动作生成端到端地映射,VLA使机器人能够在复杂场景中完成通用指令执行和多任务操作。然而,当前主流VLA系统通常依赖体量庞大的视觉与语言模型,带来巨大的计算与存储开销,同时推理延迟较高,难以满足真实机器人平台对实时性与能耗的严格要求。效率问题已成为VLA从实验室研究向实际应用转化的关键瓶颈。
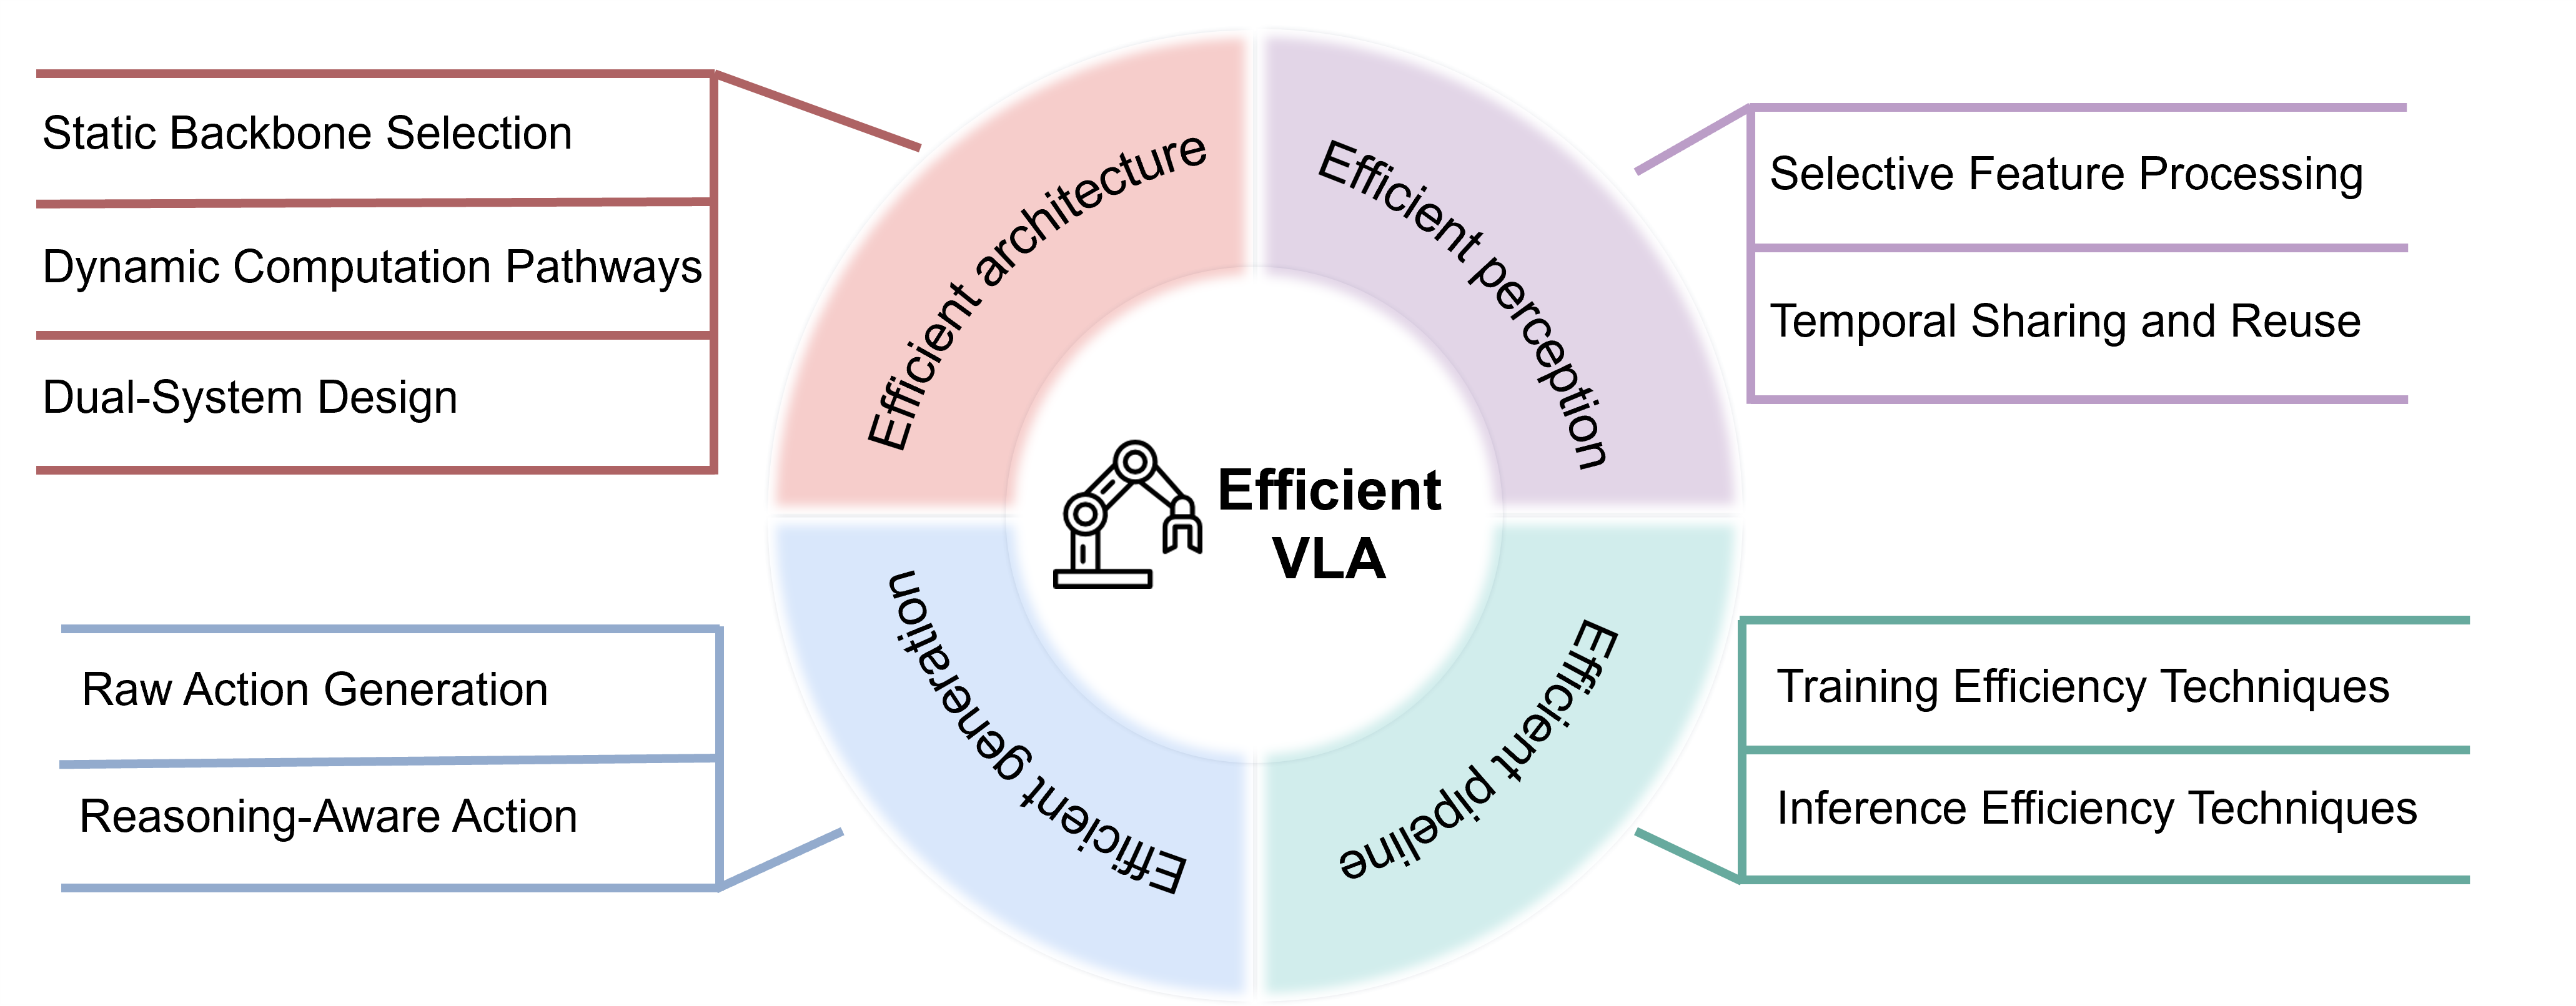
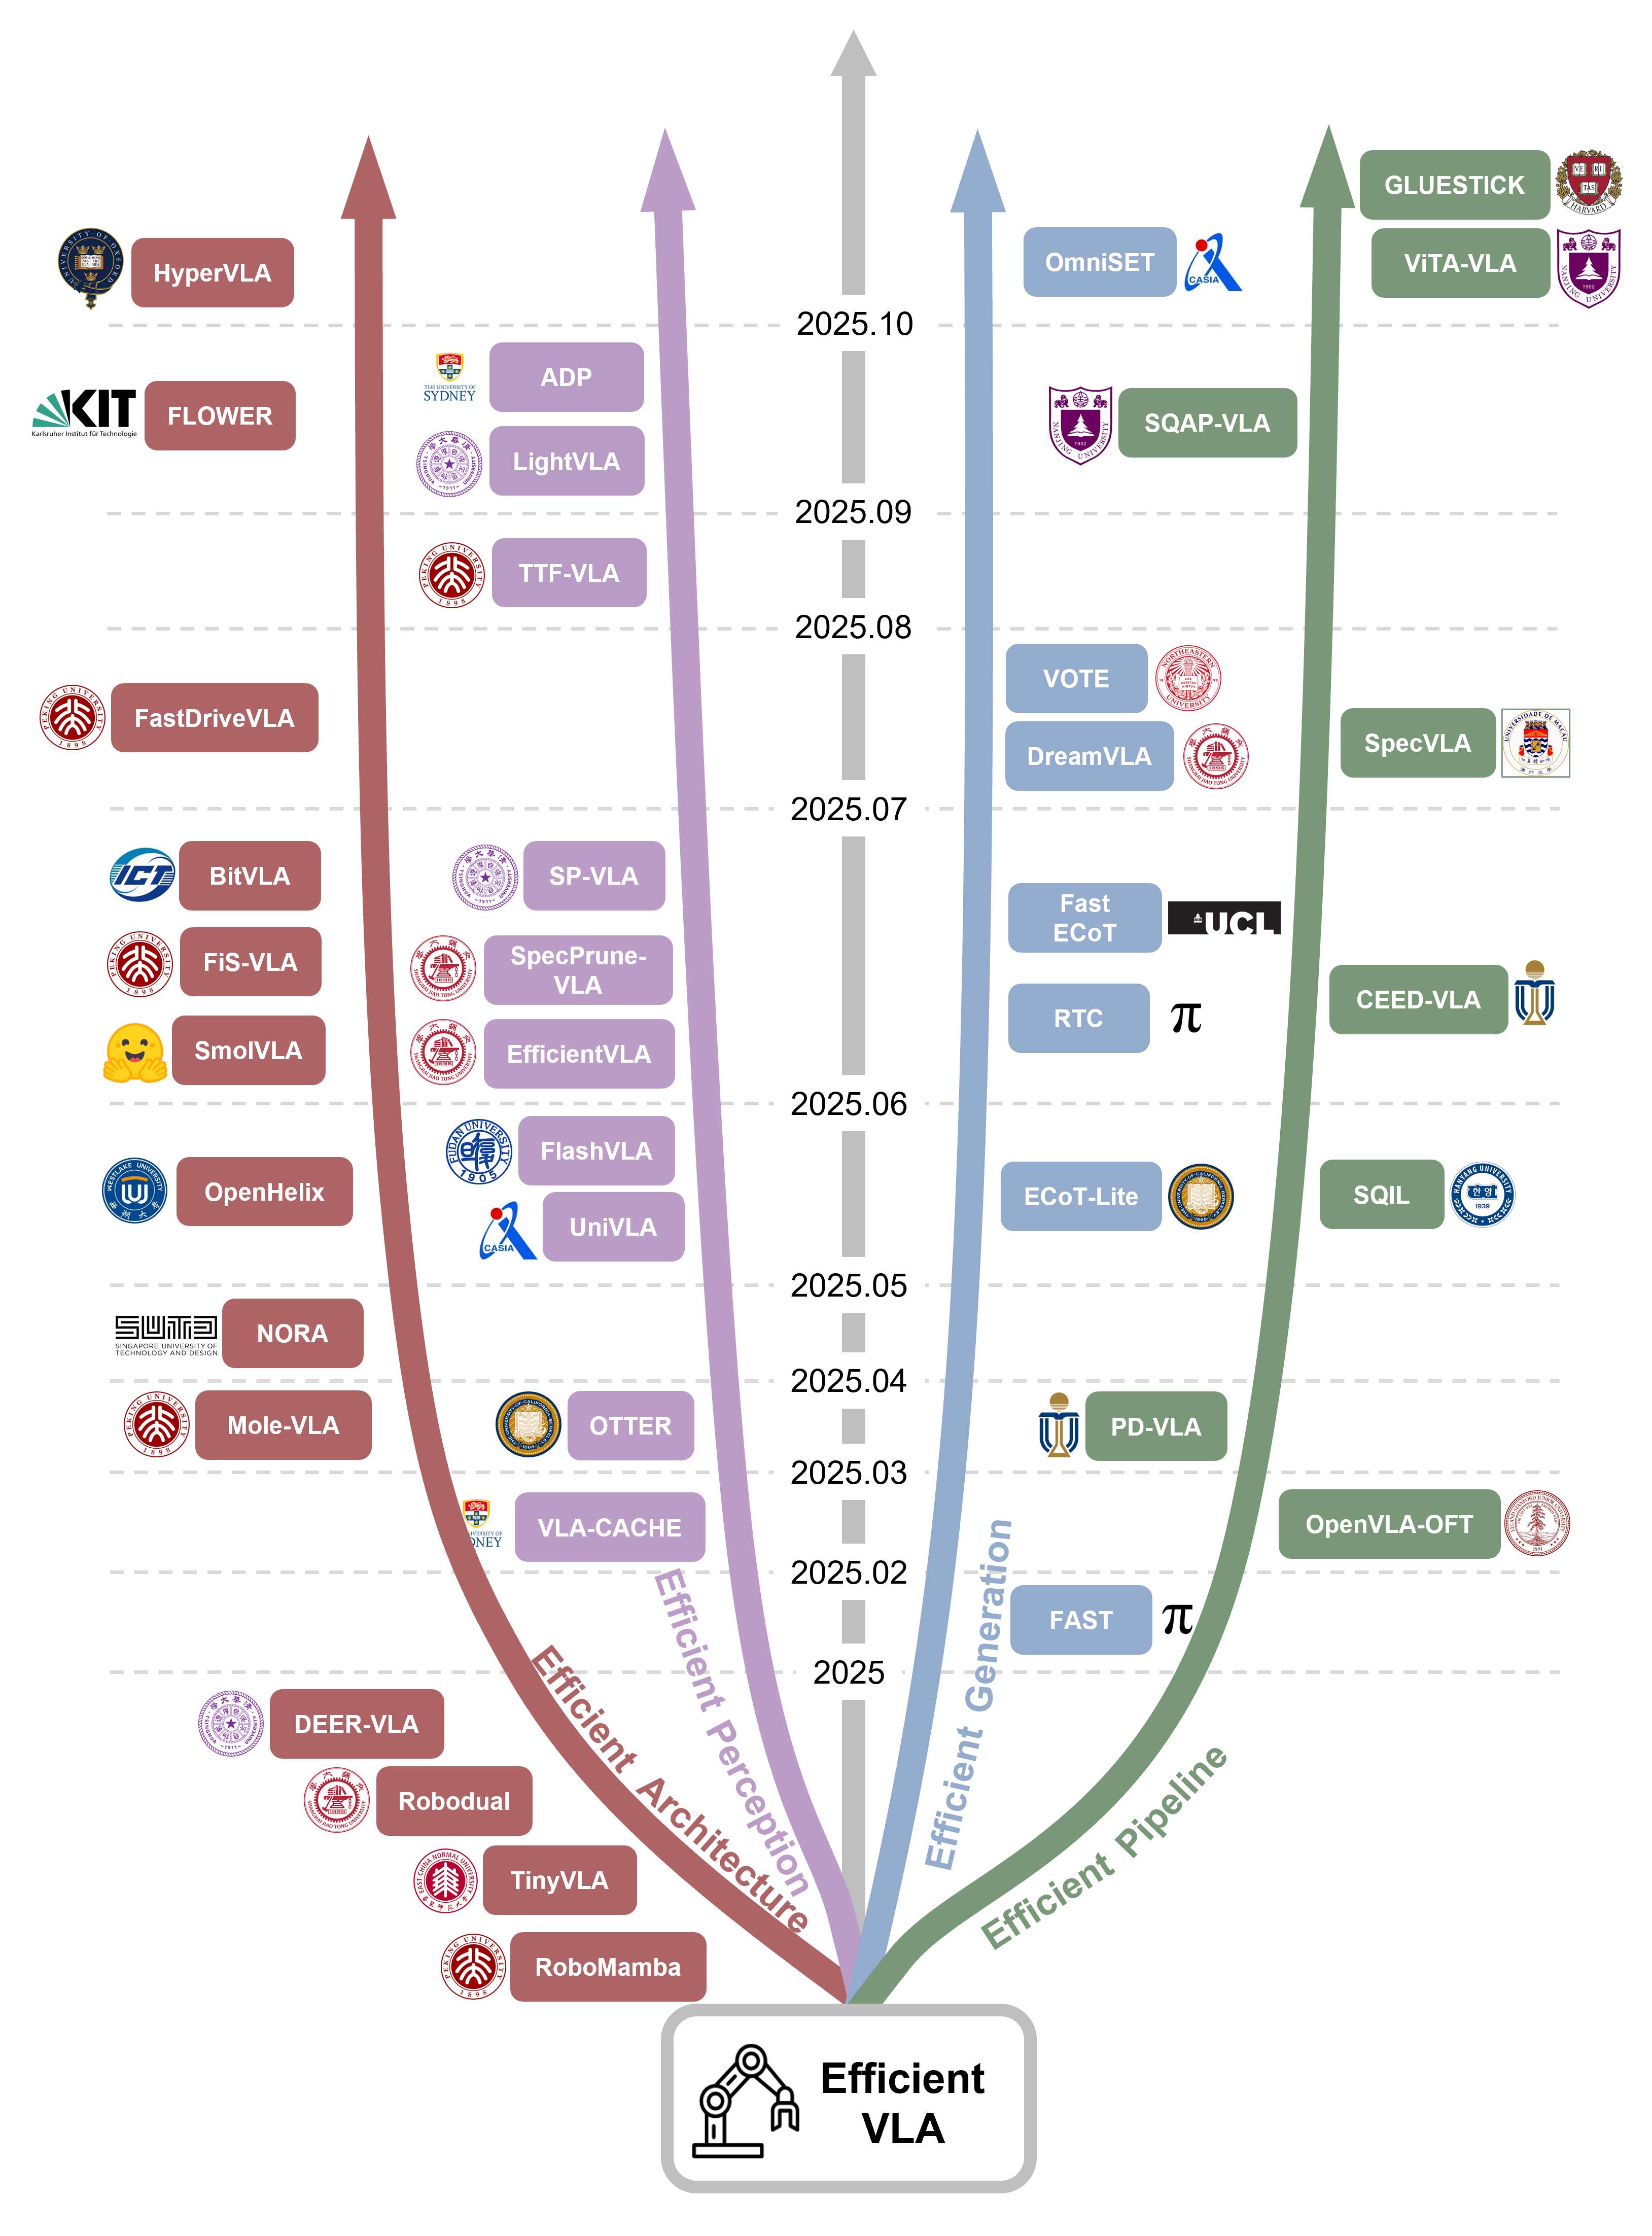
该综述正是在这一背景下展开,围绕“效率”问题对VLA模型进行了系统性回顾和分类。文章从模型架构、感知特征、动作生成及训练与推理四个核心维度展开分析,总结了代表性方法、比较关键权衡,并提出对未来高效VLA研究的展望。大家可通过以下三点快速把握本综述的核心贡献:
一是首次系统聚焦“效率”这一VLA核心瓶颈: 与以往综述多侧重于模型架构或动作表征不同,该综述以“效率”为中心议题,系统分析了VLA在计算、延迟、存储与能耗上的瓶颈来源,揭示效率问题不仅依赖单点优化,而是贯穿视觉、语言与动作生成全链路的系统性挑战。
二是统一梳理当前高效VLA策略,提出四维度分类框架: 该综述将现有高效VLA方法划分为四个互补维度:高效架构设计、感知特征压缩、动作生成加速与训练推理优化。通过总结各维度的代表性技术,构建了覆盖从建模到部署的完整效率谱系,为理解现有方法的设计逻辑与权衡提供清晰视角。
三是展望未来VLA的发展趋势与效率优化方向: 随着机器人操作任务复杂性不断增加,未来VLA模型不仅需要追求能力提升,更需在计算与部署成本上实现精细权衡。本综述基于发展趋势,分析了下一代VLA系统中最关键的效率优化环节,包括数据利用、感知特征、动作生成与学习策略,为研究者把握能力与效率的平衡提供参考。
领域的痛点
视觉-语言-动作(Vision-Language-Action, VLA)模型,旨在将视觉观测与自然语言指令直接映射为机器人动作,是实现端到端语义驱动控制的核心技术。近年来,得益于大规模预训练模型的驱动,VLA模型的能力取得了飞速发展。
然而,VLA模型在实际应用中,尤其是在机器人端侧部署时,面临着严峻的效率瓶颈。这些模型普遍依赖大规模的视觉编码器和语言模型,导致推理过程计算复杂度高、延迟大、内存占用高。同时,动作输出的连续性与平滑性问题也直接影响任务执行的可靠性。这些瓶颈严重制约了VLA模型在实时、资源受限场景下的应用,成为其从学术研究走向产业落地的关键障碍。
在此背景下,如何设计和优化高效(Efficient)的VLA模型,已成为一个亟待解决的核心问题。该综述以“效率”为切入点,系统性地梳理和分析现有的VLA模型效率优化方法,归纳其核心策略,并展望未来仍需突破的技术方向,以期为相关领域的研究者提供有价值的参考。
高效模型架构
模型架构改进的核心诉求在于在维持模型性能上限的同时,最小化平均推理开销。
主要方案包括三类:
-
压缩骨干模型:使用参数量更小的预训练模型,或设计轻量化的序列模型来替代超大规模的骨干网络。此类策略直接减少了参数量与内存占用,实现简单,但存在压缩模型性能上限的风险。
-
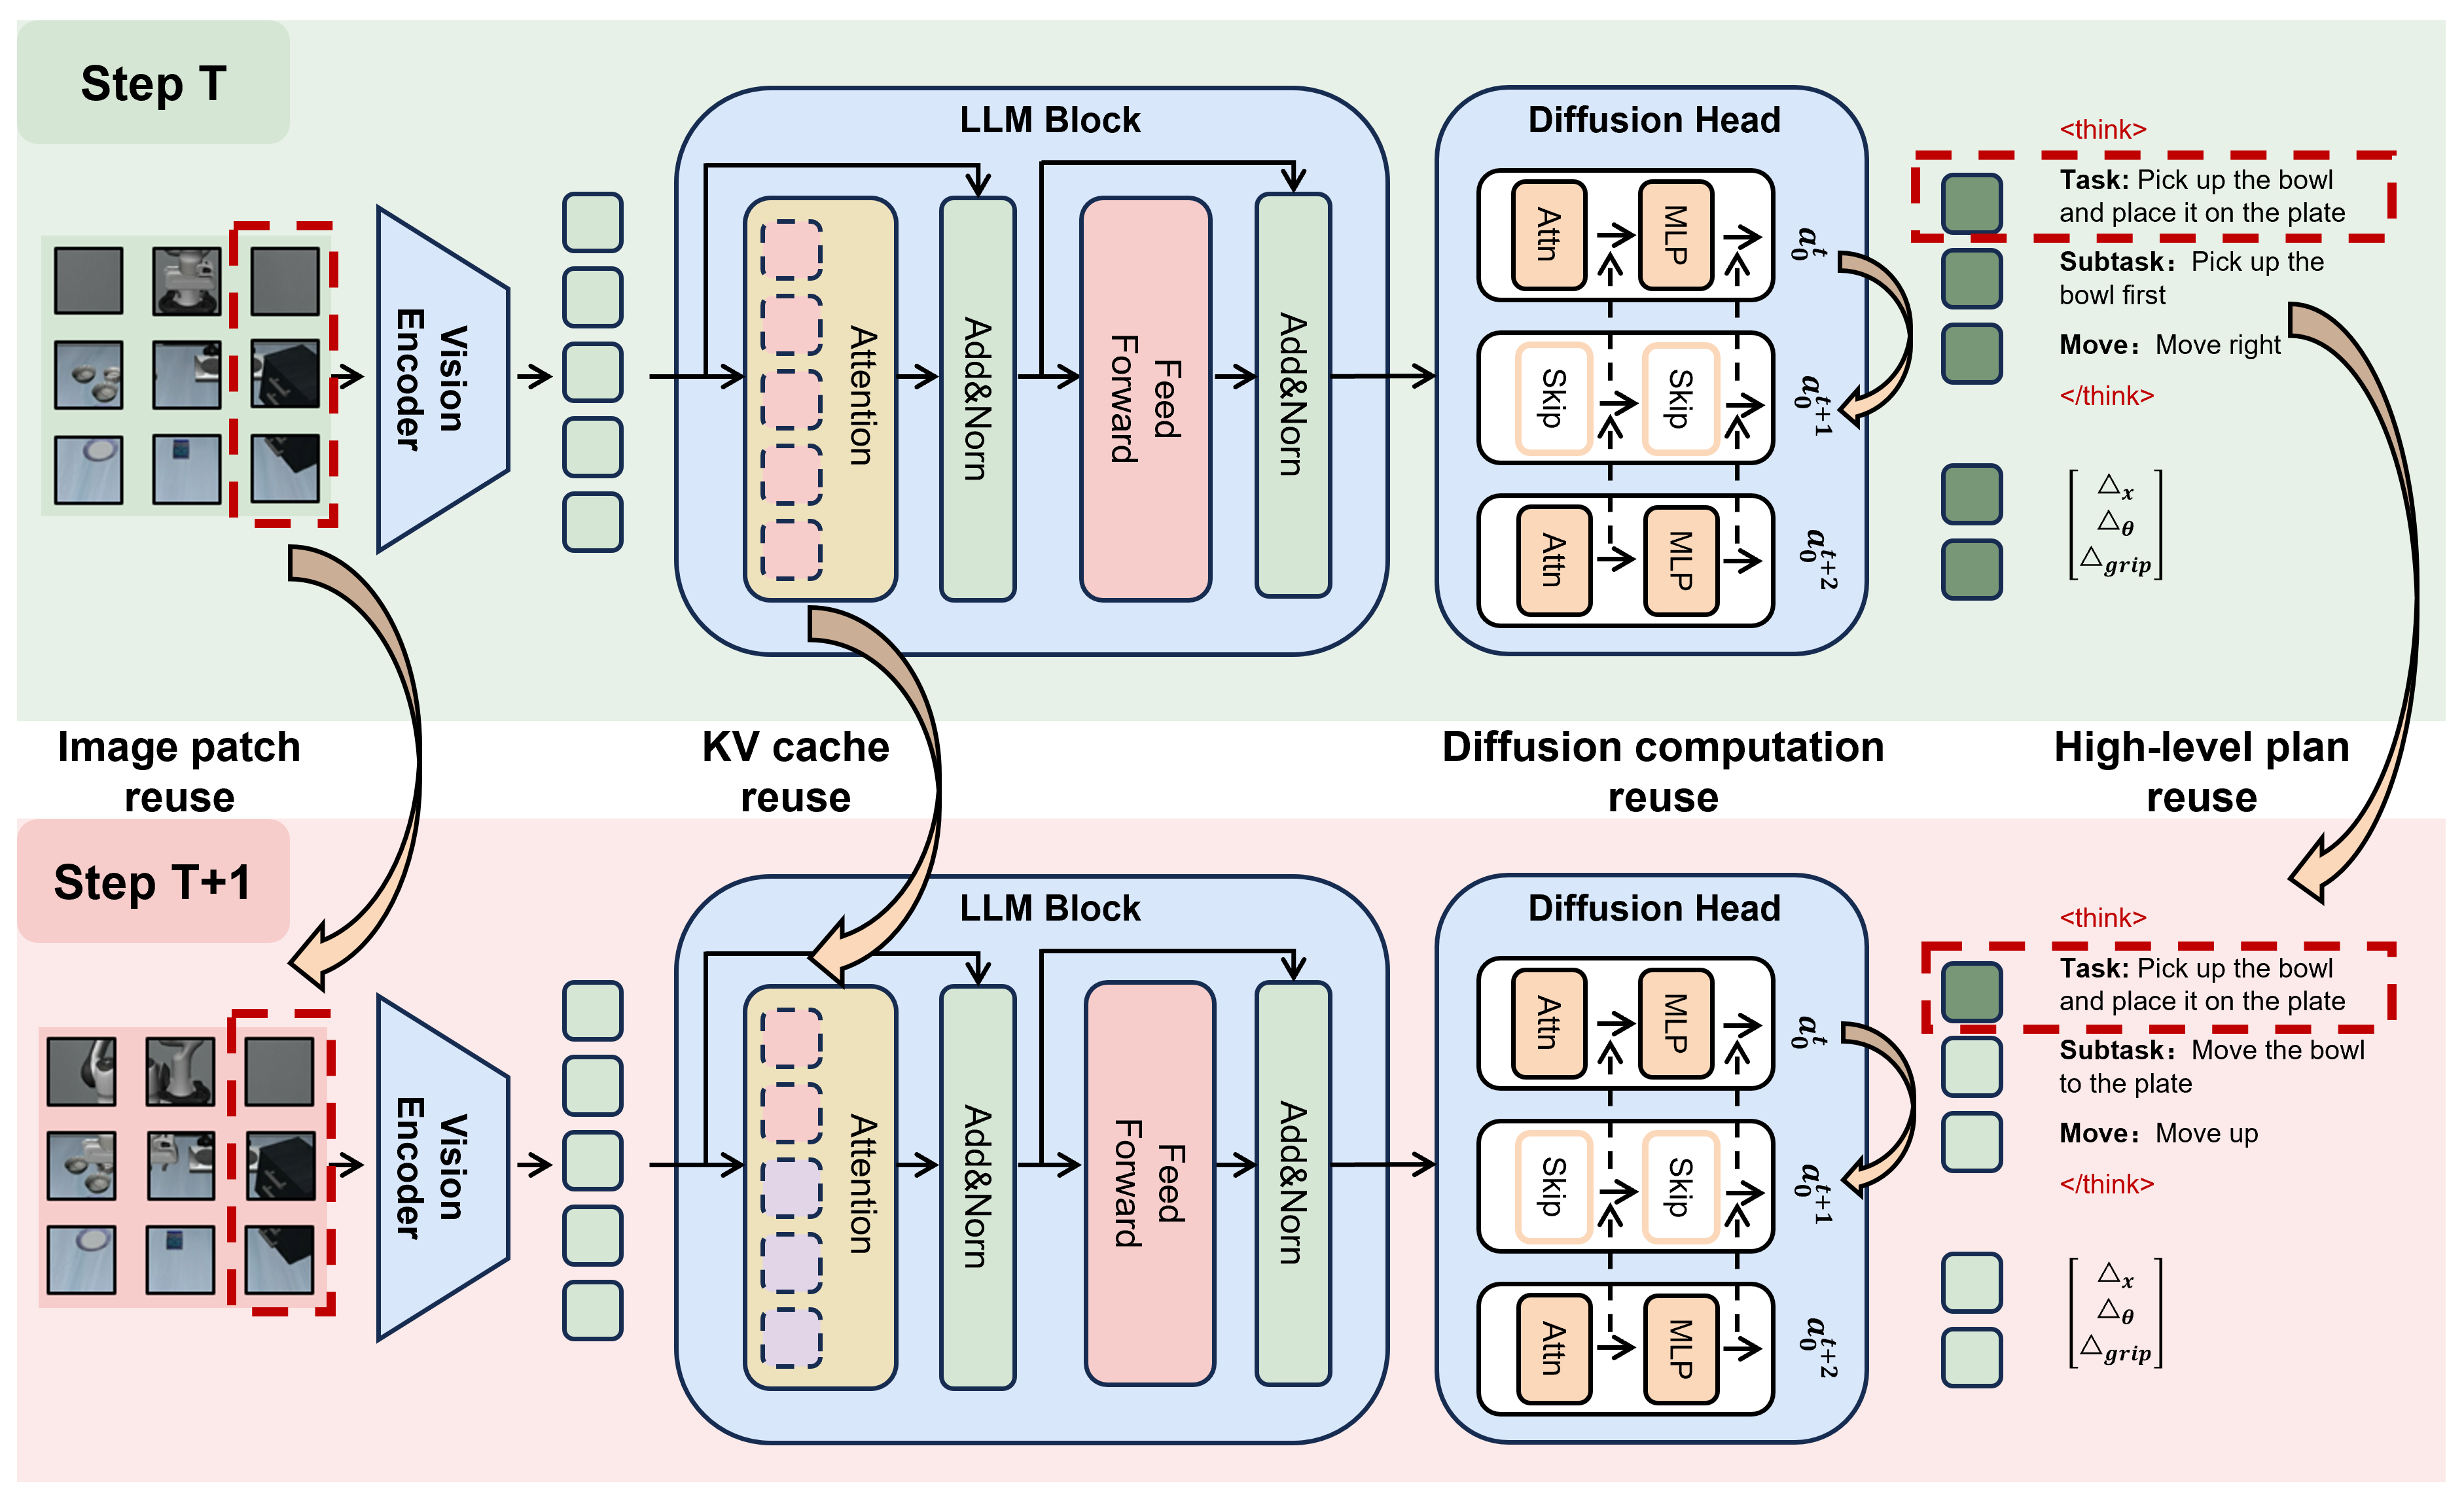
动态计算路径:在训练时保留大型模型的全部能力,而在推理时根据输入复杂度动态选择计算路径,例如early exit, layer skip, Mixture-of-Experts等。此类方法能在保障复杂样本处理能力的同时,显著降低平均计算成本,但代价是增加了路由机制和训练的复杂度。
-
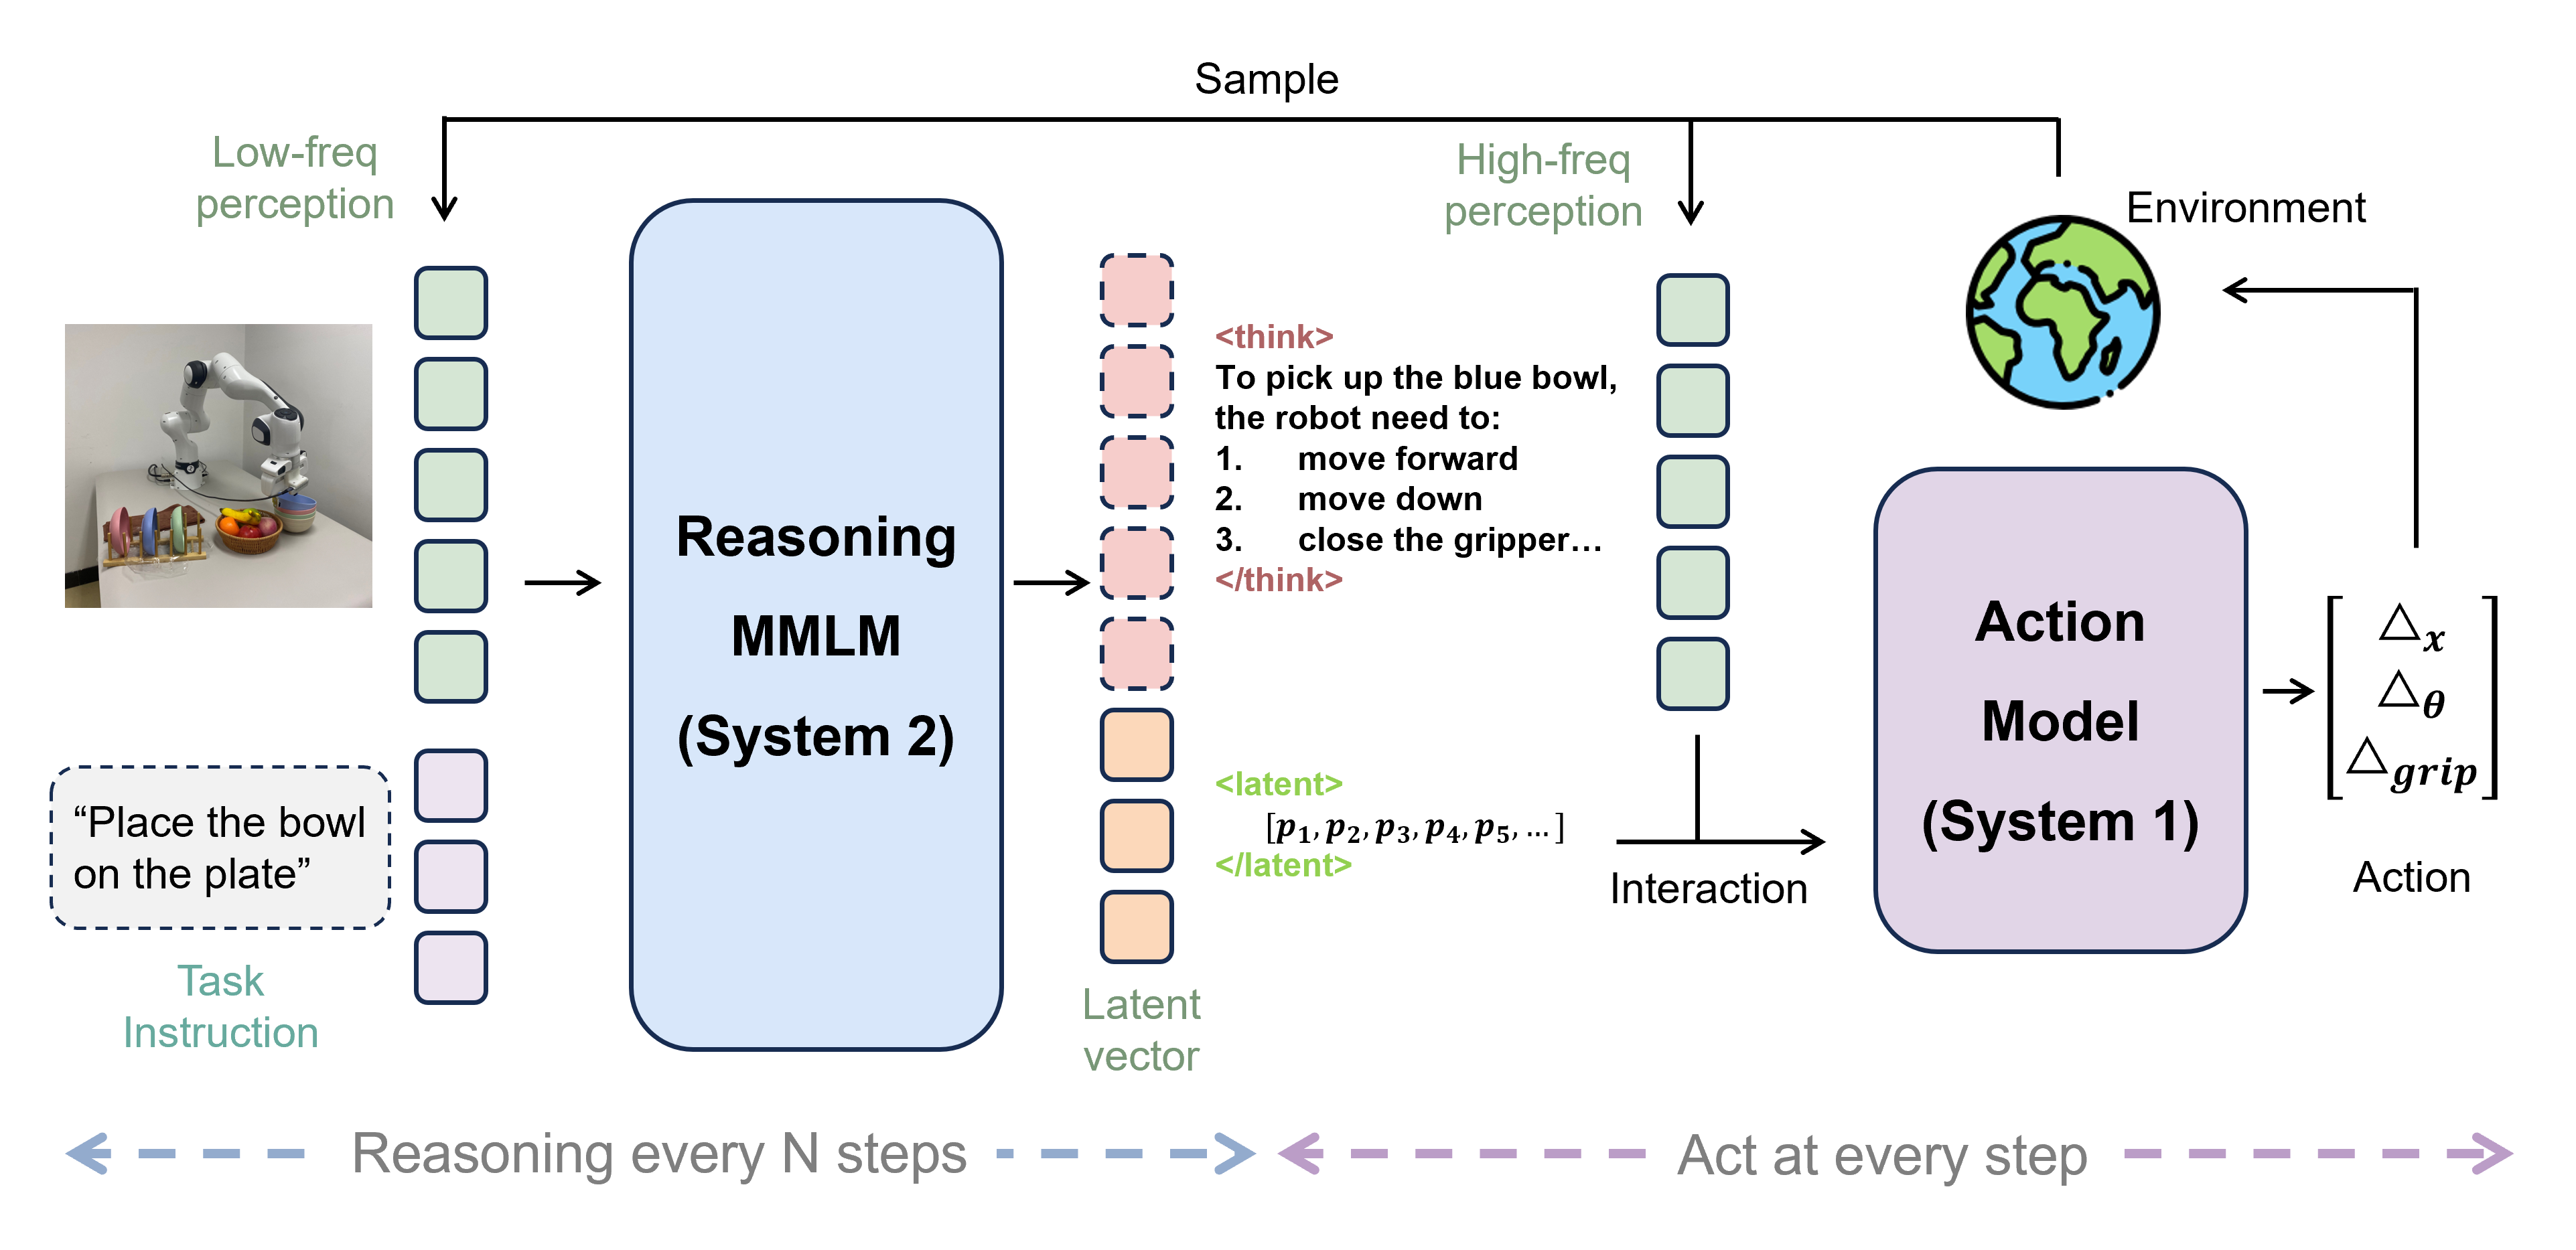
双系统架构设计:解耦模型的推理与反应功能。通常设置一个“慢系统”(高阶推理系统)负责深度理解和长时规划,以及一个“快系统”(低阶反应系统)负责即时动作生成与多步动作复用。两者通过隐状态向量或特殊Token进行通信。该设计在工程上平衡了推理质量与响应速度,但需要精细处理系统间的同步、通信与联合训练问题。
高效感知特征
视觉模态输入通常构成最长的Token序列,是VLA模型最主要的计算开销来源。相关的优化研究主要沿两条互补的路径推进。
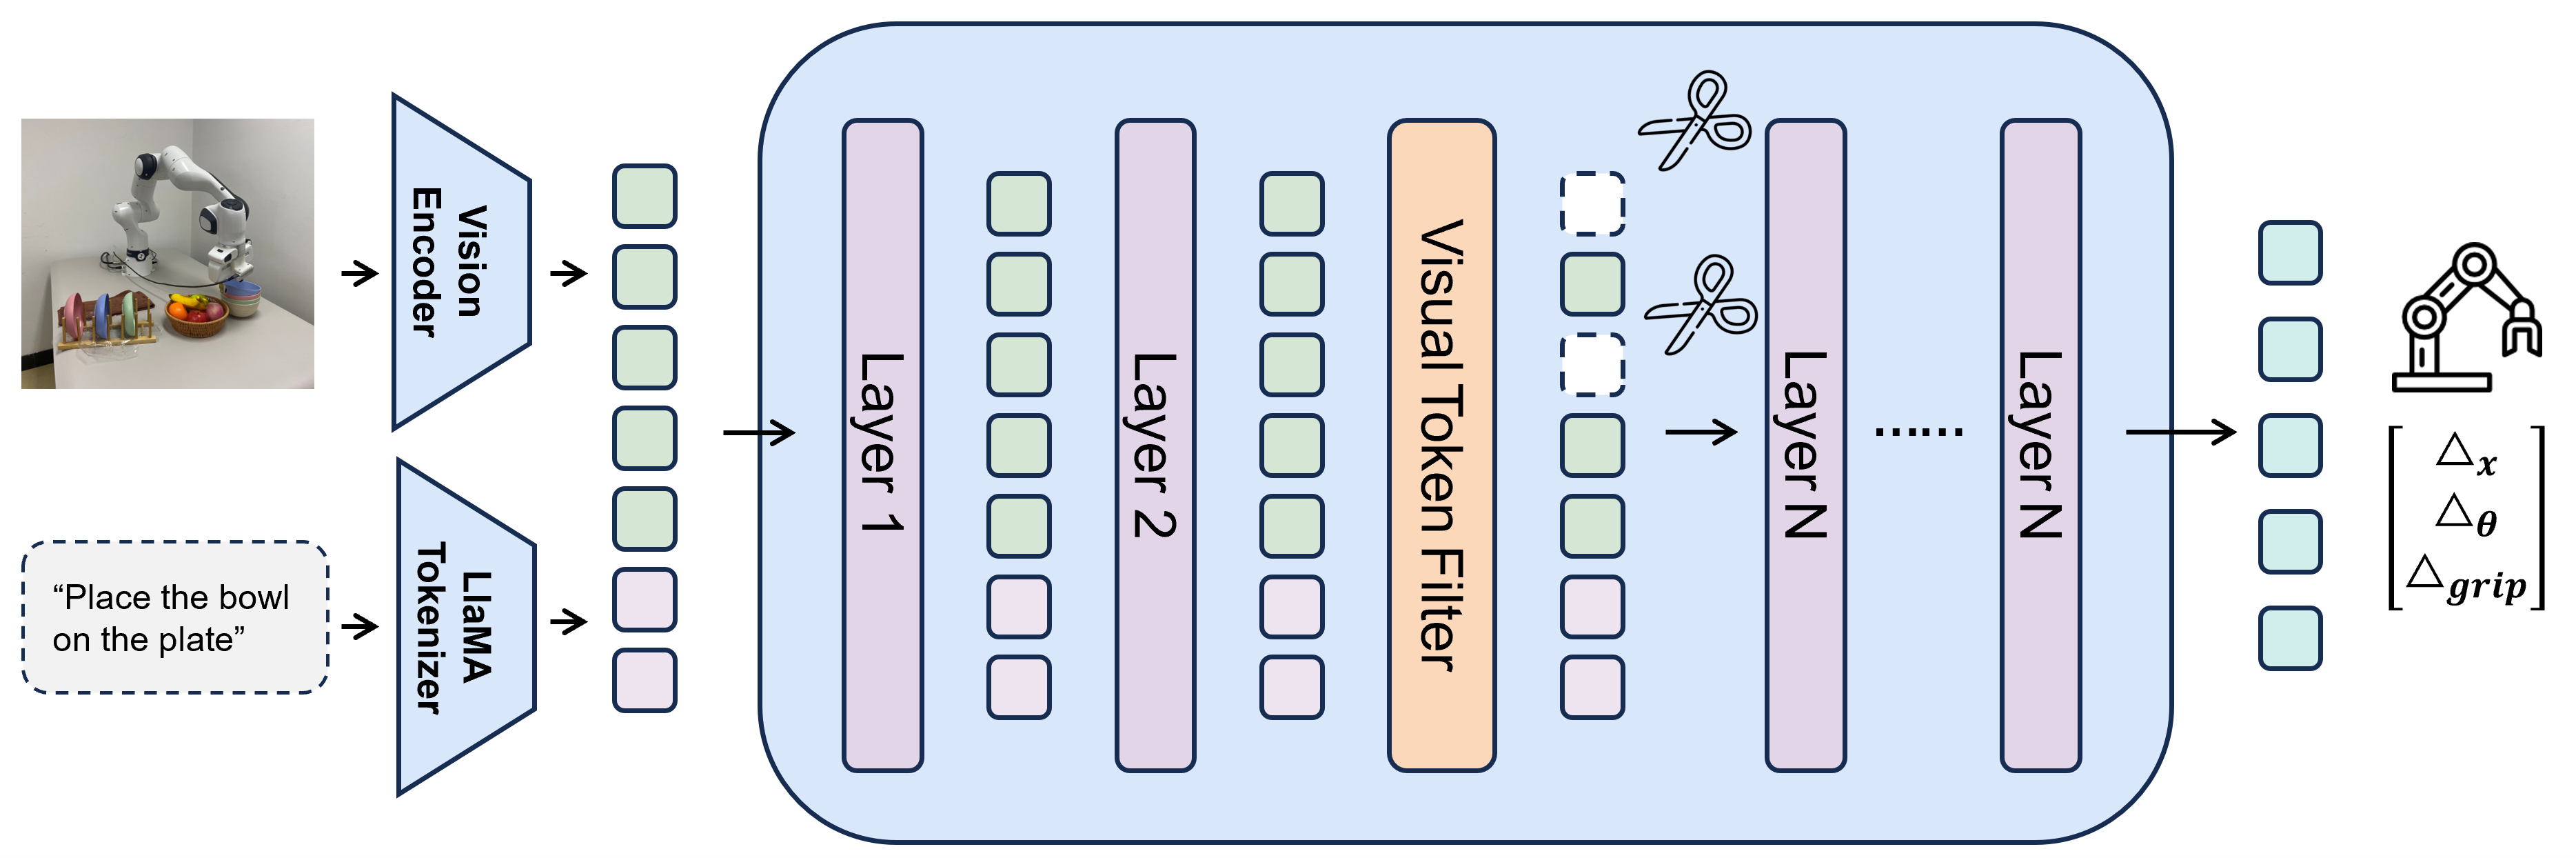
一是单帧特征选择性处理:通过基于注意力分数或特征相似度等指标,筛选并保留任务相关的视觉token,或通过token压缩机制将可变长度的长序列映射为固定长度的紧凑表示。
二是跨时序特征复用:利用机器人观测数据在时间上的高度连续性,复用帧间不变或缓变的特征。时序复用能显著降低连续帧之间的重复计算,但必须引入有效的缓存刷新机制来判断复用的安全性,以避免信息漂移或性能退化。
高效动作生成
动作是连接感知与执行的关键环节,其表示方法和生成策略直接影响任务精度与系统延迟。主要优化策略分为两类。
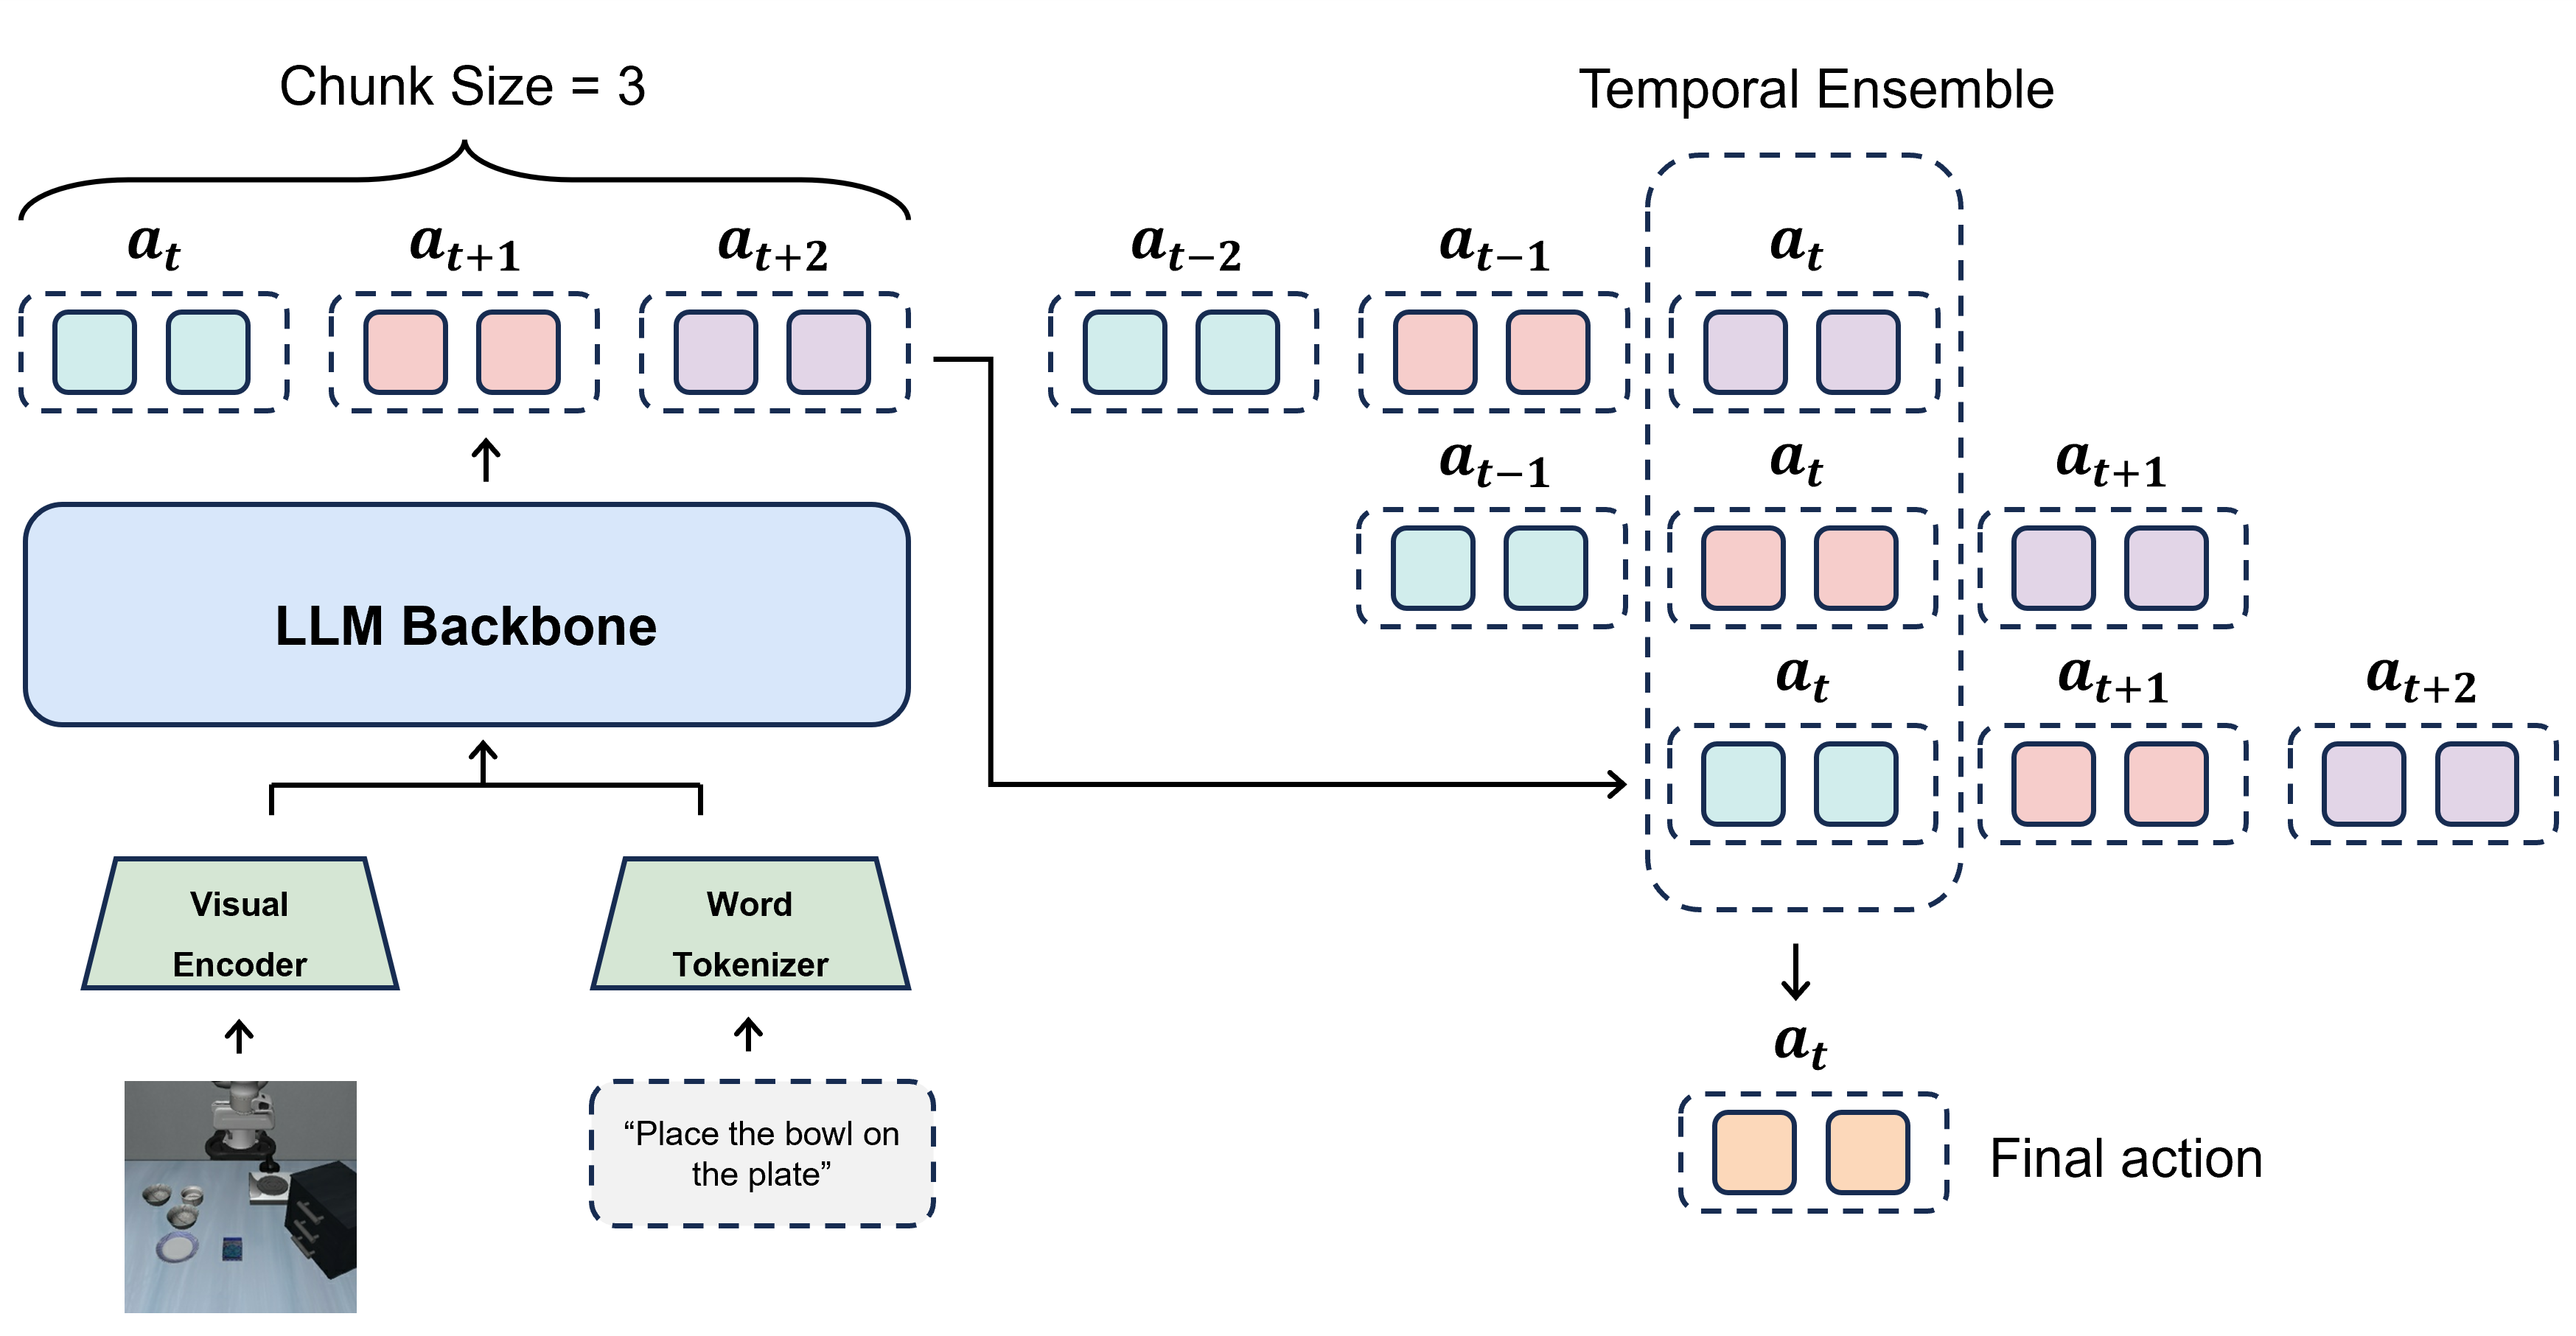
一类直接输出低维连续动作向量以实现最低延迟,但逐步预测在长时序任务中会产生累积误差。改进手段包括动作块化(一次生成多步并做时间平滑)和动作序列压缩(频域变换与量化编码)。这些方法兼顾吞吐量与平滑性,但需处理块边界一致性问题。
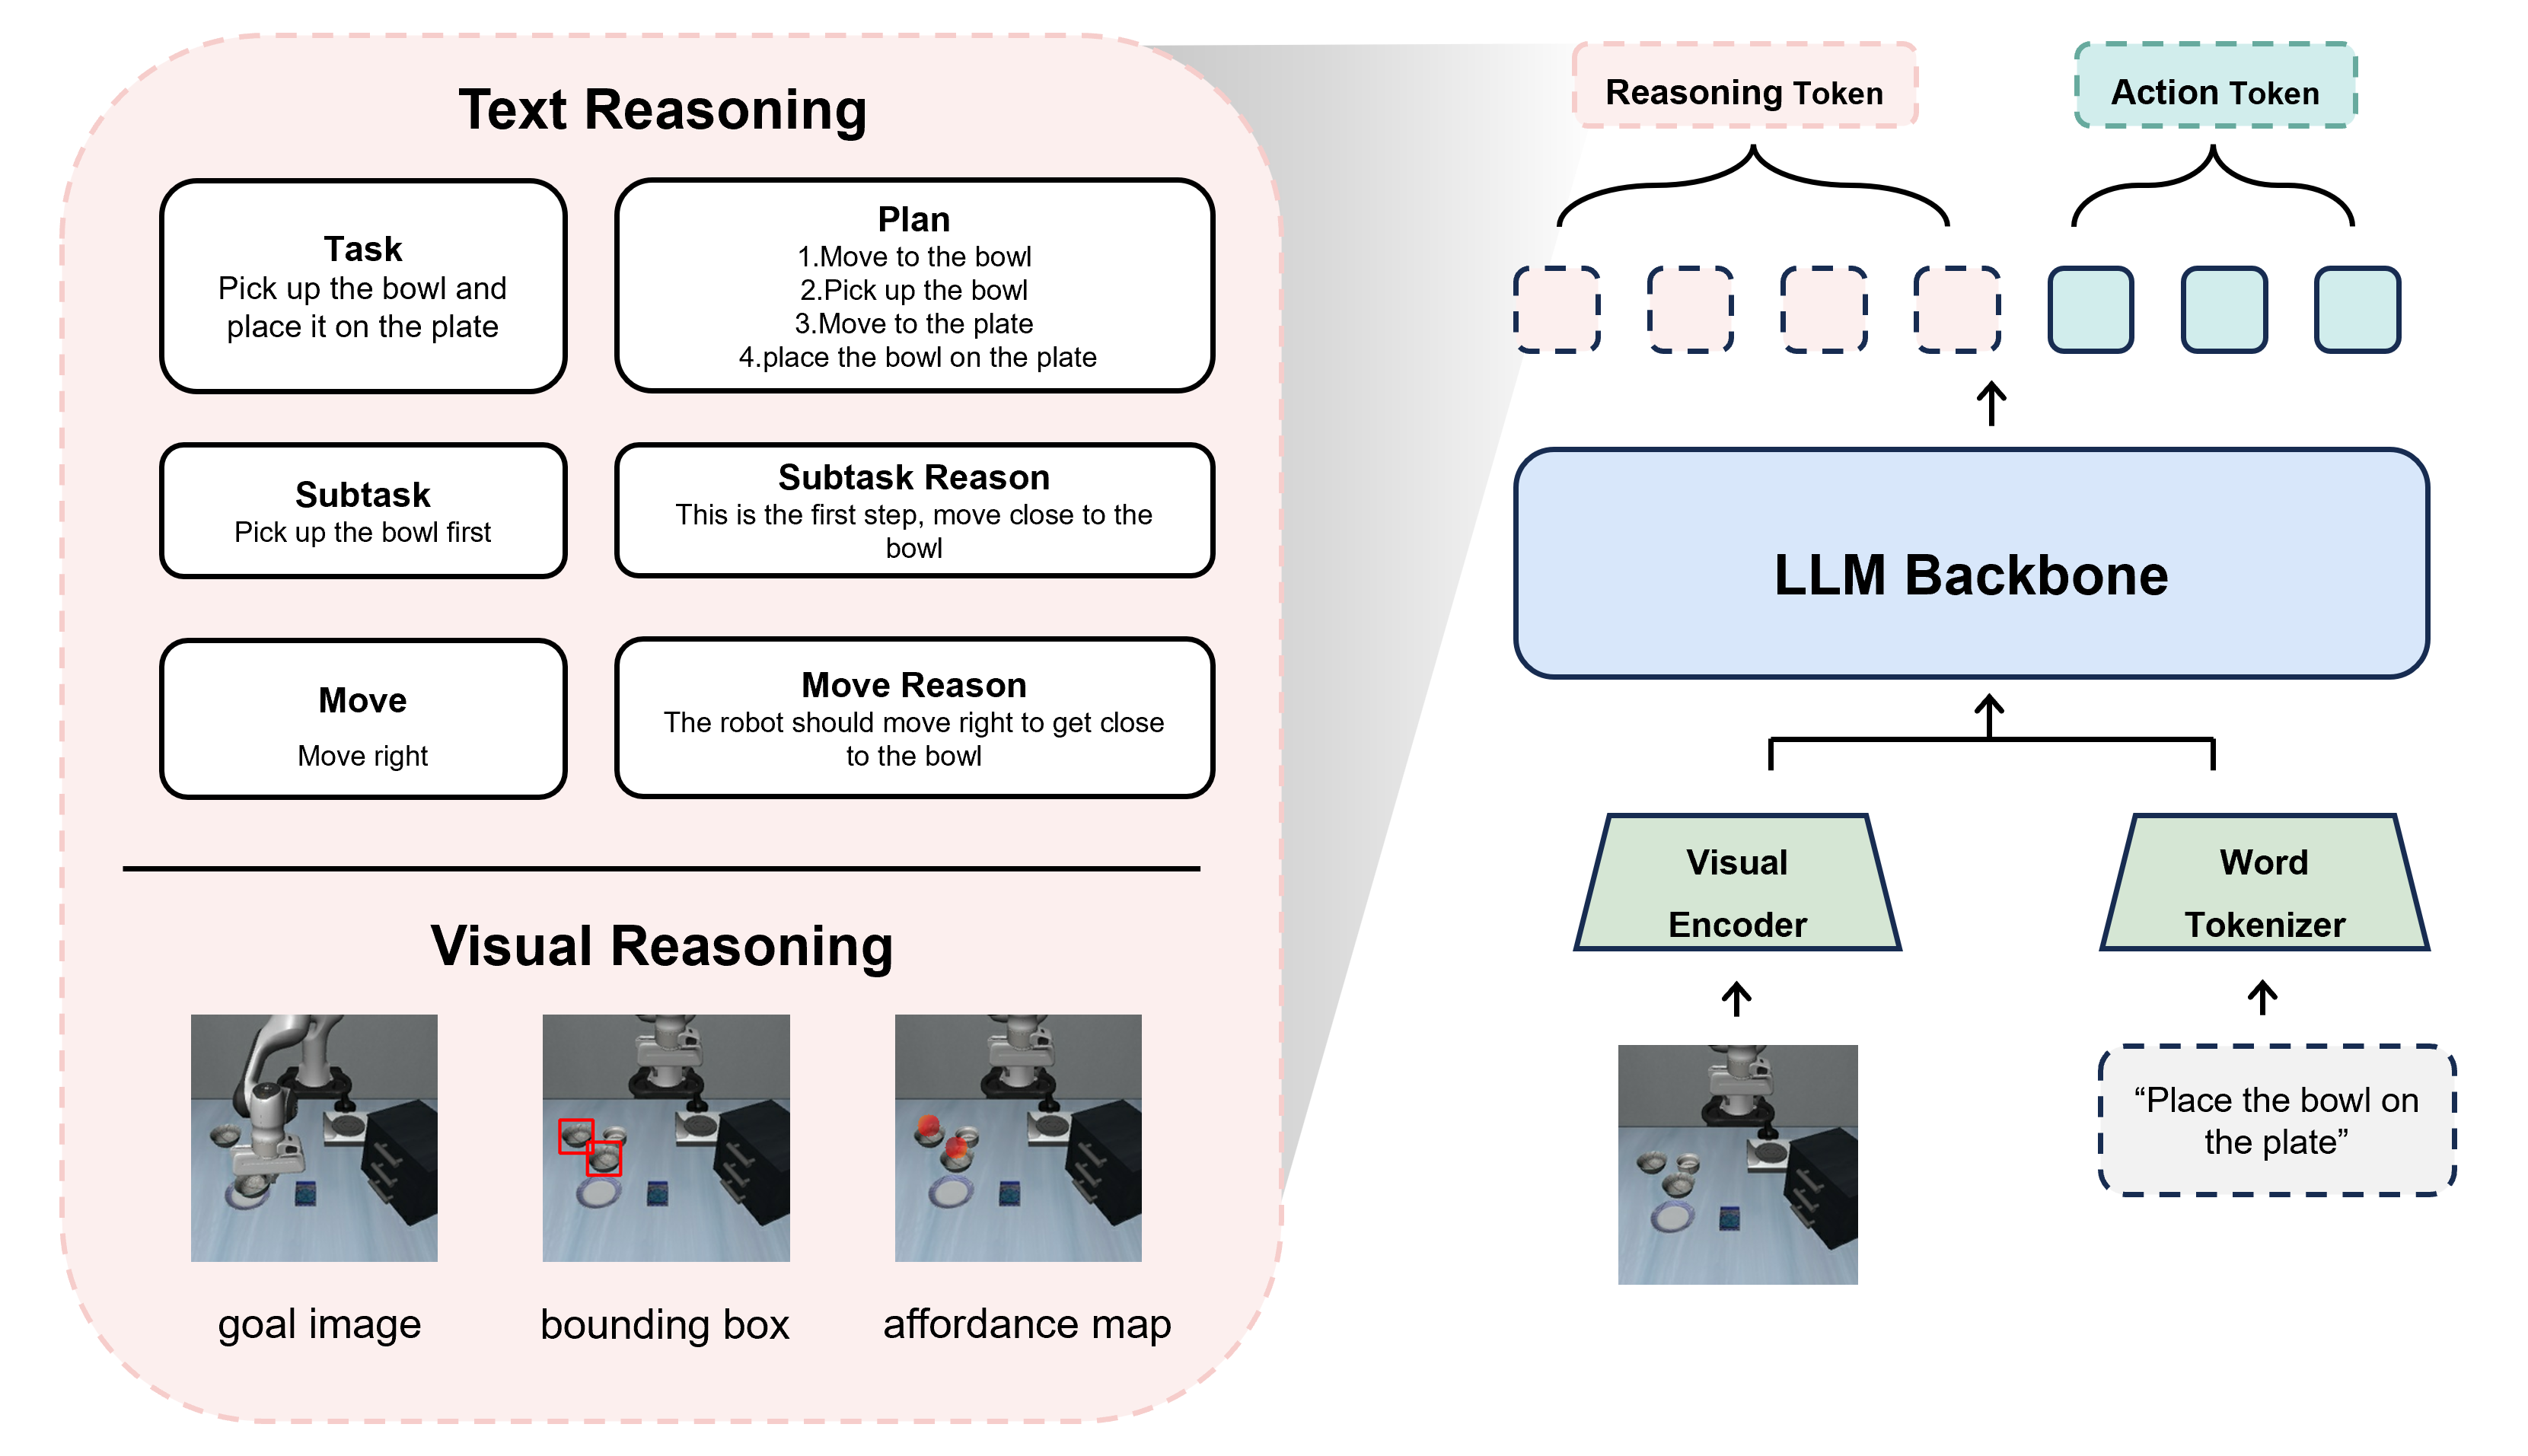
另一类在动作前引入显式推理,包括语言层面的任务分解和视觉层面的子目标预测。此类方法提升可解释性与跨场景泛化,但显著增加序列长度与推理延迟。实践中常采用选择性推理或对高层推理结果实施缓存以减少频繁调用成本。
高效训练与推理
训练端的重点在于降低模型在新任务和新环境下的适配成本。常用策略包括参数高效微调、知识蒸馏、结构化剪枝与量化感知训练。前两者通过少量可学习参数或教师–学生迁移实现快速适配,后两者则在压缩模型规模的同时保持控制精度,整体提升了模型的部署效率与可扩展性。
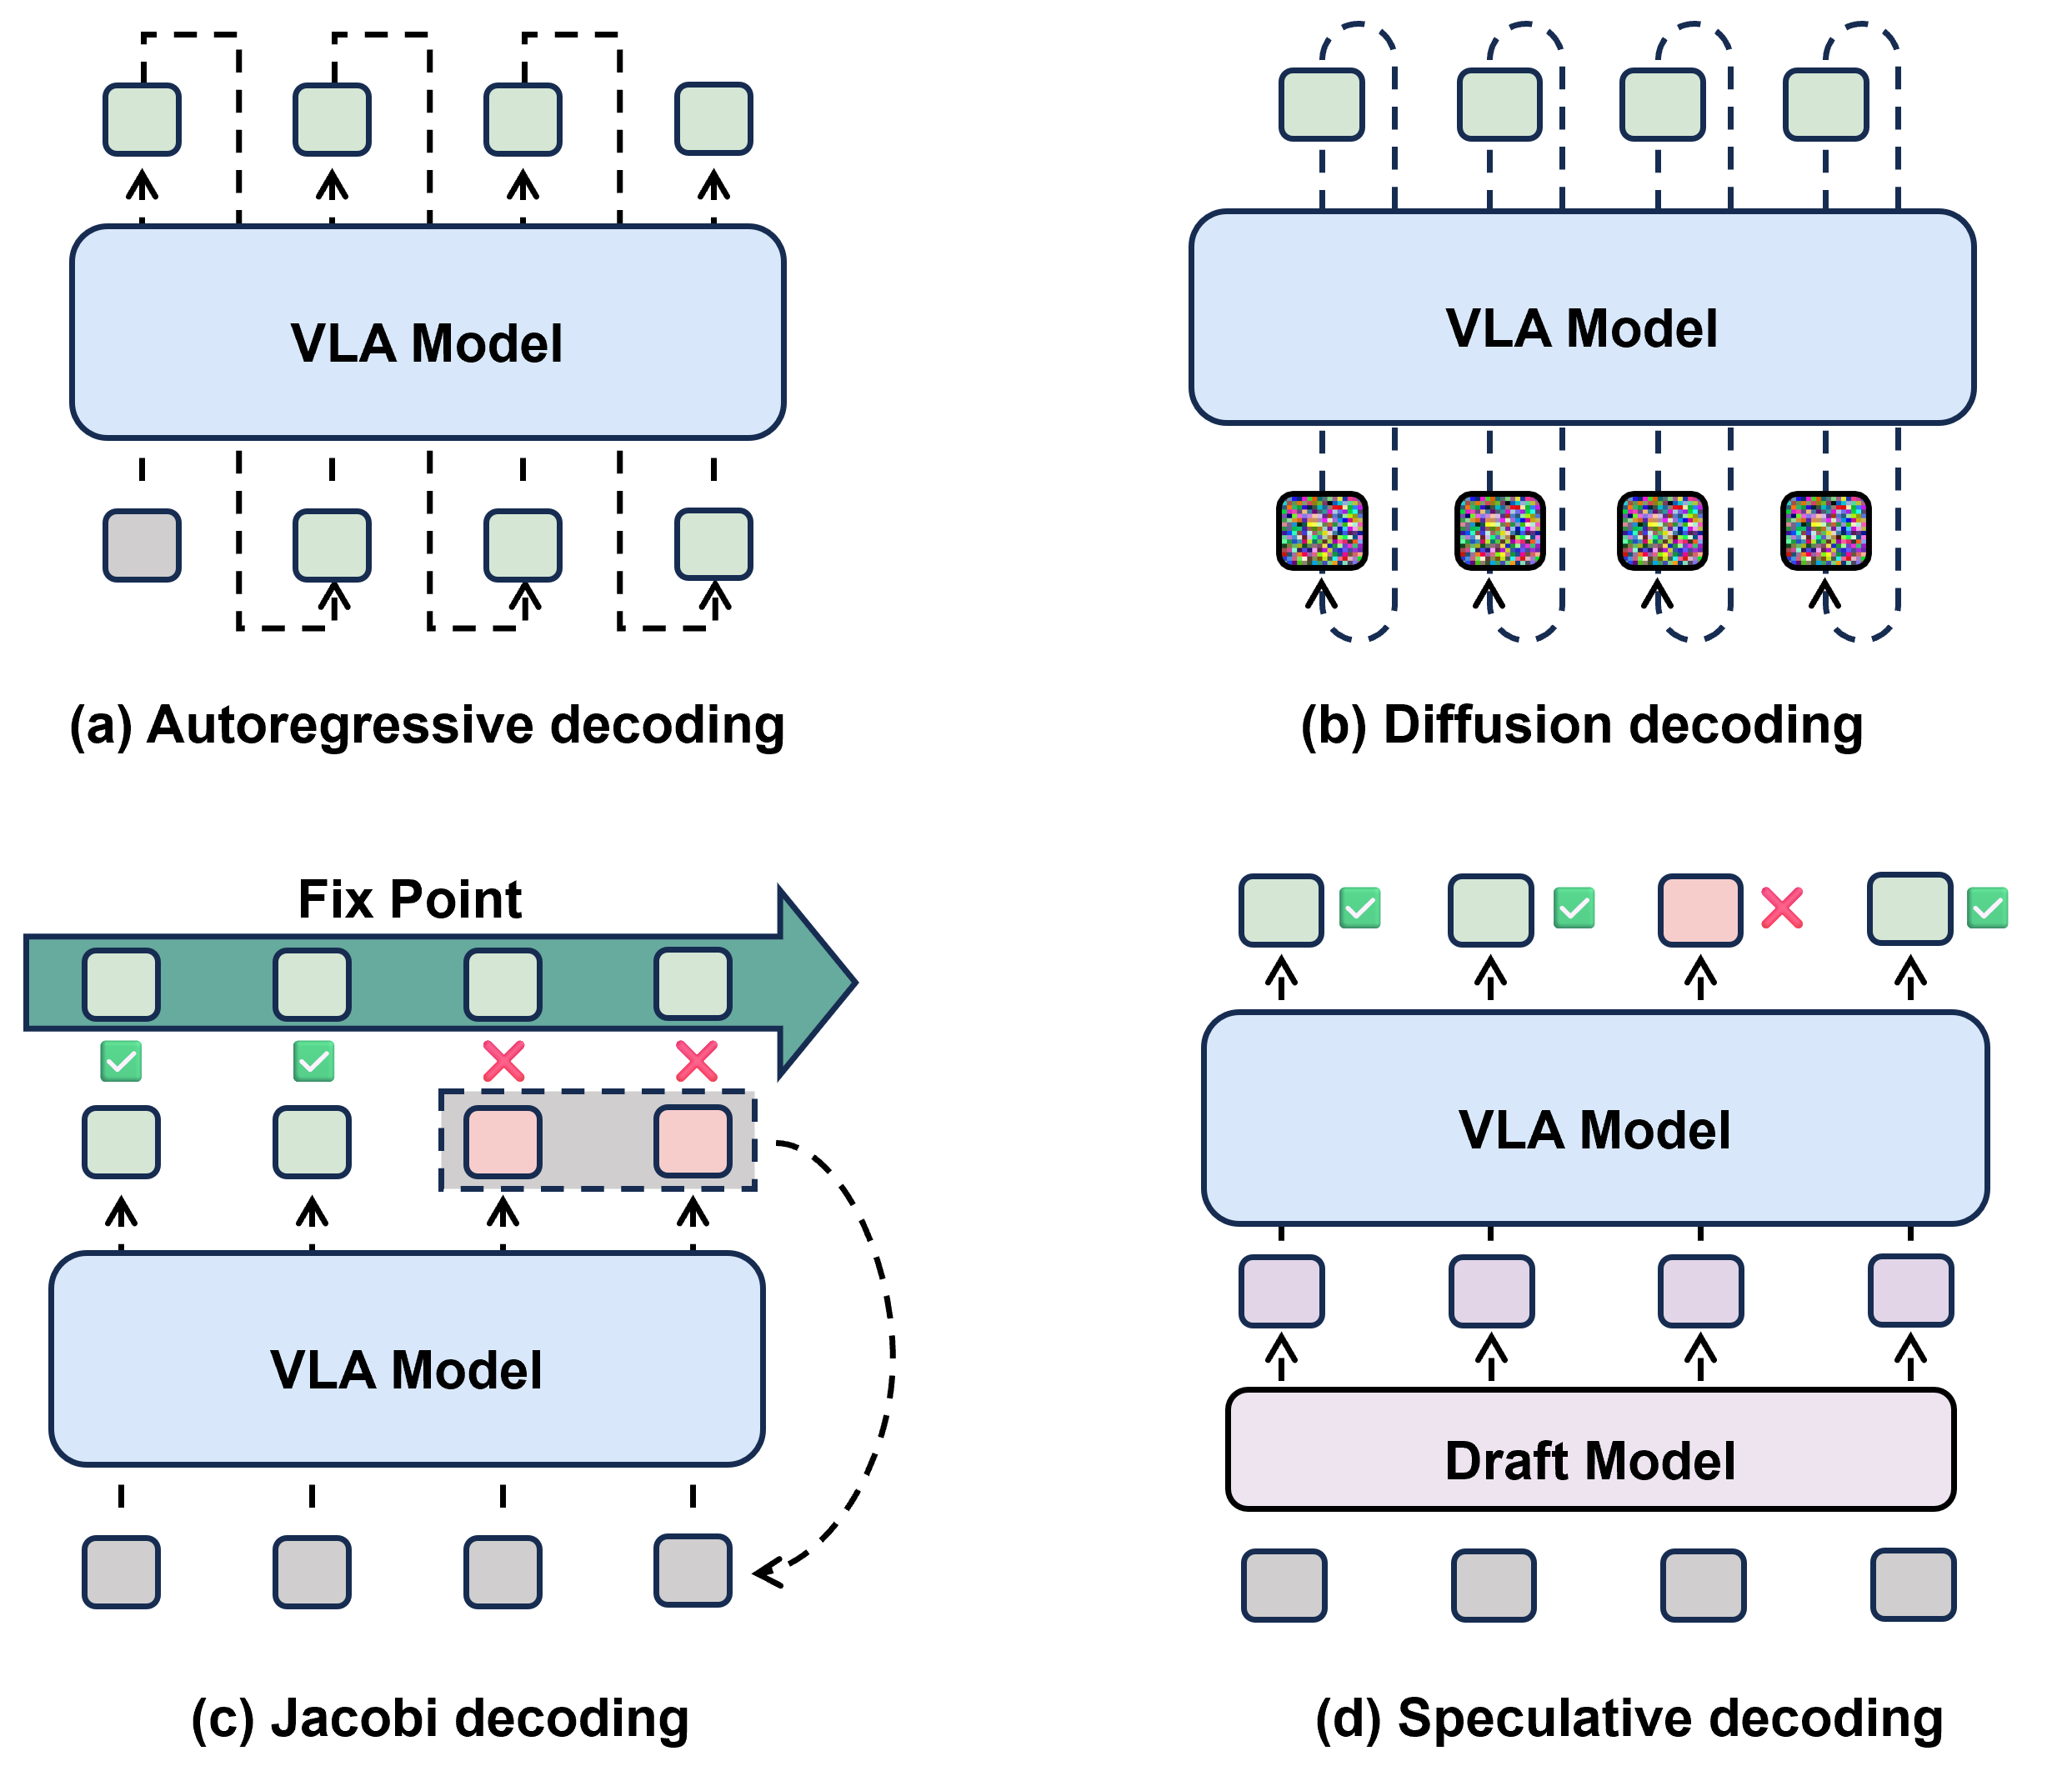
推理端聚焦于突破自回归瓶颈,实现并行化或混合解码。典型路径包括采用并行草案与一次验证的投机式解码、使用双向或部分并行注意力结构以增强吞吐,以及通过一致性蒸馏缩小训练与并行推理间的分布差,从而确保稳定性与收敛速度。
未来展望
随着机器人操作任务复杂性不断增加,未来的VLA模型将不仅追求能力提升,更需要在计算和部署成本上做出精细权衡。综述从发展的趋势出发,对下一代VLA系统中最关键的效率优化点进行了分析,明确了模型、数据、感知、动作与学习策略等环节的潜在改进空间,帮助研究者把握能力与效率的平衡方向。
一 模型数据协同精简: 过去“更大模型+更多数据”的范式在实机数据稀缺这种背景下逐渐失效,未来高效VLA的关键在于模型与数据的协同设计。通过选择高价值样本、优化数据结构和控制数据流向,模型可以在有限算力下充分利用多模态信息,减少冗余训练和无效计算,从而实现能力提升与效率优化。
二 高效时空感知信息: 真实任务要求模型理解复杂空间关系和长时序意图,但全量三维和历史信息代价过高。未来研究将关注任务相关的三维压缩、关键帧和语义筛选策略,使模型在保留必要空间与时间信息的同时,显著降低计算负担,实现高效决策。
三 高效推理动作编码: 高精度操作需要连续、上下文敏感的动作输出,而传统离散指令生成推理成本大。通过层次化动作编码、跨动作段特征复用和轻量级在线规划,模型可以在保证动作连续性的前提下压缩输出序列,实现实时高频控制。
四 高效强化学习策略: 模仿学习受限于演示覆盖,而强化学习探索成本高。未来高效 VLA 将采用分阶段训练、离线微调与安全在线适应相结合的策略,同时复用多模态经验和优化奖励信号,使模型在有限交互预算下自主提升,兼顾学习效率与性能增长。
五 效率导向评测体系: 缺乏统一标准让效率改进难以衡量。建议建立以资源消耗、任务表现和可解释性为核心的评测体系,通过统一报告延迟、内存、能耗,同时考察长期稳定性与鲁棒性,为研发者提供清晰的效率指引和明确的优化空间。
写在最后
本综述从系统视角出发,围绕模型架构、感知特征、动作生成与训练推理四个核心维度,对高效VLA的主要研究进展进行了结构化梳理与比较。作者认为,提升VLA的效率不仅是实现模型压缩和加速的技术问题,更是推动具身智能系统从受控实验环境向复杂真实场景落地的关键因素。通过提供开源论文清单与分类索引,本综述旨在为研究者和工程师提供一份面向效率优化的参考资源,支持高效VLA技术的持续发展与应用。完整论文及相关资源可通过以下链接获取。
论文链接:https://arxiv.org/abs/2510.17111
GitHub仓库:https://github.com/guanweifan/awesome-efficient-vla
具身求职内推来啦
国内最大的具身智能全栈学习社区来啦!
推荐阅读
从零部署π0,π0.5!好用,高性价比!面向具身科研领域打造的轻量级机械臂
工业级真机教程+VLA算法实战(pi0/pi0.5/GR00T/世界模型等)
具身智能算法与落地平台来啦!国内首个面向科研及工业的全栈具身智能机械臂
VLA/VLA+触觉/VLA+RL/具身世界模型等!具身大脑+小脑算法与实战全栈路线来啦~
MuJoCo具身智能实战:从零基础到强化学习与Sim2Real
Diffusion Policy在具身智能领域是怎么应用的?为什么如此重要?
1v1 科研论文辅导来啦!

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 15
 0
- 0


 已为社区贡献21条内容

所有评论(0)